探秘大语言模型数据合成能力:AgoraBench基准测试全解析
现在语言模型用合成数据训练变得越来越重要,但之前没标准方法比较不同模型生成数据的能力。这篇文章提出 AgoraBench测试,用它评估模型在生成数据上的水平。结果发现不同模型各有厉害的地方,而且生成数据能力和解决问题能力不一样,像数据质量的一些特点更能体现其生成能力。这对研究人员和用模型的人都有帮助,能让研究人员知道什么样的模型能更好地生成数据,让用模型的人优化自己生成数据的方法,对语言模型在实际里用得更好很有意义。
我们翻译解读最新论文:评估作为合成数据生成器的语言模型,文末有论文信息。
作者:张长旺,图源:旺知识
摘要
鉴于合成数据在语言模型(LM)后训练中的使用日益增加,语言模型生成高质量数据的能力已几乎与其直接解决问题的能力同等重要。虽然先前的工作侧重于开发有效的数据生成方法,但它们缺乏在统一设置下对不同语言模型作为数据生成器的系统比较。为了弥补这一差距,我们提出了 AGORABENCH,这是一个基准测试,它提供标准化的设置和指标来评估语言模型的数据生成能力。通过使用 6 种语言模型合成 126 万个训练实例并训练 99 个学生模型,我们揭示了关于语言模型数据生成能力的关键见解。首先,我们观察到语言模型表现出不同的优势。例如,GPT - 4o 在生成新问题方面表现出色,而 Claude - 3.5 Sonnet 在改进现有问题方面表现更好。此外,我们的分析表明,语言模型的数据生成能力与其解决问题的能力并不一定相关。相反,数据质量的多个内在特征——包括响应质量、困惑度和指令难度——共同作为更好的指标。最后,我们证明了输出格式的策略选择和具有成本意识的模型选择显著影响数据生成的有效性。
研究背景: 语言模型后训练对合成数据需求攀升,但此前评估模型数据生成能力的工作分散,缺统一实验设定,不同研究在数据生成方法、模型选用、数据量及评估基准上差异大,难以精准衡量模型生成能力,故需标准框架来有效对比各模型在数据生成任务中的表现,推动该领域发展。
研究贡献:
创新提出 AGORABENCH 基准测试,结合多领域与多种数据生成法,统一设置仅变数据生成器,精准度量语言模型数据生成能力,为系统评估奠基。
挖掘模型优势差异,如 GPT - 4o 实例生成强、Claude - 3.5 Sonnet 质量优化优,打破以解题力衡量生成力局限,发现两者弱关联,明确指令难度等多特征联合为优指标,助选合适模型。
验证输出格式与成本选模影响生成,JSON 格式或降性能、预算限定时便宜模型多生数据或更优,为优化生成策略提供关键依据。
实现设计:
实验设置:确定数学、代码、指令跟随核心领域,依数据生成法择适配种子数据集与基准测试,使语言模型于各设置造等量训练实例,以孤立数据质量影响、精准评估生成力。
指标构建:创性能差距恢复(PGR)指标,借学生模型在基准测试分数变化,量化其于生成数据训练后相对基础模型改进程度,有效度量模型数据生成价值。
评估流程:用监督微调训练学生模型,依设定超参数直用生成数据训练,聚焦评估语言模型原始生成力,多维度内在评估含指令质量、响应特性及多样性衡量,借主成分分析挖掘关键影响因素及预测因子。
实验结果:
模型性能对比:GPT - 4o 在多设置中 PGR 得分优,实例生成领先;Claude - 3.5 - Sonnet 质量增强佳,特定领域响应生成出色,且弱解题力模型可能优先生成,如代码域 Llama - 3.1 - 8B - Instruct 超强解题模型。
成本性能平衡:Llama - 3.1 - 8B - Instruct 性价比高,GPT - 4o 较 Claude - 3.5 - Sonnet 低成本优效,为经济选模供依据,显示成本非性能决定因素。
其他因素影响:JSON 格式降性能,元提示优化重要,预算约束下弱模型多生成实例在部分领域超强模型少生成情形,表明输出格式、成本与生成量协同影响生成效果。
1 引言
在合成数据上对语言模型进行后训练是提高其解决广泛任务能力的一种有前途的方法(Wang 等人,2023;Honovich 等人,2023;Taori 等人,2023;Liu 等人,2024b)。虽然通过手动标注获取数据仍然发挥着重要作用,但合成数据生成提供了一种可扩展的替代人工标注的方法(Viswanathan 等人,2023;Kim 等人,2023b)。因此,许多工作提出了新颖的方法来有效地生成高质量的合成数据(Xu 等人,2024a;Gunasekar 等人,2023;Yue 等人,2023,2024)。
随着多个性能相当的专有语言模型出现以及开源语言模型稳步追赶(Hurst 等人,2024;Anthropic,2024;MetaAI,2024;Team,2024),衡量每个语言模型的数据生成能力变得与开发新的数据生成方法同样关键。此外,提供专有语言模型的公司已开始推广使用其最新模型来生成合成数据(Nvidia,2024)。仔细比较不同语言模型的数据生成能力有助于验证这些说法,并使从业者能够明智地选择用于数据合成的模型。
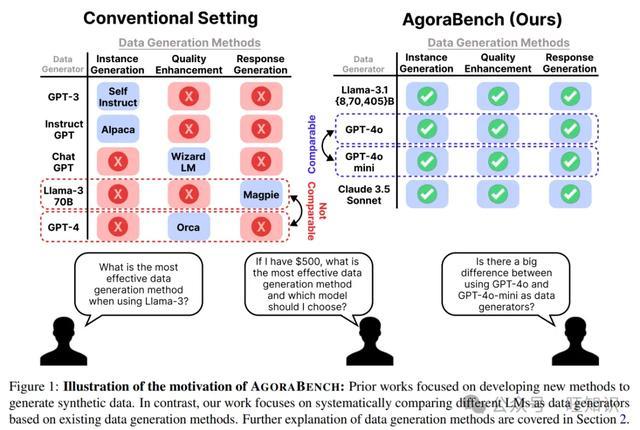
为了系统地比较语言模型作为数据生成器的能力,需要一个统一的实验设置,其中只有数据生成器变化,而其他组件保持固定。然而,如图 1 所示,先前的工作更多地侧重于展示其数据生成方法的有效性,导致了各种实验设置,使得这种比较具有挑战性。例如,Self - Instruct(Wang 等人,2023)、Alpaca(Taori 等人,2023)、WizardLM(Xu 等人,2024a)和 Orca(Mukherjee 等人,2023)在用于数据生成的语言模型选择、合成训练数据的数量、用于训练的基础模型以及评估在合成数据集上训练的模型的基准测试方面各不相同。这些不同的设置使得难以分离和衡量语言模型的数据生成能力,突出了对受控设置的需求。
为此,我们提出了 AGORABENCH,这是一个用于评估语言模型在九种设置下的数据生成能力的基准测试,它将三个领域(数学、指令跟随、代码)与三种数据生成方法(实例生成、响应生成、质量增强)相结合。在每种设置中,除数据生成器外的所有变量都受到控制:使用相同的元提示和种子数据集,每个语言模型生成相同数量的训练实例。在每个合成数据集上训练 Llama3.1 - 8B,并在涵盖不同能力(数学、编码和一般指令跟随)的固定基准测试集上进行评估。为了评估合成数据的质量,我们定义了一个称为性能差距恢复(PGR)的指标,它衡量在数据上训练的模型(表示为“学生模型”)相对于其基础模型的相对改进。基于此设置,我们评估六种语言模型作为数据生成器:GPT - 4o、GPT - 4o - mini、Claude - 3.5 - Sonnet 和 Llama - 3.1 - Instruct(8B、70B、405B)。
我们的分析揭示了不同语言模型在各种数据生成方法中的独特优势。例如,GPT - 4o 在生成新实例方面表现出卓越的性能(+ 46.75%),优于 Claude - 3.5 - Sonnet(+ 24.14%)和 Llama - 3.1 - 405B - Instruct(+ 10.10%)。另一方面,Claude - 3.5 - Sonnet 在优化现有实例方面表现出色(+ 17.89%),超过 GPT - 4o(+ 6.69%)和 GPT - 4o - mini(+ 5.49%)。这些发现展示了 AGORABENCH 如何指导从业者为其特定需求选择合适的语言模型。
出乎意料的是,我们还发现解决问题能力较弱的语言模型有时在数据生成方面优于能力较强的语言模型——例如,在代码领域生成新实例时,Claude - 3.5 - Sonnet(+ 23.43%)不如 Llama - 3.1 - 8B - Instruct(+ 55.69%)有效。基于这些发现,我们研究语言模型的数据生成能力是否仅由其解决问题的能力预测。我们的分析表明这两种能力之间没有很强的相关性。相反,数据质量的多个内在特征——包括指令难度、响应质量和响应困惑度——共同影响学生模型的改进。此外,我们证明从内在测量中提取的前 5 个主成分可以解释 PGR 值中 93.4%的方差。
最后,我们进行了有效数据生成的分析实验。例如,我们发现合成数据的输出格式显著影响性能:与自由格式生成相比,使用 JSON 格式生成的数据在六个设置中的平均性能低 4.45%。此外,在预算受限的设置中,使用较弱的模型生成更多数据可能优于使用较强的模型生成较少数据。我们发现使用 GPT - 4o - mini 生成 50K 实例,虽然成本低 3.4 倍,但在三个设置中的两个设置中比使用 GPT - 4o 生成 10K 实例实现了更好的性能。
2 预备知识:测量语言模型的数据生成能力
符号说明
给定种子数据 和描述要执行的数据生成类型的提示(称为“元提示”),数据生成器 生成 ,其中 和 都可以表示为 ,其中 表示指令, 表示相应的响应, 表示数据的大小。
数据生成方法
如图 2 所示,在各种数据生成方法中,大多数可以分为三类:实例生成、响应生成和质量增强。这些方法的工作原理如下:
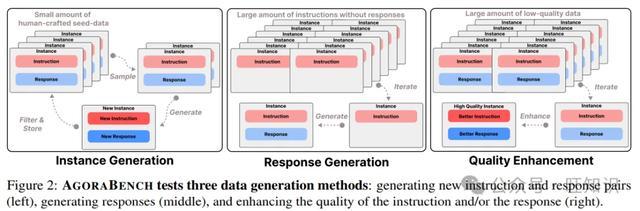
实例生成:给定一个小的种子数据集 ,从 中随机采样几个实例作为上下文示例,从而生成新实例(Honovich 等人,2023;Wang 等人,2023)。这个过程迭代进行,直到构建出 ,其中 。请注意,生成的实例也可以可选地用作示例。
响应生成:给定一大组指令 , 迭代遍历每个指令 以生成相应的响应 (Xu 等人,2024b)。
质量增强:给定一大组指令和响应 , 迭代遍历每个实例以改进 和/或 ,例如通过明确提示 “使 和/或 的质量更高”(例如,使指令更难或具有更高的教育价值)(Xu 等人,2024a;Yue 等人,2024)。
指标
语言模型的数据生成能力可以通过评估在教师生成的数据上训练的学生模型的性能改进来衡量。具体来说,我们提出一个指标,性能差距恢复(PGR),它衡量相对于参考模型在基准 上的改进,
其中 表示预训练的语言模型, 表示在 上训练的 , 表示与 作为基础模型共享相同预训练模型的参考模型,并且 表示在基准 上的分数。在我们的实验中,我们使用 Llama3.1 - 8B 作为 ,并使用 Llama - 3.1 - 8B - Instruct 作为 。
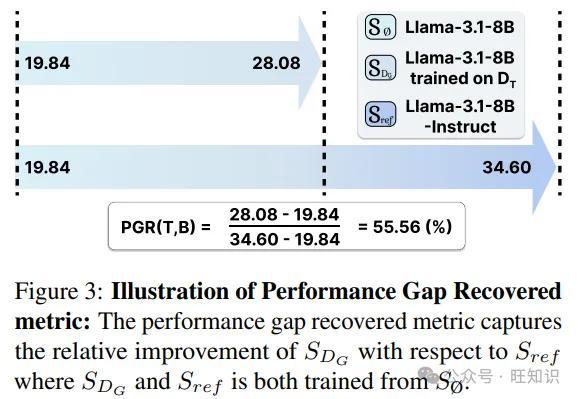
直观地说,如图 3 所示,通过使用 Llama - 3.1 - 8B 作为 和 Llama - 3.1 - 8B - Instruct 作为 ,PGR 值表示与 Llama - 3.1 - 8B - Instruct 的后训练过程相比恢复了多少性能,据报道,Llama - 3.1 - 8B - Instruct 在超过 1000 万个由人类精心策划的数据示例上进行了广泛的训练(MetaAI,2024)。例如,PGR 值为 50%表示 已经恢复了相对于 , 所实现的改进的 50%。值高于 100%表示 优于 ,而负值表示在 上的训练与少样本提示的 相比降低了在 上的性能。
训练学生模型
在训练学生模型()时,我们采用监督微调(SFT),仅计算响应标记上的损失。我们直接使用生成的数据 而不进行过滤,并且不考虑其他后训练方法,因为我们的目标是在最直接的设置中评估语言模型()的原始数据生成能力,而不是最大化 的基准性能。训练的超参数在附录 D 中详细说明。
3 AGORABENCH 的实验设置
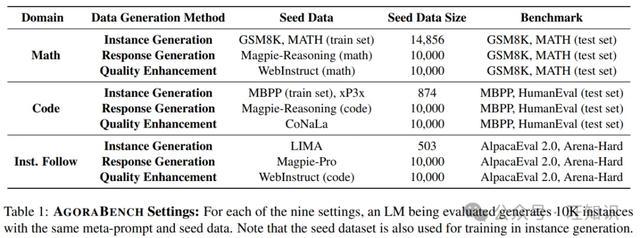
在各种选择中,AgoraBench 专注于被认为对语言模型至关重要的三种核心能力:指令跟随、数学推理和编码(Chang 等人,2024;Guo 等人,2023;Hurst 等人,2024;Anthropic,2024)。AGORABENCH 的整体实验设置,包括每个设置的领域、种子数据集和基准测试,列于表 1。
领域
AGORABENCH 涵盖三个领域:数学、代码和指令跟随。在每个领域中评估三种数据生成方法,产生九个不同的设置,每个设置都有专用的种子数据集()和基准测试()。对于每个设置,用作数据生成器的语言模型生成 10K 训练实例。
然后,使用来自单个领域的数据训练学生模型,以隔离生成数据质量的影响,因为跨域训练可能通过正迁移或负迁移引入混淆因素(例如,在代码数据上的训练提高数学能力(Dong 等人,2023;Zhang 等人,2024))。
种子数据集
对于每个设置,我们基于不同的假设选择种子数据集():
实例生成:由于我们将少量高质量数据扩展为更大的量,我们的方法基于使用高质量的人工制作数据作为种子数据。因此,对于数学,我们使用 GSM8K(Cobbe 等人,2021)和 MATH(Hendrycks 等人,2021)的训练子集;对于代码,我们使用 MBPP(Austin 等人,2021)和 xP3x(Muennighoff 等人,2023b);对于指令跟随,我们使用 LIMA(Zhou 等人,2024)。根据 Llama - 3 标记器,我们排除超过 4096 个标记的实例,分别为数学、代码和指令跟随领域产生 14856、874 和 503 个种子实例。
响应生成:我们模拟不同的数据生成器如何为一组固定的指令附加响应,以最终创建更高质量的数据。虽然我们可以使用任意数据并丢弃其响应进行实验,但我们利用 Magpie 数据集,因为 Xu 等人(2024b)的设置与我们的设置非常匹配——他们首先通过用空聊天模板提示语言模型来提取指令,然后使用两种不同类型的语言模型(Llama3 - 70B - Instruct 和 Qwen - 2 - 72B - Instruct)生成响应。在我们的实验中,我们从 Magpie 数据集(Xu 等人,2024b)为指令跟随领域采样 10K 实例,并从 Magpie - Reasoning 数据集为数学和代码领域各采样 10K 实例。
质量增强:我们测试指令和响应的完整实例已经存在但其质量在用于后训练之前需要改进的场景——要么是因为指令太简单,要么是因为响应不够详细。对于指令跟随和数学领域,我们从 WebInstruct(来自网络需要改进的问答对;见 Yue 等人(2024))中采样 10K 实例。请注意,WebInstruct 不包含域标签,因此我们提示 GPT - 4o - mini - 2024 - 07 - 18 准备一个单独的 (更多细节在附录 B 中)。对于代码领域,我们使用 CoNaLa,它包含来自 StackOverflow 的简单指令与 1 - 3 行代码片段配对(Yin 等人,2018)。
基准测试
我们使用每个领域的两个代表性基准测试来评估学生模型()的性能。对于数学,我们使用 GSM8K(Cobbe 等人,2021)和 MATH(Hendrycks 等人,2021)的测试子集。对于代码,我们使用 MBPP(Austin 等人,2021)和 HumanEval(Chen 等人,2021)的测试集。对于指令跟随,我们在 AlpacaEval - 2.0(Dubois 等人,2024)和 Arena - Hard(Li 等人,2024)上进行评估。
4 AGORABENCH 的实验结果
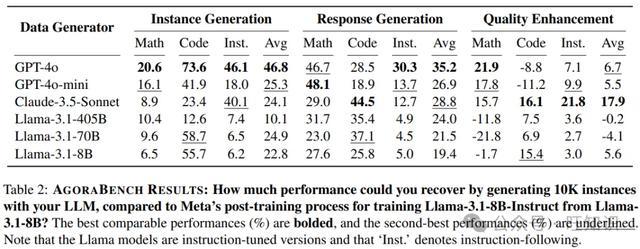
我们比较了 6 种语言模型作为数据生成器(),即 GPT - 4o - 2024 - 08 - 06(Hurst 等人,2024)、GPT - 4o - mini - 2024 - 07 - 18、Claude - 3.5 - Sonnet - 2024 - 06 - 20(Anthropic,2024)、Llama - 3.1 - 405B - Instruct、Llama - 3.1 - 70B - Instruct 和 Llama - 3.1 - 8B - Instruct(Dubey 等人,2024)。此外,我们使用 Llama - 3.1 - 8B 作为学生模型()。AGORABENCH 的结果列于表 2。
GPT - 4o 是总体性能最佳的数据生成器
在九个实验设置中,GPT - 4o 在五个设置中获得了最高的 PGR 分数。它在实例生成方面的性能尤为显著,在所有三个领域(数学为 20.6%、代码为 73.6%、指令跟随为 46.1%,总体平均为 46.8%)中作为数据生成器都优于其他语言模型,并且在响应生成中也获得了最高的平均 PGR 分数(35.2%)。
Claude - 3.5 - Sonnet 对质量增强特别有效
Claude - 3.5 - Sonnet 在质量增强方面表现出强大的性能,在三个领域中的两个领域(代码为 21.8%、指令跟随为 17.9%,总体平均为 17.9%)获得了最高的 PGR 分数。此外,它在代码领域的响应生成中获得了最佳的 PGR 分数(44.5%),使其在九个设置中的最佳表现总数达到三次。
较弱的语言模型可以优于较强的语言模型
我们观察到在某些情况下,解决问题能力较弱的语言模型实现的性能差距恢复(PGR)分数高于其较强的对应模型。在实例生成的代码领域中,Claude - 3.5 - Sonnet(23.4%)和 Llama - 3.1 - 405B - Instruct(12.6%)都被 Llama - 3.1 - 70B - Instruct(58.7%)和 Llama - 3.1 - 8B - Instruct(55.7%)超越。同样,在代码领域的质量增强设置中,GPT - 4o(8.8%)和 GPT - 4o - mini(-11.2%)的性能比其他语言模型差。
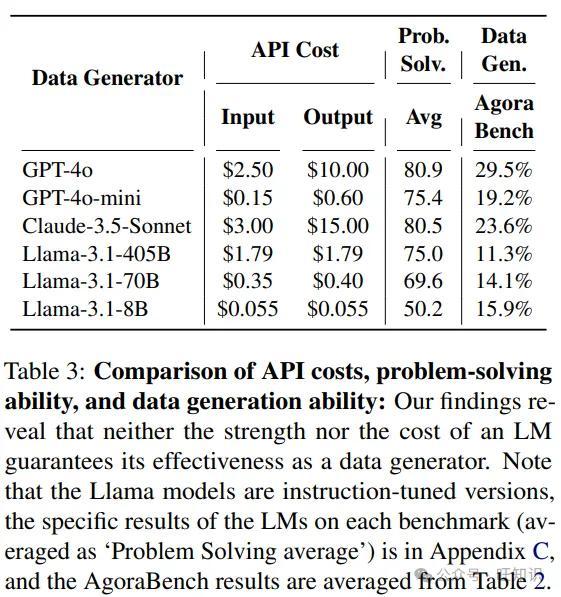
有趣的是,如表 3 所示,在这些情况下表现较差的语言模型实际上在代码基准测试(MBPP 和 HumanEval)中得分更高,这表明它们具有更强的解决问题能力。这种矛盾表明,更强的语言模型不一定能生成更好的训练数据。我们将在第 5 节中进一步讨论这一现象。
GPT - 4o、GPT - 4o - mini 和 Llama - 3.1 - 8B - Instruct 是平衡成本和性能的有效数据生成器
在生成大量合成数据时,成本是与性能并列的关键因素。表 3 列出了所有六种语言模型的 API 成本、解决问题能力(基准测试分数)和在 AGORABENCH 上的平均性能(即数据生成能力)。Llama - 3.1 - 8B - Instruct 的性能优于 Llama - 3.1 - 70B - Instruct 和 Llama - 3.1 - 405B - Instruct,同时成本低 6 到 32.5 倍。同样,GPT - 4o 以 1.2 到 1.5 倍的较低成本实现了比 Claude - 3.5 - Sonnet 更好的性能。这些发现表明,使用更昂贵的语言模型并不一定保证更好的数据生成,突出了根据特定任务或感兴趣的领域仔细选择模型的重要性。
5 什么使一个有效的数据生成器?
在上一节中,我们观察到一个意外的发现:在相同条件下生成相同数量的合成数据时,解决问题能力较弱的语言模型有时优于较强的语言模型。为了更好地理解这一现象,我们首先检查解决问题能力和数据生成能力之间是否存在强相关性(第 5.1 节)。然后,我们研究是否可以通过分析每个语言模型生成的数据来预测学生模型性能的提升程度(第 5.2 节)。
5.1 最佳求解器一定是最佳生成器吗?
为了检查数据生成和解决问题能力之间的关系,我们进行了线性回归分析,比较了两个指标:多个基准测试(GSM8K、MATH、MBPP、HumanEval、AlpacaEval - 2.0、Arena - Hard)的平均性能和 AGORABENCH 的分数。我们在两个粒度级别上进行此分析。第一个分析(粗粒度)使用所有领域和数据生成设置的总体平均 AGORABENCH 分数。第二个分析(细粒度)分别检查 AGORABENCH 中不同领域和数据生成设置的单个分数。
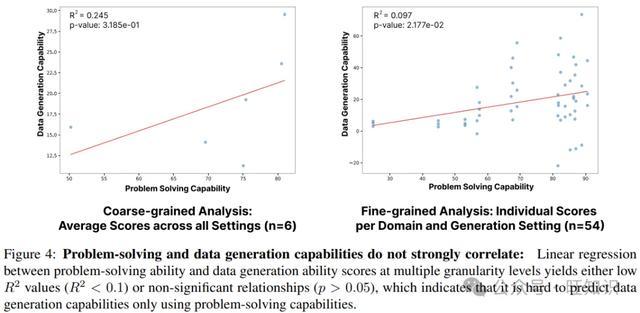
图 4 所示的结果表明,在任何粒度级别上,解决问题能力(基准测试分数)和数据生成能力(AGORABENCH PGR 分数)之间都没有强线性相关性。这一发现表明,语言模型在传统基准测试上的性能可能无法预测其作为数据生成器的有效性。
5.2 我们可以通过查看数据来预测学生模型的改进吗?
鉴于解决问题能力不能直接预测数据生成能力,我们探索其他哪些特征可能定义有效的数据生成器。我们假设能够显著改进学生模型的良好数据具有可提取的特征,这些特征可以通过分析其内在属性来识别。这种理解至关重要,因为它告诉我们来自良好数据生成器的数据可能具有哪些属性。受 Liu 等人(2023b)的启发,我们通过分析生成数据 的各种属性进行内在评估。
内在评估指标
我们评估(1)指令 的复杂性,(2)响应 的质量,(3)使用学生模型 的 的困惑度,(4)分别指令和响应的多样性:
响应质量:我们衡量给定 时 的质量。我们使用两种方法:
LLM - as - a - Judge 分数:我们提示一个语言模型返回一个介于 1 和 5 之间的离散分数,该分数代表 的质量。我们使用两个语言模型评判者:(1)Prometheus - 2 - 8x7B(Kim 等人,2024),一个专门评估语言模型输出的开源语言模型,以及(2)GPT - 4o,一个广泛用作评判者的专有语言模型。我们为每个领域使用不同的评分标准,列于附录 G。
奖励模型分数:我们使用奖励模型预测一个标量值分数,该分数代表 的质量。我们使用 SkyworkReward - Llama - 3.1 - 8B(Liu 等人,2024a),这是在奖励基准(Lambert 等人,2024)上表现最佳的奖励模型之一。
指令复杂性(LLM - as - a - Judge 分数):我们通过提示一个语言模型返回一个介于 1 和 5 之间的离散分数来衡量 的难度,该分数代表 的复杂性。与评估响应质量类似,我们使用 Prometheus - 2 - 8x7B 和 GPT - 4o 作为评判者。请注意,评分标准与评估响应质量的标准不同,我们为每个领域使用不同的评分标准,列于附录 G。
响应困惑度:我们使用基础模型 (Llama - 3.1 - 8B)测量给定 时 的困惑度。
实例多样性:我们分别测量 中指令的平均余弦相似度和 中响应的平均余弦相似度。这表示每个指令或响应的分布广泛程度(即多样性)(Ni 等人,2024)。我们使用 dunzhang/stella_en_400M_v5,这是一个在 MTEB 基准测试(Muennighoff 等人,2023a)上表现出色且高效的模型。
由于篇幅限制,内在评估的完整结果在附录 E 中进一步详细说明。
实验
受 Ruan 等人(2024)的实验启发,我们进行主成分分析(PCA)以研究内在评估指标是否可以解释 AGORABENCH 结果的变异性。由于我们的内在评估指标之间存在相互依赖性,我们选择 PCA 而不是多元线性回归。
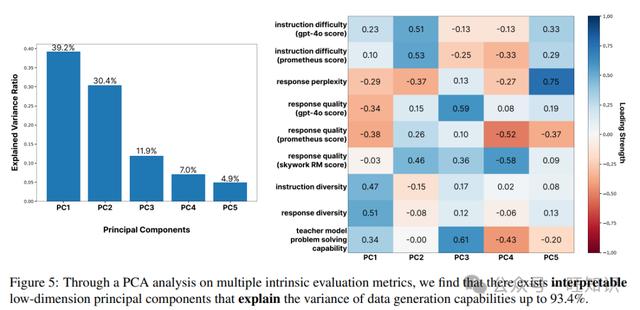
结果如图 5 所示,前五个主成分解释了 AGORABENCH 结果中约 93.4%的方差(分别为 39.2%、30.4%、11.9%、7.0%和 4.9%)。此外,我们发现对成分权重的分析揭示了可解释的模式。第一个主成分(PC - 1)受指令难度和多样性相关指标的强烈影响。第二个成分(PC - 2)受响应质量和指令难度的影响,而第三个成分(PC - 3)结合了多样性相关指标、响应质量和语言模型的解决问题能力。
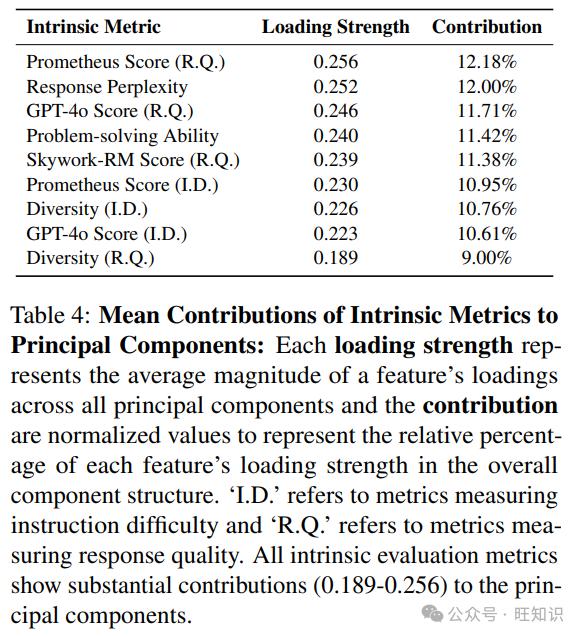
此外,如表 4 所示,当我们分析每个内在评估指标的平均加载强度(所有主成分中一个特征的加载的平均幅度,表示每个指标对数据总体方差的影响程度)时,我们观察到贡献范围从 0.189 到 0.256,表明所有内在评估指标对 PGR 结果的贡献相似。我们还发现,与多样性相关指标或指令难度相关指标相比,响应质量相关指标对 PGR 结果的贡献略强。
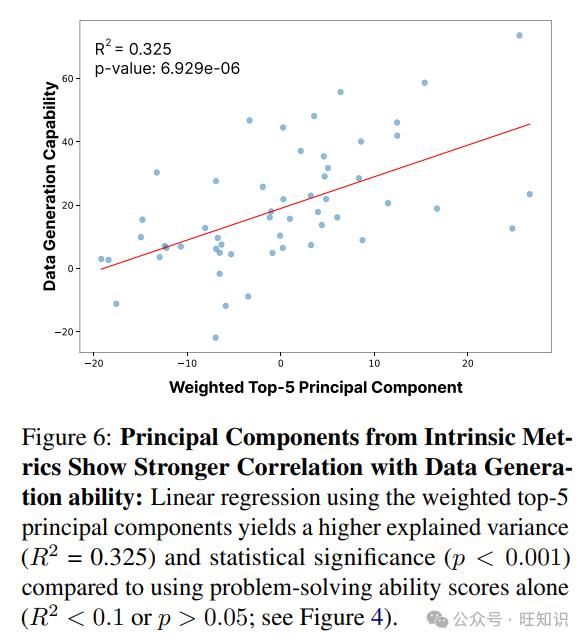
最后,我们通过对前 5 个主成分进行线性回归来预测数据生成能力,通过其相应的回归系数对每个成分进行加权,如图 6 所示。与仅使用解决问题分数相比(图 4),这种方法产生了具有统计显著性的关系(),解释能力提高()。然而,中等的 值表明,可能需要超出我们当前集合的额外内在测量来更好地预测数据生成能力。我们将这个问题的进一步探索留给未来的工作。
6 进一步分析实验
在本节中,我们进一步研究关于数据生成的两个关键问题:(1)我们应该优先使用更便宜的语言模型追求数量,还是使用更昂贵的语言模型追求质量?(第 6.1 节)以及(2)元提示设计的影响是什么,特别是当比较结构化 JSON 格式生成与传统自由格式方法时?(第 6.2 节)
6.1 数量还是质量?
在第 4 节中,我们表明在某些情况下,较便宜的语言模型在生成固定数量的实例时可以比昂贵的语言模型更有效地作为数据生成器,尽管昂贵的模型通常表现更好。这引发了一个实际问题:使用更便宜的模型生成大量实例是否比使用更昂贵的模型生成较少实例更有效?
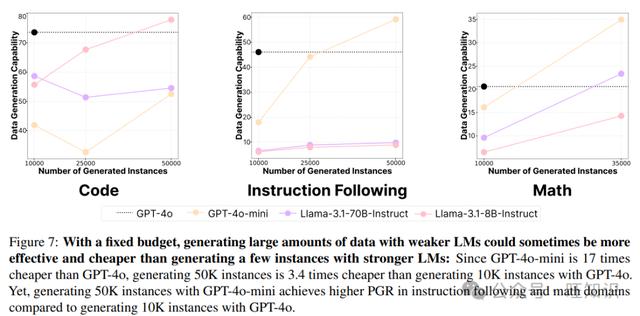
我们扩大实验规模,在实例生成场景中使用 GPT - 4o - mini、Llama - 3.1 - 70B - Instruct 和 Llama - 3.1 - 8B - Instruct 在三个领域中生成多达 50K 个实例。如图 7 所示,使用 GPT - 4o - mini 生成 50K 实例在指令跟随和数学领域的性能优于使用 GPT - 4o 生成 10K 实例,并且 Llama - 3.1 - 8B - Instruct 在代码领域表现出类似的模式。鉴于这些语言模型至少比 GPT - 4o 具有五倍的成本效益,我们的发现表明,使用更实惠的语言模型生成大量合成数据可能比使用昂贵的语言模型生成较小的数据集更具优势。此外,这表明当比较具有不同数量训练实例的两个设置时,指令多样性或响应多样性可能会影响 PGR 结果。
6.2 元提示的影响
最近,Tam 等人(2024)表明,当语言模型以结构化格式(例如 JSON)生成响应时,其解决问题的能力会下降。鉴于从业者在使用语言模型时倾向于结构化输出(Shorten 等人,2024;Liang 等人,2024),研究这种格式是否影响数据生成性能很重要。此外,我们检查元提示设计对生成质量的影响。
为了研究这些问题,我们创建了四个额外的元提示进行比较。对于每个设置(实例生成和质量增强),我们让两位作者创建元提示:一位开发了一个未优化的版本(花费不到 10 分钟),而另一位创建了一个 JSON 格式的版本。
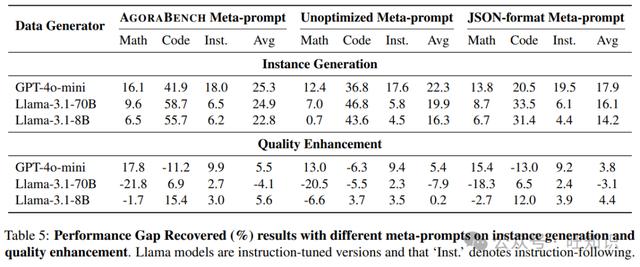
表 5 展示了我们的发现。与其他元提示相比,AGORABENCH 元提示在六个设置中的五个设置中获得了最高分数,展示了 AGORABENCH 设置的稳健性。将 AGORABENCH 元提示与未优化版本进行比较,平均性能差距为 3.97%,突出了元提示优化的重要性。此外,使用自由格式生成的 AGORABENCH 元提示比 JSON 格式提示的性能高 4.45%。这与最近的发现一致,即结构化格式要求可能会损害语言模型的输出质量(Tam 等人,2024)。
7 结论
在本文中,我们引入了 AGORABENCH,这是一个通过标准化设置和指标系统地评估语言模型数据生成能力的基准测试。我们的分析表明,模型在不同的生成方法和领域中表现出独特的优势,突出了仔细选择数据生成器的重要性。虽然语言模型的数据生成能力不能仅由其成本或解决问题的能力预测,但我们从内在评估测量中识别出可解释的低维主成分,这些主成分解释了高达 93.4%的方差,并作为更好的预测指标。
展望未来,我们设想 AGORABENCH 将推动该领域的两个关键进展。首先,由于我们的发现表明解决问题的能力不是数据生成质量的主要决定因素,研究人员可以使用我们的基准测试来识别构成有效数据生成器的核心能力,并有可能开发专门用于数据生成的语言模型。其次,AGORABENCH 可以作为从业者评估和改进其数据生成流程的实用评估框架——他们可以使用自己的自定义数据生成方法、种子数据集或元提示,并与我们的基线设置进行比较。此外,他们可以利用我们的系统评估方法在部署大规模数据创建之前优化其生成参数。通过这些互补的研究和应用方向,AGORABENCH 旨在加速我们对语言模型作为数据生成器的理论理解及其在实际应用中的实际部署。
作者:张长旺,图源:旺知识
参考资料
标题:Evaluating Language Models as Synthetic Data Generators
作者:Seungone Kim, Juyoung Suk, Xiang Yue, Vijay Viswanathan, Seongyun Lee, Yizhong Wang, Kiril Gashteovski, Carolin Lawrence, Sean Welleck, Graham Neubig
单位:Carnegie Mellon University, KAIST AI, University of Washington, NEC Laboratories Europe, Ss. Cyril and Methodius University of Skopje
标签:语言模型、合成数据生成、数据生成能力评估、基准测试
概述:本文提出 AGORABENCH 基准测试,通过标准化设置与指标评估语言模型数据生成能力,揭示模型优势及影响因素,为模型选择和数据生成优化提供依据。
链接:https://arxiv.org/pdf/2412.03679