多模态大模型真实世界个性化能力征途:MDI基准点亮前路
在人工智能领域,人们一直希望开发出能满足不同用户需求的个性化 AI 助手。如今大型多模态模型兴起,但现有的评估基准测试有缺陷,不能很好地判断这些模型是否符合现实中人们的需求以及能否满足不同人群的需要。本文提出的 MDI 基准测试很重要,它能全面评估模型在各种场景、不同问题难度以及不同年龄人群需求方面的表现,通过测试发现了现有模型的不足,有助于推动模型发展,使其能更好地服务人类。
我们翻译解读最新论文,文末有论文信息。
作者:张长旺,图源:旺知识
随着大型多模态模型(LMMs)的发展,现有基准测试难以全面评估其在现实场景中满足人类多样化需求的能力。本文提出 MDI 基准测试,包含 500 多张图像及 1200 多个问题,涉及六个生活场景,并从问题复杂性和年龄两个维度进行评估。通过对 14 个主流 LMMs 实验,发现 GPT-4o 表现最佳,但各模型在不同场景、年龄组和问题复杂性上均存在改进空间,为未来 LMMs 发展提供了方向。
摘要&解读
大型多模态模型(LMMs)领域发展迅速,涌现出多种能力出众的模型。然而,现有的基准测试无法全面、客观、准确地评估 LMMs 在现实场景中是否符合人类的多样化需求。为了填补这一空白,我们提出了多维洞察(MDI)基准测试,其中包含 500 多张涵盖人类生活六种常见场景的图像。值得注意的是,MDI 基准测试相较于现有评估有两个显著优势:(1)每张图像都配有两种类型的问题:简单问题用于评估模型对图像的理解,复杂问题用于评估模型超出基本内容的分析和推理能力。(2)考虑到不同年龄段的人在面对相同场景时具有不同的需求和视角,我们的基准测试将问题分为三个年龄类别:年轻人、中年人和老年人。这种设计能够详细评估 LMMs 满足不同年龄群体偏好和需求的能力。使用 MDI 基准测试,像 GPT4o 这样的强大模型在与年龄相关的任务上达到了 79%的准确率,这表明现有的 LMMs 在解决现实应用问题方面仍有很大的改进空间。展望未来,我们预计 MDI 基准测试将为实现 LMMs 在现实世界中的个性化开辟新途径。MDI 基准测试数据和评估代码可在 https://mdi-benchmark.github.io/ 获取。
研究背景:人工智能从专用小模型向大型多模态模型转变,虽有多种基准测试评估 LMMs,但都未充分关注其满足人类多样化需求和不同群体需求的能力,在此背景下本文开展研究。
技术贡献:
首次提出 MDI 基准测试,全面评估 LMMs 在现实场景中的能力。
基准测试涵盖多方面,包括大量图像和问题,涉及多种场景且有年龄分层,并将年龄因素用于评估指导模型个性化响应。
通过测试发现现有模型在不同场景、年龄和复杂性维度上的表现差异,为后续研究提供方向。
实现设计:
确定评估维度:包括场景维度(基于社会学文献和问卷调查确定六个主要场景)、问题复杂性维度(分为两个级别)、年龄维度(分为三个年龄组)。
数据收集:收集新图像,招募志愿者构建数据团队,通过多种方式生成场景描述搜索图像并分类,利用启发式方法结合知识库和志愿者生成问题。
实验结果:
GPT 系列模型表现突出,闭源模型整体优于开源模型,但部分开源模型有追赶趋势。
模型性能随参数增大有提升趋势,且在不同场景和问题复杂性下表现不同,在教育场景 1 级问题表现较好,体育场景整体较弱,问题越复杂模型性能越低。
不同年龄组中模型表现有差异,GPT-4o 优势明显但整体模型在年龄维度上有提升空间,且中年问题难度相对较高。
1. 引言
开发个性化人工智能(AI)助手以满足不同用户的多样化需求一直是人类的重要追求(Kobsa & Schreck, 2003; Xiao et al., 2018; Kocaballi et al., 2019; Rafieian & Yoganarasimhan, 2023; Pesovski et al., 2024)。在现实场景中,理想的 AI 助手应能够精准满足不同年龄、文化背景和专业领域个体的特定需求。
近年来,人工智能领域发生了重大的范式转变,从为特定简单任务设计的专用小模型(Rawat & Wang, 2017; Zhao et al., 2019; Minaee et al., 2021; Singh et al., 2017)过渡到能够处理复杂任务的统一大型多模态模型(LMMs)(Zhang et al., 2024)。这一范式转变是迈向通用人工智能(AGI)的关键一步,也凸显了 LMMs 成为个性化人类助手的潜力。
为了全面评估 LMMs 的能力,研究人员构建了多个常见的视觉问答基准测试(Goyal et al., 2017; Chen et al., 2015; Marino et al., 2019; Mishra et al., 2019; Biten et al., 2019),用于评估 LMMs 的图文理解和对话能力。然而,这些基准测试仅仅是将答案与标准答案进行比较,对模型的细粒度能力提供的见解有限。为了解决这一局限性,后续的多模态理解基准测试得以开发(Yu et al., 2023b; Liu et al., 2023; Fu et al., 2024a; Ying et al., 2024),涵盖了更广泛的任务和更多的测试样本。这种改进能够更精确地评估模型能力,促进更强大的 LMMs 的发展。尽管如此,当前的基准测试主要关注特定任务的技术指标,忽略了两个关键的研究问题:
问题 1:这些 LMMs 能否真正符合现实场景中人类的实际需求?
问题 2:这些 LMMs 能否满足不同群体的多样化需求?
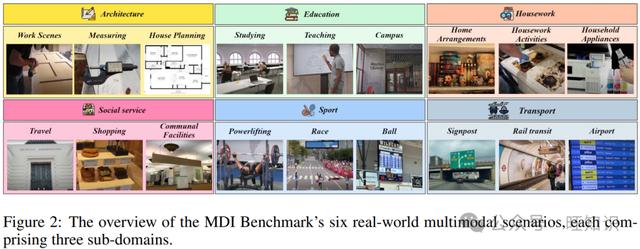
为了应对这些挑战,我们引入了一种新颖的“多维洞察”(MDI)基准测试,它涵盖了各种现实场景、不同的问题复杂性和多样的年龄群体。具体而言,MDI 基准测试由 500 多张现实世界图像和 1200 个人类提出的问题组成。如图 2 所示,它涵盖了人类生活的六个主要场景:建筑、教育、家务、社会服务、体育和交通。此外,MDI 基准测试从以下两个维度对 LMMs 进行评估:
问题复杂性维度:该维度将人类提出的问题分为两个复杂程度级别。第一级评估 LMMs 的基本能力,如目标检测和光学字符识别(OCR)等。第二级评估更复杂的能力,包括逻辑推理、数学计算和知识应用。
年龄维度:年龄是评估个体差异的基本标准,因为不同年龄的人有不同的需求。我们将个体分为三个年龄组:年轻人、中年人和老年人,以评估 LMMs 满足这些群体不同需求和偏好的有效性。我们的目标是全面评估 LMMs 在实际情况下是否能够满足人类的多样化需求。
总之,我们的主要贡献如下:
为了使大型多模态模型符合人类的实际需求,我们首次提出了一个多模态基准测试,用于全面评估 LMMs 在实际现实场景中的能力。
MDI 基准测试包括 500 多张现实世界图像和 1200 个人类提出的问题,涵盖六个现实世界多模态场景。每个场景分为 3 个子域,具有 2 个复杂程度级别。此外,我们将年龄因素纳入评估,以指导 LMMs 为不同人群提供个性化响应。
使用 MDI 基准测试,我们对几个主流 LMMs 进行了全面评估。具体而言,GPT - 4o 在所有指标上取得了最佳结果,但在满足不同年龄群体需求方面仍有很大的改进空间。跨场景、复杂性和年龄等维度的进一步分析为开发可靠的个性化人类助手提供了有价值的见解。
我们希望我们的研究能够推动多模态大型模型在现实场景中的应用,并为多维个性化的发展铺平道路。
2. 相关工作
2.1 多模态数据集和基准测试
为了评估 LMMs 的能力,过去的研究应用了多种基准测试。其中,Flickr30k(Young et al., 2014)、COCO Captions(Chen et al., 2015)和 Nocaps(Agrawal et al., 2019)用于评估 LMMs 的文本生成和图像描述能力。Vizwiz(Bigham et al., 2010)、VQA(Goyal et al., 2017)、GQA(Hudson & Manning, 2019)和 OK - VQA(Marino et al., 2019)用于评估 LMMs 对图像信息的理解和问答能力。对于评估 OCR 能力,采用了 ST - VQA(Biten et al., 2019)和 OCR - VQA(Mishra et al., 2019)等基准测试。DocVQA(Mathew et al., 2021)专门用于评估模型理解和识别文档的能力。
为了进一步探索 LMMs 的细粒度能力,最近的基准测试显著扩展了所评估的任务类型。此类基准测试的示例包括 LVLM - eHub(Xu et al., 2023)、MM - Vet(Yu et al., 2023b)、MMBench(Liu et al., 2023)、SEED - Bench(Li et al., 2023)、MME(Fu et al., 2024a)、MMT - Bench(Ying et al., 2024)、Video - MME(Fu et al., 2024b)、MMMU(Yue et al., 2023)、MMMU - Pro(Yue et al., 2024a)、MathVista(Lu et al., 2024b)、Mathverse(Zhang et al., 2025)、We - Math(Qiao et al., 2024a)和 MMEvol(Luo et al., 2024)。然而,需要注意的是,这些基准测试尚未充分探索 LMMs 满足不同个体多样化需求的能力。因此,我们希望通过 MDI 基准测试更好地探索这一能力。
2.2 大型多模态模型
在许多大型语言模型(LLMs)(Brown et al., 2020; Touvron et al., 2023; Chiang et al., 2023)取得成功的基础上,最近的研究将大型语言模型与视觉编码器相结合,形成了具有强大视觉理解和语义生成能力的 LMMs。已经开发了许多优秀的开源(Hong et al., 2023; Wang et al., 2023; Hu et al., 2024; Lu et al., 2024a; Liu et al., 2024b; Ye et al., 2023; Abdin et al., 2024)和闭源(Team et al., 2023; Bai et al., 2023; OpenAI, 2023; 2024)项目。这一发展进一步增强了实现个性化 AI 助手的潜力。
2.3 个性化研究
为了实现个性化 AI 助手,大型语言模型(LLMs)目前正试图与用户的个性化输出相结合,以增强其个性化能力,使其能够生成符合用户偏好的输出(Wo´zniak et al., 2024; Zhuang et al., 2024b; Baek et al., 2024; Tan et al., 2024)。同时,为了进一步扩展 LLMs 在面对不同需求时的理解能力,个性化数据生成也至关重要(Chan et al., 2024)。在这项工作中,我们利用 MDI 基准测试来评估现有大型多模态模型满足个性化需求的能力,并为未来的 LMMs 研究提供我们的见解。
3. MDI 基准测试
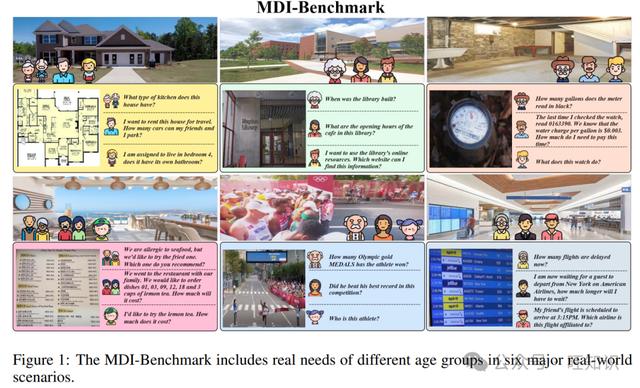
MDI 基准测试样本设计强调信息的现实世界复杂性、场景可变性和年龄差异。人们的信息关注点通常因场景而异。如图 1 所示,一个购买新房的家庭可能会关注与他们密切相关的实际问题,如厨房类型、车库容量和卧室设施。体育赛事的观众可能会关注比赛细节、运动员成绩和比赛进展。
3.1 评估维度
与现有工作相比,MDI 基准测试强调模型在特定任务场景中跨不同年龄和复杂性的现实世界问题上的表现,它由三个不同维度构成:场景、年龄和问题复杂性。
场景维度:从场景的角度来看,MDI 基准测试旨在紧密贴合人类生活的实际需求。与之前 LMMs 评估基准测试侧重于能力评估不同,MDI 基准测试是基于现实生活场景构建的。
为了应对人类在现实生活中面临的各种场景,我们借鉴了社会学文献(Tajfel, 1979; Birmingham et al., 2008; Spears, 2021)中的定义并进行了扩展,确定了 30 个子域场景。在此基础上,我们进行了为期一个月的问卷调查,涵盖不同年龄、性别和职业的人群。共发放了 2500 份问卷,收集到 2374 份有效回复。根据问卷中子域选择的频率,我们选择了前 18 个子域,最终总结为六个主要场景:建筑、教育、家务、社会服务、体育和交通。我们从这些子域中收集图像,以确保该基准测试具有丰富的场景信息。示例见附录 C.1。
问题复杂性维度:在日常人类活动中,复杂程度差异很大,难度的定义往往是主观的。为了简化这一定义,我们以模型的基本能力为原子单位对问题进行了分层量化。基于此标准,我们筛选了调查问题并改进了之前的评估标准。此外,MDI 基准测试分为两个级别:(1)第一级涉及相对简单的问题类型,主要评估模型提取场景信息的能力。这包括检测、光学字符识别、位置识别、颜色识别等基本能力。(2)第二级要求模型巧妙地分析场景信息和用户语义信息,具备逻辑敏锐性,同时整合相关知识以有效满足用户需求。示例见附录 C.2。
年龄维度:年龄是群体分类的一个通用且具体的标准,与基于文化和宗教信仰的分类相比更具客观性。作为每个人都具备的基本属性,年龄易于量化和比较。通过将年龄作为分类维度,我们可以更好地理解不同群体的需求,并评估 LMMs 满足这些多样化需求的能力。为了进行评估和量化,我们确定了三个不同的年龄组:年轻人(10 - 25 岁)、中年(35 - 50 岁)和老年人(60 - 75 岁)。我们让这些年龄段的人参与现实生活场景,询问他们的需求。这些调查结果为 MDI 基准测试的初始版本提供了依据。示例见附录 C.3。
3.2 数据收集
数据源:现有的 LMMs 评估基准测试已被广泛用于评估和训练新模型。为了确保评估结果的准确性,我们收集了 500 多张未包含在现有数据集中的新图像,并从三个年龄组招募了 120 名志愿者。从每个组中抽取 10 名志愿者组成一个 30 人的数据构建团队。主要的数据收集过程如下:首先,在确定场景维度信息后,数据构建团队根据自己的兴趣编写详细的场景信息。同时,我们将场景维度信息输入开源模型(如 GPT - 4o、Gemini 1.5 Pro)和闭源模型(如 LLaVA - Next、MiniCPM),以生成更个性化、多样化和详细的场景描述。此外,人类和模型创建的描述都被用作关键词在互联网上搜索相关图像。同时,我们向志愿者支付足够的工资,大约每小时 7 美元。这些志愿者的任务是将图像分类到六个场景维度中。为了确保数据平衡并尽量减少偏差,我们确保每个年龄组在性别、职业和其他因素方面具有多样性。提供了详细的分类标准和指南,以确保分类的一致性。我们采用交叉验证方法,即每组志愿者筛选图像,我们只保留所有三组都分类相同的图像。此外,还进行了多次验证迭代。这个综合过程有助于构建一个平衡可靠的数据源。
问题和答案生成:在获得收集的图像后,我们使用启发式方法手动生成问题。具体过程如下:(1)知识库构建:具体而言,首先使用多个开源和闭源模型描述图像中的场景内容,并由人类专家进行总结。随后,通过互联网搜索找到与场景内容相关的额外信息,并将图像和这些信息组合形成知识库。(2)生成困难的多项选择题:为了确保生成的问题与图像内容一致,我们邀请参与数据收集阶段的三个不同年龄组的志愿者提交问题。这些志愿者根据图像场景和知识库内容提出不同复杂程度的问题,并创建具有迷惑性的错误选项。(3)问题格式:志愿者提供的图像 - 问题对必须遵循以下格式:[级别]-[年龄]-[场景]。这里,级别包括 1 级和 2 级;年龄包括老年、中年和青年;场景包括建筑、教育、家务、社会服务、体育和交通。最后,一个专家团队筛选和评估志愿者提交的问题,以完成问题的构建。
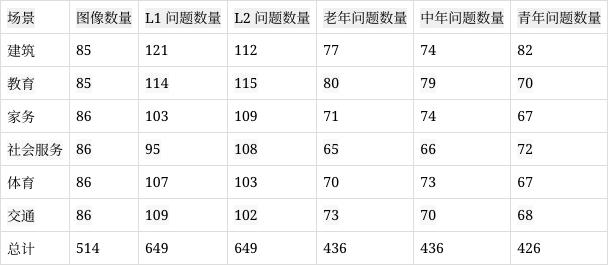
数据统计:MDI 基准测试从三个不同维度收集:场景、年龄组和能力。它总共包括 514 张图像和 1298 个问题,均为新收集的数据。同时,我们努力确保不同场景、年龄和问题复杂性的数据平衡。详细信息见表 1。如图 1 所示,数据集涵盖六个领域,每个领域有三个子域,提供了跨各个领域的全面且结构化的数据构建。
表1:MDI数据集统计
4. 实验
4.1 实验设置
评估协议:为了有效评估模型的输出,我们要求模型在其响应中提供正确答案。基于此,计算响应的准确率。这意味着如果模型表达了正确的概念但未能给出准确答案,将被归类为错误。这种方法强调了模型准确遵循指令的能力,突出了这方面的不足。此外,由于不同模型的提示输入格式不同,我们研究了每个模型的输入格式。然后,我们努力保持提示的一致性,遵循每个模型提供的官方输入格式。这种方法旨在尽量减少提示差异对模型性能的影响。
提示模板:表 4 报告了我们实验中的提示模板。
评估模型:我们研究了两类基础模型在 MDI 基准测试上的性能。(a)闭源模型:GPT - 4o(OpenAI,2024)、GPT - 4V(OpenAI,2023)、Qwen - VL - Plus(Bai 等人,2023)、Gemini 1.5 Pro(Team 等人,2023);(b)开源模型:LLaVA - NeXT - 110B(Liu 等人,2024a)、LLaVA - NeXT - 70B(Liu 等人,2024a)、LLaVA - NeXT - 7B(Liu 等人,2024b)、DeepSeek - VL - 7B、DeepSeek - VL - 1.3B(Lu 等人,2024a)、Phi3 - Vision - 4.2B(Abdin 等人,2024)、MiniCPM - LLaMA3 - V 2.5(Hu 等人,2024)、CogVLM - chat(Wang 等人,2023)、CogAgent - vqa(Hong 等人,2023)、mPLUG - Owl2 - 7B(Ye 等人,2023)。
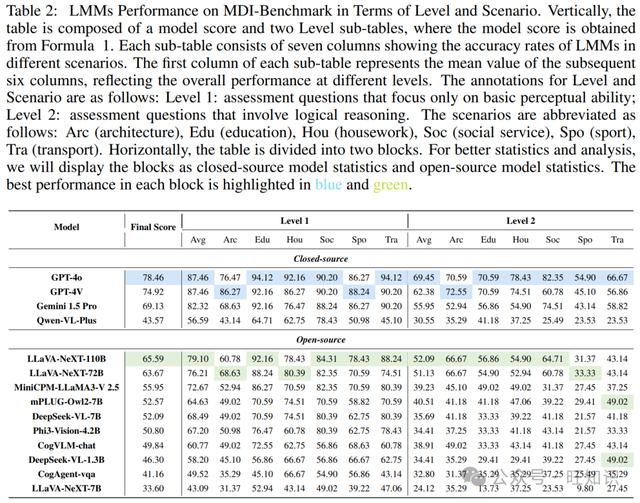
评分指标:表 2 展示了不同 LMMs 在两个问题复杂程度级别和六个场景下的整体性能。为了更好地评估模型所展示的能力,我们定义了评分指标:
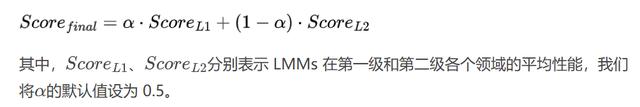
4.2 主要结果
表 2 说明了不同 LMMs 在 MDI 基准测试上的整体性能。我们得出以下见解:
GPT 系列表现出绝对优势。GPT - 4o 在所有模型中领先并获得最高性能得分。还可以观察到闭源模型通常优于开源模型。然而,一些强大的开源模型正在努力追赶闭源模型。例如,LLaVA - NeXT - 110B 和 LLaVA - NeXT - 72B 的表现略逊于 Gemini 1.5 Pro,但优于 Qwen - VL - Plus。
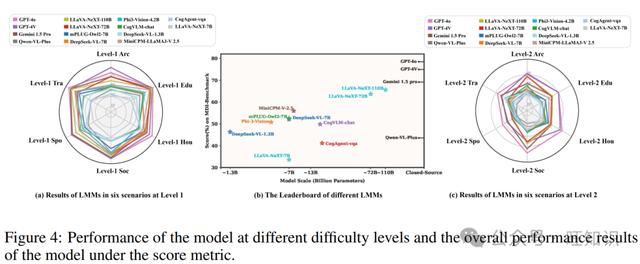
模型性能的缩放现象。此外,由于闭源模型的可用数据有限,我们在开源模型中观察到一些有趣的趋势。我们选择了不同规模下表现最佳的开源模型,从 LLaVA - NeXT - 110B 和 LLaVA - NeXT - 72B 到 MiniCPM - LLaMA3 - V 2.5、DeepSeek - VL - 7B、Phi3 - Vision - 4.2B 和 DeepSeek - VL - 1.3B。如图 4(不同 LMMs 的排行榜)所示,这些模型的最终得分表明,模型参数越大,其解决现实场景问题的能力越强。这与人类经验相符:更大的语言模型参数意味着更多的文本逻辑训练样本和更少的模型蒸馏。在面对更复杂的逻辑推理任务时,这些模型可以利用更多的底层知识和基本能力。
4.3 场景维度分析
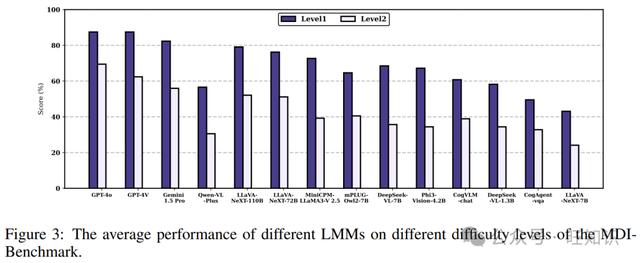
LMMs 在日常场景中的性能仍有很大的提升空间。为了观察不同模型在各个场景中的具体表现,如图 3 所示,我们计算了不同模型在不同领域的准确率。我们发现这 14 个 LMMs 在教育场景的 1 级问题上表现良好。在建筑、家务、交通和社会服务场景中性能较为平衡。然而,在体育场景中的表现存在一些不足,我们认为这与 LMMs 当前的训练数据密切相关。目前,LMMs 研究小组更注重使用现有的互联网文本数据和高质量教材数据来实现更好的训练和测试水平,但忽视了日常生活领域数据集和能力的提升。这就是 MDI 基准测试发挥作用的地方。我们认为体育和交通领域中与逻辑推理相关的问题类型和所需的背景知识比建筑领域更丰富、更广泛,这导致问题难度增加,推理性能差距显著。
4.4 复杂性维度分析
随着问题复杂性的增加,模型性能下降。在同一场景中,对于同一模型,回答问题的准确率也会发生显著变化。例如,对于 GPT - 4o,在表现最佳的教育场景中,准确率从 94.12 降至 70.59。这凸显了问题复杂性对模型性能的显著影响。
不同场景下问题的复杂性在泛化方面呈现出丰富的多样性。为了分析这些 LMMs 在多个级别上的详细性能,我们创建了雷达图(图 4),展示了 14 个 LMMs 在 1 级和 2 级不同场景中的性能。为了说明由于问题复杂性变化导致的宏观性能变化,我们还生成了性能方差和总和的统计数据,在不同轴上绘制平均和方差数据以突出宏观趋势(图 5)。一般来说,平均准确率高且方差低的模型表现出更好、更全面的能力。
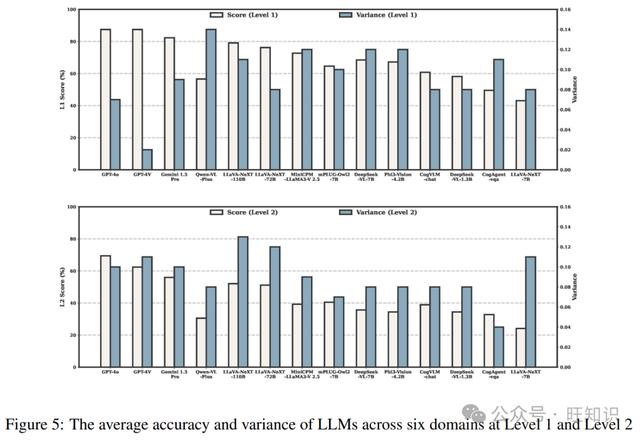
在 1 级检查时,很明显大多数模型表现平衡,如图 4 所示。CogAgent - vqa 和 LLaVA - NeXT - 7B 等模型是这一趋势的明显例外。在 2 级时,GPT - 4o 的方差显著增加,只有 GPT 系列和 Gemini 1.5 Pro 保持平衡性能。如图 4 所示,只有 GPT 系列的性能略有下降,而其他 LMMs 在体育场景中的性能急剧下降。
与先进的闭源 LMMs 相比,开源 LMMs 需要进一步研究特定的日常生活能力和复杂问题场景,以缩小显著差距。值得注意的是,如图 5 所示,LLaVA - NeXT - 72B 在 2 级上的表现与最佳模型 LLaVA - NeXT - 110B 相似,但方差更小,这表明通过有效蒸馏以较小参数实现更好性能是一个值得进一步研究的领域。
我们认为研究社区在这些领域缺乏对增强 LMMs 数据集和能力的关注,以及与逻辑推理相关的问题类型和所需背景知识的多样性和广泛性,在较简单任务中更为明显。这种多样性导致随着问题复杂性的增加,模型的推理性能出现显著差距。因此,需要进一步研究来解决这些差距并提高 LMMs 在复杂问题场景中的性能。
4.5 年龄维度分析
为了进行更直接和宏观的性能分析,我们在主表中仅呈现平均性能统计数据,如表 3 所示,它主要代表了 LMMs 在三个年龄分层中的性能。此外,我们根据年龄组和场景维度详细分析了模型的性能,如附录 D 所示。我们有以下观察结果。
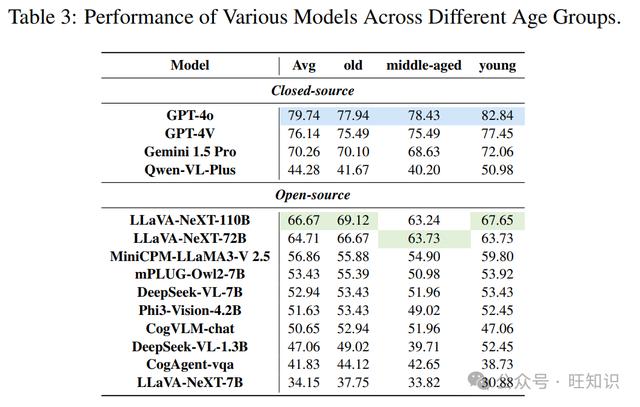
所有模型在水平评估维度下表现各异,但不同年龄之间存在性能差异。如表 3 所示,GPT - 4o 在年龄维度上仍然是表现最佳的模型,比排名最高的开源模型高出 13 分,比排名最低的闭源模型高出 35 分。在年龄分层评估中的这种主导性能突出了 GPT - 4o 的强大泛化能力及其在日常使用场景中的领先地位。然而,从年龄维度评估模型能力时,它揭示了模型在不同群体中的有效性。鉴于个人在日常生活中遇到的众多情况,模型的能力必须全面才能满足人类的多样化需求。不同年龄组之间准确率的下降表明,在这个维度上所有模型的整体性能都有很大的提升空间。这一发现强调了进一步研究年龄相关问题的必要性,并突出了我们工作的必要性和创新性。
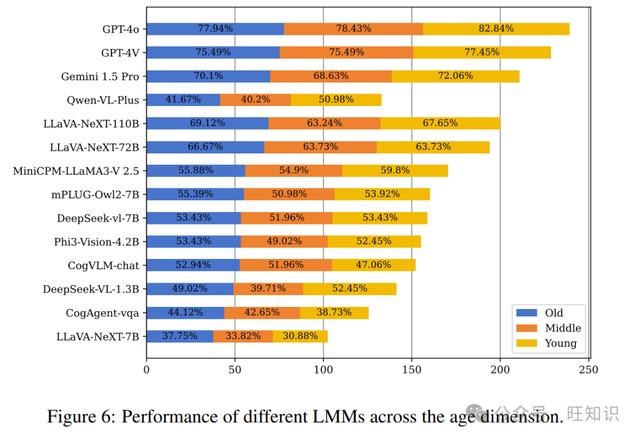
模型在不同年龄维度上的整体泛化能力不足。如图 6 所示,我们进一步可视化了模型在不同年龄组(包括老年、中年、青年)中的性能。通过对年龄维度上的模型结果求和,我们发现老年组总计达到 856.38,中年组为 764.72,青年组为 902.94。这种分布突出了不同年龄水平问题的实际难度顺序:中年 > 老年 > 青年。在现实场景中,中年人的问题往往涵盖更多方面,需要比老年人或年轻人更强的逻辑推理和背景知识。因此,多模态 LMMs 需要具备强大而全面的能力才能有效处理此类问题。GPT - 4o 在这方面表现出色,在所有三个年龄相关类别中表现差距较小。有趣的是,Cog 系列模型尽管拥有最大的视觉编码器,但在青年组中的性能明显下降,这表明其大型视觉编码器的泛化能力不如 CLIP - ViT/L14。
在年龄维度上,语言模型的缩放性能明显,但模型压缩显示出巨大潜力。我们发现,在每个模型层中,具有最大语言模型参数的模型表现最佳。根据经验,我们认为语言模型在 LMMs 中比视觉编码器发挥更重要的作用。此外,我们惊讶地发现 Phi3 - Vision - 4.2B 仅使用约 4.2B 参数就超过了闭源模型 Qwen - VL - Plus 的宏观性能。这表明 LMMs 在模型参数压缩方面仍有很大的探索空间。
5. 结论
在本文中,我们提出了 MDI 基准测试,这是一种用于评估大型多模态模型(LMMs)在多维场景中满足现实世界人类需求能力的工具。MDI 基准测试包括 500 多张图像和 1200 个相应的问题,涵盖人类生活的六个主要方面。此外,我们引入了年龄分层的概念,并根据老年人、中年人和年轻人的需求进行抽样提问,以确保全面评估。使用 MDI 基准测试,我们评估了 14 个现有的 LMMs,揭示了它们在不同场景中的性能偏好。虽然 GPT - 4o 在各种指标上表现最佳,但在所有年龄组和场景中仍存在性能差距。因此,我们建议未来的研究应侧重于提高 LMMs 对人类需求的适应性及其在不同领域和年龄组中的泛化能力。这将为能够有效满足人类需求的下一代 LMMs 铺平道路。
作者:张长旺,图源:旺知识
参考资料
标题:MULTI-DIMENSIONAL INSIGHTS: BENCHMARKING REAL-WORLD PERSONALIZATION IN LARGE MULTIMODAL MODELS
作者:YiFan Zhang1∗, Shanglin Lei2∗, Runqi Qiao1∗, Zhuoma GongQue1, Xiaoshuai Song1, Guanting Dong1, Qiuna Tan1, Zhe Wei1, Peiqing Yang1, Ye Tian1, Yadong Xue1, Xiaofei Wang1, Honggang Zhang1†
单位:1 北京邮电大学;2 华中科技大学
标签:人工智能、大型多模态模型、基准测试、个性化
概述:本文提出了 MDI 基准测试,涵盖多种场景、问题复杂性和年龄组,通过对 14 个 LMMs 评估,揭示其性能差异,为提升模型个性化能力提供方向。
链接:https://arxiv.org/pdf/2412.12606