深度剖析DeepSeek-V3:从架构创新到实验佳绩,解锁语言模型新高
在大语言模型迅速发展的背景下,开源模型不断努力追赶闭源模型。DeepSeek-V3 的出现意义重大,它通过一系列创新架构和策略,在保证训练效率和成本的同时,提升了模型性能,在多个领域的基准测试中表现出色,为开源模型的发展提供了新的强大示例,有助于推动自然语言处理技术的进步。
我们翻译解读最新论文,文末有论文信息。
作者:张长旺,图源:旺知识
本文介绍了 DeepSeek-V3 这一强大的专家混合(MoE)语言模型,其总参数达 671B,每个词元激活 37B 参数。通过采用多头潜在注意力(MLA)和 DeepSeekMoE 架构、无辅助损失的负载均衡策略及多词元预测训练目标等创新点,在 14.8 万亿词元上预训练,并经监督微调与强化学习阶段。实验表明,它在多种基准测试中表现优异,超越其他开源模型且与领先闭源模型相当,训练成本低且过程稳定。
摘要&解读
我们推出了DeepSeek-V3,这是一个强大的专家混合(MoE)语言模型,总参数达6710亿,每个词元(token)激活370亿参数。为实现高效推理和具有成本效益的训练,DeepSeek-V3采用了多头潜在注意力(MLA)和DeepSeekMoE架构,这些架构在DeepSeek-V2中已得到充分验证。此外,DeepSeek-V3率先采用了无辅助损失的负载均衡策略,并设定了多词元预测训练目标以提升性能。我们在14.8万亿个多样且高质量的词元上对DeepSeek-V3进行了预训练,随后通过监督微调与强化学习阶段充分挖掘其能力。综合评估表明,DeepSeek-V3优于其他开源模型,性能可与领先的闭源模型相媲美。尽管性能卓越,但DeepSeek-V3的完整训练仅需278.8万H800 GPU小时。此外,其训练过程极为稳定,在整个训练过程中,未出现任何不可恢复的损失峰值,也无需进行任何回滚操作。模型检查点可在https://github.com/deepseek-ai/DeepSeek-V3获取。
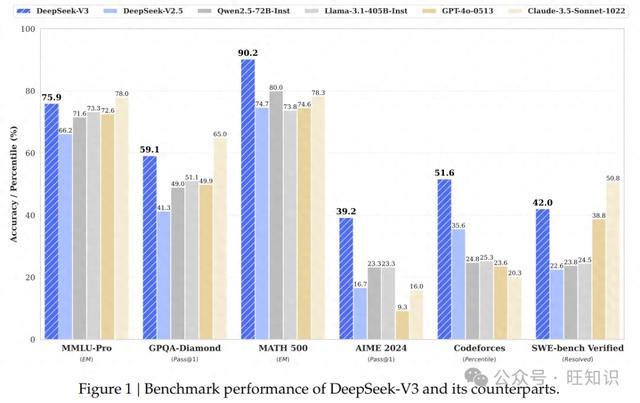
研究背景: 随着大语言模型的快速迭代,开源模型努力缩小与闭源模型的差距。在硬件能力进步的支持下,低精度训练等技术不断发展,促使研究人员探索更高效的模型架构和训练方法,以提升模型性能并降低成本。
研究贡献:架构创新:采用无辅助损失的负载均衡策略减少因负载均衡对性能的影响,引入多词元预测训练目标提升性能。训练创新:设计 FP8 混合精度训练框架并验证其在大规模模型上的有效性,通过算法、框架和硬件协同设计提高训练效率。后训练创新:从 DeepSeek-R1 模型中提取推理能力并应用于 DeepSeek-V3,提升其推理性能。
实现设计:架构实现:基于 Transformer 框架,采用 MLA 进行注意力计算以减少 KV 缓存,DeepSeekMoE 进行前馈神经网络计算并通过特定方式实现负载均衡和路由,多词元预测通过多个顺序模块实现。训练实现:在计算集群上利用 HAI-LLM 框架,采用 DualPipe 算法等优化训练过程,支持 FP8 训练并通过多种策略提升精度和降低开销。推理与部署实现:在 H800 集群上根据不同阶段采用不同的并行方式和专家部署策略,以平衡负载和提高效率。
实验结果:预训练结果:在 14.8 万亿词元上训练稳定,通过长上下文扩展能处理 128K 长度输入,且训练效率高。评估结果:在多种基准测试中,DeepSeek-V3 优于其他开源模型,在代码、数学等领域表现突出,聊天版本与领先闭源模型相当,多词元预测和无辅助损失策略等均提升了模型性能。
1. 引言
近年来,大语言模型(LLMs)迅速迭代与演进(Anthropic, 2024; Google, 2024; OpenAI, 2024a),逐渐缩小了与通用人工智能(AGI)的差距。除闭源模型外,开源模型如DeepSeek系列(DeepSeek-AI, 2024a,b,c; Guo等, 2024)、LLaMA系列(AI@Meta, 2024a,b; Touvron等, 2023a,b)、Qwen系列(Qwen, 2023, 2024a,b)和Mistral系列(Jiang等, 2023; Mistral, 2024)也取得了显著进展,努力缩小与闭源模型的差距。为进一步拓展开源模型的能力边界,我们扩大模型规模并推出DeepSeek-V3,这是一个具有6710亿参数的大型专家混合(MoE)模型,每个词元激活370亿参数。
秉持前瞻性视角,我们始终追求强大的模型性能与经济成本。因此,在架构方面,DeepSeek-V3沿用了用于高效推理的多头潜在注意力(MLA)(DeepSeek-AI, 2024c)和用于经济高效训练的DeepSeekMoE(Dai等, 2024)。这两种架构在DeepSeek-V2中已得到验证,表明它们能够在实现高效训练和推理的同时保持稳健的模型性能。在基础架构之上,我们实施了两项额外策略以进一步增强模型能力。首先,DeepSeek-V3率先采用无辅助损失的负载均衡策略(Wang等, 2024a),旨在最大程度减少因促进负载均衡而对模型性能产生的不利影响。其次,DeepSeek-V3采用了多词元预测训练目标,经观察发现该目标可提升评估基准上的整体性能。
为实现高效训练,我们支持FP8混合精度训练,并对训练框架进行全面优化。低精度训练已成为高效训练的有前途的解决方案(Dettmers等, 2022; Kalamkar等, 2019; Narang等, 2017; Peng等, 2023b),其发展与硬件能力的进步密切相关(Luo等, 2024; Micikevicius等, 2022; Rouhani等, 2023a)。在这项工作中,我们引入了FP8混合精度训练框架,并首次在超大规模模型上验证了其有效性。通过支持FP8计算和存储,我们实现了加速训练并减少了GPU内存使用。对于训练框架,我们设计了双管道(DualPipe)算法以实现高效的流水线并行,该算法减少了流水线气泡,并通过计算 - 通信重叠隐藏了训练期间的大部分通信。这种重叠确保了随着模型进一步扩展,只要我们保持恒定的计算与通信比率,就能够在节点间使用细粒度专家的同时实现近乎零的全对全通信开销。此外,我们还开发了高效的跨节点全对全通信内核,以充分利用InfiniBand(IB)和NVLink带宽。再者,我们精心优化了内存占用,使得无需使用昂贵的张量并行即可训练DeepSeek-V3。通过这些努力,我们实现了高训练效率。
在预训练期间,我们在14.8万亿个高质量且多样的词元上训练DeepSeek-V3。预训练过程极为稳定,在整个训练过程中,未遇到任何不可恢复的损失峰值,也无需回滚。接下来,我们对DeepSeek-V3进行了两阶段的上下文长度扩展。在第一阶段,将最大上下文长度扩展到32K,在第二阶段进一步扩展到128K。随后,我们对DeepSeek-V3的基础模型进行后训练,包括监督微调(SFT)和强化学习(RL),使其与人类偏好对齐并进一步释放其潜力。在后训练阶段,我们从DeepSeek-R1系列模型中提取推理能力,并精心维持模型准确性与生成长度之间的平衡。
我们在一系列综合基准上对DeepSeek-V3进行评估。尽管训练成本经济,但综合评估显示DeepSeek-V3 - Base已成为目前最强的开源基础模型,尤其在代码和数学方面。其聊天版本在一系列标准和开放式基准测试中也优于其他开源模型,性能可与领先的闭源模型(如GPT-4o和Claude-3.5-Sonnet)相媲美。
最后,我们再次强调DeepSeek-V3的经济训练成本,如表1所示,这是通过我们对算法、框架和硬件的优化协同设计实现的。在预训练阶段,在每万亿词元上训练DeepSeek-V3仅需18万H800 GPU小时,即在我们拥有2048个H800 GPU的集群上耗时3.7天。因此,我们的预训练阶段在不到两个月的时间内完成,耗时266.4万GPU小时。加上11.9万GPU小时的上下文长度扩展和5千GPU小时的后训练,DeepSeek-V3的完整训练仅需278.8万GPU小时。假设H800 GPU的租赁价格为每GPU小时2美元,我们的总训练成本仅为557.6万美元。需要注意的是,上述成本仅包括DeepSeek-V3的正式训练,不包括先前在架构、算法或数据方面的研究和消融实验相关成本。
我们的主要贡献包括:
架构:创新的负载均衡策略和训练目标在DeepSeek-V2的高效架构基础上,率先采用无辅助损失的负载均衡策略,最大限度地减少了因促进负载均衡而导致的性能下降。研究了多词元预测(MTP)目标,并证明其对模型性能有益。它还可用于推理加速的推测解码。
预训练:迈向极致训练效率设计了FP8混合精度训练框架,并首次在超大规模模型上验证了FP8训练的可行性和有效性。通过算法、框架和硬件的协同设计,克服了跨节点MoE训练中的通信瓶颈,实现了近乎完全的计算 - 通信重叠。这显著提高了我们的训练效率并降低了训练成本,使我们能够在不增加额外开销的情况下进一步扩大模型规模。以仅266.4万H800 GPU小时的经济成本,我们在14.8万亿词元上完成了DeepSeek-V3的预训练,生成了目前最强的开源基础模型。预训练后的后续训练阶段仅需0.1万GPU小时。
后训练:从DeepSeek-R1中提取知识引入了一种创新方法,将推理能力从长思维链(CoT)模型(特别是DeepSeek R1系列模型之一)提取到标准大语言模型中,尤其是DeepSeek-V3。我们的流程巧妙地将R1的验证和反思模式融入DeepSeek-V3,并显著提高了其推理性能。同时,我们也保持了对DeepSeek-V3输出风格和长度的控制。
2. 架构
我们首先介绍DeepSeek-V3的基础架构,其采用多头潜在注意力(MLA)(DeepSeek-AI, 2024c)实现高效推理,并采用DeepSeekMoE(Dai等, 2024)实现经济高效训练。然后,我们提出了多词元预测(MTP)训练目标,经观察发现该目标可提升评估基准上的整体性能。对于未明确提及的其他次要细节,DeepSeek-V3遵循DeepSeek-V2(DeepSeek-AI, 2024c)的设置。
2.1 基础架构
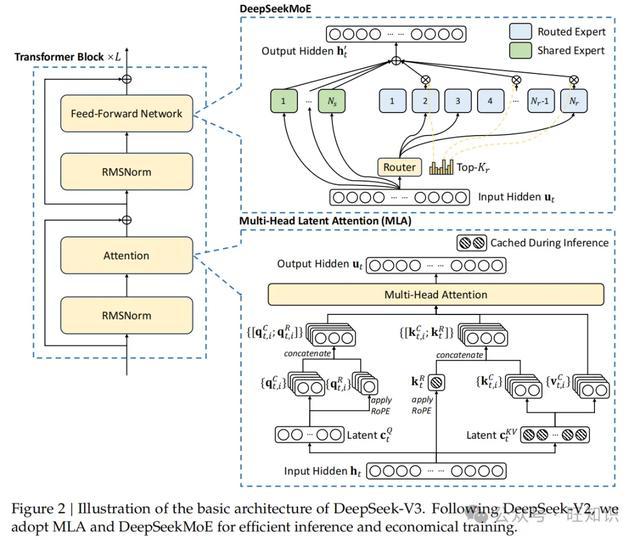
DeepSeek-V3的基础架构仍在Transformer(Vaswani等, 2017)框架内。为实现高效推理和经济高效训练,DeepSeek-V3也采用了MLA和DeepSeekMoE,这在DeepSeek-V2中已得到充分验证。与DeepSeek-V2相比,一个例外是我们为DeepSeekMoE额外引入了无辅助损失的负载均衡策略(Wang等, 2024a),以缓解因确保负载平衡而导致的性能下降。图2展示了DeepSeek-V3的基础架构,在本节中我们将简要回顾MLA和DeepSeekMoE的细节。
2.1.1 多头潜在注意力
对于注意力机制,DeepSeek-V3采用MLA架构。设d表示嵌入维度,nh表示注意力头数,dh表示每个头的维度,ht∈Rd表示在给定注意力层中第tt个词元的注意力输入。MLA的核心是对注意力键和值进行低秩联合压缩,以减少推理期间的键值(KV)缓存:
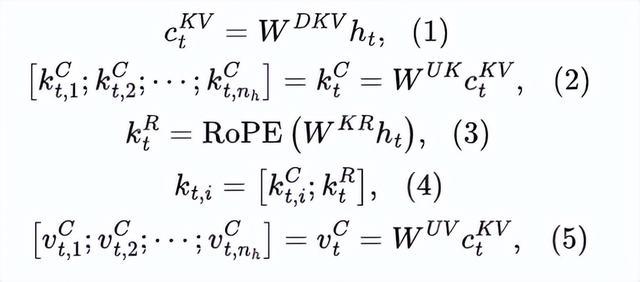
其中ctKV∈Rdc是键和值的压缩潜在向量;dc(≪dhnh)表示KV压缩维度;WDKV∈Rdc×d表示下投影矩阵;WUK,WUV∈Rdhnh×dc分别是键和值的上投影矩阵;WKR∈RdhR×d是用于生成携带旋转位置嵌入(RoPE)(Su等, 2024)的解耦键的矩阵;RoPE表示应用RoPE矩阵的操作;[⋯ ][⋯]表示连接。需要注意的是,对于MLA,在生成过程中仅需缓存蓝色框内的向量(即ctKVctKV和ktRktR),这在保持与标准多头注意力(MHA)(Vaswani等, 2017)相当性能的同时,显著减少了KV缓存。
对于注意力查询,我们也进行低秩压缩,这可以减少训练期间的激活内存:
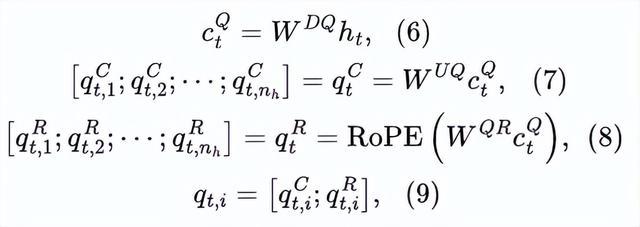
其中ctQ∈Rdc′是查询的压缩潜在向量;dc′(≪dhnh)表示查询压缩维度;WDQˉ∈Rdc′×d,WUQ∈Rdhnh×dc′分别是查询的下投影和上投影矩阵;WQR∈RdhRnh×dc′是用于生成携带RoPE的解耦查询的矩阵。
最终,注意力查询(qt,i)、键(kj,i)和值(vj,iC)相结合,产生最终的注意力输出ur:
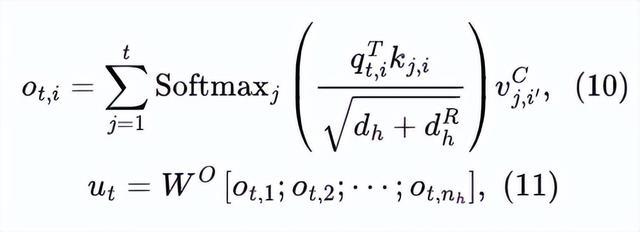
其中WO∈Rd×dhnh表示输出投影矩阵。
2.1.2 采用无辅助损失负载均衡的 DeepSeekMoE
DeepSeekMoE的基础架构:对于前馈神经网络(FFNs),DeepSeek-V3 采用 DeepSeekMoE 架构(Dai 等, 2024)。与传统的 MoE 架构(如 GShard(Lepikhin 等, 2021))相比,DeepSeekMoE 使用更细粒度的专家,并隔离出一些专家作为共享专家。设utut表示第tt个词元的 FFN 输入,我们计算 FFN 输出ht′如下:
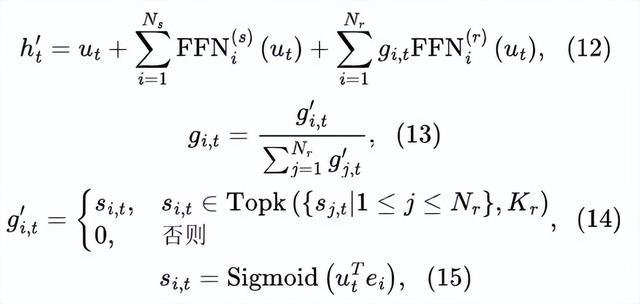
其中Ns和Nr分别表示共享专家和路由专家的数量;FFNi(s)(⋅)和FFNi(r)(⋅)分别表示第i个共享专家和第i个路由专家;Kr表示激活的路由专家数量;gi,t是第i个专家的门控值;si,t是词元 - 专家亲和力;ei是第i个路由专家的质心向量;Topk(⋅,K)表示由第t个词元与所有路由专家计算出的亲和力得分中前K个最高得分组成的集合。与 DeepSeek-V2 略有不同,DeepSeek-V3 使用 Sigmoid 函数计算亲和力得分,并在所有选定的亲和力得分中进行归一化以产生门控值。
无辅助损失负载均衡:对于 MoE 模型,专家负载不平衡会导致路由崩溃(Shazeer 等, 2017),并在专家并行场景下降低计算效率。传统解决方案通常依赖辅助损失(Fedus 等, 2021; Lepikhin 等, 2021)来避免不平衡负载。然而,过大的辅助损失会损害模型性能(Wang 等, 2024a)。为了在负载均衡和模型性能之间实现更好的权衡,我们率先采用无辅助损失的负载均衡策略(Wang 等, 2024a)来确保负载平衡。具体而言,我们为每个专家引入一个偏差项bibi,并将其添加到相应的亲和力得分si,t中以确定前K路由:
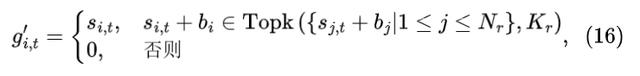
需要注意的是,偏差项仅用于路由。与 FFN 输出相乘的门控值仍由原始亲和力得分si,t得出。在训练过程中,我们持续监测每个训练步骤中整个批次的专家负载。在每个步骤结束时,如果其对应的专家过载,我们将偏差项减少γ;如果其对应的专家欠载,我们将偏差项增加γ,其中γ是一个称为偏差更新速度的超参数。通过动态调整,DeepSeek-V3 在训练期间保持专家负载平衡,并比通过纯辅助损失促进负载平衡的模型实现了更好的性能。
互补的序列级辅助损失:虽然 DeepSeek-V3 主要依赖无辅助损失策略来实现负载平衡,但为了防止任何单个序列内的极端不平衡,我们也采用了互补的序列级平衡损失:
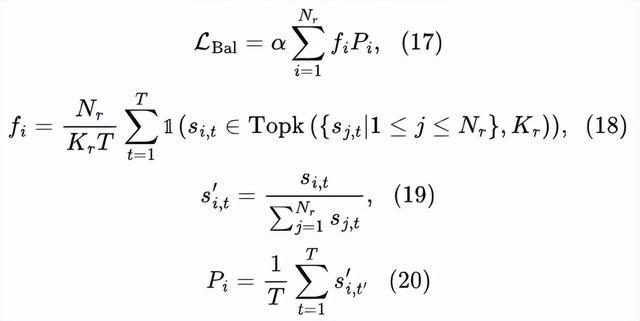
其中平衡因子α是一个超参数,对于 DeepSeek-V3,其被赋予一个极小的值;11表示指示函数;TT表示序列中的词元数量。序列级平衡损失鼓励每个序列上的专家负载保持平衡。
节点限制路由:与 DeepSeek-V2 使用的设备限制路由类似,DeepSeek-V3 也使用受限路由机制来限制训练期间的通信成本。简而言之,我们确保每个词元最多被发送到MM个节点,这些节点是根据分布在每个节点上的专家的最高KrMMKr亲和力得分之和来选择的。在这种约束下,我们的 MoE 训练框架几乎可以实现完全的计算 - 通信重叠。
无词元丢弃:由于有效的负载均衡策略,DeepSeek-V3 在整个训练过程中保持良好的负载平衡。因此,DeepSeek-V3 在训练期间不会丢弃任何词元。此外,我们还实施了特定的部署策略以确保推理负载平衡,所以 DeepSeek-V3 在推理期间也不会丢弃词元。
2.2 多词元预测
受 Gloeckle 等(2024)的启发,我们为 DeepSeek-V3 研究并设定了多词元预测(MTP)目标,该目标将预测范围扩展到每个位置的多个未来词元。一方面,MTP 目标使训练信号更密集,可能提高数据效率。另一方面,MTP 可能使模型能够预先规划其表示,以便更好地预测未来词元。图 3 展示了我们的 MTP 实现方式。与 Gloeckle 等(2024)不同,他们使用独立的输出头并行预测DD个额外词元,我们顺序预测额外词元,并在每个预测深度保持完整的因果链。在本节中,我们将介绍 MTP 实现的细节。
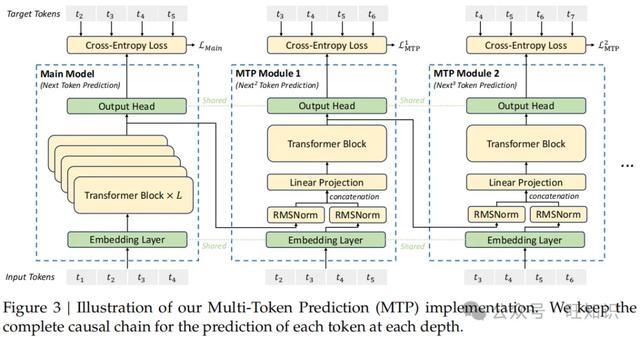
MTP 模块:具体而言,我们的 MTP 实现使用DD个顺序模块来预测DD个额外词元。第k个 MTP 模块由一个共享嵌入Emb、一个共享输出头OutHead、一个 Transformer 块TRMk(⋅)和一个投影矩阵Mk∈Rd×2d组成。对于第i个输入词元titi,在第k个预测深度,我们首先将第i个词元在第k−1深度的表示hik−1∈Rd与第(i+k)个词元的嵌入Emb(ti+k)∈Rd通过线性投影相结合:
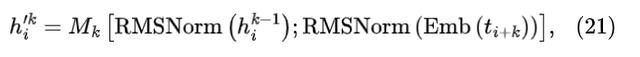
其中[⋯ ][⋯]表示连接。特别地,当k=1时,hik−1指的是主模型给出的表示。需要注意的是,对于每个 MTP 模块,其嵌入层与主模型共享。组合后的hi′k作为第kk个深度的 Transformer 块的输入,以产生当前深度的输出表示hik:
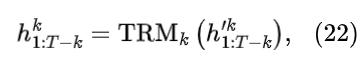
其中T表示输入序列长度,i:j表示切片操作(包括左右边界)。最后,以hik为输入,共享输出头将计算第k个额外预测词元Pi+1+kk∈RV的概率分布,其中V是词汇表大小:
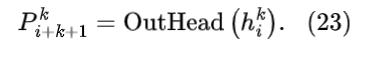
输出头OutHead(⋅)将表示线性映射到 logits,然后应用 Softmax 函数计算第kk个额外词元的预测概率。同样,对于每个 MTP 模块,其输出头与主模型共享。我们保持预测因果链的原则与 EAGLE(Li 等, 2024b)类似,但 EAGLE 的主要目标是推测解码(Leviathan 等, 2023; Xia 等, 2023),而我们利用 MTP 来改进训练。
MTP 训练目标:对于每个预测深度,我们计算交叉熵损失LMTPk:
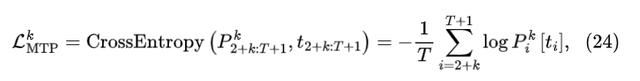
其中T表示输入序列长度,titi表示第ii个位置的真实词元,Pik[ti]表示由第k个 MTP 模块给出的ti的相应预测概率。最后,我们计算所有深度的 MTP 损失的平均值,并乘以一个权重因子λλ以获得总体 MTP 损失LMTP,它作为 DeepSeek-V3 的一个额外训练目标:
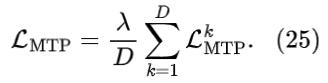
MTP 在推理中的应用:我们的 MTP 策略主要旨在提高主模型的性能,因此在推理过程中,我们可以直接丢弃 MTP 模块,主模型可以独立且正常地运行。此外,我们也可以将这些 MTP 模块重新用于推测解码,以进一步提高生成延迟。
3. 基础设施
3.1 计算集群
DeepSeek-V3 在一个配备 2048 个 NVIDIA H800 GPU 的集群上进行训练。H800 集群中的每个节点包含 8 个 GPU,通过节点内的 NVLink 和 NVSwitch 连接。在不同节点之间,使用 InfiniBand(IB)互连来促进通信。
3.2 训练框架
DeepSeek-V3 的训练由 HAI-LLM 框架支持,这是一个由我们的工程师从头开始构建的高效且轻量级的训练框架。总体而言,DeepSeek-V3 应用 16 路流水线并行(PP)(Qi 等, 2023a)、跨 8 个节点的 64 路专家并行(EP)(Lepikhin 等, 2021)和 ZeRO-1 数据并行(DP)(Rajbhandari 等, 2020)。
为了促进 DeepSeek-V3 的高效训练,我们实施了细致的工程优化。首先,我们设计了双管道算法以实现高效的流水线并行。与现有的 PP 方法相比,双管道算法减少了流水线气泡。更重要的是,它在正向和反向过程中重叠计算和通信阶段,从而解决了跨节点专家并行带来的高通信开销挑战。其次,我们开发了高效的跨节点全对全通信内核,以充分利用 IB 和 NVLink 带宽,并节省专用于通信的流多处理器(SMs)。最后,我们在训练期间精心优化内存占用,从而能够在不使用昂贵的张量并行的情况下训练 DeepSeek-V3。
3.2.1 双管道与计算 - 通信重叠
对于 DeepSeek-V3,跨节点专家并行引入的通信开销导致计算与通信比率约为 1:1,效率低下。为了解决这个挑战,我们设计了一种创新的流水线并行算法——双管道(DualPipe),它不仅通过有效地重叠正向和反向计算 - 通信阶段来加速模型训练,还减少了流水线气泡。
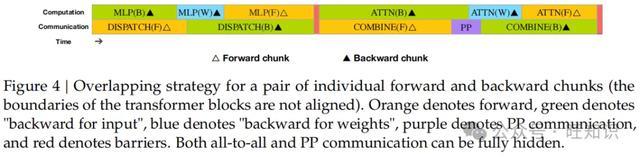
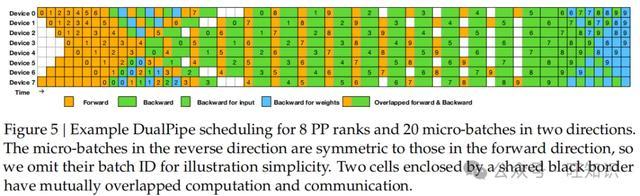
双管道的关键思想是在一对单独的正向和反向块内重叠计算和通信。具体而言,我们将每个块分为四个组件:注意力、全对全分发、MLP 和全对全合并。特别地,对于反向块,注意力和 MLP 都进一步分为两部分,即输入反向和权重反向,如同在 ZeroBubble(Qi 等, 2023b)中一样。此外,我们还有一个 PP 通信组件。如图 4 所示,对于一对正向和反向块,我们重新排列这些组件并手动调整专用于通信与计算的 GPU SMs 比例。在这种重叠策略下,我们可以确保在执行过程中全对全和 PP 通信都能完全隐藏。鉴于高效的重叠策略,完整的双管道调度如图 5 所示。它采用双向流水线调度,同时从流水线的两端输入微批次,并且大部分通信可以完全重叠。这种重叠还确保了随着模型进一步扩展,只要我们保持恒定的计算与通信比率,我们就可以在节点间使用细粒度专家的同时实现近乎零的全对全通信开销。
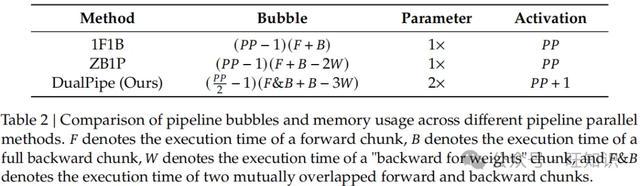
此外,即使在没有高通信负担的更一般场景中,双管道仍然具有效率优势。在表 2 中,我们总结了不同流水线并行方法的流水线气泡和内存使用情况。如表所示,与 ZB1P(Qi 等, 2023b)和 1F1B(Harlap 等, 2018)相比,双管道显著减少了流水线气泡,同时仅将峰值激活内存增加了1PPPP1倍。虽然双管道需要保留两份模型参数,但由于我们在训练期间使用较大的 EP 大小,这并不会显著增加内存消耗。与 Chimera(Li 和 Hoefler, 2021)相比,双管道仅要求流水线阶段和微批次能被 2 整除,而不要求微批次能被流水线阶段整除。此外,对于双管道,气泡和激活内存都不会随着微批次数量的增加而增加。
3.2.2 高效实现跨节点全对全通信
为了确保双管道有足够的计算性能,我们定制了高效的跨节点全对全通信内核(包括分发和合并),以节省专用于通信的 SMs 数量。内核的实现与 MoE 门控算法和我们集群的网络拓扑协同设计。具体而言,在我们的集群中,跨节点 GPU 通过 IB 完全互连,节点内通信通过 NVLink 处理。NVLink 提供 160 GB/s 的带宽,大约是 IB(50 GB/s)的 3.2 倍。为了有效利用 IB 和 NVLink 的不同带宽,我们限制每个词元最多被分发到 4 个节点,从而减少 IB 流量。对于每个词元,当做出路由决策时,它首先通过 IB 传输到目标节点上具有相同节点内索引的 GPU。一旦到达目标节点,我们将努力确保它通过 NVLink 立即转发到承载其目标专家的特定 GPU,而不会被后续到达的词元阻塞。通过这种方式,IB 和 NVLink 上的通信完全重叠,每个词元可以在不产生 NVLink 额外开销的情况下,平均每个节点高效地选择 3.2 个专家。
这意味着,尽管 DeepSeek-V3 在实际中仅选择 8 个路由专家,但在保持相同通信成本的情况下,它最多可以将这个数字扩展到 13 个专家(4 个节点×每个节点 3.2 个专家)。总体而言,在这样的通信策略下,仅需 20 个 SM 就足以充分利用 IB 和 NVLink 的带宽。
具体来说,我们采用线程束(warp)专门化技术(Bauer 等, 2014),并将 20 个 SM 划分为 10 个通信通道。在分发过程中,(1)IB 发送、(2)IB 到 NVLink 转发和(3)NVLink 接收由各自的线程束处理。分配给每个通信任务的线程束数量根据所有 SM 上的实际工作量动态调整。类似地,在合并过程中,(1)NVLink 发送、(2)NVLink 到 IB 转发和累积以及(3)IB 接收和累积也由动态调整的线程束处理。此外,分发和合并内核与计算流重叠,因此我们也考虑它们对其他 SM 计算内核的影响。具体而言,我们采用定制的 PTX(并行线程执行)指令并自动调整通信块大小,这显著减少了 L2 缓存的使用和对其他 SM 的干扰。
3.2.3 以极小开销实现极致内存节省
为了减少训练期间的内存占用,我们采用了以下技术:
重新计算 RMSNorm 和 MLA 上投影:我们在反向传播期间重新计算所有 RMSNorm 操作和 MLA 上投影,从而无需持久存储它们的输出激活。以极小的开销,此策略显著减少了存储激活所需的内存。
CPU 中的指数移动平均:在训练期间,我们保留模型参数的指数移动平均(EMA),以便在学习率衰减后早期估计模型性能。EMA 参数存储在 CPU 内存中,并在每个训练步骤后异步更新。此方法使我们能够维护 EMA 参数,而不会产生额外的内存或时间开销。
多词元预测的共享嵌入和输出头:通过双管道策略,我们将模型的最浅层(包括嵌入层)和最深层(包括输出头)部署在相同的 PP 等级上。这种安排使得 MTP 模块和主模型之间能够物理共享共享嵌入和输出头的参数和梯度。这种物理共享机制进一步提高了我们的内存效率。
3.3 FP8 训练
受近期低精度训练进展的启发(Dettmers 等, 2022; Noune 等, 2022; Peng 等, 2023b),我们提出了一个利用 FP8 数据格式训练 DeepSeek-V3 的细粒度混合精度框架。虽然低精度训练前景广阔,但它通常受到激活、权重和梯度中异常值的限制(Fishman 等, 2024; He 等; Sun 等, 2024)。尽管在推理量化方面取得了显著进展(Frantar 等, 2022; Xiao 等, 2023),但在大规模语言模型预训练中成功应用低精度技术的研究相对较少(Fishman 等, 2024)。为了应对这一挑战并有效扩展 FP8 格式的动态范围,我们引入了一种细粒度量化策略:具有1×Nc1×Nc个元素的 tile 级分组或具有Nc×NcNc×Nc个元素的块级分组。在我们增加精度的累加过程中,相关的反量化开销在很大程度上得到缓解,这是实现准确 FP8 通用矩阵乘法(GEMM)的关键方面。此外,为了进一步减少 MoE 训练中的内存和通信开销,我们以 FP8 缓存和分发激活,同时以 BF16 存储低精度优化器状态。我们在与 DeepSeek-V2-Lite 和 DeepSeek-V2 类似的两个模型规模上验证了所提出的 FP8 混合精度框架,训练了大约 1 万亿个词元(更多细节见附录 B.1)。值得注意的是,与 BF16 基线相比,我们的 FP8 训练模型的相对损失误差始终低于 0.25%,这在训练随机性的可接受范围内。
3.3.1 混合精度框架
基于在低精度训练中广泛采用的技术(Kalamkar 等, 1995; Narang 等, 2017),我们提出了一个用于 FP8 训练的混合精度框架。在这个框架中,大多数计算密集型操作以 FP8 进行,而一些关键操作则策略性地保持在其原始数据格式中,以平衡训练效率和数值稳定性。整体框架如图 6 所示。
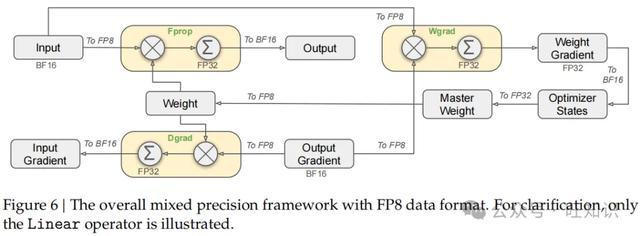
首先,为了加速模型训练,大多数核心计算内核,即 GEMM 操作,以 FP8 精度实现。这些 GEMM 操作接受 FP8 张量作为输入,并产生 BF16 或 FP32 的输出。如图 6 所示,与线性算子相关的所有三个 GEMM,即前向传播(Fprop)、激活反向传播(Dgrad)和权重反向传播(Wgrad),都在 FP8 中执行。与原始 BF16 方法相比,这种设计在理论上使计算速度翻倍。此外,FP8 Wgrad GEMM 允许激活以 FP8 存储以供反向传播使用,这显著减少了内存消耗。
尽管 FP8 格式具有效率优势,但某些算子由于对低精度计算敏感,仍然需要更高的精度。此外,一些低成本算子也可以以可忽略的开销利用更高精度,而不会对整体训练成本产生重大影响。出于这个原因,经过仔细研究,我们对以下组件保持原始精度(例如 BF16 或 FP32):嵌入模块、输出头、MoE 门控模块、归一化算子和注意力算子。这些有针对性的高精度保留确保了 DeepSeek-V3 的稳定训练动态。为了进一步保证数值稳定性,我们以更高精度存储主权重、权重梯度和优化器状态。虽然这些高精度组件会产生一些内存开销,但在我们的分布式训练系统中,通过在多个 DP 等级上进行高效分片,可以将其影响降至最低。
3.3.2 量化与乘法精度提升
基于我们的混合精度 FP8 框架,我们引入了几种策略来提高低精度训练的准确性,重点关注量化方法和乘法过程。
细粒度量化:在低精度训练框架中,由于 FP8 格式的动态范围有限(受其减少的指数位限制),溢出和下溢是常见的挑战。作为标准做法,通过将输入张量的最大绝对值缩放为 FP8 的最大可表示值,使输入分布与 FP8 格式的可表示范围对齐(Narang 等, 2017)。这种方法使低精度训练对激活异常值高度敏感,这可能会严重降低量化准确性。为了解决这个问题,我们提出了一种细粒度量化方法,在更细粒度的级别上应用缩放。如图 7(a)所示,(1)对于激活,我们以1×128 tile(即每个词元每个 128 通道)为基础对元素进行分组和缩放;(2)对于权重,我们以128×128块(即每个 128 输入通道每个 128 输出通道)为基础对元素进行分组和缩放。这种方法确保量化过程能够通过根据较小的元素组调整缩放来更好地适应异常值。在附录 B.2 中,我们进一步讨论了当我们以与权重量化相同的方式对激活进行块级分组和缩放时的训练不稳定性。
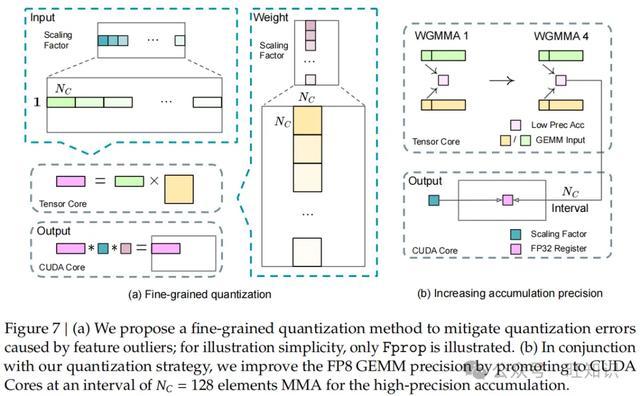
我们方法的一个关键修改是引入了沿 GEMM 操作内维度的每组缩放因子。这一功能在标准 FP8 GEMM 中不直接支持。然而,结合我们精确的 FP32 累加策略,可以有效地实现。
值得注意的是,我们的细粒度量化策略与微缩放格式的思想高度一致(Rouhani 等, 2023b),而 NVIDIA 下一代 GPU(Blackwell 系列)的 Tensor Cores 已宣布支持具有更小量化粒度的微缩放格式(NVIDIA, 2024a)。我们希望我们的设计能够为未来的工作提供参考,以跟上最新的 GPU 架构。
提高累加精度:低精度 GEMM 操作经常遭受下溢问题,其准确性在很大程度上依赖于高精度累加,通常以 FP32 精度执行(Kalamkar 等, 1995; Narang 等, 2017)。然而,我们观察到 NVIDIA H800 GPU 上 FP8 GEMM 的累加精度仅限于保留约 14 位,这明显低于 FP32 累加精度。当内部维度KK较大时(Wortsman 等, 2023),这个问题会变得更加明显,这是大规模模型训练中增加批量大小和模型宽度的典型场景。以两个随机矩阵的 GEMM 操作(K=4096K=4096)为例,在我们的初步测试中,Tensor Cores 中有限的累加精度导致最大相对误差接近 2%。尽管存在这些问题,有限的累加精度仍然是一些 FP8 框架(NVIDIA, 2024b)中的默认选项,严重限制了训练准确性。
为了解决这个问题,我们采用了提升到 CUDA Cores 以获得更高精度的策略(Thakkar 等, 2023)。过程如图 7(b)所示。具体而言,在 Tensor Cores 上执行 MMA(矩阵乘法累加)时,中间结果使用有限的位宽进行累加。一旦达到NCNC的间隔,这些部分结果将被复制到 CUDA Cores 上的 FP32 寄存器中,在那里进行全精度 FP32 累加。如前所述,我们的细粒度量化沿内部维度KK应用每组缩放因子。这些缩放因子可以在 CUDA Cores 上作为反量化过程高效地相乘,而几乎没有额外的计算成本。
值得注意的是,这种修改降低了单个线程束的 WGMMA(线程束级矩阵乘法累加)指令发出率。然而,在 H800 架构上,通常有两个 WGMMA 同时持续:当一个线程束执行提升操作时,另一个线程束能够执行 MMA 操作。这种设计使两个操作能够重叠,保持 Tensor Cores 的高利用率。根据我们的实验,设置NC=128NC=128个元素(相当于 4 个 WGMMAs)代表了可以显著提高精度而不会引入大量开销的最小累加间隔。
尾数与指数:与先前工作(NVIDIA, 2024b; Peng 等, 2023b; Sun 等, 2019b)采用的混合 FP8 格式不同,先前工作在 Fprop 中使用 E4M3(4 位指数和 3 位尾数),在 Dgrad 和 Wgrad 中使用 E5M2(5 位指数和 2 位尾数),我们在所有张量上采用 E4M3 格式以获得更高精度。我们将这种方法的可行性归因于我们的细粒度量化策略,即 tile 和块级缩放。通过对较小的元素组进行操作,我们的方法有效地在这些分组元素之间共享指数位,减轻了有限动态范围的影响。
在线量化:在张量级量化框架(NVIDIA, 2024b; Peng 等, 2023b)中采用延迟量化,它维护先前迭代的最大绝对值历史来推断当前值。为了确保准确的缩放并简化框架,我们为每个1×1281×128激活 tile 或128×128128×128权重块在线计算最大绝对值。基于此,我们导出缩放因子,然后将激活或权重在线量化为 FP8 格式。
3.3.3 低精度存储与通信
结合我们的 FP8 训练框架,我们通过将缓存的激活和优化器状态压缩为更低精度格式,进一步减少了内存消耗和通信开销。
低精度优化器状态:我们采用 BF16 数据格式而不是 FP32 来跟踪 AdamW(Loshchilov 和 Hutter, 2017)优化器中的一阶和二阶矩,而不会导致可观察到的性能下降。然而,主权重(由优化器存储)和梯度(用于批量大小累积)仍然保留在 FP32 中,以确保整个训练过程中的数值稳定性。
低精度激活:如图 6 所示,Wgrad 操作在 FP8 中执行。为了减少内存消耗,在 Linear 算子的反向传播中以 FP8 格式缓存激活是一个自然的选择。然而,对于几个算子,为了低成本高精度训练需要特殊考虑:注意力算子之后的 Linear 输入。这些激活也用于注意力算子的反向传播,这使得它对精度敏感。我们专门为这些激活采用定制的 E5M6 数据格式。此外,这些激活在反向传播中将从1×1281×128量化 tile 转换为128×1128×1 tile。为了避免引入额外的量化误差,所有缩放因子都是 2 的整数次幂进行舍入缩放。MoE 中的 SwiGLU 算子输入。为了进一步降低内存成本,我们缓存 SwiGLU 算子的输入,并在反向传播中重新计算其输出。这些激活也使用我们的细粒度量化方法以 FP8 存储,在内存效率和计算准确性之间取得平衡。
低精度通信:通信带宽是 MoE 模型训练中的关键瓶颈。为了缓解这一挑战,我们在 MoE 上投影之前将激活量化为 FP8,然后应用分发组件,这与 MoE 上投影中的 FP8 Fprop 兼容。与注意力算子之后的 Linear 输入类似,此激活的缩放因子是 2 的整数次幂。类似的策略也应用于 MoE 下投影之前的激活梯度。对于前向和反向合并组件,我们将它们保留在 BF16 中,以在训练管道的关键部分保持训练精度。
3.4 推理与部署
我们将 DeepSeek-V3 部署在 H800 集群上,其中每个节点内的 GPU 通过 NVLink 互连,集群中所有 GPU 通过 IB 完全互连。为了同时确保在线服务的服务水平目标(SLO)和高吞吐量,我们采用了将预填充和解码阶段分离的部署策略。
3.4.1 预填充
预填充阶段的最小部署单元由 4 个节点和 32 个 GPU 组成。注意力部分采用 4 路张量并行(TP4)与序列并行(SP)相结合,并结合 8 路数据并行(DP8)。其较小的 TP 大小为 4,限制了 TP 通信的开销。对于 MoE 部分,我们使用 32 路专家并行(EP32),这确保每个专家处理足够大的批量大小,从而提高计算效率。对于 MoE 全对全通信,我们使用与训练相同的方法:首先通过 IB 在节点间传输词元,然后通过 NVLink 在节点内的 GPU 之间转发。特别是,对于浅层的密集 MLP,我们使用 1 路张量并行以节省 TP 通信。
为了在 MoE 部分的不同专家之间实现负载平衡,我们需要确保每个 GPU 处理大约相同数量的词元。为此,我们引入了冗余专家的部署策略,即复制高负载专家并进行冗余部署。高负载专家根据在线部署期间收集的统计信息进行检测,并定期调整(例如每 10 分钟)。在确定冗余专家集后,我们根据观察到的负载在节点内的 GPU 之间仔细重新排列专家,努力在不增加跨节点全对全通信开销的情况下尽可能平衡 GPU 之间的负载。对于 DeepSeek-V3 的部署,我们为预填充阶段设置了 32 个冗余专家。对于每个 GPU,除了它原本承载的 8 个专家外,它还将承载一个额外的冗余专家。
此外,在预填充阶段,为了提高吞吐量并隐藏全对全和 TP 通信的开销,我们同时处理两个计算工作量相似的微批次,将一个微批次的注意力和 MoE 与另一个微批次的分发和合并重叠。
最后,我们正在探索一种专家动态冗余策略,其中每个 GPU 承载更多专家(例如 16 个专家),但在每个推理步骤中仅激活 9 个专家。在每一层的全对全操作开始之前,我们即时计算全局最优路由方案。鉴于预填充阶段的计算量较大,计算此路由方案的开销几乎可以忽略不计。
3.4.2 解码
在解码期间,我们将共享专家视为路由专家。从这个角度来看,每个词元在路由过程中将选择 9 个专家,其中共享专家被视为始终会被选择的高负载专家。解码阶段的最小部署单元由 40 个节点和 320 个 GPU 组成。注意力部分采用 TP4 与 SP 相结合,并结合 DP80,而 MoE 部分使用 EP320。对于 MoE 部分,每个 GPU 仅承载一个专家,64 个 GPU 负责承载冗余专家和共享专家。分发和合并部分的全对全通信通过 IB 上的直接点对点传输执行,以实现低延迟。此外,我们利用 IBGDA(NVIDIA, 2022)技术进一步最小化延迟并提高通信效率。
与预填充类似,我们定期在一定间隔内根据在线服务的统计专家负载确定冗余专家集。然而,由于每个 GPU 仅承载一个专家,我们不需要重新排列专家。我们也在探索解码的动态冗余策略。然而,这需要更仔细地优化计算全局最优路由方案的算法,并与分发内核融合以减少开销。
此外,为了提高吞吐量并隐藏全对全通信的开销,我们也在探索在解码阶段同时处理两个计算工作量相似的微批次。与预填充不同的是,在解码阶段注意力消耗的时间比例更大。因此,我们将一个微批次的注意力与另一个微批次的分发 + MoE + 合并重叠。在解码阶段,每个专家的批量大小相对较小(通常在 256 个词元以内),瓶颈在于内存访问而非计算。由于 MoE 部分只需要加载一个专家的参数,内存访问开销极小,所以分配较少的 SM 不会显著影响整体性能。因此,为了避免影响注意力部分的计算速度,我们可以仅将一小部分 SM 分配给分发 + MoE + 合并。
3.5 硬件设计建议
基于我们对全对全通信和 FP8 训练方案的实现,我们向 AI 硬件供应商提出以下芯片设计建议。
3.5.1 通信硬件
在 DeepSeek-V3 中,我们实现了计算与通信的重叠,以在计算过程中隐藏通信延迟。与串行计算和通信相比,这显著降低了对通信带宽的依赖。然而,当前的通信实现依赖于昂贵的 SM(例如,在 H800 GPU 的 132 个 SM 中,我们为此目的分配了 20 个),这将限制计算吞吐量。此外,使用 SM 进行通信导致效率低下,因为张量核心完全未得到充分利用。
目前,SM 主要执行以下全对全通信任务:
在 IB(InfiniBand)和 NVLink 域之间转发数据,同时将来自单个 GPU 的去往同一节点内多个 GPU 的 IB 流量进行聚合。
在 RDMA 缓冲区(注册的 GPU 内存区域)和输入/输出缓冲区之间传输数据。
执行全对全合并的归约操作。
在通过 IB 和 NVLink 域向多个专家分块传输数据期间管理细粒度的内存布局。
我们希望未来的供应商开发能够从宝贵的计算单元 SM 中卸载这些通信任务的硬件,作为 GPU 协处理器或网络协处理器,如 NVIDIA SHARP(Graham 等, 2016)。此外,为了降低应用编程复杂性,我们希望从计算单元的角度统一 IB(向外扩展)和 NVLink(向内扩展)网络。通过这种统一接口,计算单元可以通过基于简单原语提交通信请求,轻松地在整个 IB - NVLink 统一域中完成读、写、多播和归约等操作。
3.5.2 计算硬件
提高 Tensor Cores 中 FP8 GEMM 累加精度:在 NVIDIA Hopper 架构的当前 Tensor Core 实现中,FP8 GEMM(通用矩阵乘法)采用定点累加,在加法前根据最大指数对尾数乘积进行右移对齐。我们的实验表明,在符号填充右移后,它仅使用每个尾数乘积的最高 14 位,并截断超出此范围的位。然而,例如,要从 32 个 FP8×FP8 乘法的累加中获得精确的 FP32 结果,至少需要 34 位精度。因此,我们建议未来的芯片设计提高 Tensor Cores 中的累加精度,以支持全精度累加,或者根据训练和推理算法的精度要求选择适当的累加位宽。这种方法确保在保持计算效率的同时,误差保持在可接受范围内。
支持 tile 和块级量化:当前的 GPU 仅支持张量级量化,缺乏对像我们的 tile 和块级量化这样的细粒度量化的原生支持。在当前实现中,当达到NCNC间隔时,部分结果将从 Tensor Cores 复制到 CUDA 核心,乘以缩放因子,并添加到 CUDA 核心上的 FP32 寄存器中。尽管结合我们精确的 FP32 累加策略,反量化开销显著降低,但 Tensor Cores 和 CUDA 核心之间频繁的数据移动仍然限制了计算效率。因此,我们建议未来的芯片支持细粒度量化,使 Tensor Cores 能够接收缩放因子并实现带有组缩放的 MMA。这样,整个部分和累加及反量化可以直接在 Tensor Cores 内部完成,直到产生最终结果,避免频繁的数据移动。
支持在线量化:当前的实现难以有效支持在线量化,尽管我们的研究证明了其有效性。在现有过程中,我们需要从 HBM(高带宽内存)读取 128 个 BF16 激活值(前一计算的输出)进行量化,然后将量化后的 FP8 值写回 HBM,仅在进行 MMA 时再次读取。为了解决这个低效问题,我们建议未来的芯片将 FP8 转换和 TMA(张量内存加速器)访问集成到单个融合操作中,以便在激活从全局内存传输到共享内存期间完成量化,避免频繁的内存读写。我们还建议支持线程级转换指令以加速,这进一步促进了层归一化和 FP8 转换的更好融合。或者,可以采用近内存计算方法,将计算逻辑放置在 HBM 附近。在这种情况下,BF16 元素在从 HBM 读入 GPU 时可以直接转换为 FP8,将片外内存访问减少约 50%。
支持转置 GEMM 操作:当前架构使得将矩阵转置与 GEMM 操作融合变得繁琐。在我们的工作流程中,前向传播期间的激活被量化为1×1281×128 FP8 tile 并存储。在反向传播期间,需要读取矩阵、反量化、转置、重新量化为128×1128×1 tile,并存储在 HBM 中。为了减少内存操作,我们建议未来的芯片在 MMA 操作之前,对于训练和推理所需的精度,启用从共享内存直接读取转置矩阵。结合 FP8 格式转换和 TMA 访问的融合,这种增强将显著简化量化工作流程。
4. 预训练
4.1 数据构建
与 DeepSeek-V2 相比,我们通过提高数学和编程样本的比例优化了预训练语料库,同时将多语言覆盖范围扩展到英语和中文之外。此外,我们优化了数据处理管道,在保持语料库多样性的同时最大限度地减少冗余。受 Ding 等(2024)的启发,我们实施了文档打包方法以保证数据完整性,但在训练期间未采用跨样本注意力掩码。最后,DeepSeek-V3 的训练语料库在我们的分词器中由 14.8 万亿个高质量且多样的词元组成。
在 DeepSeekCoder-V2(DeepSeek-AI, 2024a)的训练过程中,我们观察到中间填充(Fill-in-Middle,FIM)策略在不影响下一词元预测能力的情况下,使模型能够基于上下文线索准确预测中间文本。与 DeepSeekCoder-V2 一致,我们也在 DeepSeek-V3 的预训练中采用了 FIM 策略。具体而言,我们采用前缀 - 后缀 - 中间(Prefix-Suffix-Middle,PSM)框架来构建数据,如下所示: <|fim_begin|> fprefpre<|fim_hole|> fsuffsuf<|fim_end|> fmiddlefmiddle<|eos_token|> 这种结构在文档级别作为预打包过程的一部分应用。FIM 策略以 0.1 的比例应用,与 PSM 框架一致。
DeepSeek-V3 的分词器采用字节级 BPE(Shibata 等, 1999),扩展词汇表为 128K 词元。我们修改了预分词器和分词器的训练数据,以优化多语言压缩效率。此外,与 DeepSeek-V2 相比,新的预分词器引入了结合标点符号和换行符的词元。然而,当模型处理没有终端换行符的多行提示时,尤其是在少样本评估提示中,这种技巧可能会引入词元边界偏差(Lundberg, 2023)。为了解决这个问题,我们在训练期间随机拆分一定比例的此类组合词元,使模型接触到更广泛的特殊情况,从而减轻这种偏差。
4.2 超参数
模型超参数:我们设置 Transformer 层数为 61,隐藏维度为 7168。所有可学习参数均以标准差 0.006 随机初始化。在 MLA 中,我们设置注意力头数nhnh为 128,每个头的维度dhdh为 128。KV 压缩维度dcdc设置为 512,查询压缩维度dc′dc′设置为 1536。对于解耦的查询和键,我们设置每个头的维度dhRdhR为 64。除了前三层外,我们用 MoE 层替换所有的 FFN。每个 MoE 层由 1 个共享专家和 256 个路由专家组成,每个专家的中间隐藏维度为 2048。在路由专家中,每个词元将激活 8 个专家,并且每个词元最多被发送到 4 个节点。多词元预测深度DD设置为 1,即除了精确的下一个词元外,每个词元将预测一个额外词元。与 DeepSeek-V2 一样,DeepSeek-V3 在压缩潜在向量后也采用了额外的 RMSNorm 层,并在宽度瓶颈处乘以额外的缩放因子。在这种配置下,DeepSeek-V3 总共包含 6710 亿参数,其中每个词元激活 370 亿参数。
训练超参数:我们采用 AdamW 优化器(Loshchilov 和 Hutter, 2017),超参数设置为β1=0.9β1=0.9,β2=0.95β2=0.95,权重衰减=0.1=0.1。在预训练期间,我们将最大序列长度设置为 4K,并在 14.8 万亿个词元上预训练 DeepSeek-V3。对于学习率调度,我们首先在最初的 2K 步内将其从 0 线性增加到2.2×10−42.2×10−4。然后,我们保持学习率为2.2×10−42.2×10−4,直到模型消耗 10 万亿个训练词元。随后,我们在 4.3 万亿个词元内按照余弦衰减曲线将学习率逐渐衰减到2.2×10−52.2×10−5。在训练最后 5000 亿个词元期间,我们在前 3330 亿个词元内保持学习率为2.2×10−52.2×10−5,在剩余的 1670 亿个词元内切换到另一个恒定学习率7.3×10−67.3×10−6。梯度裁剪范数设置为 1.0。我们采用批量大小调度策略,在训练前 4690 亿个词元期间,批量大小从 3072 逐渐增加到 15360,然后在剩余的训练中保持 15360。我们利用流水线并行将模型的不同层部署在不同的 GPU 上,对于每个层,路由专家将均匀部署在属于 8 个节点的 64 个 GPU 上。对于节点限制路由,每个词元最多被发送到 4 个节点(即M=4M=4)。对于无辅助损失负载平衡,我们在前 14.3 万亿个词元中将偏差更新速度γγ设置为 0.001,在剩余的 5000 亿个词元中将其设置为 0.0。对于平衡损失,我们将αα设置为 0.0001,仅为了避免任何单个序列内的极端不平衡。MTP 损失权重λλ在前 10 万亿个词元中设置为 0.3,在剩余的 4.8 万亿个词元中设置为 0.1。
4.3 长上下文扩展
我们采用与 DeepSeek-V2(DeepSeek-AI, 2024c)类似的方法,使 DeepSeek-V3 具备长上下文能力。在预训练阶段之后,我们应用 YaRN(Peng 等, 2023a)进行上下文扩展,并进行两个额外的训练阶段,每个阶段包含 1000 步,以逐步将上下文窗口从 4K 扩展到 32K,然后再扩展到 128K。YaRN 配置与 DeepSeek-V2 中使用的一致,仅应用于解耦的共享键ktRktR。两个阶段的超参数保持相同,其中尺度s=40,α=1,β=32,缩放因子t=0.1lns+1。在第一阶段,序列长度设置为 32K,批量大小为 1920。在第二阶段,序列长度增加到 128K,批量大小减少到 480。两个阶段的学习率都设置为7.3×10⁻⁶,与预训练阶段的最终学习率相匹配。
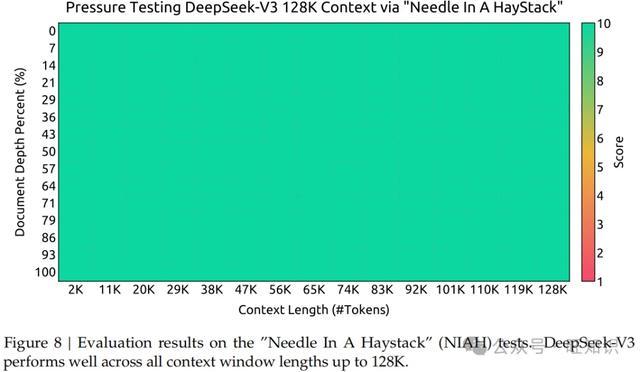
通过这两个阶段的扩展训练,DeepSeek-V3 能够处理长度高达 128K 的输入,同时保持强大的性能。图 8 显示,经过监督微调后,DeepSeek-V3 在“大海捞针”(Needle In A Haystack,NIAH)测试中取得了显著的性能,在高达 128K 的上下文窗口长度上表现出一致的稳健性。
4.4 评估
4.4.1 评估基准
DeepSeek-V3 的基础模型在以英语和中文为主的多语言语料库上进行预训练,因此我们主要在英语和中文以及一个多语言基准上评估其性能。我们的评估基于集成在 HAI-LLM 框架中的内部评估框架。考虑的基准分类并列出如下,其中下划线标注的基准为中文基准,双下划线标注的基准为多语言基准:
多学科多项选择题数据集包括 MMLU(Hendrycks 等, 2020)、MMLU-Redux(Gema 等, 2024)、MMLU-Pro(Wang 等, 2024b)、MMMLU(OpenAI, 2024b)、C-Eval(Huang 等, 2023)和 CMMLU(Li 等, 2023)。
语言理解和推理数据集包括 HellaSwag(Zellers 等, 2019)、PIQA(Bisk 等, 2020)、ARC(Clark 等, 2018)和 BigBench Hard(BBH)(Suzgun 等, 2022)。
闭卷问答数据集包括 TriviaQA(Joshi 等, 2017)和 NaturalQuestions(Kwiatkowski 等, 2019)。
阅读理解数据集包括 RACE(Lai 等, 2017)、DROP(Dua 等, 2019)、C3(Sun 等, 2019a)和 CMRC(Cui 等, 2019)。
参考消歧数据集包括 CLUEWSC(Xu 等, 2020)和 WinoGrande(Sakaguchi 等, 2019)。
语言建模数据集包括 Pile(Gao 等, 2020)。
中文理解和文化数据集包括 CCPM(Li 等, 2021)。
数学数据集包括 GSM8K(Cobbe 等, 2021)、MATH(Hendrycks 等, 2021)、MGSM(Shi 等, 2023)和 CMath(Wei 等, 2023)。
代码数据集包括 HumanEval(Chen 等, 2021)、LiveCodeBench-Base(0801 - 1101)(Jain 等, 2024)、MBPP(Austin 等, 2021)和 CRUXEval(Gu 等, 2024)。
标准化考试包括 AGIEval(Zhong 等, 2023)。需要注意的是,AGIEval 包括英语和中文子集。
遵循我们之前的工作(DeepSeek-AI, 2024b,c),我们对包括 HellaSwag、PIQA、WinoGrande、RACE-Middle、RACE-High、MMLU、MMLU-Redux、MMLU-Pro、MMMLU、ARC-Easy、ARC-Challenge、C-Eval、CMMLU、C3 和 CCPM 在内的数据集采用基于困惑度的评估,并对 TriviaQA、NaturalQuestions、DROP、MATH、GSM8K、MGSM、HumanEval、MBPP、LiveCodeBench-Base、CRUXEval、BBH、AGIEval、CLUEWSC、CMRC 和 CMath 采用基于生成的评估。此外,我们对 Pile-test 进行基于语言建模的评估,并使用每字节位数(Bits-Per-Byte,BPB)作为指标,以确保使用不同分词器的模型之间的公平比较。
4.4.2 评估结果
在表 3 中,我们将 DeepSeek-V3 的基础模型与最先进的开源基础模型进行比较,包括 DeepSeek-V2-Base(DeepSeek-AI, 2024c)(我们之前的版本)、Qwen2.5 72B Base(Qwen, 2024b)和 LLaMA-3.1 405B Base(AI@Meta, 2024b)。我们使用内部评估框架对所有这些模型进行评估,并确保它们具有相同的评估设置。需要注意的是,由于我们的评估框架在过去几个月中有所变化,DeepSeek-V2-Base 的性能与我们之前报告的结果略有不同。总体而言,DeepSeek-V3-Base 全面优于 DeepSeek-V2-Base 和 Qwen2.5 72B Base,并在大多数基准测试中超过 LLaMA-3.1 405B Base,基本上成为最强的开源模型。
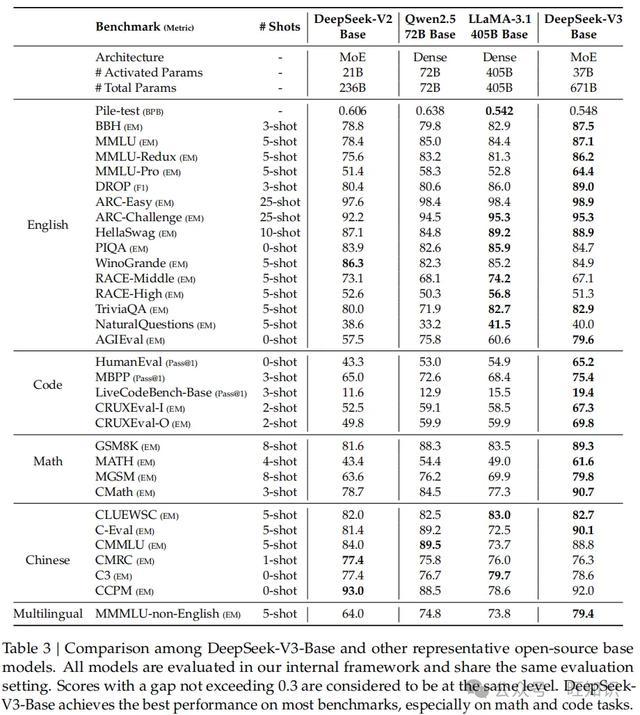
从更详细的角度来看,我们将 DeepSeek-V3-Base 与其他开源基础模型分别进行比较。(1)与 DeepSeek-V2-Base 相比,由于我们的模型架构改进、模型规模和训练词元的扩大以及数据质量的提高,DeepSeek-V3-Base 如预期的那样取得了显著更好的性能。(2)与 Qwen2.5 72B Base 相比,Qwen2.5 72B Base 是最先进的中文开源模型,尽管 DeepSeek-V3-Base 激活的参数只有其一半,但在英语、多语言、代码和数学基准测试中仍表现出显著优势。对于中文基准测试,除了 CMMLU(一个中文多学科多项选择题任务)外,DeepSeek-V3-Base 也比 Qwen2.5 72B 表现更好。(3)与 LLaMA-3.1 405B Base 相比,LLaMA-3.1 405B Base 是最大的开源模型,其激活参数是 DeepSeek-V3-Base 的 11 倍,DeepSeek-V3-Base 在多语言、代码和数学基准测试中也表现出更好的性能。对于英语和中文语言基准测试,DeepSeek-V3-Base 表现出具有竞争力或更好的性能,在 BBH、MMLU 系列、DROP、C-Eval、CMMLU 和 CCPM 等方面尤其出色。
由于我们高效的架构和全面的工程优化,DeepSeek-V3 实现了极高的训练效率。在我们的训练框架和基础设施下,在每万亿词元上训练 DeepSeek-V3 仅需 18 万 H800 GPU 小时,这比训练 72B 或 405B 密集模型便宜得多。
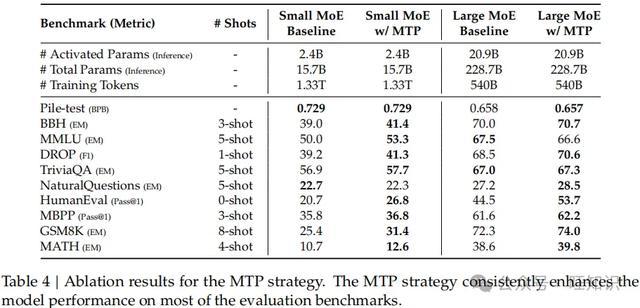
在表 4 中展示了 MTP 策略的消融结果。具体而言,我们在两个不同规模的基线模型上验证了 MTP 策略。在小规模下,我们在 1.33 万亿词元上训练一个包含 157 亿总参数的基线 MoE 模型。在大规模下,我们在 5400 亿词元上训练一个包含 2287 亿总参数的基线 MoE 模型。在它们之上,保持训练数据和其他架构相同,我们添加一个 1 深度的 MTP 模块并训练两个具有 MTP 策略的模型进行比较。需要注意的是,在推理过程中,我们直接丢弃 MTP 模块,因此比较模型的推理成本完全相同。从表中可以看出,MTP 策略在大多数评估基准测试中始终提高了模型性能。
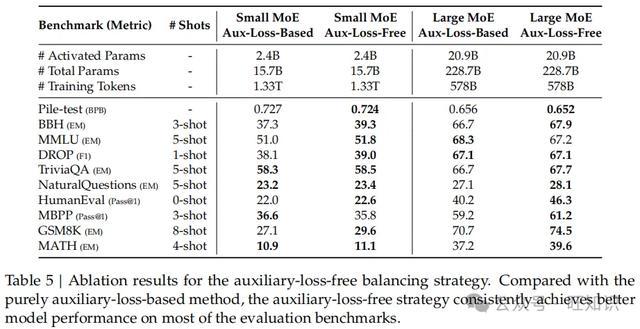
在表 5 中展示了无辅助损失平衡策略的消融结果。我们在两个不同规模的基线模型上验证了此策略。在小规模下,我们在 1.33 万亿词元上训练一个包含 157 亿总参数的基线 MoE 模型。在大规模下,我们在 5780 亿词元上训练一个包含 2287 亿总参数的基线 MoE 模型。这两个基线模型纯粹使用辅助损失来促进负载平衡,并使用带有 top-K 亲和力归一化的 Sigmoid 门控函数。它们控制辅助损失强度的超参数分别与 DeepSeek-V2-Lite 和 DeepSeek-V2 相同。在这两个基线模型之上,保持训练数据和其他架构相同,我们移除所有辅助损失并引入无辅助损失平衡策略进行比较。从表中可以看出,无辅助损失策略在大多数评估基准测试中始终实现了更好的模型性能。
4.5 讨论
4.5.1 多词元预测的消融研究
在表 4 中,我们展示了多词元预测(MTP)策略的消融结果。具体来说,我们在两个不同规模的基线模型上验证了 MTP 策略。在小规模下,我们训练了一个包含 157 亿总参数的基线 MoE 模型,在 1.33 万亿个词元上进行训练。在大规模下,我们训练了一个包含 2287 亿总参数的基线 MoE 模型,在 5400 亿个词元上进行训练。在这些基线模型的基础上,保持训练数据和其他架构不变,我们添加了一个 1 深度的 MTP 模块,并训练了两个采用 MTP 策略的模型用于比较。需要注意的是,在推理时,我们直接丢弃 MTP 模块,所以对比模型的推理成本是完全相同的。从表中可以看出,MTP 策略在大多数评估基准测试中都持续提升了模型性能。
4.5.2 无辅助损失平衡策略的消融研究
在表 5 中,我们展示了无辅助损失平衡策略的消融结果。我们在两个不同规模的基线模型上验证了该策略。在小规模下,我们训练了一个包含 157 亿总参数的基线 MoE 模型,在 1.33 万亿个词元上进行训练。在大规模下,我们训练了一个包含 2287 亿总参数的基线 MoE 模型,在 5780 亿个词元上进行训练。这两个基线模型都纯粹使用辅助损失来促进负载平衡,并使用带有 top - K 亲和力归一化的 Sigmoid 门控函数。它们控制辅助损失强度的超参数分别与 DeepSeek - V2 - Lite 和 DeepSeek - V2 相同。在这两个基线模型的基础上,保持训练数据和其他架构不变,我们移除了所有辅助损失,并引入无辅助损失平衡策略进行比较。从表中可以看出,无辅助损失策略在大多数评估基准测试中都持续取得了更好的模型性能。
4.5.3 批次级负载均衡与序列级负载均衡
无辅助损失平衡和序列级辅助损失的关键区别在于它们的平衡范围:批次级与序列级。与序列级辅助损失相比,批次级平衡施加了更灵活的约束,因为它不强制每个序列在域内保持平衡。这种灵活性使专家能够更好地专注于不同领域。为了验证这一点,我们记录并分析了在 Pile 测试集上基于 16B 辅助损失的基线模型和无辅助损失模型在不同领域的专家负载。如图 9 所示,正如预期的那样,无辅助损失模型展示出更大的专家专业化模式。
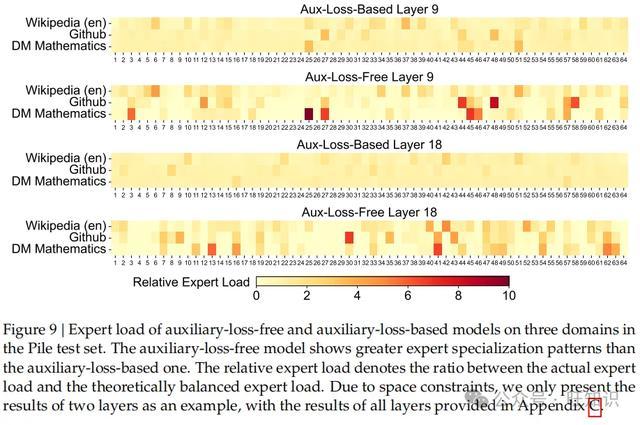
为了进一步研究这种灵活性与模型性能优势之间的相关性,我们还设计并验证了一种批次级辅助损失,它鼓励在每个训练批次而不是每个序列上实现负载平衡。实验结果表明,当实现类似的批次级负载平衡时,批次级辅助损失也能实现与无辅助损失方法相似的模型性能。具体来说,在我们对 1B MoE 模型的实验中,验证损失分别为:2.258(使用序列级辅助损失)、2.253(使用无辅助损失方法)和 2.253(使用批次级辅助损失)。我们在 3B MoE 模型上也观察到了类似的结果:使用序列级辅助损失的模型验证损失为 2.085,而使用无辅助损失方法或批次级辅助损失的模型验证损失均为 2.080。
此外,尽管批次级负载平衡方法表现出一致的性能优势,但它们在效率方面也面临两个潜在挑战:(1)某些序列或小批次内的负载不平衡,以及(2)推理过程中因域转移导致的负载不平衡。第一个挑战由我们使用大规模专家并行和数据并行的训练框架自然解决,这保证了每个微批次的大小足够大。对于第二个挑战,我们也设计并实现了一个带有冗余专家部署的高效推理框架,如第 3.4 节所述,来克服它。
5. 后训练
5.1 监督微调
我们精心策划了包含 150 万个实例的指令微调数据集,涵盖多个领域,每个领域都根据其特定要求采用不同的数据创建方法。
对于推理相关的数据集,包括数学、代码竞赛问题和逻辑谜题等,我们利用内部的 DeepSeek - R1 模型生成数据。具体来说,虽然 R1 生成的数据准确性较高,但存在过度思考、格式不佳和长度过长等问题。我们的目标是平衡 R1 生成的推理数据的高准确性与常规格式推理数据的清晰简洁性。
为了建立我们的方法,我们首先使用监督微调(SFT)和强化学习(RL)训练管道开发针对特定领域(如代码、数学或一般推理)的专家模型。这个专家模型作为最终模型的数据生成器。训练过程涉及为每个实例生成两种不同类型的 SFT 样本:第一种将问题与其原始响应以<问题, 原始响应>的格式组合,第二种将系统提示与问题和 R1 响应以<系统提示, 问题, R1 响应>的格式组合。
系统提示经过精心设计,包含引导模型生成包含反思和验证机制的响应的指令。在 RL 阶段,模型利用高温采样生成融合了 R1 生成数据和原始数据模式的响应,即使在没有明确系统提示的情况下也是如此。经过数百个 RL 步骤后,中间 RL 模型学会整合 R1 模式,从而有策略地提高整体性能。
在完成 RL 训练阶段后,我们实施拒绝采样来筛选最终模型的高质量 SFT 数据,其中专家模型用作数据生成源。这种方法确保最终训练数据保留 DeepSeek - R1 的优势,同时生成简洁有效的响应。
对于非推理数据,如创意写作、角色扮演和简单问答,我们利用 DeepSeek - V2.5 生成响应,并聘请人类注释者验证数据的准确性和正确性。
我们使用 SFT 数据集对 DeepSeek - V3 - Base 进行两个 epoch 的微调,采用从5×10−65×10−6开始并逐渐降至1×10−61×10−6的余弦衰减学习率调度。在训练过程中,每个单序列由多个样本打包而成。然而,我们采用样本掩码策略,确保这些示例相互隔离且不可见。
5.2 强化学习
5.2.1 奖励模型
在我们的 RL 过程中,我们采用基于规则的奖励模型(RM)和基于模型的 RM。 对于可以使用特定规则验证的问题,我们采用基于规则的奖励系统来确定反馈。例如,某些数学问题有确定的结果,我们要求模型在指定格式(如在框内)提供最终答案,以便我们可以应用规则来验证正确性。同样,对于 LeetCode 问题,我们可以利用编译器根据测试用例生成反馈。通过尽可能利用基于规则的验证,我们确保了更高的可靠性,因为这种方法不易被操纵或利用。
对于具有自由格式真实答案的问题,我们依靠奖励模型来确定响应是否与预期的真实答案匹配。相反,对于没有确定真实答案的问题,如创意写作,奖励模型的任务是根据问题和相应的答案作为输入提供反馈。奖励模型从 DeepSeek - V3 的 SFT 检查点进行训练。为了提高其可靠性,我们构建偏好数据,不仅提供最终奖励,还包括导致奖励的思维链。这种方法有助于减轻特定任务中奖励作弊的风险。
5.2.2 组相对策略优化
与 DeepSeek - V2(DeepSeek - AI, 2024c)类似,我们采用组相对策略优化(GRPO)(Shao 等, 2024),它省略了通常与策略模型大小相同的评论家模型,并从组分数中估计基线。具体来说,对于每个问题q,GRPO 从旧策略模型πθold中采样一组输出{o1,o2,⋯,oG},然后通过最大化以下目标来优化策略模型πθ:
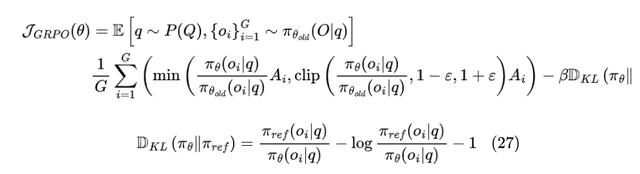
其中β和πref是相关参数,Ai是优势,由每个组内输出对应的奖励{r1,r2,⋯,rG}得出:
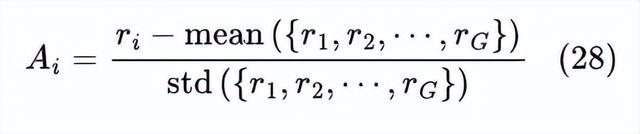
我们在 RL 过程中纳入来自不同领域的提示,如编码、数学、写作、角色扮演和问答。这种方法不仅使模型更符合人类偏好,还提高了在基准测试中的性能,特别是在可用 SFT 数据有限的情况下。
5.3 评估
5.3.1 评估设置
除了用于基础模型测试的基准测试外,我们还在 IFEval(Zhou 等, 2023)、FRAMES(Krishna 等, 2024)、LongBench v2(Bai 等, 2024)、GPQA(Rein 等, 2023)、SimpleQA(OpenAI, 2024c)、CSimpleQA(He 等, 2024)、SWE - Bench Verified(OpenAI, 2024d)、Aider 1、LiveCodeBench(Jain 等, 2024)(2024 年 8 月至 11 月的问题)、Codeforces 2、中国高中数学奥林匹克(CNMO 2024)3 和美国数学邀请赛 2024(AIME 2024)(MAA, 2024)等基准测试上评估经过指令调整的模型。
我们将聊天模型与几个强大的基线模型进行全面评估,包括 DeepSeek - V2 - 0506、DeepSeek - V2.5 - 0905、Qwen2.5 72B Instruct、LLaMA - 3.1 405B Instruct、Claude - Sonnet - 3.5 - 1022 和 GPT - 4o - 0513。对于 DeepSeek - V2 模型系列,我们选择最具代表性的变体进行比较。对于闭源模型,通过它们各自的 API 进行评估。
对于标准基准测试,如 MMLU、DROP、GPQA 和 SimpleQA,我们采用来自 simple - evals 框架 4 的评估提示。对于 MMLU - Redux 在零样本设置下,我们利用 Zero - Eval 提示格式(Lin, 2024)。对于其他数据集,我们遵循其原始评估协议,使用数据集创建者提供的默认提示。对于代码和数学基准测试,HumanEval - Mul 数据集总共包括 8 种主流编程语言(Python、Java、Cpp、C#、JavaScript、TypeScript、PHP 和 Bash)。我们使用 CoT 和非 CoT 方法评估模型在 LiveCodeBench 上的性能,数据收集时间为 2024 年 8 月至 11 月。Codeforces 数据集使用参赛者的百分比进行测量。SWE - Bench verified 使用无代理框架(Xia 等, 2024)进行评估。我们使用“diff”格式评估与 Aider 相关的基准测试。对于数学评估,AIME 和 CNMO 2024 在温度为 0.7 下进行评估,结果在 16 次运行中取平均值,而 MATH - 500 采用贪婪解码。我们允许所有模型在每个基准测试中最多输出 8192 个词元。
5.3.2 标准评估
在表 6 中,我们将 DeepSeek - V3 与其他代表性聊天模型进行比较。所有模型在限制输出长度为 8K 的配置下进行评估。对于包含少于 1000 个样本的基准测试,使用不同的温度设置进行多次测试,以得出可靠的最终结果。DeepSeek - V3 是性能最佳的开源模型,并且在与前沿闭源模型的竞争中也表现出竞争力。
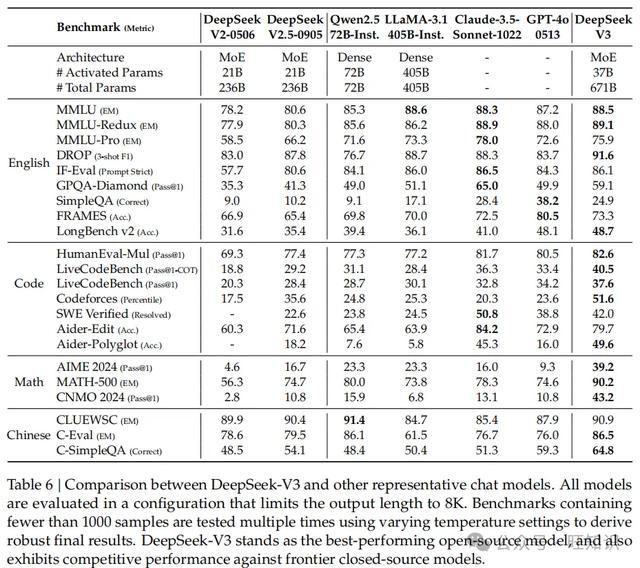
在中文基准测试方面,Qwen和DeepSeek是两个在中英文方面都有强大支持的代表性模型系列。在事实性基准测试 Chinese SimpleQA 上,尽管 Qwen2.5 在包含 18 万亿词元(比 DeepSeek-V3 预训练的 14.8 万亿词元多 20%)的更大语料库上进行训练,但 DeepSeek-V3 比 Qwen2.5-72B 高出 16.4 分。
在 C-Eval(一个用于评估中文教育知识的代表性基准测试)和 CLUEWSC(中文 Winograd 模式挑战赛)上,DeepSeek-V3 和 Qwen2.5-72B 表现出相似的性能水平,这表明这两个模型在具有挑战性的中文推理和教育任务上都进行了良好的优化。
5.3.3 开放式评估
除了标准基准测试外,我们还使用大语言模型作为评判者,在开放式生成任务上评估我们的模型,结果如表 7 所示。具体来说,我们遵循 AlpacaEval 2.0(Dubois 等, 2024)和 Arena-Hard(Li 等, 2024a)的原始配置,这两个配置都利用 GPT-4-Turbo-1106 作为评判者进行成对比较。在 Arena-Hard 上,DeepSeek-V3 相对于基线 GPT-4-0314 取得了超过 86%的令人印象深刻的胜率,与顶级模型如 Claude-Sonnet-3.5-1022 表现相当。这凸显了 DeepSeek-V3 的强大能力,特别是在处理复杂提示(包括编码和调试任务)方面。此外,DeepSeek-V3 作为第一个在 Arena-Hard 基准测试上超过 85%的开源模型,取得了突破性的里程碑。这一成就显著缩小了开源和闭源模型之间的性能差距,为开源模型在具有挑战性的领域中能够实现的目标设定了新的标准。
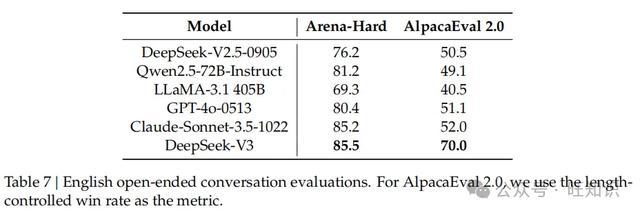
同样,DeepSeek-V3 在 AlpacaEval 2.0 上也表现出色,优于闭源和开源模型。这表明它在写作任务和处理简单问答场景方面具有卓越的熟练程度。值得注意的是,它比 DeepSeek-V2.5-0905 高出 20%,突出了在处理简单任务方面的显著改进,并展示了其进步的有效性。
5.3.4 DeepSeek-V3 作为生成式奖励模型
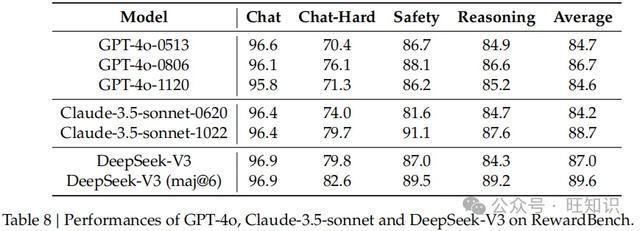
我们将 DeepSeek-V3 的评判能力与最先进的模型,即 GPT-4o 和 Claude-3.5 进行比较。表 8 展示了这些模型在 RewardBench(Lambert 等, 2024)上的性能。DeepSeek-V3 达到了与 GPT-4o-0806 和 Claude-3.5-Sonnet-1022 最佳版本相当的性能,同时超过了其他版本。此外,DeepSeek-V3 的评判能力还可以通过投票技术得到增强。因此,我们使用 DeepSeek-V3 结合投票来为开放式问题提供自我反馈,从而提高对齐过程的有效性和鲁棒性。
5.4 讨论
5.4.1 从 DeepSeek-R1 进行蒸馏
我们基于 DeepSeek-V2.5 对从 DeepSeek-R1 进行蒸馏的贡献进行了消融研究。基线模型在短 CoT 数据上进行训练,而其对比模型使用上述专家检查点生成的数据。
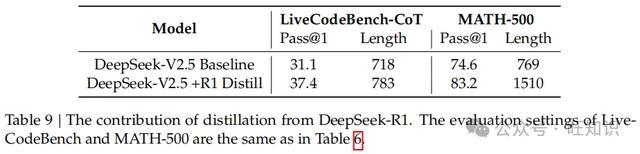
表 9 展示了蒸馏数据的有效性,在 LiveCodeBench 和 MATH-500 基准测试中都有显著的性能提升。我们的实验揭示了一个有趣的权衡:蒸馏导致更好的性能,但也大幅增加了平均响应长度。为了在模型准确性和计算效率之间保持平衡,我们在 DeepSeek-V3 的蒸馏过程中仔细选择了最佳设置。
我们的研究表明,从推理模型进行知识蒸馏是后训练优化的一个有前途的方向。虽然我们目前的工作主要集中在从数学和编码领域蒸馏数据,但这种方法在各种任务领域都有更广泛的应用潜力。在这些特定领域中展示的有效性表明,长 CoT 蒸馏对于增强其他需要复杂推理的认知任务中的模型性能可能是有价值的。在不同领域进一步探索这种方法仍然是未来研究的一个重要方向。
5.4.2 自奖励
奖励在强化学习中起着关键作用,引导优化过程。在通过外部工具进行验证较为直接的领域,如一些编码或数学场景中,强化学习表现出卓越的效果。然而,在更一般的场景中,构建反馈是具有挑战性的。在这些情况下,自奖励机制可能是一种有前途的解决方案。通过让模型对自己的生成进行评估和奖励,我们可以在没有明确外部反馈的情况下引导模型的学习。然而,设计有效的自奖励机制并非易事,需要仔细考虑如何避免模型陷入自我强化的循环或产生不合理的奖励。未来的研究需要探索如何设计可靠的自奖励机制,以充分发挥其在强化学习中的潜力。
5.4.3 多词元预测评估
在本文中,我们展示了多词元预测(MTP)策略在提高模型性能方面的有效性。然而,MTP 策略仍有进一步改进的空间。例如,我们可以探索不同的预测深度和模块结构,以找到更优的配置。此外,研究 MTP 与其他训练技术(如对比学习或对抗训练)的结合可能会带来额外的性能提升。在推理过程中,虽然我们目前主要将 MTP 模块用于推测解码,但可能还有其他更有效的利用方式。未来的研究可以专注于这些方面,以进一步挖掘 MTP 策略的潜力。
6. 结论、局限与未来方向
在本文中,我们介绍了 DeepSeek-V3,一个强大的专家混合(MoE)语言模型,在多个方面取得了显著的成果。通过采用创新的架构设计,如无辅助损失的负载均衡策略和多词元预测目标,结合高效的训练和推理技术,DeepSeek-V3 在各种基准测试中表现出色,与领先的闭源模型相比具有竞争力,同时保持了相对较低的训练成本和高度的训练稳定性。
然而,DeepSeek-V3 仍然存在一些局限性。尽管在多语言支持方面取得了进展,但在某些低资源语言或特定领域的语言处理上可能仍有改进的空间。在模型的可解释性方面,虽然我们对模型的行为有一定的理解,但仍需要进一步的研究来深入解释模型的决策过程。此外,随着模型规模的不断扩大,对计算资源的需求仍然是一个挑战,尽管我们已经采取了一些优化措施来降低成本。
未来的研究方向包括进一步优化模型架构,探索更有效的训练算法和数据增强技术,以提高模型的性能和泛化能力。在多语言和跨文化方面,加强对不同语言和文化背景下的语言理解和生成的研究,以提供更全面的语言服务。在可解释性方面,开发新的方法和工具来揭示模型的内部工作机制,增强用户对模型的信任。最后,持续关注硬件技术的发展,与硬件供应商紧密合作,实现算法和硬件的协同优化,进一步提高模型训练和推理的效率。
我们相信,通过不断的研究和创新,大语言模型将在未来取得更大的突破,为人工智能的发展做出更大的贡献。
作者:张长旺,图源:旺知识
参考资料
标题:DeepSeek-V3 Technical Report
作者:DeepSeek-AI
单位:DeepSeek-AI
标签:人工智能、大语言模型、深度学习、自然语言处理、混合专家模型
概述: 本文介绍了 DeepSeek-V3 模型,包括其架构、训练方法、评估结果等,展示了其在性能上的优势与创新之处。
链接:https://github.com/deepseek-ai/DeepSeek-V3/blob/main/DeepSeek_V3.pdf