Search-o1:智能体搜索增强大推理模型,部分能力超越人类专家
在人工智能领域,大型推理模型在处理复杂问题时经常因为知识不够而出现错误。Search-o1 这个新框架就像是给模型配上了一个智能助手,能在模型遇到不懂的知识时帮它查找资料,还能把找到的资料整理好再给模型用,让模型的推理更准确。经过很多实验证明,这个框架在科学、数学等多个领域都表现得非常好,比以前的方法都厉害,甚至在一些方面比人类专家还强,对推动智能系统发展很有帮助。
我们详细翻译解读最新论文,文末有相关信息。
作者:张长旺,图源:旺知识
大型推理模型虽有长步骤推理能力,但常因知识不足产生错误。Search-o1 框架将智能体搜索流程融入推理,通过智能体检索增强生成机制在模型遇到知识不确定点时检索外部知识,并利用 Reason-in-Documents 模块优化检索文档后再融入推理链,避免干扰。实验在多领域任务和问答基准测试中表明,Search-o1 性能出色,在复杂推理任务上超越现有方法,部分领域超人类专家水平,提升了模型可靠性与通用性。
摘要&解读
像OpenAI - o1这样的大型推理模型(LRMs)通过大规模强化学习展现出了令人瞩目的长步骤推理能力。然而,其扩展的推理过程常常因知识不足而受阻,频繁导致不确定性和潜在错误。为解决这一局限,我们引入Search - o1,这一框架通过智能体检索增强生成(RAG)机制和用于优化检索文档的Reason - in - Documents模块来增强大型推理模型。Search - o1将智能体搜索工作流程整合到推理过程中,使大型推理模型在遇到不确定知识点时能够动态检索外部知识。此外,鉴于检索文档冗长的特性,我们设计了独立的Reason - in - Documents模块,在将检索信息注入推理链之前对其进行深度分析,最大程度减少噪声并保持推理流程的连贯性。在科学、数学和编程等复杂推理任务以及六个开放领域问答基准测试上进行的大量实验,证明了Search - o1的强大性能。这种方法提高了大型推理模型在复杂推理任务中的可信度和适用性,为构建更可靠、通用的智能系统奠定了基础。
研究背景: 大型推理模型在复杂推理任务中虽有进展,但存在知识不足的缺陷,传统检索增强方法也无法有效解决,且检索文档存在冗余、模型理解长文档能力有限等问题。
研究贡献:
提出首个将智能体搜索工作流程整合到大型推理模型类似 o1 推理过程的 Search-o1 框架,实现自主知识补充。
结合智能体 RAG 机制和知识精炼模块,使模型按需检索并有效整合外部知识,保持推理逻辑流。
在多领域任务和问答基准测试中表现优异,提升模型在复杂推理任务的可信度和适用性,部分领域超人类专家水平。
实现设计:
设计智能体检索增强生成机制,模型可在推理中生成搜索查询触发检索,检索结果注入推理链。
构建 Reason-in-Documents 模块,基于当前查询、检索文档和已有推理链分析提炼信息,再融入推理链。
制定 Search-o1 推理过程,包括单个问题的推理逻辑和批量推理机制,保障知识有效利用和系统高效处理多问题。
• 实验结果:
在具有挑战性的推理任务中,Search-o1 优于 RAgent-QwQ-32B 等基线模型,如在五个数据集平均表现上分别超出一定比例,且在部分领域超人类专家。
在开放领域问答任务中,Search-o1 在多跳任务表现突出,相比 RAG-QwQ-32B 等基线模型在平均 EM 指标上有显著提升。
1 引言
最近涌现的大型推理模型(LRMs),以OpenAI的o1 、QwenQwQ和DeepSeek - R1为代表,采用大规模强化学习培养出令人印象深刻的长序列逐步推理能力,为解决复杂推理问题提供了有前景的方案。这一进展激发了一系列基础研究工作,旨在探索和重现类似o1的推理模式,将其应用扩展到更广泛的基础模型。
值得注意的是,类似o1的推理模式引导大型推理模型通过隐式分解复杂问题,生成较长的内部推理链,然后逐步找到合适的解决方案,从而进行较慢的思考过程。虽然这一特性增强了推理的逻辑连贯性和可解释性,但过长的思维链可能导致过度思考,并增加知识不足的风险,任何知识缺口都可能传播错误并破坏整个推理链。
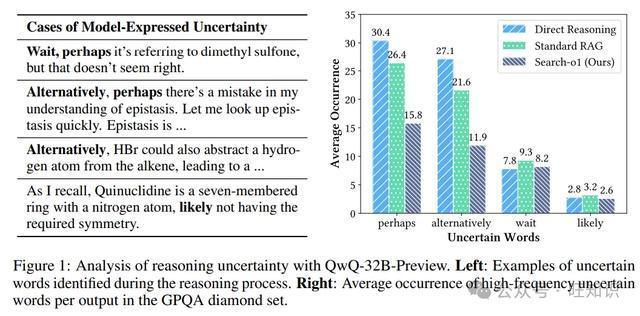
为解决这一局限,我们进行了初步实验,评估由于知识缺口导致大型推理模型解码不确定词的频率。如图1所示,在具有挑战性的推理问题中,扩展的思考过程导致大型推理模型频繁解码大量不确定词汇,在每个推理过程中,“perhaps”(或许)平均出现次数超过30次。值得注意的是,这些问题的高度专业性也使得人工推理验证变得复杂,通常会产生高昂的成本。因此,为类似o1的推理过程自动补充所需知识已成为一项重大挑战,限制了大型推理模型实现普遍可信推理的进展。
为解决这一问题,我们的核心动机是通过自主检索增强具有类似o1推理模式的大型推理模型。我们提出Search - o1,它将大型推理模型的推理过程与两个核心组件相结合:智能体检索增强生成(RAG)机制和知识优化模块。这一设计旨在使大型推理模型能够将智能体搜索工作流程整合到推理过程中,按需检索外部知识以支持逐步推理,同时始终保持连贯性。
具体而言,图1中的结果显示,与直接推理相比,传统的面向问题的RAG技术无法有效解决知识缺口问题(标准RAG与直接推理对比)。这一发现符合人类直觉,因为标准RAG仅以面向问题的方式检索一次相关知识,而在复杂推理场景中,每个推理步骤所需的知识往往是多样且不同的。与标准RAG不同,Search - o1采用智能体RAG技术,引导模型在遇到知识短缺时主动解码搜索查询,从而触发检索机制获取相关外部知识。由于这一设计的优势,我们的检索机制可以在单个推理会话中多次触发和迭代,以满足各个推理步骤的知识需求。
为了有效地将检索到的知识整合到大型推理模型的推理过程中,在实际实验中,我们进一步确定了将检索文档直接纳入推理链时面临的两个关键挑战:(1)检索文档中的冗余信息。检索到的文档通常冗长且包含冗余信息,将其直接输入大型推理模型可能会破坏原始推理的连贯性,甚至引入噪声。(2)理解长文档的能力有限。大多数大型推理模型在预训练和微调阶段专门针对复杂推理任务进行了优化。这种专注导致它们在通用能力方面出现了一定程度的灾难性遗忘,最终限制了它们对检索文档的长上下文理解能力。
为应对这些挑战,我们引入了Reason - in - Documents模块,该模块独立于主推理链运行。此模块首先根据当前搜索查询和先前的推理步骤对检索到的文档进行全面分析,然后生成精炼信息,使其与先前的推理链无缝集成。
总之,我们的贡献如下:
我们提出Search - o1,这是首个将智能体搜索工作流程整合到大型推理模型类似o1推理过程中的框架,以实现自主知识补充。
为了在推理过程中有效整合外部知识,Search - o1将推理过程与智能体RAG机制和知识优化模块相结合。这种设计使大型推理模型能够按需检索外部知识,并将其无缝整合到推理链中,同时保持原始逻辑流。
通过五个复杂推理领域和六个开放领域问答基准测试,我们证明Search - o1在推理领域取得了卓越性能,同时在常识方面也有显著提升。进一步的定量分析证实了其效率和可扩展性,为大型推理模型的可信推理提供了实用指导。
2 相关工作
2.1 大型推理模型
大型推理模型专注于通过利用扩展的推理步骤在测试时提高性能,这与传统的大型预训练模型不同,后者通过增加模型规模或扩展训练数据在训练过程中实现可扩展性。研究表明,测试时扩展可以提高较小模型在复杂任务上的推理能力。最近,像OpenAI - o1、Qwen - QwQ和DeepSeek - R1这样的模型明确展示了思维链推理,在数学、编程等领域模仿人类解决问题的方法。
人们探索了各种方法来实现类似o1的推理能力。一些方法将策略和奖励模型与蒙特卡罗树搜索(MCTS)相结合,尽管这并未将推理内化到模型中。其他研究在训练过程中在推理路径中引入有意错误,以部分内化这些能力。此外,提取训练数据已被证明可以增强模型类似o1的推理技能。类似o1的推理范式在多个领域都表现出强大的性能,包括视觉语言推理、代码生成、医疗保健和机器翻译。然而,这些方法受到其对静态参数化模型的依赖的限制,当内部知识不足时,这些模型无法利用外部世界的知识。
2.2 检索增强生成
检索增强生成(RAG)引入检索机制,以解决生成模型中静态参数的局限性,允许访问外部知识以解决更复杂的问题。该领域的前沿研究从多个方面增强了RAG系统,包括检索的必要性、查询的预处理、检索文档的压缩、去噪、优化、指令遵循等。此外,一些研究探索了端到端模型训练以实现RAG系统,以及基于知识图谱的RAG系统。
最近,智能体RAG系统使模型能够根据需要自主确定何时以及检索什么知识,展现出更强的规划和问题解决能力。也有研究将基于智能体的系统与蒙特卡罗树搜索相结合,以优化复杂工作流程,利用检索器和其他工具来完成任务。然而,现有的RAG方法尚未将类似o1模型的强大推理能力相结合,限制了在解决复杂任务时进一步提高系统性能的潜力。
3 方法
3.1 问题表述
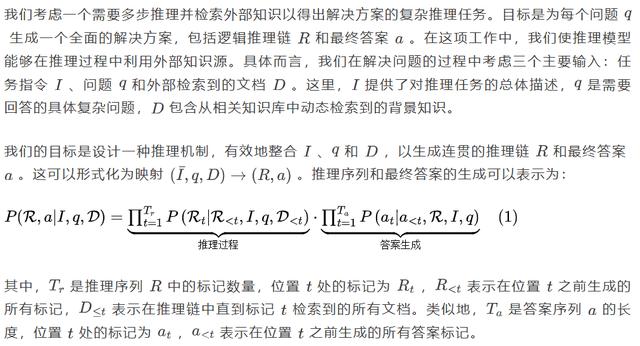
3.2 Search - o1框架概述
Search - o1框架通过将外部知识检索无缝整合到大型推理模型(LRMs)的推理过程中,同时保持思维链的连贯性,来解决大型推理模型中的知识不足问题。如图2所示,我们对三种方法进行了对比分析:普通推理、智能体检索增强生成(RAG)和我们提出的Search - o1框架。
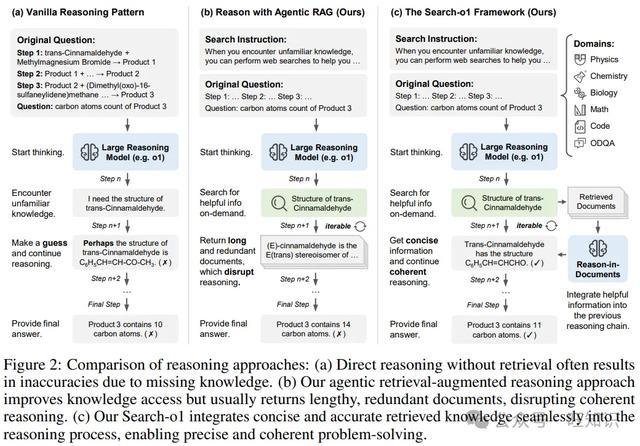
普通推理模式:以图2(a)中的例子为例,任务是确定一个三步化学反应最终产物中的碳原子数。当普通推理方法遇到知识缺口(例如“反式肉桂醛的结构”)时就会陷入困境。由于无法获取准确信息,模型必须依靠假设,这可能会在后续推理步骤中引发连锁错误。
智能体RAG:为了在推理过程中弥补知识缺口,我们构建了智能体RAG机制(图2(b)),使模型在需要时能够自主检索外部知识。当出现不确定性时,例如对化合物结构的不确定,模型会生成有针对性的搜索查询(例如“反式肉桂醛的结构”)。然而,直接插入检索到的文档(这些文档通常包含冗长且不相关的信息)可能会扰乱推理流程并损害连贯性。
Search - o1:我们的Search - o1框架(图2(c))通过整合Reason - in - Documents模块扩展了智能体RAG机制。该模块将检索到的文档浓缩为有针对性的推理步骤,在整合外部知识的同时保持推理链的逻辑流。它考虑当前搜索查询、检索到的文档和现有的推理链,以生成连贯的步骤。这个迭代过程持续进行,直到得出最终答案。以下部分将详细解释智能体RAG、Reason - in - Documents和Search - o1推理过程。
3.3 智能体检索增强生成机制
智能体RAG机制是Search - o1框架的关键组成部分,它使推理模型能够在推理过程中自主决定何时检索外部知识。该机制允许模型自行决定是继续生成推理步骤还是启动检索步骤。详细的模型指令可在附录A.1中找到。
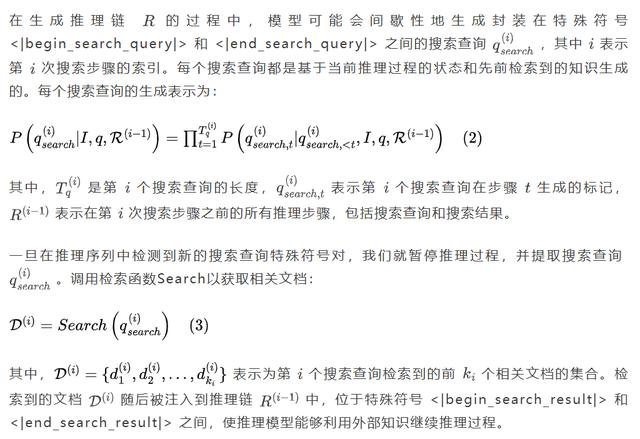
这种智能体机制使模型能够动态、高效地整合外部知识,在避免因过度或不相关的检索结果导致信息过载的同时,保持推理过程的连贯性和相关性。
3.4 通过Reason - in - Documents进行知识优化
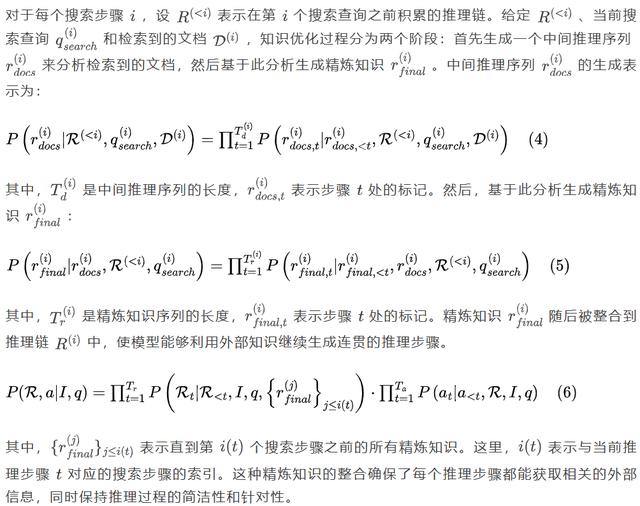
虽然智能体RAG机制解决了推理中的知识缺口问题,但由于检索到的文档篇幅长且冗余,直接插入完整文档可能会破坏推理的连贯性。为克服这一问题,Search - o1框架包含知识优化模块,该模块通过使用原始推理模型的单独生成过程,仅将相关且简洁的信息选择性地整合到推理链中。此模块处理检索到的文档,使其与模型的特定推理需求保持一致,将原始信息转化为精炼、相关的知识,同时保持主推理链的连贯性和逻辑一致性。
Reason - in - Documents的优化准则在附录A.1中有详细说明。这些准则指示模型根据先前的推理步骤、当前的搜索查询以及搜索到的网页内容来分析检索到的网页。目标是提取与原始问题的推理过程直接相关且准确的信息,以确保无缝整合到现有的推理链中。
3.5 Search - o1推理过程
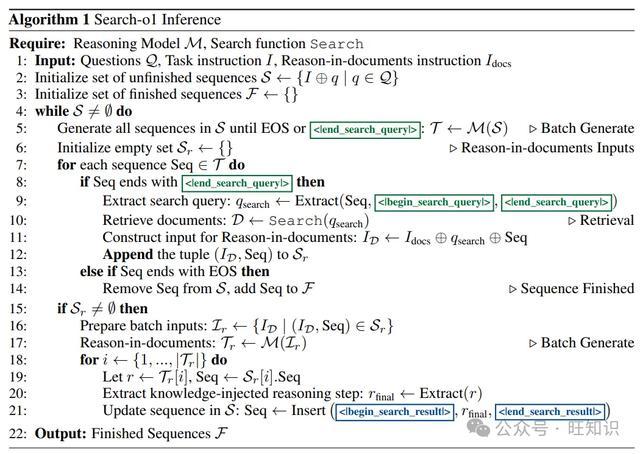
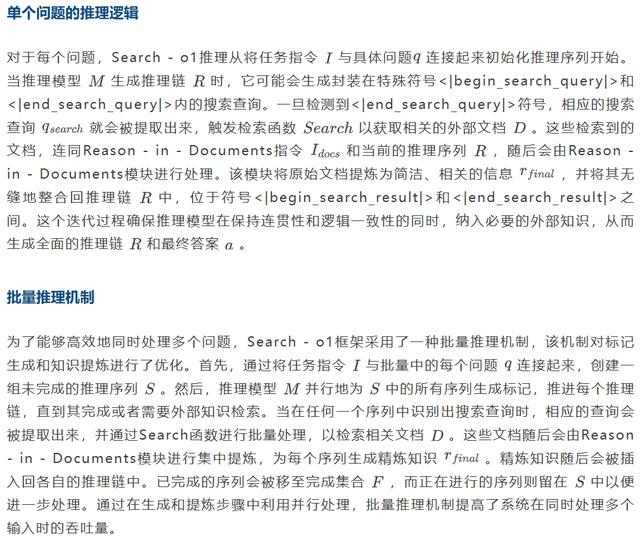
4 实验
4.1 任务和数据集
本实验中使用的评估包括以下两类:
具有挑战性的推理任务:
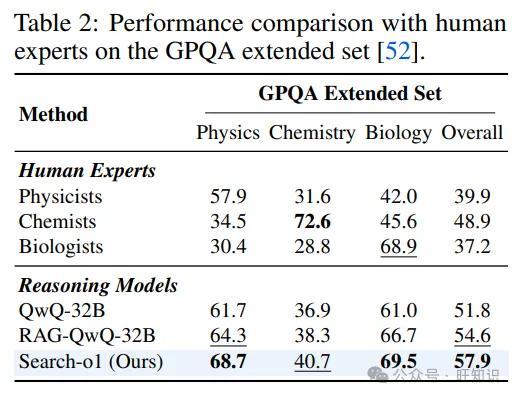
GPQA:是一个博士水平的科学多项选择题问答数据集。这些问题由物理学、化学和生物学领域的专家编写。在我们的主要实验中,我们使用包含198个问题的最高质量的钻石集,在表2中,我们使用包含546个问题的更全面的扩展集,以便与人类专家的表现进行比较。
数学基准测试:包括MATH500、AMC2023和AIME2024。MATH500包含来自MATH测试集的500个问题。AMC2023和AIME2024是中学数学竞赛,涵盖算术、代数、几何等内容,分别包含40个和30个问题。在这三个数据集中,MATH500和AMC相对简单,而AIME更具难度。
LiveCodeBench:是一个用于评估大语言模型编码能力的基准测试,包含简单、中等和困难难度的问题。它收集了近期竞赛平台上发布的编程问题,以避免数据污染。我们使用了2024年8月至11月的问题,共计112个问题。
开放领域问答任务:
单跳问答数据集:自然问题(NQ)包含来自真实谷歌搜索查询的问题,答案来自维基百科文章。TriviaQA是一个大规模数据集,问题来自琐事网站和竞赛,具有复杂的实体关系。
多跳问答数据集:HotpotQA是第一个需要跨多个维基百科段落进行推理的大规模数据集。2WikiMultihopQA(2WIKI)为多跳问题提供了明确的推理路径。MuSiQue具有由五个现有的单跳数据集构建的2 - 4跳问题。Bamboogle收集了谷歌回答错误的复杂问题,以评估模型在各个领域的组合推理能力。
4.2 基线方法
我们将我们的方法与以下基线方法进行比较:
直接推理:这些方法利用模型的内部知识,不进行检索。开源模型包括Qwen2.5 - 32B - Instruct、Qwen2.5 - Coder - 32B - Instruct、QwQ - 32B - Preview、Qwen2.5 - 72B - Instruct和Llama3.3 - 70B - Instruct。闭源非专有模型包括DeepSeek - R1 - Lite - Preview、OpenAI GPT - 4o和o1 - preview。开源模型的结果基于我们的实现,而闭源模型的结果来自其官方发布。
检索增强推理:这些方法检索外部信息以增强推理过程。我们考虑两种检索增强方法:
标准RAG:为原始问题检索前10个文档,并将它们与问题一起输入模型进行推理和答案生成。
RAG智能体(RAgent):允许模型决定何时生成检索查询,如第3.3节所述。为了管理检索文档的长度,受ReAct启发,我们在推理过程中首先检索前10个片段。然后,模型在必要时决定获取哪些URL的完整文档。
4.3 实现细节
对于Search - o1中的骨干大型推理模型,我们使用开源的QwQ - 32B - Preview。对于生成设置,我们在所有模型中使用最大32768个标记、温度为0.7、top_p为0.8、top_k为20以及重复惩罚为1.05。对于检索,我们使用必应网络搜索API,将区域设置为US - EN,检索的前k个文档数设置为10。我们使用Jina Reader API根据给定的URL获取网页内容。对于所有基于检索的方法,遵循[52],我们应用一种回退策略,即当没有提供最终答案时,我们使用直接推理的结果。对于没有专门为类似o1推理进行训练的基线模型,我们应用思维链(CoT)提示,在生成答案之前进行推理。所有模型的详细指令在附录A中提供。所有实验都在八个NVIDIA A800 - 80GB GPU上进行。
4.4 具有挑战性的推理任务的结果
主要结果
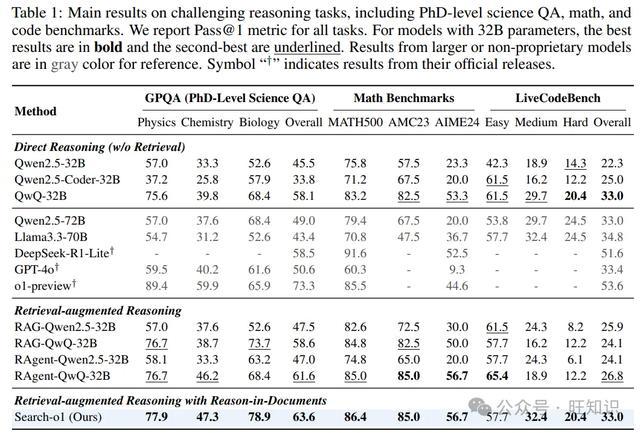
表1展示了Search - o1在复杂推理任务上的性能,主要结果概述如下:
在无检索和有检索增强的两种设置下,大型推理模型QwQ - 32B - Preview始终比传统的指令微调大语言模型表现更优。具有320亿参数的QwQ模型在直接推理设置中甚至优于更大的大语言模型,如Qwen2.5 - 72B和Llama3.3 - 70B,这证明了类似o1的长思维链方法在复杂推理中的有效性。
RAgent - QwQ - 32B在大多数任务中优于基于标准RAG的模型和直接推理的QwQ - 32B,这得益于其智能体搜索机制,该机制可以自主检索信息,以补充每个推理步骤所需的知识。此外,我们发现使用智能体RAG的非推理模型Qwen2.5 - 32B在GPQA上的表现与标准RAG相似,甚至在数学和代码任务上表现下降。这表明普通大语言模型无法有效地将搜索作为解决复杂推理任务的工具。
我们的Search - o1在大多数任务中进一步优于RAgent - QwQ - 32B,证明了我们的Reason - in - Documents策略的有效性,该策略在整合外部知识的同时,确保其不会影响原始推理的连贯性。具体而言,在所有五个数据集的平均值上,Search - o1分别比RAgent - QwQ - 32B和QwQ - 32B高出4.7%和3.1%,并且显著优于非推理模型Qwen2.5 - 32B和Llama3.3 - 70B,分别高出44.7%和39.3%。
检索文档数量的缩放分析
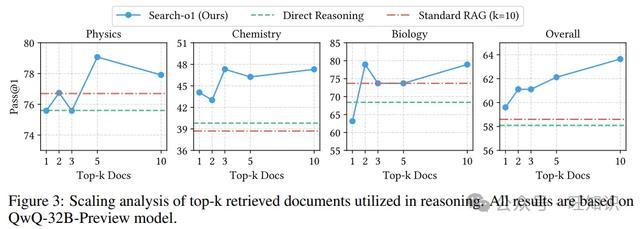
在本实验中,我们分析了随着检索文档数量变化的性能变化,如图3所示。我们的结果表明,Search - o1可以有效地利用越来越多的检索文档,从而在处理复杂推理任务方面取得改进。我们还观察到,就整体性能而言,即使只检索一篇文档,也可以超越使用十篇检索文档的直接推理和标准RAG模型,这展示了智能体搜索和Reason - in - Documents策略的有效性。
与人类专家的比较
我们在GPQA扩展集的各个领域中将我们的Search - o1的性能与人类专家进行了比较。表2展示了来自不同学科(包括物理学、化学和生物学)的人类专家的评估。我们的Search - o1模型在整体性能(57.9)上优于人类专家,在物理学(68.7)和生物学(69.5)领域也是如此,这表明其在处理复杂推理任务方面表现卓越。虽然Search - o1在化学子领域中略落后于化学家(40.7对72.6),但它在整体上仍然具有竞争优势,特别是在多个领域的通用性能方面。这凸显了Search - o1在利用文档检索和推理以实现与专家水平相当或超越专家水平的跨领域性能方面的有效性。
4.5 开放领域问答任务的结果
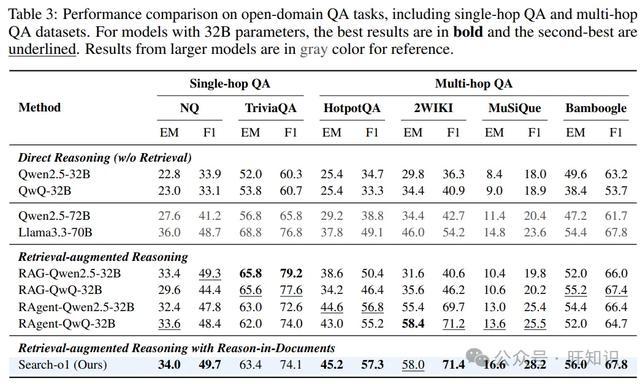
除了大型推理模型擅长的推理任务外,我们还探索了我们的Search - o1在开放领域问答任务上的性能。表3展示了整体结果。关键观察结果如下:
对于无检索的直接推理,大型推理模型QwQ - 32B的性能总体上与非推理大语言模型Qwen2.5 - 32B相似,在所有问答数据集上的平均EM值略有下降(31.3对30.7)。这表明大型推理模型在开放领域问答任务上的表现不如在推理任务上那么出色。
当采用检索增强推理时,检索显著提高了推理模型和非推理模型在所有任务上的性能,这表明模型在这些任务中存在知识缺口。此外,对于QwQ - 32B模型,智能体RAG在多跳问答任务上比标准RAG平均提高了23.2%的EM值,这证明了我们的智能体RAG策略在基于知识的多跳问答中的有效性。然而,我们也观察到在单跳任务中性能没有显著变化(平均EM值为47.8对47.6),因为这些问题只需要来自单个知识点的信息,无需多次检索。这也验证了智能体搜索机制可以更好地在更复杂和具有挑战性的推理任务中发挥大型推理模型的潜力。
对于我们的Search - o1,我们发现它在多跳任务中通常优于所有基线方法。具体而言,在平均EM指标方面,我们的Search - o1分别比RAG - QwQ - 32B和RAgent - QwQ - 32B高出29.6%和5.3%,这证明了我们的Reason - in - Documents策略在复杂问答任务中的有效性。这进一步强调了保持外部知识与推理逻辑链一致性的重要性。
5 结论
在这项工作中,我们提出了Search - o1,这是一个通过整合智能体检索增强生成机制和Reason - in - Documents模块来解决大型推理模型(LRMs)中固有知识不足问题的框架。我们的方法使大型推理模型能够在推理过程中自主检索并无缝整合外部知识,从而提高其长步骤推理能力的准确性和连贯性。在科学、数学和编程等各种复杂推理任务以及多个开放领域问答基准测试上进行的全面实验表明,Search - o1始终优于现有的检索增强和直接推理方法。值得注意的是,Search - o1不仅在处理复杂推理挑战方面超越了基线模型,而且在特定领域中达到了与人类专家相当或超越人类专家的性能水平。这些发现强调了Search - o1在显著提高大型推理模型的可靠性和通用性方面的潜力,为在复杂问题解决场景中构建更可信和有效的智能系统铺平了道路。
作者:张长旺,图源:旺知识
参考资料
标题:Search-o1: Agentic Search-Enhanced Large Reasoning Models
作者:Xiaoxi Li, Guanting Dong, Jiajie Jin, Yuyao Zhang, Yujia Zhou, Yutao Zhu, Peitian Zhang, Zhicheng Dou
单位:Renmin University of China, Tsinghua University
标签:人工智能、大型推理模型、检索增强生成、知识精炼
概述: 本文提出 Search-o1 框架,通过智能体检索增强生成机制和 Reason-in-Documents 模块解决大型推理模型知识不足问题,实验证明其性能优异。
链接:https://arxiv.org/pdf/2501.05366