Google智能体(Agent)白皮书详细翻译解读:架构到实践进阶之路
人类在解决问题时常借助工具补充知识,生成式AI模型同样可通过工具获取实时信息并执行现实任务。智能体概念由此产生,它超越了模型自身能力。研究智能体有助于拓展AI在实际场景中的应用,使其能够处理更复杂、多样化的任务,推动AI技术在更多领域发挥价值。
我们详细翻译解读最新论文,文末有相关信息。
作者:张长旺,图源:旺知识
文章深入阐述了生成式AI智能体,介绍其定义为借助工具观察世界并行动以达成目标的应用程序。剖析了智能体架构中的模型、工具、编排层等核心组件,对比了智能体与模型的差异。详细介绍扩展、函数、数据存储等工具类型及其用例,并探讨通过针对性学习提升模型选择工具的能力。还通过LangChain构建智能体实例以及Vertex AI平台的应用示例,展示智能体在实际场景中的运作。
- 研究背景:生成式AI模型虽在文本和图像生成方面表现出色,但与外部世界交互能力受限,难以满足复杂现实场景需求。人类在解决问题时借助各类工具,受此启发,研究人员探索让生成式AI模型利用工具扩展能力,进而提出智能体概念。
- 研究贡献:
- 详细阐述智能体架构组成,明确模型、工具、编排层等组件功能及相互关系,为智能体开发提供理论框架。
- 分类介绍扩展、函数、数据存储等工具类型,针对不同应用场景提供多样化工具选择方案。
- 提出多种针对性学习方法提升模型选择工具能力,增强智能体在实际应用中的效能。
- 实现设计:
- 模型选择:根据应用需求选择合适的语言模型,可通过特定示例优化模型以适配智能体任务。
- 工具集成:扩展通过示例引导智能体调用API;函数由模型生成参数并在客户端执行;数据存储将数据转化为向量嵌入供智能体使用。
- 流程编排:采用循环过程管理智能体信息处理、推理和决策,可结合不同推理框架如ReAct等。
谷歌发布的一篇名为《智能体》的新白皮书,畅想了人工智能在商业领域扮演更积极、独立角色的未来。
它引入了智能体的概念,这是一种软件系统,旨在超越当今的人工智能模型,能够通过推理、规划并采取行动来实现特定目标。与仅基于预先存在的训练数据生成回复的传统人工智能系统不同,智能体可以与外部系统交互、自主决策并完成复杂任务。
白皮书中解释道:“智能体是自主的,能够在无需人类干预的情况下行动。” 并将其描述为结合了推理、逻辑和实时数据访问的系统。这些智能体背后的理念十分宏大:它们可以帮助企业实现任务自动化,解决问题,并做出曾经只能由人类完成的决策。
该白皮书详细阐述了智能体的工作原理以及运行所需条件。但其更广泛的影响同样不可忽视。智能体不仅仅是对现有技术的升级,它们代表了组织运营、竞争和创新方式的转变。采用这些系统的企业可能会在效率和生产力方面取得显著提升,而犹豫不决的企业可能会发现自己难以跟上步伐。
以下是从谷歌白皮书中总结出的五条最重要的见解,以及它们对商业领域人工智能未来的意义。
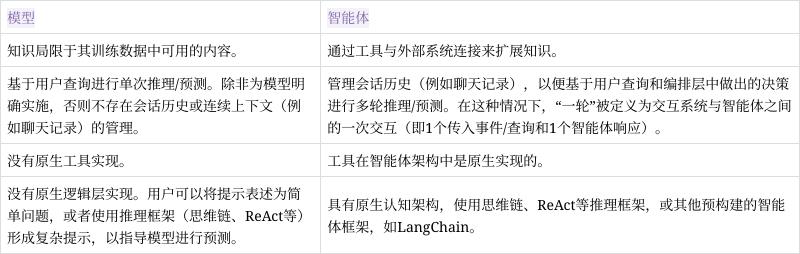
- 智能体不仅仅是更智能的模型 谷歌认为,智能体与传统语言模型有着根本性的区别。虽然像GPT-4o或谷歌的双子座等模型在生成单轮回复方面表现出色,但它们的能力局限于从训练数据中学到的内容。相比之下,智能体被设计用于与外部系统交互、从实时数据中学习并执行多步骤任务。白皮书中指出:“(传统模型中的)知识局限于其训练数据中可用的内容。智能体通过工具与外部系统建立连接,从而扩展了这一知识范围。” 这种差异并非仅仅停留在理论层面。想象一下,给一个传统语言模型布置一项推荐旅行行程的任务,它可能会基于一般知识给出建议,但却无法预订航班、查询酒店房态,也不能根据用户反馈调整推荐内容。然而,智能体却可以完成所有这些事情,将实时信息与自主决策相结合。这一转变将智能体定位为一种新型的数字工作者,能够处理复杂的工作流程。对于企业而言,这可能意味着实现那些以前需要多个人员协作才能完成的任务的自动化。通过将推理和执行相结合,智能体在从物流到客户服务等各个行业中都可能变得不可或缺。
- 认知架构驱动其决策过程 智能体能力的核心在于其认知架构,谷歌将其描述为一个用于推理、规划和决策的框架。这个被称为编排层的架构,使智能体能够以循环方式处理信息,融入新数据以优化其行动和决策。谷歌将这一过程比作一位厨师在繁忙的厨房中准备饭菜。厨师收集食材,考虑顾客的偏好,并根据反馈或食材供应情况对食谱进行调整。同样,智能体收集数据,思考下一步行动,并调整自身行为以实现特定目标。编排层依赖先进的推理技术来指导决策。诸如推理与行动(ReAct)、思维链(CoT)和思维树(ToT)等框架,为分解复杂任务提供了结构化方法。例如,ReAct使智能体能够实时将推理与行动相结合,而ToT则允许它同时探索多种可能的解决方案。这些技术使智能体不仅能够做出被动反应,还能主动采取行动。根据白皮书所述,这使得它们具有高度的适应性,能够以传统模型无法企及的方式应对不确定性和复杂性。对于企业来说,这意味着智能体可以承担诸如解决供应链问题或分析财务数据等任务,并且具有较高的自主性,从而减少了对持续人工监督的需求。
- 工具拓展了智能体超越训练数据的能力范围 传统人工智能模型常被形容为 “静态的知识库”,局限于它们所接受的训练内容。而智能体则可以通过工具访问实时信息,并与外部系统进行交互。正是这种能力,使它们在现实世界的应用中具有实用性。白皮书中解释道:“工具弥合了智能体内部能力与外部世界之间的差距。” 这些工具包括应用程序编程接口(API)、扩展程序和数据存储,它们允许智能体获取信息、执行操作,并检索随时间演变的知识。例如,一个负责规划商务旅行的智能体,可以使用API扩展来查询航班时刻表,利用数据存储来检索旅行政策,并借助地图工具查找附近的酒店。这种与外部系统动态交互的能力,将智能体从静态的回复者转变为业务流程中的积极参与者。谷歌还强调了这些工具的灵活性。例如,函数允许开发者将某些任务卸载到客户端系统,使企业在智能体如何访问敏感数据或执行特定操作方面拥有更多控制权。对于金融和医疗等合规性和安全性至关重要的行业而言,这种灵活性可能至关重要。
- 检索增强生成技术使智能体更智能 智能体设计中最具前景的进展之一,是检索增强生成(RAG)技术的集成。当训练数据不足时,这项技术允许智能体查询外部数据源,如向量数据库或结构化文档。白皮书中解释道:“数据存储通过提供对更动态、最新信息的访问,解决了(静态模型的)局限性问题。” 书中描述了智能体如何实时检索相关数据,以使它们的回复基于事实信息。基于RAG的智能体在信息快速变化的领域中尤其有价值。例如,在金融领域,智能体可以在提出投资建议前获取实时市场数据。在医疗保健领域,它可以检索最新的研究成果,为诊断建议提供参考。这种方法还解决了人工智能中一个长期存在的问题:幻觉,即生成不正确或虚构的信息。通过将回复建立在现实世界的数据基础上,智能体可以提高准确性和可靠性,使其更适合高风险的应用场景。
- 谷歌提供工具以加速智能体的部署 虽然白皮书包含丰富的技术细节,但它也为希望实施智能体的企业提供了实用指导。谷歌重点介绍了两个关键平台:LangChain,一个用于智能体开发的开源框架;以及Vertex AI,一个用于大规模部署智能体的托管平台。LangChain通过允许开发者将推理步骤和工具调用串联起来,简化了智能体的构建过程。与此同时,Vertex AI提供了测试、调试和性能评估等功能,使得部署生产级智能体变得更加容易。白皮书中指出:“Vertex AI使开发者能够专注于构建和优化他们的智能体,而基础设施、部署和维护的复杂性则由平台自身管理。” 这些工具可以降低那些希望尝试智能体但缺乏广泛技术专长的企业的准入门槛。然而,它们也引发了关于广泛采用智能体的长期后果的问题。随着这些系统变得越来越强大,企业需要考虑如何在效率提升与潜在风险之间取得平衡,比如对自动化的过度依赖,或者决策透明度方面的伦理问题。
谷歌关于智能体的白皮书,对人工智能的未来发展描绘了一幅详细而宏大的愿景。对于企业而言,信息十分明确:智能体并非仅仅是一个理论概念,它们是能够重塑企业运营方式的实用工具。
然而,这种转变不会一蹴而就。部署智能体需要精心规划、实验,以及重新思考传统工作流程的意愿。正如白皮书中所指出的:“由于支撑其架构的基础模型具有生成性,没有两个智能体是完全相同的。”
目前,智能体既代表着机遇,也带来了挑战。那些投资于理解和实施这项技术的企业,有望获得显著的竞争优势。而那些观望等待的企业,可能会发现在一个智能自主系统日益主导的世界中,自己只能奋力追赶。
- 引言
- 什么是智能体?
- 模型
- 工具
- 编排层
- 智能体与模型对比
- 认知架构:智能体如何运作
- 工具:我们通往外部世界的钥匙
- 扩展
- 示例扩展
- 函数
- 用例
- 函数示例代码
- 数据存储
- 实施与应用
- 工具回顾
- 通过针对性学习提升模型性能
- 使用LangChain快速启动智能体
- Vertex AI智能体的生产应用
- 总结
这种将推理、逻辑以及对外部信息的访问与生成式人工智能模型相连接的方式,引出了智能体的概念。
人类在处理复杂模式识别任务方面表现出色。然而,在得出结论之前,他们常常依赖工具,如书籍、谷歌搜索或计算器,来补充先验知识。与人类一样,生成式人工智能模型也可以通过训练来使用工具,以获取实时信息或建议现实世界中的行动。例如,模型可以利用数据库检索工具来获取特定信息,如客户的购买历史,从而生成个性化的购物推荐。或者,根据用户的查询,模型可以进行各种API调用,代你向同事发送电子邮件回复或完成金融交易。为此,模型不仅必须能够访问一组外部工具,还需要具备以自主方式规划和执行任何任务的能力。这种将推理、逻辑以及对外部信息的访问与生成式人工智能模型相连接的方式,引出了智能体的概念,即一种超越生成式人工智能模型独立能力的程序。本白皮书将更详细地探讨所有这些及相关方面。
从最基本的形式来看,生成式人工智能智能体可以被定义为一种应用程序,它试图通过观察世界并利用自身可用的工具对世界采取行动来实现目标。智能体是自主的,可以在无需人类干预的情况下行动,特别是在被赋予明确的目标时。智能体在实现目标的过程中也可以采取主动的方式。即使在没有人类明确指令集的情况下,智能体也能够推理出下一步应该采取什么行动来实现最终目标。虽然人工智能中智能体的概念非常普遍且强大,但本白皮书将重点关注在发布时生成式人工智能模型能够构建的特定类型的智能体。
为了理解智能体的内部运作,让我们首先介绍驱动智能体行为、行动和决策的基础组件。这些组件的组合可以被描述为一种认知架构,通过对这些组件的混合和匹配,可以实现多种这样的架构。从核心功能来看,如图1所示,智能体的认知架构中有三个基本组件。
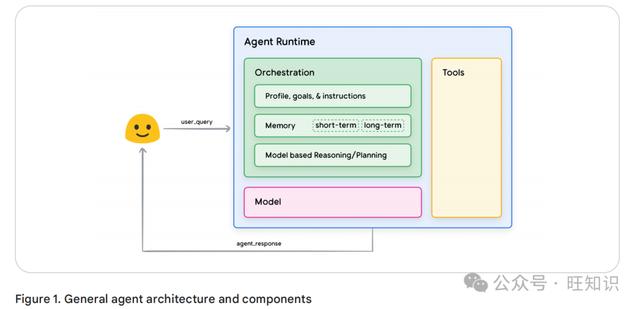
图1. 通用智能体架构和组件
在智能体的范畴内,模型指的是语言模型(LM),它将作为智能体流程的核心决策器。智能体使用的模型可以是一个或多个任意大小(小型/大型)的语言模型,这些模型能够遵循基于指令的推理和逻辑框架,如ReAct、思维链(Chain-of-Thought)或思维树(Tree-of-Thoughts)。模型可以是通用的、多模态的,也可以根据特定智能体架构的需求进行微调。为了在生产中获得最佳效果,你应该选择最适合你期望的最终应用的模型,并且理想情况下,该模型已经在与你计划在认知架构中使用的工具相关的数据特征上进行了训练。需要注意的是,模型通常不会使用智能体的特定配置设置(即工具选择、编排/推理设置)进行训练。然而,通过向模型提供展示智能体能力的示例,包括智能体在各种场景中使用特定工具或推理步骤的实例,可以进一步针对智能体的任务对模型进行优化。
基础模型尽管在文本和图像生成方面表现出色,但由于无法与外部世界进行交互而受到限制。工具弥补了这一差距,使智能体能够与外部数据和服务进行交互,同时解锁了比基础模型本身更广泛的行动范围。工具可以有多种形式,复杂程度也各不相同,但通常与常见的Web API方法(如GET、POST、PATCH和DELETE)一致。例如,一个工具可以更新数据库中的客户信息,或者获取天气数据以影响智能体向用户提供的旅行建议。借助工具,智能体可以访问和处理现实世界的信息。这使它们能够支持更专业的系统,如检索增强生成(RAG),显著扩展了智能体的能力,超越了基础模型独自所能达到的水平。我们将在下面更详细地讨论工具,但最重要的是要理解,工具弥合了智能体内部能力与外部世界之间的差距,开启了更广泛的可能性。
编排层描述了一个循环过程,该过程控制智能体如何接收信息、进行一些内部推理,并利用这些推理来指导其下一个行动或决策。一般来说,这个循环会一直持续,直到智能体达到目标或遇到停止点。编排层的复杂程度因智能体及其执行的任务而异。有些循环可能是带有决策规则的简单计算,而其他循环可能包含链式逻辑、涉及额外的机器学习算法,或实施其他概率推理技术。我们将在认知架构部分更详细地讨论智能体编排层的具体实现。
为了更清晰地理解智能体和模型之间的区别,请参考以下图表:
想象一位厨师在繁忙的厨房里。他们的目标是为餐厅顾客制作美味的菜肴,这涉及到一系列的规划、执行和调整循环。
- 他们收集信息,比如顾客的订单以及 pantry 和冰箱里有哪些食材。
- 他们根据刚刚收集到的信息,在内部思考可以制作哪些菜肴以及搭配何种风味。
- 他们采取行动制作菜肴:切菜、调配香料、煎肉。在这个过程的每个阶段,厨师都会根据需要进行调整,随着食材的消耗或收到顾客反馈,不断完善他们的计划,并利用之前的结果来确定下一个行动计划。这种信息摄入、规划、执行和调整的循环,描述了厨师为实现目标所采用的独特认知架构。
就像厨师一样,智能体可以通过迭代处理信息、做出明智决策,并根据先前的输出改进下一步行动,利用认知架构来实现最终目标。智能体认知架构的核心是编排层,它负责维护记忆、状态、推理和规划。它利用快速发展的提示工程领域及相关框架来指导推理和规划,使智能体能够更有效地与环境互动并完成任务。语言模型的提示工程框架和任务规划方面的研究正在迅速发展,产生了各种有前景的方法。以下并非详尽无遗的列表,而是在本文发布时一些最流行的框架和推理技术:
- ReAct,一种提示工程框架,为语言模型提供了一种在用户查询上进行推理和采取行动的思维过程策略,无论是否有上下文示例。ReAct提示已被证明优于多个SOTA基线,并提高了大语言模型的人机互操作性和可信度。
- 思维链(Chain-of-Thought,CoT),一种通过中间步骤实现推理能力的提示工程框架。思维链有各种子技术,包括自一致性、主动提示和多模态思维链,每种技术根据具体应用都有其优缺点。
- 思维树(Tree-of-Thoughts,ToT),一种适用于探索或战略前瞻性任务的提示工程框架。它是对思维链提示的泛化,允许模型探索各种思维链,这些思维链作为使用语言模型解决一般问题的中间步骤。
智能体可以利用上述推理技术之一,或许多其他技术,为给定的用户请求选择下一个最佳行动。例如,让我们考虑一个被编程为使用ReAct框架为用户查询选择正确行动和工具的智能体。事件序列可能如下所示:
- 用户向智能体发送查询。
- 智能体开始ReAct序列。
- 智能体向模型提供一个提示,要求它生成下一个ReAct步骤及其相应输出:
- 这个思考/行动/行动输入/观察过程可能根据需要重复N次。
- 这是选择工具的地方。
- 例如,一个行动可以是[航班、搜索、代码、无]中的一个,前三个代表模型可以选择的已知工具,最后一个代表“不选择工具”。
- 问题:来自用户查询的输入问题,随提示一起提供。
- 思考:模型关于下一步该做什么的想法。
- 行动:模型关于下一步采取什么行动的决策。
- 行动输入:模型关于为工具提供什么输入的决策(如果有)。
- 观察:行动/行动输入序列的结果。
- 最终答案:模型对原始用户查询的最终回答。
- ReAct循环结束,并将最终答案返回给用户。
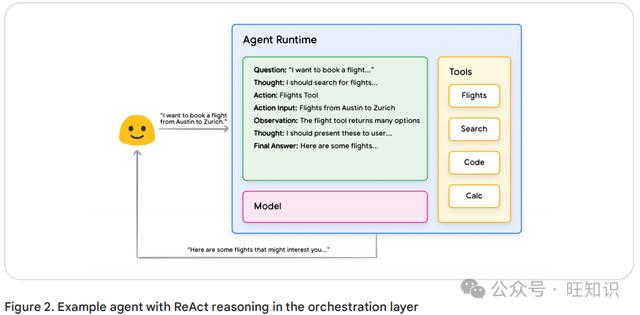
图2. 在编排层中使用ReAct推理的示例智能体
如图2所示,模型、工具和智能体配置协同工作,根据用户的原始查询为用户提供有依据的、简洁的回复。虽然模型可能根据其先验知识猜测(幻觉)出一个答案,但它转而使用了一个工具(航班)来搜索实时外部信息。这些额外的信息被提供给模型,使其能够根据真实数据做出更明智的决策,并将这些信息总结后返回给用户。
总之,智能体回复的质量直接取决于模型对各种任务进行推理和行动的能力,包括选择正确工具的能力,以及工具的定义是否完善。就像厨师用新鲜食材精心烹制菜肴并关注顾客反馈一样,智能体依赖合理的推理和可靠的信息来提供最佳结果。在下一节中,我们将深入探讨智能体与新数据建立连接的各种方式。
虽然语言模型在处理信息方面表现出色,但它们缺乏直接感知和影响现实世界的能力。这限制了它们在需要与外部系统或数据进行交互的场景中的实用性。从某种意义上说,这意味着语言模型的好坏取决于它从训练数据中学到的内容。但是,无论我们向模型输入多少数据,它们仍然缺乏与外部世界进行交互的基本能力。那么,我们如何使我们的模型能够与外部系统进行实时、上下文感知的交互呢?函数、扩展、数据存储和插件都是为模型提供这种关键能力的方式。
尽管它们有许多不同的名称,但工具是连接我们的基础模型与外部世界的桥梁。与外部系统和数据的这种连接使我们的智能体能够执行更广泛的任务,并且执行起来更加准确和可靠。例如,工具可以使智能体调整智能家居设置、更新日历、从数据库中获取用户信息,或者根据一组特定指令发送电子邮件。
截至本文发布之日,谷歌模型能够与之交互的主要工具有三种类型:扩展、函数和数据存储。通过为智能体配备工具,我们为它们开启了巨大的潜力,使它们不仅能够理解世界,还能够对世界采取行动,为无数新的应用和可能性打开了大门。
理解扩展的最简单方法是将它们视为以标准化方式连接API和智能体的桥梁,使智能体能够无缝执行API,而无需考虑其底层实现。假设你构建了一个智能体,其目标是帮助用户预订航班。你知道你想使用谷歌航班API来检索航班信息,但你不确定如何让你的智能体调用这个API端点。
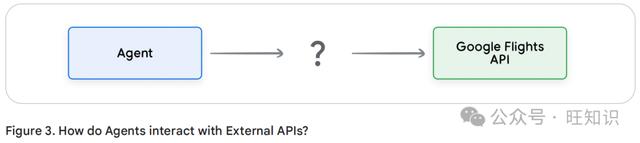
图3. 智能体如何与外部API交互?
一种方法可能是实现自定义代码,该代码将获取传入的用户查询,解析查询以获取相关信息,然后进行API调用。例如,在航班预订用例中,用户可能会说“我想预订从奥斯汀到苏黎世的航班”。在这种情况下,我们的自定义代码解决方案需要从用户查询中提取“奥斯汀”和“苏黎世”作为相关实体,然后再尝试进行API调用。但是,如果用户说“我想预订到苏黎世的航班”,而没有提供出发城市,会发生什么情况呢?如果没有所需的数据,API调用将失败,并且需要实现更多代码来处理像这样的边缘和极端情况。这种方法不可扩展,并且在任何超出已实现的自定义代码范围的场景中都很容易出错。
一种更具弹性的方法是使用扩展。扩展通过以下方式连接智能体和API:
- 使用示例教导智能体如何使用API端点。
- 教导智能体成功调用API端点需要哪些参数。
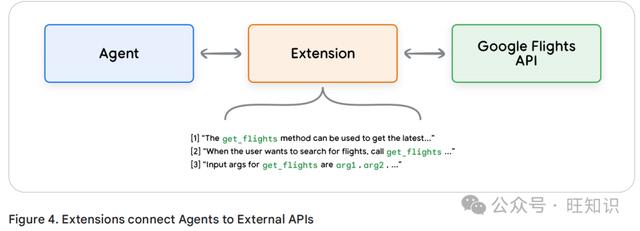
图4. 扩展将智能体连接到外部API
扩展可以独立于智能体进行构建,但应作为智能体配置的一部分提供。智能体在运行时使用模型和示例来决定是否有适合解决用户查询的扩展。这凸显了扩展的一个关键优势,即其内置的示例类型,使智能体能够动态地为任务选择最合适的扩展。
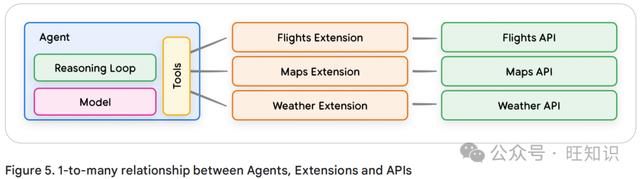
图5. 智能体、扩展和API之间的一对多关系
可以将此过程想象成软件开发人员在为用户问题寻找解决方案时决定使用哪些API端点。如果用户想要预订航班,开发人员可能会使用谷歌航班API。如果用户想知道离他们位置最近的咖啡店在哪里,开发人员可能会使用谷歌地图API。同样,智能体/模型堆栈使用一组已知的扩展来决定哪一个最适合用户的查询。如果你想看到扩展的实际运行效果,可以在Gemini应用程序中尝试,方法是进入“设置”>“扩展”,然后启用任何你想要测试的扩展。例如,你可以启用谷歌航班扩展,然后问Gemini“显示下周五从奥斯汀到苏黎世的航班”。
为了简化扩展的使用,谷歌提供了一些开箱即用的扩展,这些扩展可以快速导入到你的项目中,并且只需进行最少的配置即可使用。例如,代码片段1中的代码解释器扩展允许你根据自然语言描述生成并运行Python代码。
import vertexaiimport pprintPROJECT_ID = "YOUR_PROJECT_ID"REGION = "us-central1"vertexai.init(project=PROJECT_ID, location=REGION)from vertexai.preview.extensions import Extensionextension_code_interpreter = Extension.from_hub("code_interpreter")CODE_QUERY = """Write a python method to invert a binary tree in O(n) time."""response = extension_code_interpreter.execute( operation_params={"query": CODE_QUERY}, operation_id="generate_and_execute",)print("Generated Code:")pprint.pprint({response['generated_code']})# 上述代码片段将生成以下代码。Generated Code:class TreeNode: def __init__(self, val=0, left=None, right=None): self.val = val self.left = left self.right = rightdef invert_binary_tree(root): """ Args: root: 二叉树的根节点。 Returns: 反转后的二叉树的根节点。 """ if not root: return None # 递归地交换左右子树 invert_binary_tree(root.right), invert_binary_tree(root.left) root.left, root.right = root.right, root.left return root# 示例用法:# 构建一个示例二叉树root = TreeNode(4)root.left = TreeNode(2)root.right = TreeNode(7)root.left.left = TreeNode(1)root.left.right = TreeNode(3)root.right.left = TreeNode(6)root.right.right = TreeNode(9)# 反转二叉树inverted_root = invert_binary_tree(root)代码片段1. 代码解释器扩展可以生成并运行Python代码
总之,扩展为智能体提供了多种感知、交互和影响外部世界的方式。这些扩展的选择和调用是由示例引导的,所有示例都作为扩展配置的一部分进行定义。
在软件工程领域,函数被定义为完成特定任务且可根据需要重复使用的自包含代码模块。当软件开发人员编写程序时,他们通常会创建许多函数来执行各种任务。他们还会定义何时调用函数a而非函数b的逻辑,以及预期的输入和输出。
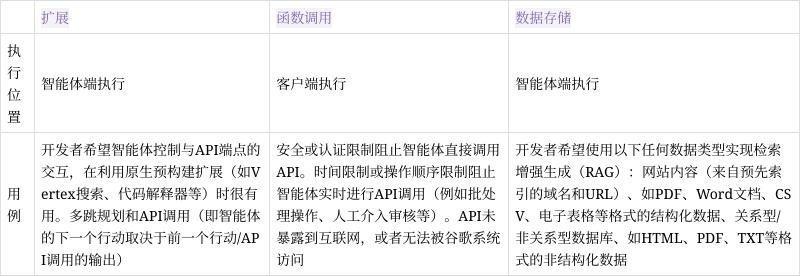
在智能体的世界里,函数的工作方式非常相似,但我们可以用模型取代软件开发人员。模型可以获取一组已知的函数,并根据其规范决定何时使用每个函数以及该函数需要哪些参数。函数与扩展在几个方面有所不同,最显著的是:
- 模型输出一个函数及其参数,但不会进行实时API调用。
- 函数在客户端执行,而扩展在智能体端执行。
再次以我们的谷歌航班示例来说,函数的一个简单设置可能如下图7所示。
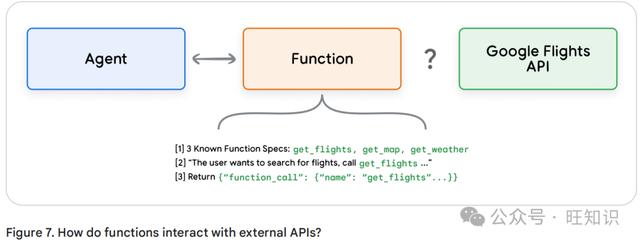
图7. 函数如何与外部API交互?
请注意,这里的主要区别在于,无论是函数还是智能体都不会直接与谷歌航班API交互。那么API调用实际上是如何发生的呢?
对于函数,调用实际API端点的逻辑和执行被从智能体转移回客户端应用程序,如下图8和图9所示。这为开发人员提供了对应用程序中数据流更精细的控制。开发人员可能选择使用函数而非扩展的原因有很多,以下是一些常见的用例:
- API调用需要在应用程序栈的另一层进行,而不是在直接的智能体架构流程中(例如中间件系统、前端框架等)。
- 安全或认证限制阻止智能体直接调用API(例如API未暴露到互联网,或者智能体基础设施无法访问)。
- 时间或操作顺序限制阻止智能体实时进行API调用(例如批处理操作、人工介入审核等)。
- 需要对API响应应用额外的数据转换逻辑,而智能体无法执行该操作。例如,考虑一个API端点没有提供用于限制返回结果数量的过滤机制。在客户端使用函数为开发人员提供了进行这些转换的额外机会。
- 开发人员希望在不部署额外API端点基础设施的情况下迭代智能体开发(即函数调用可以充当API的“桩”)。
虽然这两种方法在内部架构上的差异很微妙,如图8所示,但函数调用对外部基础设施的额外控制和松耦合依赖,使其成为开发人员有吸引力的选择。
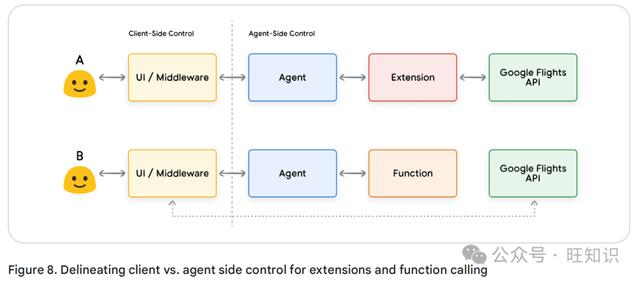
图8. 区分扩展和函数调用的客户端与智能体端控制
模型可用于调用函数,以便为终端用户处理复杂的客户端执行流程,在这种情况下,智能体开发者可能不希望语言模型管理API执行(就像扩展的情况那样)。让我们考虑以下示例,一个智能体被训练为旅行礼宾员,与想要预订度假旅行的用户进行交互。目标是让智能体生成一个城市列表,我们可以在中间件应用程序中使用该列表来为用户的旅行规划下载图像、数据等。用户可能会说:“我想和家人一起去滑雪旅行,但我不知道去哪里。”
在对模型的典型提示中,输出可能如下所示:“当然,这里有一些你可以考虑的适合家庭滑雪旅行的城市:
- 美国科罗拉多州的克雷斯特德比特
- 加拿大不列颠哥伦比亚省的惠斯勒
- 瑞士的采尔马特”
虽然上述输出包含我们需要的数据(城市名称),但其格式并不理想,不利于解析。通过函数调用,我们可以训练模型以结构化的风格(如JSON)格式化此输出,这更便于其他系统进行解析。给定用户相同的输入提示,函数的示例JSON输出可能如代码片段5所示。
{ "function_call": { "name": "display_cities", "args": { "cities": ["Crested Butte", "Whistler", "Zermatt"], "preferences": "skiing" } }}代码片段5. 用于显示城市列表和用户偏好的示例函数调用有效负载
这个JSON有效负载由模型生成,然后发送到我们的客户端服务器,我们可以根据需要对其进行处理。在这个特定案例中,我们将调用谷歌地图API,使用模型提供的城市查找图像,然后将它们作为格式化的丰富内容返回给用户。请考虑图9中的序列图,它详细展示了上述交互的步骤。
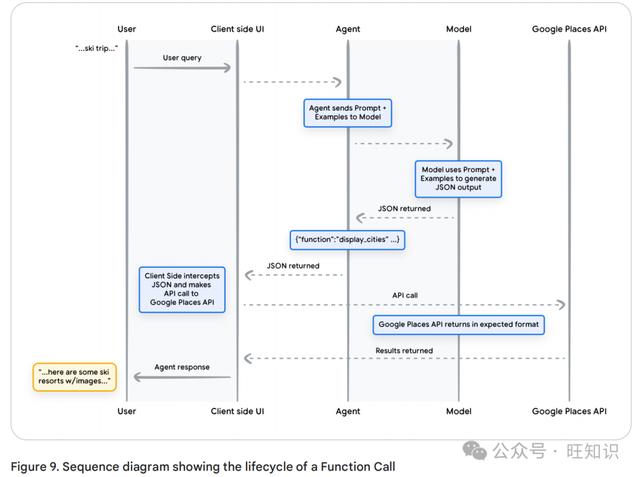
图9. 显示函数调用生命周期的序列图
图9中示例的结果是,模型被用于“填空”,提供客户端UI调用谷歌地图API所需的参数。客户端UI使用模型在返回的函数中提供的参数来管理实际的API调用。这只是函数调用的一个用例,但还有许多其他场景需要考虑,例如:
- 你希望语言模型建议一个你可以在代码中使用的函数,但你不想在代码中包含凭证。由于函数调用不会运行函数,你无需在包含函数信息的代码中包含凭证。
- 你正在运行可能需要几秒钟以上时间的异步操作。这些场景非常适合函数调用,因为它本身就是一个异步操作。
- 你希望在与生成函数调用及其参数的系统不同的设备上运行函数。
关于函数,需要记住的一个关键要点是,它们旨在为开发人员提供对API调用执行以及整个应用程序中数据流的更精细控制。在图9的示例中,开发人员选择不将API信息返回给智能体,因为这与智能体未来可能采取的行动无关。然而,根据应用程序的架构,将外部API调用数据返回给智能体以影响未来的推理、逻辑和行动选择可能是有意义的。最终,这取决于应用程序开发人员为特定应用程序做出正确的选择。
为了从我们的滑雪度假场景中获得上述输出,让我们构建每个组件,使其与我们的gemini-1.5-flash-001模型协同工作。
首先,我们将display_cities函数定义为一个简单的Python方法。
from typing import Optionaldef display_cities(cities: list[str], preferences: Optional[str] = None): """根据用户的搜索查询和偏好提供城市列表。 Args: preferences (str): 用户的搜索偏好,如滑雪、海滩、餐厅、烧烤等。 cities (list[str]): 推荐给用户的城市列表。 Returns: list[str]: 推荐给用户的城市列表。 """ return cities代码片段6. 用于显示城市列表的函数的示例Python方法
接下来,我们将实例化我们的模型,构建工具,然后将用户的查询和工具传递给模型。执行以下代码将得到代码片段底部所示的输出。
from vertexai.generative_models import GenerativeModel, Tool, FunctionDeclarationmodel = GenerativeModel("gemini-1.5-flash-001")display_cities_function = FunctionDeclaration.from_func(display_cities)tool = Tool(function_declarations=[display_cities_function])message = "I’d like to take a ski trip with my family but I’m not sure where to go."res = model.generate_content(message, tools=[tool])print(f"Function Name: {res.candidates[0].content.parts[0].function_call.name}")print(f"Function Args: {res.candidates[0].content.parts[0].function_call.args}")# 输出# Function Name: display_cities# Function Args: {'preferences': 'skiing', 'cities': ['Aspen', 'Vail', 'Park City']}代码片段7. 构建工具,将其与用户查询一起发送到模型并允许函数调用发生
总之,函数提供了一个简单直接的框架,使应用程序开发人员能够对数据流和系统执行进行精细控制,同时有效地利用智能体/模型生成关键输入。开发人员可以根据特定的应用程序架构要求,有选择地决定是否让智能体“参与循环”,即返回外部数据,或者省略它。
可以将语言模型想象成一个巨大的图书馆,里面存放着它的训练数据。但与不断购入新书的图书馆不同,这个图书馆是静态的,只包含它最初训练时的知识。这带来了一个挑战,因为现实世界的知识在不断发展。数据存储通过提供对更动态、最新信息的访问,解决了这一限制,并确保模型的回复基于事实且具有相关性。
考虑一个常见的场景,开发人员可能需要向模型提供少量额外数据,这些数据可能以电子表格或PDF的形式存在。
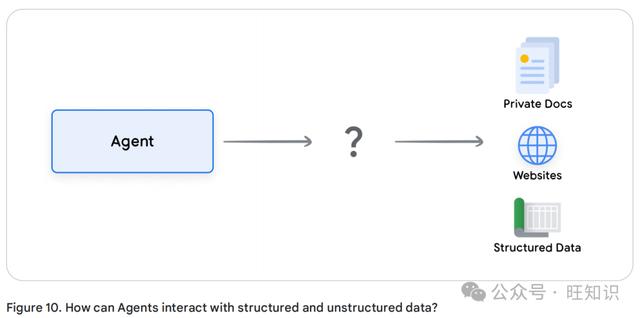
图10. 智能体如何与结构化和非结构化数据交互?
数据存储允许开发人员以原始格式向智能体提供额外数据,从而无需进行耗时的数据转换、模型重新训练或微调。数据存储将传入的文档转换为一组向量数据库嵌入,智能体可以使用这些嵌入来提取所需信息,以辅助其下一步行动或对用户的回复。
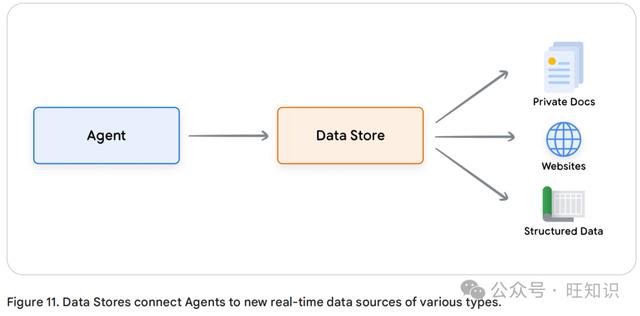
图11. 数据存储将智能体连接到各种新的实时数据源
在生成式人工智能智能体的背景下,数据存储通常被实现为开发人员希望智能体在运行时能够访问的向量数据库。虽然我们不会在此深入讨论向量数据库,但关键是要理解它们以向量嵌入的形式存储数据,向量嵌入是所提供数据的一种高维向量或数学表示。最近,数据存储在语言模型中的一个最典型应用示例是基于检索增强生成(RAG)的应用程序的实现。这些应用程序旨在通过让模型访问各种格式的数据,扩展模型知识的广度和深度,超越基础训练数据,这些数据格式包括:
- 网站内容
- 如PDF、Word文档、CSV、电子表格等格式的结构化数据
- 如HTML、PDF、TXT等格式的非结构化数据
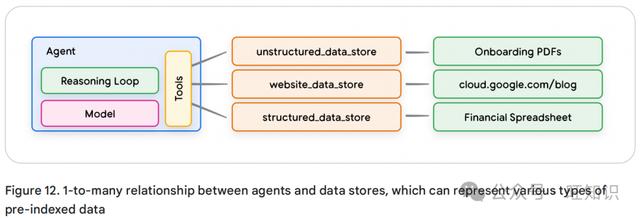
图12. 智能体和数据存储之间的一对多关系,数据存储可代表各种预先索引的数据类型
每个用户请求和智能体回复循环的底层过程通常如图13所示。
- 用户查询被发送到一个嵌入模型以生成查询的嵌入。
- 然后使用诸如SCaNN之类的匹配算法,将查询嵌入与向量数据库的内容进行匹配。
- 从向量数据库中以文本格式检索匹配的内容,并将其发送回智能体。
- 智能体接收用户查询和检索到的内容,然后制定回复或行动。
- 最终回复被发送给用户。
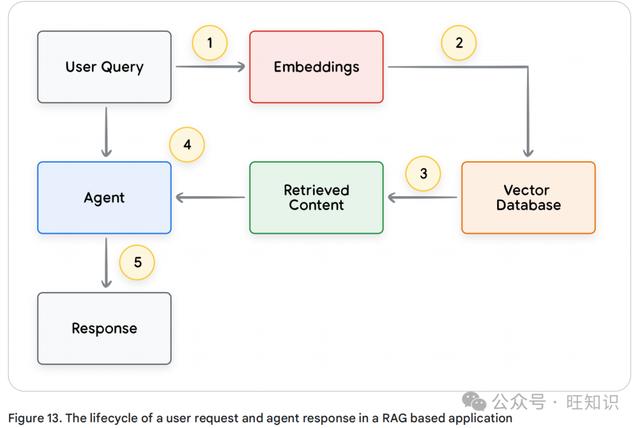
图13. 基于RAG的应用程序中用户请求和智能体回复的生命周期
最终结果是一个应用程序,它允许智能体通过向量搜索将用户的查询与已知的数据存储进行匹配,检索原始内容,并将其提供给编排层和模型进行进一步处理。下一步行动可能是向用户提供最终答案,或者执行额外的向量搜索以进一步优化结果。
图14展示了与实现了带有ReAct推理/规划的RAG的智能体的示例交互。
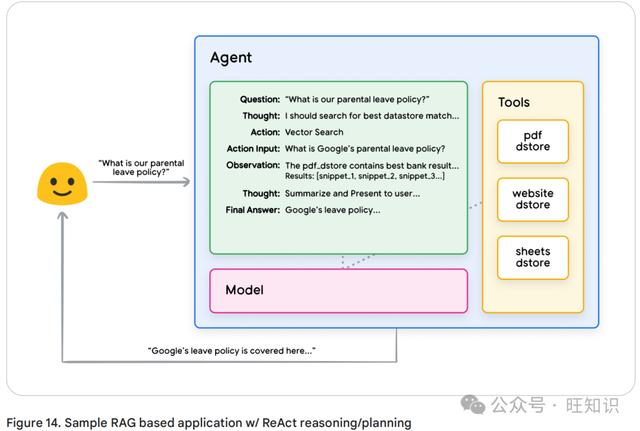
图14. 基于RAG的应用程序示例,带有ReAct推理/规划
总之,扩展、函数和数据存储构成了智能体在运行时可以使用的几种不同类型的工具。每种工具都有其特定用途,智能体开发者可以根据需要单独或组合使用它们。
有效使用模型的一个关键方面是其在生成输出时选择正确工具的能力,特别是在生产环境中大规模使用工具时。虽然通用训练有助于模型培养这种技能,但现实世界的场景通常需要超出训练数据的知识。可以将此想象为基本烹饪技能与精通特定菜系之间的区别。两者都需要基础烹饪知识,但后者需要针对性学习才能获得更精细的结果。
为了帮助模型获取这种特定知识,有几种方法:
- 上下文学习:这种方法在推理时为通用模型提供提示、工具和少量示例,使其能够“即时”学习如何以及何时针对特定任务使用这些工具。ReAct框架就是自然语言中这种方法的一个例子。
- 基于检索的上下文学习:这种技术通过从外部存储器中检索最相关的信息、工具和相关示例,动态地将它们填充到模型提示中。Vertex AI扩展中的“示例存储”或前面提到的基于RAG架构的数据存储就是这种方法的例子。
- 基于微调的学习:这种方法涉及在推理之前使用更大的特定示例数据集对模型进行训练。这有助于模型在收到任何用户查询之前,理解何时以及如何应用某些工具。
为了对每种针对性学习方法提供更多见解,让我们再次回到我们的烹饪类比。
- 想象一位厨师收到了顾客提供的特定食谱(提示)、一些关键食材(相关工具)和一些示例菜肴(少量示例)。基于这些有限的信息和厨师的一般烹饪知识,他们需要“即时”想出如何准备与食谱和顾客偏好最相符的菜肴。这就是上下文学习。
- 现在想象我们的厨师在一个库存充足的厨房(外部数据存储)中,里面有各种食材和食谱(示例和工具)。厨师现在能够从厨房中动态选择食材和食谱,更好地符合顾客的食谱和偏好。这使厨师能够利用现有知识和新知识,制作出更精致的菜肴。这就是基于检索的上下文学习。
- 最后,想象我们送厨师回学校学习一种新的菜系或一系列菜系(在更大的特定示例数据集上进行预训练)。这使厨师能够以更深入的理解来处理未来遇到的顾客食谱。如果我们希望厨师在特定菜系(知识领域)中表现出色,这种方法非常合适。这就是基于微调的学习。
这些方法在速度、成本和延迟方面各有优缺点。然而,通过在智能体框架中结合使用这些技术,我们可以利用它们的各种优势并尽量减少其劣势,从而获得更强大和适应性更强的解决方案。
为了提供一个智能体实际运行的真实可执行示例,我们将使用LangChain和LangGraph库构建一个快速原型。这些流行的开源库允许用户通过“链接”逻辑、推理和工具调用序列来构建自定义智能体,以回答用户的查询。我们将使用我们的gemini-1.5-flash-001模型和一些简单工具来回答用户的多阶段查询,如代码片段8所示。
我们使用的工具是SerpAPI(用于谷歌搜索)和谷歌地图API。在执行代码片段8中的程序后,你可以在代码片段9中看到示例输出。
import osfrom langgraph.prebuilt import create_react_agentfrom langchain_core.tools import toolfrom langchain_community.utilities import SerpAPIWrapperfrom langchain_community.tools import GooglePlacesToolos.environ["SERPAPI_API_KEY"] = "XXXXX"os.environ["GPLACES_API_KEY"] = "XXXXX"@tooldef search(query: str): """使用SerpAPI进行谷歌搜索。""" search = SerpAPIWrapper() return search.run(query)@tooldef places(query: str): """使用谷歌地图API进行谷歌地图查询。""" places = GooglePlacesTool() return places.run(query)model = ChatVertexAI(model="gemini-1.5-flash-001")tools = [search, places]query = "Who did the Texas Longhorns play in football last week? What is the address of the other team's stadium?"agent = create_react_agent(model, tools)input = {"messages": [("human", query)]}for s in agent.stream(input, stream_mode="values"): message = s["messages"][-1] if isinstance(message, tuple): print(message) else: message.pretty_print()代码片段8. 基于LangChain和LangGraph的带有工具的智能体示例
Unset=============================== Human Message ================================Who did the Texas Longhorns play in football last week? What is the address of the other team's stadium?================================= Ai Message =================================Tool Calls: searchArgs:query: Texas Longhorns football schedule================================ Tool Message ================================Name: search{...Results: "NCAA Division I Football, Georgia, Date..."}================================= Ai Message =================================The Texas Longhorns played the Georgia Bulldogs last week.Tool Calls: placesArgs:query: Georgia Bulldogs stadium================================ Tool Message ================================Name: places{...Sanford Stadium Address: 100 Sanford...}================================= Ai Message =================================The address of the Georgia Bulldogs stadium is 100 Sanford Dr, Athens, GA 30602, USA.代码片段9. 代码片段8中程序的输出
虽然这是一个相当简单的智能体示例,但它展示了模型、编排和工具这三个基础组件协同工作以实现特定目标的过程。在最后一部分,我们将探讨这些组件如何在谷歌规模的托管产品(如Vertex AI智能体和生成式手册)中协同工作。
虽然本白皮书探讨了智能体的核心组件,但构建生产级应用程序需要将它们与其他工具集成,如用户界面、评估框架和持续改进机制。谷歌的Vertex AI平台通过提供一个完全托管的环境简化了这一过程,该环境涵盖了前面提到的所有基本要素。开发人员可以使用自然语言界面快速定义智能体的关键要素——目标、任务指令、工具、用于任务委派的子智能体以及示例——以轻松构建所需的系统行为。此外,该平台还附带了一套开发工具,可用于测试、评估、衡量智能体性能、调试以及提高所开发智能体的整体质量。这使开发人员能够专注于构建和优化他们的智能体,而基础设施、部署和维护的复杂性则由平台本身管理。
在图15中,我们展示了一个在Vertex AI平台上构建的智能体的示例架构,该架构使用了各种功能,如Vertex智能体构建器、Vertex扩展、Vertex函数调用和Vertex示例存储等。该架构包含了一个生产就绪应用程序所需的许多不同组件。
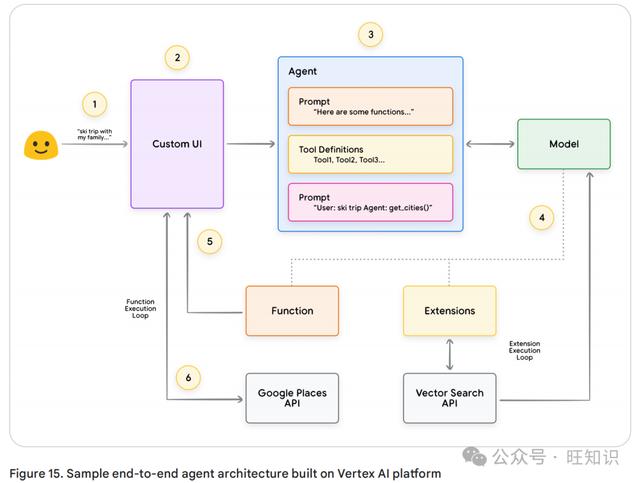
图15. 在Vertex AI平台上构建的端到端智能体示例架构
你可以从我们的官方文档中尝试这个预构建智能体架构的示例。
在本白皮书中,我们讨论了生成式人工智能智能体的基础构建块、它们的组成,以及以认知架构形式实施它们的有效方法。本白皮书的一些关键要点包括:
- 智能体通过利用工具访问实时信息、建议现实世界行动,以及自主规划和执行复杂任务,扩展了语言模型的能力。智能体可以利用一个或多个语言模型来决定何时以及如何在不同状态之间转换,并使用外部工具来完成许多复杂任务,这些任务对于模型自身而言可能很难或无法完成。
- 智能体运作的核心是编排层,这是一种认知架构,它组织推理、规划、决策并指导智能体的行动。各种推理技术,如ReAct、思维链和思维树,为编排层提供了一个框架,使其能够接收信息、进行内部推理,并生成明智的决策或回复。
- 工具,如扩展、函数和数据存储,是智能体通往外部世界的钥匙,使它们能够与外部系统交互并获取超出其训练数据的知识。扩展在智能体和外部API之间架起了一座桥梁,能够执行API调用并检索实时信息。函数通过分工为开发人员提供了更精细的控制,使智能体能够生成可在客户端执行的函数参数。数据存储为智能体提供了对结构化或非结构化数据的访问,从而实现数据驱动的应用程序。
智能体的未来有着令人兴奋的发展前景,我们目前所触及的只是冰山一角。随着工具变得更加复杂,推理能力得到增强,智能体将有能力解决越来越复杂的问题。此外,“智能体链式组合”的策略将继续获得发展动力。通过组合专门的智能体——每个智能体在特定领域或任务中表现出色——我们可以创建一种“智能体专家组合”的方法,能够在各个行业和问题领域中取得卓越成果。
需要记住的是,构建复杂的智能体架构需要采用迭代的方法。实验和优化是为特定业务案例和组织需求找到解决方案的关键。由于支撑其架构的基础模型具有生成性,没有两个智能体是完全相同的。然而,通过利用这些基础组件的优势,我们可以创建有影响力的应用程序,扩展语言模型的能力并实现现实世界的价值。
作者:张长旺,图源:旺知识
- 标题:Agents
- 作者:Julia Wiesinger, Patrick Marlow and Vladimir Vuskovic
- 单位:Google
- 标签:人工智能、生成式AI、智能体、语言模型、工具扩展
- 概述:本文围绕生成式AI智能体展开,介绍其概念、架构、工具类型及应用,探讨如何通过针对性学习提升性能,并给出使用LangChain及Vertex AI平台的实践示例 。
- 链接:https://media.licdn.com/dms/document/media/v2/D561FAQH8tt1cvunj0w/feedshare-document-pdf-analyzed/B56ZQq.TtsG8AY-/0/1735887787265?e=1736985600&v=beta&t=pLuArcKyUcxE9B1Her1QWfMHF_UxZL9Q-Y0JTDuSn38