一文带你看透生成式AI:概念、行业、模型、历史、原理、领袖
随着人工智能发展,生成式人工智能从最初学习预测分类数据,发展到能够创造全新内容。其重要意义在于能在多行业自动化任务、提升效率、激发创新,带来巨大经济价值,改变人们生活和工作方式 。
作者:张长旺,图源:旺知识
文章全面介绍生成式人工智能,阐述其可创造新内容的本质,列举如GPT、MidJourney等应用实例。介绍了变分自编码器、生成对抗网络、Transformer等多种模型类型,回顾其从早期概念到如今强大模型不断演进的历程。还探讨了在各行业的应用及影响,分析了与其他AI概念的区别,说明了所需技术技能、职业发展路径,提供了学习资源,并解答常见疑问 。
生成式人工智能有可能以我们无法想象的方式改变世界。它有能力创造新的想法、产品和服务,让我们的生活更轻松、更高效、更富有创造力。——比尔·盖茨
生成式人工智能的发展历程始于机器学习对数据进行预测和分类。但真正的突破始于这些机器被训练用于创造。这一关键时刻标志着从预测分析到内容生成的转变,在这一转变中,人工智能系统可以产生输出。最初,生成式人工智能模型学会生成简单的文本和模式,但很快,随着深度学习和神经网络的融合,它们开始创造原创作品。
这一演变使机器能够自行创作音乐、设计艺术品,甚至生成逼真的图像和视频。能够创造而不仅仅是分类是一项重大突破,为各个行业开辟了无限的可能性和应用。它开启了一个新时代,人工智能系统成为共同创造者,突破了此前认为可实现的边界。
生成式人工智能是人工智能的一个分支,具有创造新作品的能力。与仅仅分析和理解数据不同,生成式人工智能旨在生成全新的内容和信息。它从现有数据中学习,识别模式和结构,然后利用这些知识创造出全新的东西。
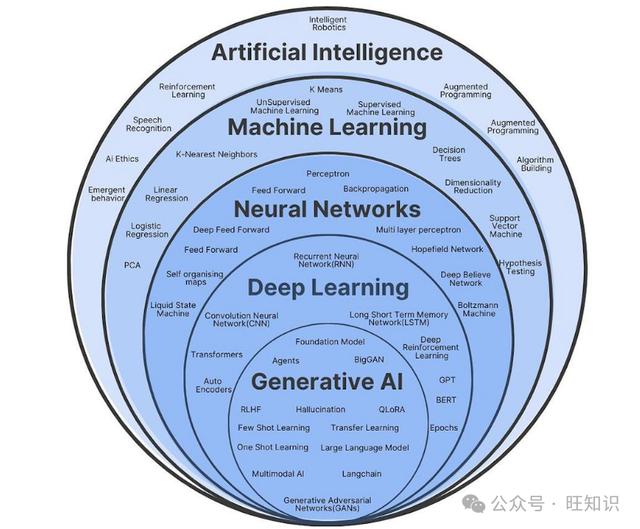
生成式人工智能的独特之处在于它能够超越解读,创造出独特的输出。无论是编写故事、创作旋律还是设计图像,生成式人工智能都不仅仅是模仿。
以下是生成式人工智能的一些关键方面:
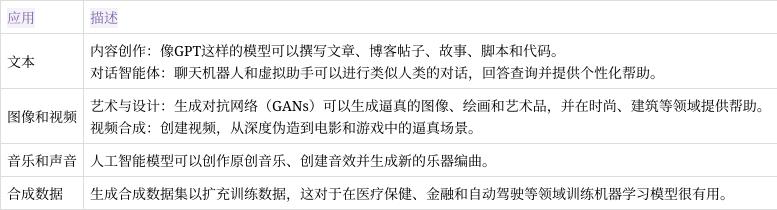
- 生成式人工智能可以创建文本、图像、音乐和视频,例如用于文本创作的GPT和用于图像生成的MidJourney。
- 生成式人工智能在大型数据集上进行训练,学习模式以产生逻辑相关的内容。
- 生成式人工智能应用于市场营销、软件开发、研发等领域,可实现内容创作和代码生成等任务的自动化。
- 先进的生成式模型可以处理多种格式,同时生成文本、图像和音频。
- 它通过实现任务自动化、加快内容创作速度并辅助各行业的决策制定,提高了生产力。
麦肯锡2023年6月的报告《生成式人工智能的经济潜力:下一个生产力前沿》指出:“在63个用例中,生成式人工智能有可能在各个行业产生2.6万亿美元至4.4万亿美元的价值。”
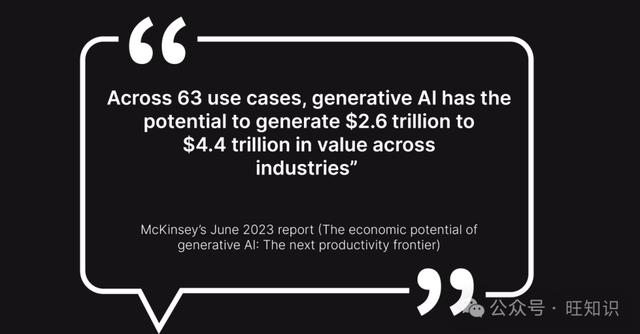
生成式人工智能能够实现任务自动化、增强客户互动并提高运营效率,使其成为多个行业的变革力量,可能重塑企业的运营方式和价值交付方式。预计生成式人工智能将对各个行业产生重大影响,不同行业的潜在价值贡献有所不同。
以下图片展示了生成式人工智能在不同行业的影响:
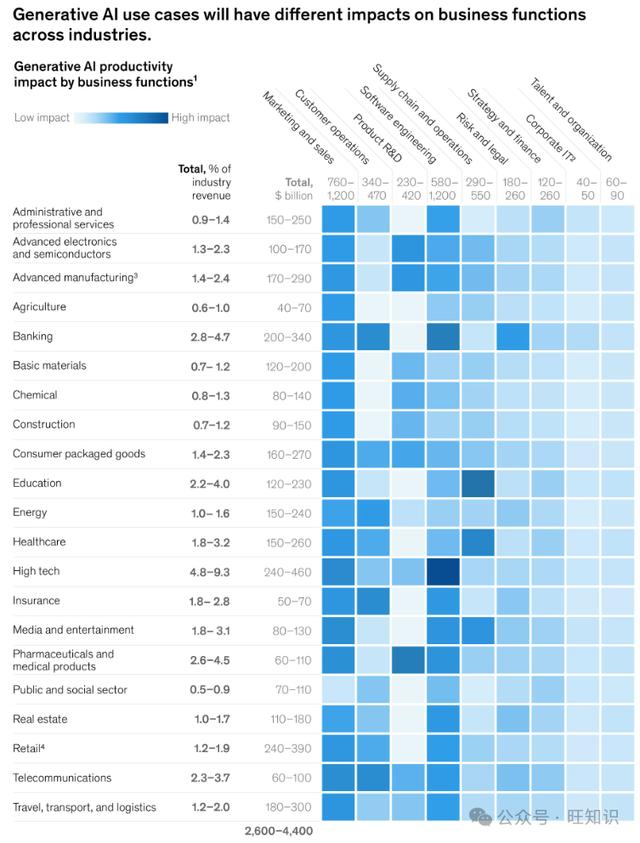
生成式人工智能用例将对不同行业的业务职能产生不同影响。
注:由于四舍五入,数字可能无法精确相加为100%。1不包括实施成本(例如培训、许可证)。²不包括软件工程。³包括航空航天、国防和汽车制造。来源:比较行业服务(CIS)、IHS Markit;牛津经济研究院;麦肯锡公司和业务职能数据库;麦肯锡制造和供应链360;麦肯锡销售导航仪;Ignite,麦肯锡数据库;麦肯锡分析
来源:麦肯锡
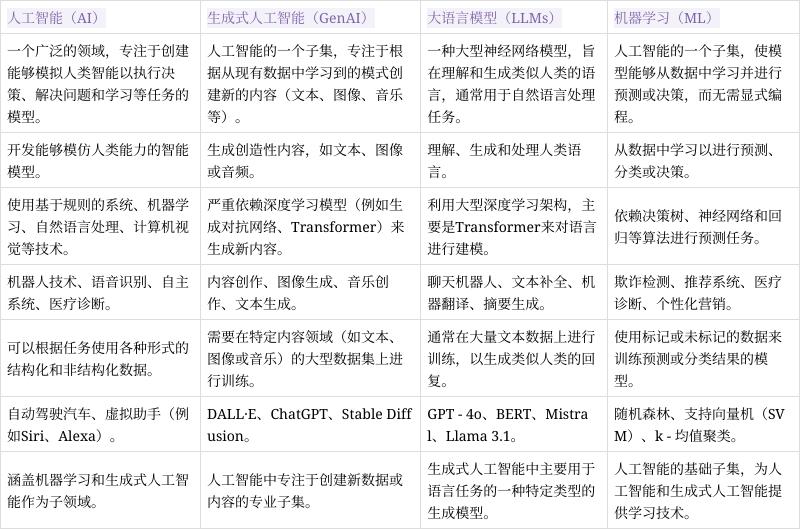
变分自编码器学习将输入数据编码到潜在空间,然后将其解码以重建原始数据。它们通常用于生成图像和其他类型的数据。
- DCVAE
- Beta - VAE
- CVAE
- VQ - VAE
- VAE - GAN
- PixelVAE
- InfoVAE
- FactorVAE
- JointVAE
- Ladder VAE
生成对抗网络由两个神经网络组成,即生成器和判别器,它们相互竞争。生成器创建新数据,而判别器评估其真实性。这个过程帮助生成对抗网络生成高度逼真的图像。
- DCGAN
- CycleGAN
- StyleGAN
- BigGAN
- Pix2Pix
- WGAN
- ProGAN
- StarGAN
- InfoGAN
- SRGAN(超分辨率生成对抗网络)
- VQGAN
Transformer在处理涉及顺序数据的任务(如语言建模)时特别有效。它们使用自注意力机制并行处理输入数据,这使得它们在生成文本和其他顺序数据方面非常高效。Transformer通常分为两类:小型语言模型(SLM)和大型语言模型(LLM),具体取决于它们的大小、能力和用例。
- 小型语言模型(SLM):小型语言模型通常比较紧凑,设计用于使用较少的参数执行特定任务,与大型模型相比,它们在句子分类、命名实体识别和问答等任务中表现出色,在这些任务中,任务的复杂性或规模不需要大量的计算资源。小型语言模型速度更快,需要的计算能力更少,并且更容易针对特定应用进行微调。例如:Phi3 Mini、BERT、T5(文本到文本转移Transformer)、RoBERTa、XLNet。
- 大型语言模型(LLM):大型语言模型规模要大得多,拥有数十亿个参数,并且能够处理更复杂的任务。这些模型用于文本生成、翻译、摘要生成,甚至推理、编码或进行长时间对话等高级任务。大型语言模型需要更多的计算能力和内存,但能提供更准确、细致且类似人类的输出,使其适用于各种应用。例如:GPT - 4o、Llama 3.1 70B、Claude 3.5、Gemini 1.5。
循环神经网络及其高级变体长短期记忆网络广泛用于顺序数据生成。这些模型按顺序处理数据,使其适用于文本生成、语言建模和语音合成。它们可以学习数据中的模式和结构,从而能够预测和生成序列中的下一个元素,无论是单词、音符还是时间序列值。
- Char - RNN
- LSTM(用于音乐生成、时间序列和文本)
- Deep Voice
- Seq2Seq
扩散模型是一类相对较新但功能强大的生成模型。它们通过逐渐向数据中添加噪声,然后学习反转这个过程,通过去除噪声来生成新数据。这个迭代过程能够创建高质量的图像、音频,甚至3D结构。扩散模型因其能够生成多样化和详细的输出而受到关注。
- DDPM
- GLIDE
- Score-Based Model
- DDIM
- Stable Diffusion
生成式人工智能的发展历程中出现了许多重要的里程碑,尤其是在近年来:
- 早期基础(20世纪50年代 - 80年代):神经网络概念的出现以及像ELIZA这样的早期聊天机器人。
- 神经网络复兴(20世纪90年代):循环神经网络和长短期记忆网络的发展,用于改进顺序数据处理。
- 深度学习突破(21世纪00年代):取得进展,使人工智能能够处理各种数据形式。
- 先进神经网络(21世纪10年代早期):自动编码器的进步以及变分自编码器的引入。
- 生成对抗网络与图像生成(2014 - 2018年):生成对抗网络的引入以及图像生成质量的提高。
- Transformer模型与GPT系列(2018 - 2022年):2017年Transformer模型的引入;OpenAI的GPT系列:GPT - 1、GPT - 2和GPT - 3;2022年11月ChatGPT发布。
- 主要人工智能模型发布与集成(2023年):OpenAI发布GPT - 4,在各种基准测试中展现出人类水平的性能,提高了推理能力并减少了幻觉现象,引入了图像输入的多模态功能;谷歌推出Bard;微软将GPT - 4集成到必应聊天中;扩展了跨语言和平台的人工智能助手(Bard、Copilot);Meta发布Llama2;OpenAI推出DALL·E 3。
- 最新进展(2023年末 - 2024年初):发布更强大的模型,如Claude 3.5 sonnet、Gemini 1.5系列、GPT - 4o;多模态人工智能和专用硬件的进一步发展;更加关注人工智能的安全性、伦理和监管问题。
对于生成式人工智能而言,以下是一些最常用的库、框架和工具。这些库和框架为研究人员和开发人员提供了开发和实现生成式人工智能模型的基本工具和构建模块,具备广泛的功能:
- 库和框架:TensorFlow、PyTorch、Keras、Transformers、Diffusers、OpenAI、Datasets、LangChain、FastAI、Chainer、Theano、OpenCV、NLTK、SpaCy、AllenNLP、Tesseract、Fairseq、PEFT、TRL、PEFT
- 生成式人工智能模型:GPT - 4o、DALLE 2、Midjourney、Gemini、Stable Diffusion、StyleGAN3、WaveNet、ControlNet、Claude、Bard、Runway Gen - 2、DeepAI、PaddleGAN、BigGAN、Taming Transformers、VQGAN + CLIP、MusicLM、Codex
- 文本到图像合成模型:Image GPT、神经辐射场(NeRF)、DeepDream
- 基于流的生成模型:Reformer
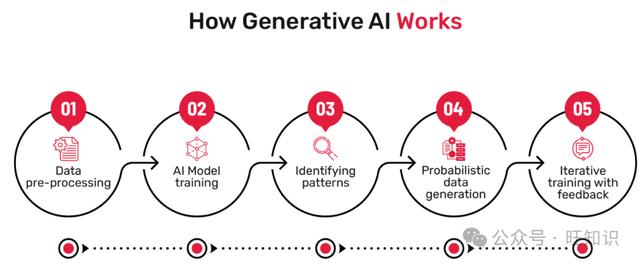
- 神经网络架构:这些模型基于复杂的神经网络,通常使用带有注意力机制的Transformer架构。
- 训练过程:它们通过处理数据、计算误差和调整参数的迭代过程进行学习。
- 标记化:对于基于文本的模型,输入被分解为标记,并转换为数字表示。
- 自注意力和上下文:Transformer模型使用自注意力机制来理解输入数据中的上下文和关系。
- 生成过程:通过基于学习到的模式和上下文预测最可能的下一个标记来生成内容。
- 微调与迁移学习:模型可以通过额外的训练适应特定任务或领域。
- 多模态能力:先进的模型可以处理多种类型的数据,如文本和图像。
- 伦理考量:开发过程中努力减轻偏差,确保输出安全、合适。
- 持续学习与改进:模型会定期用新数据更新,并在架构上进行改进。
不同背景的专业人士都可以转型进入生成式人工智能领域。通过利用他们现有的技能,并通过像生成式人工智能巅峰计划这样的结构化项目获取生成式人工智能知识,以下这些岗位的个人可以成功转型进入该领域:
- 软件开发人员:利用你的编程能力,探索人工智能特定的库和框架。投入到实际项目中,构建生成式模型,快速掌握人工智能开发的实践方面。
- 数据科学家:用生成式人工智能技术扩展你的机器学习工具包。专注于教授数据生成方法的教程和课程,让你能够运用分析技能创建合成数据。
- 机器学习工程师:通过关于生成式人工智能模型的专业培训深化你的知识。涵盖生成对抗网络、变分自编码器和语言模型的在线资源和训练营,将使你有能力训练和微调最先进的系统。
- 业务分析师:深入研究生成式人工智能的战略应用。案例研究和特定行业的人工智能实施指南将展示人工智能如何改变企业,为你在这一变革中的角色提供路线图。
- 编程熟练程度(特别是Python)
- 深度学习和神经网络架构
- 数学知识(线性代数、微积分、概率)
- 自然语言处理(NLP)技术
- 数据预处理和特征工程
- 机器学习框架(例如TensorFlow、PyTorch)
- 理解人工智能伦理原则
- 首先掌握Python,这是人工智能领域最流行的编程语言。熟悉数据结构、算法,以及用于处理数据的Pandas和NumPy等库。
- 打下坚实的概率和统计学基础。理解这些概念对于掌握人工智能模型的工作原理以及理解其预测结果至关重要。
- 学习如何预处理和清理数据。在深入研究模型之前,你需要知道如何处理原始数据,对其进行清理并为训练做好准备。这一步至关重要,因为高质量的数据能够训练出更好的模型。
- 熟悉机器学习的基础知识。理解有监督学习和无监督学习中的关键算法,并学习如何使用准确率、精确率和召回率等指标评估模型。
- 接着学习深度学习。从神经网络的基础知识、激活函数和反向传播开始。使用TensorFlow或PyTorch等框架实现简单模型,并逐步提升你的技能。
- 接下来,深入学习自然语言处理(NLP)。了解语言模型的工作原理,并使用Transformer等模型进行文本生成实验。自然语言处理是基于文本的生成式人工智能的核心。
- 探索计算机视觉。一旦你对文本生成得心应手,将注意力转移到与图像相关的任务上。学习卷积神经网络(CNNs)的工作原理,并将其应用于图像生成或分类等任务。
- 专注于模型评估和优化。了解如何衡量模型性能并微调超参数以获得更好的结果非常重要。
- 学习利用GPU编程来加速模型训练和推理。使用GPU对于高效训练大型模型至关重要。
- 不要忽视人工智能中的伦理考量。在提升技能的过程中,确保你意识到模型中可能存在的偏差,并了解如何创建公平、负责任的人工智能系统。
在生成式人工智能领域,有各种适合不同技能集和兴趣的工作岗位。以下是一些你可能考虑从事的关键工作岗位概述:
根据Statista的数据,全球生成式人工智能市场预计到2024年将达到360.6亿美元,2024年至2030年的年增长率为46.47%,到2030年可能达到3561亿美元。预计美国将处于领先地位,2024年市场规模为116.6亿美元。这些数据反映了生成式人工智能在全球各行业日益增长的影响力和机遇。
在薪资方面,根据6figr.com的数据,精通生成式人工智能的专业人员平均年薪为458万印度卢比。经过验证的个人资料显示薪资范围从281万印度卢比到1648万印度卢比不等,这凸显了该领域丰厚的机会。
- 文本聊天机器人
- YouTube视频摘要生成器
- 代码生成器
- 图像生成器
- 视频生成器
- 音乐生成器
- QR码生成器
- 文章摘要生成器
- 人工智能驱动的游戏
- 深度伪造或面部交换应用程序
- 《均衡之笔》,安吉拉·E·劳里亚著
- 《生成式人工智能的涟漪:生成式人工智能如何影响、启发和改变我们的生活》,雅各布·爱默生著
- 《商业领袖的人工智能基础》,I·阿尔梅达著
- 《AWS上的生成式人工智能》,克里斯·弗雷格利、安特耶·巴特、谢尔比·艾根布罗德著
- 《生成式深度学习:教机器绘画、写作、作曲和游戏》,大卫·福斯特著
Sam Altman是OpenAI首席执行官,对 OpenAI 的发展产生了深远影响。在技术创新方面,他领导团队在大型语言模型和自然语言处理领域取得了重大突破。2023 年,ChatGPT 的发布点燃了全球对 AI 的热情,短短几周内迅速走红,成为现象级产品,展示了强大的语言生成能力和广泛的应用潜力,随后的 GPT-4 更是进一步拓展了 AI 的应用场景。他还推动了代码生成工具 Codex 的发展,能够将自然语言转换为代码,极大降低了编程的门槛。在组织管理上,他建立了一种使命驱动的文化,确立了开发造福全人类的通用人工智能的宏大愿景,吸引了一批高素质人才,激励员工为实现目标不懈努力。2023 年他曾被突然解雇,但因受到员工的广泛支持,董事会最终妥协,在不到 24 小时的时间内让他重新回到 OpenAI,这一事件也凸显了他在公司内部的重要影响力和与员工之间的深厚关系。
在商业合作拓展方面,他带领 OpenAI 与微软建立了紧密合作关系,为公司的技术研发和业务拓展提供了强大助力,同时也与康泰纳仕、《时代》杂志、新闻集团等媒体建立合作关系,提升了产品的内容质量和用户体验。
在他的领导下,OpenAI 成为人工智能领域的领军企业,推动了整个行业对人工智能的研究和应用的加速发展。
谷歌DeepMind联合创始人兼首席执行官 - 致力于通用人工智能(AGI)研究。试图理解现实的基本本质。同时通过IsomorphicLabs革新药物研发 。
Demis Hassabis在推特上拥有超过12.8万粉丝,是领先的人工智能研究公司DeepMind的联合创始人兼首席执行官。DeepMind在人工智能领域取得了突破性进展,其中包括开发出在古老的围棋比赛中击败人类世界冠军的AlphaGo程序。虽然DeepMind没有举办特定的年度活动,但Demis经常参加世界各地的会议和活动,分享DeepMind的研究成果和人工智能的发展情况。
Ilya Sutskever 是一位极具影响力的以色列裔加拿大计算机科学家,也是OpenAI联合创始人兼首席科学家。
在学术方面,2012年,他毕业于多伦多大学,获得计算机科学博士学位,期间与杰弗里·辛顿及亚历克斯·克里热夫斯基建立了神经网络AlexNet,并在具有里程碑意义的图像识别竞赛中获胜。在谷歌工作期间,他展示了深度学习在数据序列上的规律识别能力,并与人合作创建了Seq2Seq学习算法,该算法在自然语言处理领域有着深远影响,为机器翻译、对话系统等技术的发展提供了重要支持,是自然语言处理领域的里程碑。
2015年,他加入OpenAI并成为联合创始人之一,致力于开发通用人工智能领域。在他的领导下,OpenAI推出了多个重要的人工智能模型,如早期的GPT系列、DALL-E系列以及代码生成模型Codex等,特别是2022年推出的ChatGPT,在自然语言处理和内容生成方面取得了革命性的进展,将人工智能带入了全新的纪元。
2022年,Sutskever当选为英国皇家学会院士,2023年被评选为《自然》年度十大人物。然而,在2024年5月14日,他宣布从OpenAI离职,之后与他人共同创立了名为“安全超级智能”(Safe Super Intelligence Inc.)的合资企业,目标是将安全性和性能并重,确保人工智能始终与人类价值观保持一致,继续在人工智能领域积极探索,为实现安全、可靠的人工智能发展而努力。
Ilya Sutskever在人工智能领域的贡献卓越,是深度学习和机器学习领域的杰出代表,对推动人工智能的发展和变革发挥了至关重要的作用。
吴恩达(Andrew Ng),1976年出生于英国伦敦,是一位杰出的华裔美国计算机科学家、教育家和企业家。
在教育背景方面,他毕业于新加坡莱佛士书院,1997年获得卡内基梅隆大学计算机科学、统计学和经济学三个专业的学士学位,之后在麻省理工学院取得硕士学位,并于2002年在加州大学伯克利分校获得计算机科学博士学位。
吴恩达在学术研究领域成绩斐然,是斯坦福大学计算机科学系和电子工程系副教授、人工智能实验室主任,在机器学习、深度学习、机器人技术等领域发表了100多篇论文。他主导的斯坦福自动控制直升机项目,开发出世界上最先进的自动控制直升机之一。2011年,他在谷歌创立了“谷歌大脑”项目,推动了深度学习的大规模应用和发展。2014年,吴恩达加入百度担任首席科学家,负责百度大脑计划,使百度在语音识别、自然语言处理和计算机视觉等方面取得显著进展。
他还是在线教育领域的先驱者之一,与达芙妮·科勒联合创立了Coursera,其机器学习课程成为平台上最受欢迎的课程之一,吸引了数百万学习者。2017年,他创立了DeepLearning.AI和Landing AI,继续推动人工智能的教育和应用。
吴恩达获得了众多荣誉,包括2007年斯隆奖、2013年入选《时代》杂志“全球最具影响力100人”和《财富》杂志“40位40岁以下商界精英”等。2023年,再次入选《时代》评选的全球百大AI人物名单。他的工作和成就对人工智能领域的发展产生了深远影响,是该领域的权威人物之一。
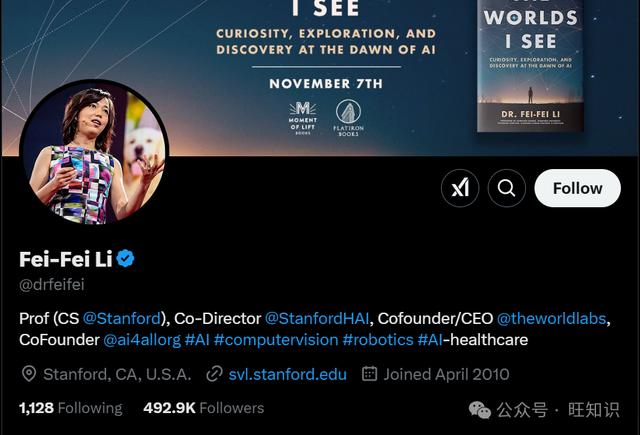
Fei-Fei Li是斯坦福大学以人为本的人工智能研究所和视觉与学习实验室的联合主任,同时也是该校计算机科学系的首位红杉教授。她还曾担任谷歌副总裁以及谷歌云人工智能/机器学习首席科学家。在多年的职业生涯中,Fei-Fei Li涉足众多领域,从认知启发的人工智能、深度学习,到机器学习、计算机视觉以及医疗保健领域的人工智能应用 。在研究方面,她在相关领域的会议和重要期刊上发表了200多篇科学论文。Fei-Fei Li开发的ImageNet是人工智能和深度学习最新前沿领域的一个革命性项目。她斩获众多奖项,包括《ELLE》杂志2017年评选的奖项、《外交政策》杂志2015年评选的全球思想家,以及2016年卡内基基金会颁发的享有盛誉的 “伟大移民:美国的骄傲 ”奖。作为一名行业领导者,她还是美国人工智能和STEM领域多元化的旗手。
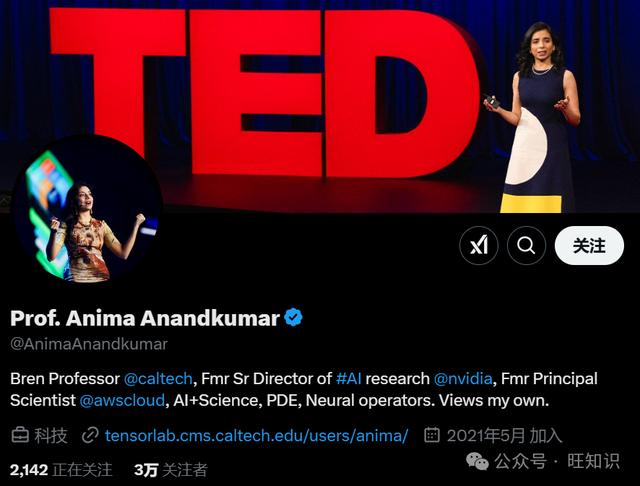
Anima Anandkumar出生于印度,是加州理工学院的布伦教授,同时担任英伟达人工智能研究高级总监,此前她还曾是亚马逊云科技的首席科学家。Anima Anandkumar拥有印度马德拉斯理工学院和康奈尔大学的学位,是美国计算机协会(ACM)、电气和电子工程师协会(IEEE)以及阿尔弗雷德·P·斯隆基金会的会士。她是一位拥有超过15万粉丝的影响者,经常分享有关大规模机器学习、非凸优化和高维统计的最新动态。她在开发新型人工智能方面的工作加速了人工智能在科学领域的应用,包括科学模拟、天气预报和药物设计。她基于高性能计算的新冠疫情研究在神经信息处理系统大会(NeurIPS)上获得认可,并荣获美国计算机协会戈登·贝尔特别奖。
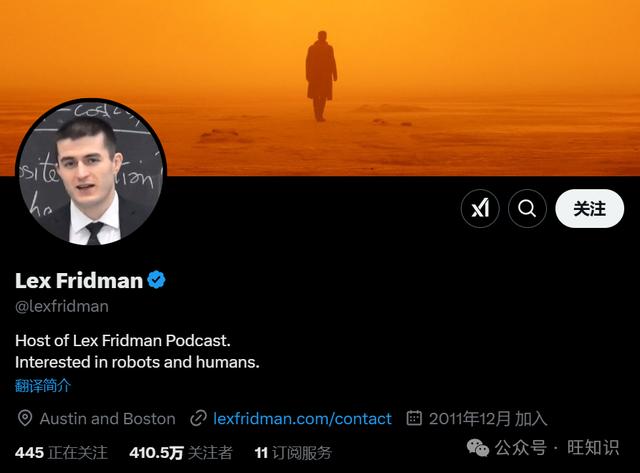
Lex Fridman是一位生成式AI影响者,他是麻省理工学院的DeepMind研究科学家,专注于多个引人入胜的研究领域。他的主要研究方向包括人机交互和机器学习,同时深入探索人类和机器人如何在各种场景中有效协作与沟通。Lex Fridman的贡献还体现在推动自动驾驶汽车以及更广泛的以人为本的人工智能系统的发展上。除了研究工作,他还主持著名的《Lex Fridman播客》。在节目中,他与包括学者、企业家、运动员和创意人士在内的各界嘉宾进行富有活力的对话。埃隆·马斯克、马克·扎克伯格和乔·罗根等知名人士都曾做客他的播客,这凸显了Lex Fridman与各领域专家探讨广泛话题的能力。Lex Fridman拥有博士学位,并且在机器人技术、人工智能和自动驾驶汽车领域有着深入的参与。他的学术背景为其研究奠定了坚实的基础,他利用大规模的真实世界数据,开创了基于学习的方法,用于复杂系统中的感知、控制和规划 。
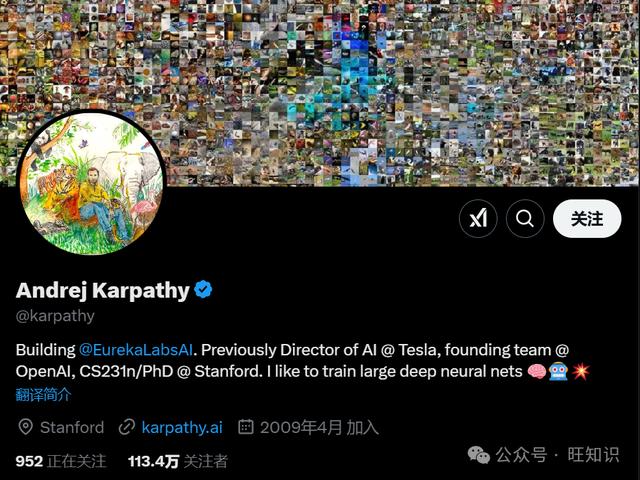
Andrej Karpathy是一位拥有斯坦福大学博士学位的斯洛伐克裔加拿大人,他正在OpenAI打造一种类似贾维斯(JARVIS)的智能系统。他曾是特斯拉人工智能和自动驾驶视觉总监。Andrej Karpathy对深度神经网络充满热情。他从多伦多起步,主修计算机科学和物理学双学位,之后前往哥伦比亚大学深造。Andrej Karpathy曾与米希尔·范德潘恩合作,为物理模拟角色开发学习控制器。在斯坦福大学视觉实验室攻读博士学位期间,他与Fei-Fei Li共事,致力于卷积神经网络和循环神经网络架构及其在自然语言处理和计算机视觉中的应用研究。此外,他设计了课程CS 231n:用于视觉识别的卷积神经网络,并担任该课程的首位主讲教师。同时,他还是一位热情的博主、深度学习库开发者以及充满激情的数据科学专家。
在探索人工智能发展历程时,Yann LeCun值得首先被提及。他曾就职于Facebook,如今担任Meta AI的首席人工智能科学家,同时还被纽约大学聘为银牌教授。他与柯朗数学科学研究所和纽约大学数据科学中心关系密切。毫不奇怪,Yann LeCun在机器学习和人工智能领域堪称领军人物。他最重大的成就之一是开发出著名的卷积网络,该网络能够解决从语音、视频到图像等领域的识别问题。更有趣的是,他与约书亚·本吉奥共同指导CIFAR项目 “神经计算与自适应感知”。Yann LeCun、约书亚·本吉奥和杰弗里·辛顿因在创新深度学习领域的杰出成就,荣获2018年ACM图灵奖。他的研究领域广泛,涵盖计算机视觉、自然语言处理、机器人技术和计算神经科学等,这些都是他的专长所在。
Greg Brockman是一位美国软件开发者、投资者和企业家,他在信息技术行业具有重大影响力。2015年,他与其他人共同发起创立OpenAI,并担任总裁一职,致力于推动人工智能发展,以造福人类。在加入OpenAI之前,Greg Brockman是Stripe公司的首席技术官,为公司发展做出了重要贡献。当时Stripe仅有五名员工,在经历大幅扩张后,员工人数最终增至205人。Greg Brockman在人工智能和机器学习领域造诣深厚,尽管并非独一无二,但他无疑是技术创新领域举足轻重的人物之一。他被称为 “十倍工程师”,因为他是该领域首位展现出上述特质的人。他是卓越职业道德和编程天赋的成功典范。
Kirk Borne博士是数据科学、机器学习和人工智能领域的杰出人物,他担任DataPrime公司的首席科学官,同时也是Data Leadership Group LLC的创始人兼所有者。Kirk Borne拥有加州理工学院的天体物理学博士学位,具备扎实的教育背景。他的职业生涯丰富多样,曾在乔治梅森大学担任天体物理学和计算科学教授。Kirk Borne以其在跨学科数据科学、大数据和大型数据库领域的开创性工作而闻名,他是备受追捧的演讲人、内容创作者,同时也是众多初创企业的顾问。他在数据挖掘、知识发现和科学数据挖掘等领域做出了卓越贡献,巩固了他在该领域的权威地位。
作为Perplexity的首席执行官兼联合创始人,Aravind Srinivas这位生成式AI影响者,率先开发出一款创新的人工智能驱动的问答引擎,重塑了搜索领域的格局。Perplexity的技术路径是从自身平台提取数据,并利用大型语言模型生成带有引用的自然语言回复,以确保准确性。自2022年创立以来,Perplexity已获得广泛关注和大量投资,从杰夫·贝索斯和苏珊·沃西基等知名投资者那里筹集了超过1亿美元资金。在准确性至关重要的领域,该公司对循证信息的坚持使其脱颖而出。
Jerry Liu是LlamaIndex的首席执行官兼联合创始人。他凭借在机器学习、研究和创业领域的丰富经验,开发出一款开源工具,该工具简化了大型语言模型应用的数据管理和查询接口。Jerry Liu曾在Robust Intelligence和优步工作,积累了机器学习监测和自动驾驶人工智能方面的专业知识,并为这些领域做出了重要贡献。LlamaIndex代表了在促进大型语言模型的访问和应用方面的关键进展,因此Jerry Liu在将人工智能技术整合到各个领域的过程中发挥着至关重要的作用。
这位生成式AI影响者在领英上拥有774211名粉丝,她是亚马逊美国初创企业和风险投资领域的人工智能业务发展主管,推动着领先人工智能公司的发展。2019年,她被《福布斯》和人工智能峰会评为 “年度人工智能创新者”,在行业内备受赞誉。她是美国科学促进会(AAAS)以及拥有10000名成员的 “产品领域女性进步组织 ”的大使。Allie在三项全国创新竞赛中获胜,展现出她卓越的才华和专业能力。
Julien Chaumond是Hugging Face的联合创始人,他通过为自然语言处理从业者提供专门的工具和资源,在推进自然语言处理和人工智能方面发挥了至关重要的作用。Hugging Face提供的产品,包括预训练模型和相关库,已成为自然语言处理社区不可或缺的资源。Julien Chaumond参与Prodcast等项目,充分展示了他在科技行业的研究、工程和创业等多方面的贡献。他的努力推动了自然语言处理领域的边界,并为人工智能创新营造了一个协作的生态系统。
问题1:生成式人工智能有哪些局限性?回答:生成式人工智能可能产生有偏见或不准确的输出,缺乏真正的理解,并且计算成本高昂。它在复杂推理方面可能存在困难,并且有可能被滥用,用于创建误导性内容。
问题2:生成式人工智能有哪些可能性?回答:生成式人工智能可以创建文本、图像和音乐等内容;协助药物研发;设计新材料;增强创意过程;实现代码生成自动化;并在各个行业实现用户体验个性化。
问题3:生成式人工智能可以解决哪些问题?回答:生成式人工智能可以解决内容创作、语言翻译、数据增强、预测性维护、个性化医疗、虚拟助手,以及建筑和工程等领域的自动化设计等方面的挑战。
问题4:生成式人工智能中常用哪种技术?回答:生成对抗网络和Transformer模型是生成式人工智能中常用的技术。这些技术能够在各个领域生成多样化且逼真的输出。
问题5:生成式人工智能是如何进行训练的?回答:生成式人工智能使用无监督学习、强化学习和对抗训练等技术,在大型数据集上进行训练。它从数据中学习模式和结构,以生成新的、类似的内容。
问题6:生成式人工智能是有监督的还是无监督的?回答:生成式人工智能既可以是有监督的,也可以是无监督的,这取决于具体的模型和任务。许多生成式模型使用无监督学习,但有些模型为了特定应用会融入有监督的元素。
问题7:生成式人工智能如何生成图像?回答:生成式人工智能通过从大量现有图像数据集中学习模式来生成图像。然后,它使用生成对抗网络或扩散模型等技术,生成与这些学习到的模式相匹配的新图像。
问题8:我们如何对生成式人工智能进行控制?回答:对生成式人工智能的控制涉及制定伦理准则、进行严格测试、人为监督、开发过程透明化,以及在模型中实施诸如内容过滤和偏差检测等安全措施。
问题9:生成式人工智能会取代人类吗?答:生成式人工智能不太可能完全取代人类。虽然它在自动化任务和生成内容方面非常有效,但它缺乏人类特有的批判性思维、同理心、创造力和理解复杂社会情境的能力。在大多数情况下,生成式人工智能将与人类协同工作,增强人类的能力,提高效率,并帮助人们专注于更复杂、更具创造性和战略性的任务。例如,在内容创作领域,生成式人工智能可以帮助撰写初稿或提供创意灵感,而人类编辑则负责添加深度、背景和确保内容符合受众的需求和价值观。在医疗保健领域,人工智能可以帮助分析数据并提供诊断建议,但最终的医疗决策仍由医生基于他们的专业知识和对患者的了解来做出。
问题10:生成式人工智能的危害是什么?答:生成式人工智能存在多种潜在危害。首先,它可能生成有害或误导性的内容,例如深度伪造视频,这类内容可能被恶意用于传播虚假信息、操纵公众舆论或进行诈骗。其次,由于训练数据中的偏差,生成式人工智能模型可能产生有偏差的输出,进而延续和放大社会中的不平等现象。另外,大规模采用生成式人工智能可能导致某些工作岗位的流失,尤其是那些涉及常规、重复性任务的岗位,这会引发经济和社会方面的挑战。最后,人们对生成式人工智能系统的过度依赖可能削弱人类的某些技能,比如批判性思维和解决问题的能力。
作者:张长旺,图源:旺知识
- 标题:Generative AI
- 作者:analyticsvidhya
- 标签:生成式人工智能、机器学习、深度学习、人工智能应用、人工智能模型
- 概述:文章围绕生成式人工智能展开,介绍了其概念、模型类型、应用、发展历程、相关技术技能、职业发展等多方面内容,并解答了常见问题 。
- 链接:https://www.analyticsvidhya.com/blog/category/generative-ai/?ref=category