详细解读:AI测试时计算为系统1与系统2思维带来的深度变革
在人工智能领域,深度学习模型在处理复杂任务时表现不佳。测试时计算应运而生,它能帮助模型更好地应对这些问题。本文对其进行了全面总结,有助于研究人员深入了解相关技术,推动人工智能向更智能的方向发展,让模型在复杂推理等方面有更好的表现。
我们详细翻译解读最新论文,文末有相关信息。
作者:张长旺,图源:旺知识
深度学习虽推动 AI 发展,但现有模型在复杂任务上有缺陷。测试时计算可提升模型性能,本文追溯其概念至系统 1 模型,介绍了模型更新、输入修改等测试时适应方法,及反馈建模、重复采样等系统 2 模型的测试时推理策略,还指出可泛化系统 2 模型、多模态推理等未来方向,为研究提供参考。
o1 模型在复杂推理中展现出的卓越性能表明,测试时计算扩展能够进一步释放模型潜力,实现强大的系统 2 思维。然而,目前仍缺乏对测试时计算扩展的全面综述。我们将测试时计算的概念追溯到系统 1 模型。在系统 1 模型中,测试时计算通过参数更新、输入修改、表示编辑和输出校准来应对分布转移,提高鲁棒性和泛化能力。在系统 2 模型中,它通过重复采样、自我纠正和树搜索来增强模型解决复杂问题的推理能力。我们按照从系统 1 到系统 2 思维的趋势组织本综述,强调测试时计算在从系统 1 模型到弱系统 2 模型,再到强系统 2 模型转变过程中的关键作用,并指出了一些未来可能的研究方向。
- 研究背景: 深度学习在 AI 发展中起重要作用,但模型存在对复杂任务处理能力不足、依赖系统 1 思维、训练资源受限等问题。测试时计算概念在大型语言模型兴起前已出现,用于系统 1 模型解决分布转移等问题,随着技术发展,在系统 2 模型中也发挥重要作用。
- 技术创新: 在系统 1 模型中提出多种测试时适应方法,如利用不同学习信号更新模型、基于检索和生成改进输入等;在系统 2 模型中创新地引入反馈建模和多种搜索策略,如基于分数和语言的反馈、重复采样、自我纠正和树搜索等,提升模型推理能力。
- 实现设计: 系统 1 模型通过设计无监督或自监督学习信号进行模型更新,选择合适参数和算法;利用检索模型和语言模型自身能力进行输入修改;基于梯度或对比提示编辑表示;借助外部信息校准输出。系统 2 模型通过训练验证器或利用大型语言模型自身指令遵循能力实现反馈建模;采用不同采样、迭代修正和搜索算法实现搜索策略。
- 实验结果: 文中提及一些方法在特定任务上的效果,如自一致性思维链在数学推理中提高准确率,kNN - MT 在机器翻译任务中表现出更好的迁移性和泛化性等,但未进行全面系统的实验结果总结。
在过去几十年中,具有缩放效应的深度学习一直是人工智能革命的驱动引擎。特别是在文本模态方面,以 GPT 系列(Radford 等人,2018,2019;Brown 等人,2020;Ouyang 等人,2022;OpenAI,2023)为代表的大型语言模型(LLM)表明,更大的模型和更多的训练数据会在下游任务中带来更好的性能。然而,一方面,由于数据和计算资源的稀缺,训练阶段的进一步扩展变得困难(Villalobos 等人,2024);另一方面,现有模型在鲁棒性和处理复杂任务方面的表现仍远低于预期。这些缺陷归因于模型对快速、直觉的系统 1 思维的依赖,而非缓慢、深入的系统 2 思维(Weston 和 Sukhbaatar,2023)。最近,配备系统 2 思维的 o1 模型因其在复杂推理任务中的出色表现而受到关注,它展示了测试时计算扩展效应:推理过程中的计算量越大,模型性能越好。
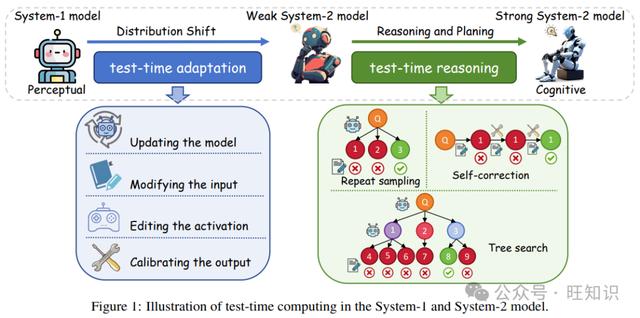
测试时计算的概念在大型语言模型兴起之前就已出现,并最初应用于系统 1 模型(如图 1 所示)。这些系统 1 模型只能执行有限的感知任务,依靠训练期间学到的模式进行预测。因此,它们受到训练和测试数据同分布假设的限制,对分布转移缺乏鲁棒性和泛化能力(Zhuang 等人,2020)。许多工作(Wang 等人,2021;Ye 等人,2023)试图通过测试时计算(也称为测试时适应(TTA))来提高模型的鲁棒性。在小模型时代,测试时适应的主流方法是在测试时更新模型参数,使模型的表示逐渐适应测试分布。对于大型语言模型,由于更新参数成本高昂,测试时适应利用外部信息来引导模型行为,包括修改输入、编辑表示和校准输出。通过引入测试时适应,系统 1 模型减缓了其思维过程,并逐渐演变为弱系统 2 模型。
目前,具有思维链(CoT)提示的先进大型语言模型使语言模型初步具备了系统 2 思维,展示了类似人类的分解问题和逐步推理的认知能力(Wei 等人,2022)。然而,它们在推理和规划等复杂任务中仍存在困难(Stechly 等人,2024;Sprague 等人,2024)。为了实现更强的系统 2 模型,研究人员采用了三种测试时计算策略来扩展模型推理的深度和准确性:重复采样、自我纠正和树搜索。重复采样模拟人类思维的多样性,自我纠正使大型语言模型能够反思,树搜索增强推理深度。
本文其余部分对系统 1 和系统 2 模型中测试时计算的最新研究进展进行了全面综述。在第 2 节中,我们介绍了系统 1 和系统 2 思维的背景。第 3 节和第 4 节详细介绍了系统 1 和系统 2 模型的测试时计算方法。然后,我们在第 5 节中讨论了可能的未来研究方向。
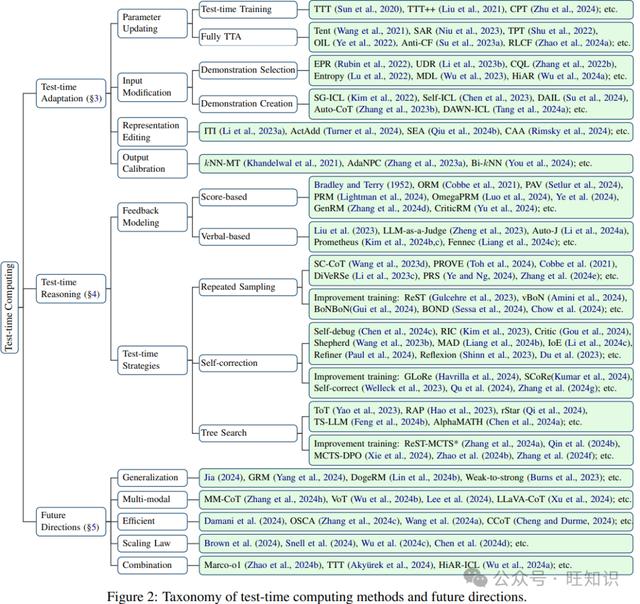
系统 1 和系统 2 思维是心理学概念(Kahneman,2011)。当识别熟悉的模式或处理简单问题时,人类通常会直觉地做出反应。这种自动、快速的思维被称为系统 1 思维。相反,当处理数学证明或逻辑推理等复杂问题时,需要深入、审慎的思考,这被称为系统 2 思维——缓慢且具有反思性。在人工智能领域,研究人员也使用这些术语来描述不同类型的模型(LeCun,2022)。系统 1 模型直接基于内部编码的感知信息和世界知识做出响应,不显示任何中间决策过程。相比之下,系统 2 模型明确生成推理过程并逐步解决任务。在大型语言模型兴起之前,系统 1 模型是人工智能的主流。尽管许多深度学习模型,如 ResNet、Transformer 和 BERT,在计算机视觉和自然语言处理的各种任务中取得了优异的性能,但这些类似于人类直觉的系统 1 模型缺乏足够的鲁棒性,容易出错。如今,大型语言模型强大的生成和推理能力使构建系统 2 模型成为可能。Wei 等人(2022)提出的思维链(CoT)允许大型语言模型在推理过程中逐步生成中间推理步骤。实证和理论结果表明,这种方法明显优于直接生成答案的方法(Kojima 等人,2022;Zhou 等人,2023;Tang 等人,2024b;Feng 等人,2024a;Li 等人,2024e)。然而,以思维链提示为代表的当前系统 2 模型仍存在缺陷。大型语言模型生成的中间过程可能包含错误,导致累积错误并最终得出错误答案。虽然检索增强生成(RAG)有助于减少事实性错误(Trivedi 等人,2023;Guan 等人,2024;Wang 等人,2024g;Ji 等人,2024),但它们对提高推理能力的影响仍然有限。因此,启用思维链的大型语言模型仍处于弱系统 2 思维阶段。
模型更新在推理阶段利用测试样本信息进一步微调模型参数,使模型能够适应测试分布。关键在于如何获取测试样本的信息以提供学习信号,以及如何选择合适的参数和优化算法来实现高效稳定的更新。
- 学习信号:在推理阶段,测试样本的真实标签不可用。因此,许多工作试图设计无监督或自监督目标作为学习信号。现有学习信号根据训练过程是否可修改可分为两类:测试时训练(TTT)和完全测试时适应(FTTA)。TTT 假设用户可以通过纳入能够感知分布转移的辅助任务来修改训练过程。在测试时适应期间,辅助任务的损失用作优化的学习信号。许多自监督任务已被证明在图像模态中可作为有效的辅助任务,如旋转预测(Sun 等人,2020)、元学习(Bartler 等人,2022)、掩码自动编码(Gandelsman 等人,2022)和对比学习(Liu 等人,2021;Chen 等人,2022)。其中,对比学习由于其在模态内和跨模态的自监督学习泛化能力,已成功应用于视觉 - 语言任务的测试时适应(Zhu 等人,2024)。相比之下,FTTA 无需访问训练过程,而是使用测试样本的内部或外部反馈作为学习信号。不确定性是最常用的学习信号,其动机是当测试样本偏离训练分布时,模型对其预测的置信度较低,从而导致更高的不确定性。Tent(Wang 等人,2021)使用模型预测的熵作为不确定性的度量,并通过最小化熵来更新模型。MEMO(Zhang 等人,2022a)对单个测试样本的数据进行扩充,然后最小化其边际熵,在单样本 TTA 设置中比 Tent 更稳定。然而,最小化熵也存在陷阱,因为盲目降低预测不确定性可能导致模型崩溃并做出平凡的预测(Press 等人,2024;Zhao 等人,2023;Su 等人,2023a)。一些工作提出了用于最小化熵的新正则化项以避免模型崩溃,包括 Kullback - Leibler 散度(Su 等人,2023a)、矩匹配(Hassan 等人,2023)和熵匹配(Bar 等人,2024)。对于特定任务,少量的人类反馈或外部模型奖励也可以作为高质量的学习信号。Gao 等人(2022)和 Li 等人(2022b)利用用户反馈来适应问答模型。Zhan 等人(2023)通过使用 COMET(Rei 等人,2020)评估翻译质量,将测试时适应应用于多语言机器翻译任务。在跨模态任务如图像 - 文本检索和图像字幕生成中,RLCF(Zhao 等人,2024a)通过使用 CLIP 分数作为 TTA 信号展示了其有效性。
- 更新参数:为了推进测试时适应在现实场景中的应用,研究人员必须解决效率和稳定性方面的挑战。为了提高效率,许多方法仅微调一小部分参数,如归一化层(Schneider 等人,2020;Su 等人,2023b)、软提示(Shu 等人,2022;Hassan 等人,2023;MA 等人,2023;Feng 等人,2023;Niu 等人,2024)、低秩适应模块(Imam 等人,2024)、适配器模块(Muhtar 等人,2024;Su 等人,2023a)和跨模态投影仪(Zhao 等人,2024a)。尽管要微调的参数数量减少了,但测试时适应仍然需要额外的反向传播。通常,一次反向传播的时间成本大约是前向传播的两倍。因此,Niu 等人(2024)提出了 FOA,它通过协方差矩阵适应进化策略调整软提示,无需反向传播。测试时适应的稳定性主要体现在两个方面。一方面,无监督或自监督学习信号不可避免地会在优化过程中引入噪声,导致测试时适应在错误的梯度方向上优化模型。为了解决这个问题,Niu 等人(2023)和 Gong 等人(2024)提出了噪声数据过滤策略和鲁棒的锐度感知优化器。另一方面,在现实场景中,测试样本的分布可能会不断变化,但持续的测试时适应优化可能会导致模型对原始知识的灾难性遗忘。情节式测试时适应(Wang 等人,2021;Shu 等人,2022;Zhao 等人,2024a)是一种避免遗忘的设置,在对单个测试样本进行测试时适应后将模型参数重置为其原始状态。然而,情节式测试时适应频繁加载原始模型,导致更高的推理延迟,并且也限制了模型的增量学习能力。为了克服这一困境,一个常见的技巧是指数移动平均(Wortsman 等人,2022;Ye 等人,2022),它结合了来自先前模型状态的信息。
对于大型语言模型,大量的参数使得基于模型更新的测试时适应方法在效率和稳定性方面面临更严峻的困境。因此,不依赖参数更新的基于输入修改的方法已成为大型语言模型中测试时适应的主流方法。基于输入修改的测试时适应的有效性源于大型语言模型的上下文学习(ICL)能力,通过在测试样本前添加一些示例可以显著提高性能。上下文学习对示例的选择和顺序高度敏感。因此,输入修改的测试时适应的核心目标是为测试样本选择合适的示例,并以最佳顺序排列它们,以最大化上下文学习的有效性。首先,实证研究(Liu 等人,2022)表明,示例与测试样本越接近,上下文学习的性能越好。因此,像 BM25 和 SentenceBERT 这样的检索模型被用于检索语义上与测试样本最接近的示例,并按相似度降序对它们进行排序(Qin 等人,2024a;Luo 等人,2023a)。为了提高示例检索的准确性,Rubin 等人(2022)和 Li 等人(2023b)通过对比学习专门训练示例检索器。然后,随着研究人员对上下文学习机制的深入研究,认为上下文学习对示例进行隐式梯度下降(Dai 等人,2023)。因此,从训练数据的角度来看,示例也需要具有信息性和多样性(Su 等人,2022;Li 和 Qiu,2023)。Wang 等人(2023c)将语言模型视为主题模型,并将示例选择问题表述为求解贝叶斯最优分类器。此外,示例的顺序是另一个重要的改进领域。Lu 等人(2022)和 Wu 等人(2023)分别以信息论为指导,选择具有最大局部熵和最小描述长度的示例进行排序。Scarlatos 和 Lan(2024)以及 Zhang 等人(2022b)考虑了示例之间的顺序依赖性,并将其建模为顺序决策问题,通过强化学习优化示例选择和排序。另一条研究路线(Chen 等人,2023;Lyu 等人,2023;Kim 等人,2022;Zhang 等人,2023b)认为,在实践中,组合有限的外部提供的示例可能并不总是最佳选择。大型语言模型可以利用其生成和注释能力来创建更好的示例。DAIL(Su 等人,2024)构建了一个示例记忆,存储先前的测试样本及其预测作为后续样本的候选示例。DAWN - ICL(Tang 等人,2024a)进一步将测试样本的遍历顺序建模为规划任务,并通过蒙特卡洛树搜索(MCTS)对其进行优化。
对于生成式大型语言模型,一些工作发现性能瓶颈不在于编码世界知识,而在于中间层信息与输出之间的巨大差距。在推理阶段,编辑表示可以帮助将中间知识外化为输出。PPLM(Dathathri 等人,2020)在小型语言模型的指导下进行基于梯度的表示编辑,以控制输出的风格。ActAdd(Turner 等人,2024)选择两个语义对比的提示,并计算它们的表示差异作为引导向量,然后将其添加到残差流中。基于对比提示的表示编辑在更广泛的场景中证明了其有效性,包括指令遵循(Stolfo 等人,2024)、减轻幻觉(Li 等人,2023a;Arditi 等人,2024)、减少毒性(Liu 等人,2024a;Lu 和 Rimsky,2024)和个性(Cao 等人,2024)。SEA(Qiu 等人,2024b)将表示投影到与正提示具有最大协方差且与负提示具有最小协方差的方向上。他们还引入了非线性特征变换,使表示编辑能够超越线性可分的表示。Scalena 等人(2024)对引导强度的选择进行了深入研究。他们发现对每个输出标记应用逐渐减小的引导强度可以在不影响质量的情况下提高对生成的控制。
使用外部信息校准模型的输出分布也是一种高效且有效的测试时适应方法(Khandelwal 等人,2020)。AdaNPC(Zhang 等人,2023a)设计了一个内存池来存储训练数据。在推理过程中,给定一个测试样本,AdaNPC 从内存池中召回 k 个样本,并使用 k 近邻(kNN)分类器预测测试样本。然后,它将测试样本及其预测标签存储在内存池中。随着时间的推移,内存池中的样本分布逐渐与测试分布对齐。在自然语言处理中,这种方法最具代表性的应用是 kNN 机器翻译(kNN - MT)。kNN - MT(Khandelwal 等人,2021)构建一个数据存储来存储上下文表示及其相应的目标标记。在翻译推理过程中,它根据解码上下文从数据存储中检索 k 个最近的候选标记,并将其处理为概率。最后,它通过对模型概率和检索到的概率进行加权融合来校准翻译模型的概率分布。kNN - MT 在跨域和多语言机器翻译任务中比传统模型表现出更好的迁移性和泛化性。后续研究集中在提高其性能和效率(Wang 等人,2022a;Zhu 等人,2023b;You 等人,2024)或将其方法应用于其他自然语言处理任务(Wang 等人,2022b;Bhardwaj 等人,2023)。
测试时推理旨在花费更多的推理时间在广阔的解码搜索空间中寻找最类似人类的推理过程。在本节中,我们介绍测试时推理的两个核心组件:反馈建模和搜索策略(如图 3 所示)。
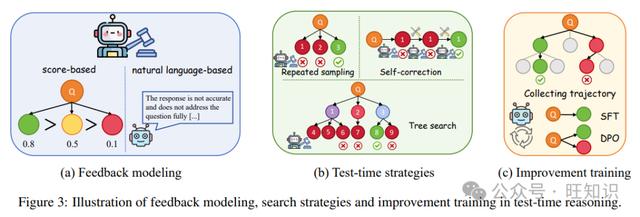
- 基于分数的反馈:基于分数的反馈,也称为验证器,旨在对生成的结果进行评分,评估其与真实情况或人类认知过程的一致性。其训练过程通常类似于强化学习中的奖励模型,使用各种形式的反馈信号并将其建模为分类(Cobbe 等人,2021)或排序任务(Bradley 和 Terry,1952;Yuan 等人,2024a;Hosseini 等人,2024)。在推理任务中,验证器主要分为两类:基于结果的验证器(ORMs)和基于过程的验证器(PRMs)。ORMs(Cobbe 等人,2021)使用最终思维链结果的正确性作为训练反馈,而 PRMs(Uesato 等人,2022;Lightman 等人,2024)则基于每个推理步骤的反馈进行训练。PRM 不仅评估中间推理步骤,而且比 ORM 更准确地评估整个推理过程。然而,PRM 需要更多的人力来注释中间步骤的反馈。Math - Shepherd(Wang 等人,2024e)和 OmegaPRM(Luo 等人,2024)利用蒙特卡洛树搜索(MCTS)算法自动收集高质量的过程监督数据。Setlur 等人(2024)认为 PRM 应该评估每个步骤对后续推理的优势,而不仅仅关注其正确性。他们提出了过程优势验证器(PAVs),并通过蒙特卡洛模拟有效地构建训练数据。基于分数的反馈建模忽略了大型语言模型的生成能力,使得难以检测细粒度的错误。因此,最近的工作提出了基于生成分数的验证器(Ankner 等人,2024;Ye 等人,2024)。GenRM(Zhang 等人,2024d)利用指令调整使验证器能够回答“答案是否正确(是/否)?”,并使用生成“是”标记的概率作为分数。GenRM 还可以结合思维链,允许验证器在回答“是”或“否”之前生成相应的理由。CriticRM(Yu 等人,2024)联合训练评论模型和验证器。在推理过程中,验证器根据答案和评论模型生成的基于语言的反馈进行评分。
- 基于语言的反馈:虽然验证器可以准确评估生成答案或步骤的正确性,但它缺乏可解释性,无法定位错误的具体原因或提供纠正建议。基于语言的反馈,也称为评论者,充分利用了大型语言模型的指令遵循能力。通过设计特定的指令,它可以进行成对比较,从多个维度评估答案,甚至以自然语言提供修改建议。强大的闭源大型语言模型,如 GPT - 4 和 Claude,是有效的评论者。它们可以对生成的文本进行详细和受控的评估,如事实性、逻辑错误、连贯性和一致性,与人类评估具有高度一致性(Wang 等人,2023a;Luo 等人,2023b;Liu 等人,2023;Chiang 和 Lee,2023)。然而,它们仍然面临诸如长度、位置和困惑度等偏差(Bavaresco 等人,2024;Wang 等人,2024d;Stureborg 等人,2024)。LLM - as - a - Judge(Zheng 等人,2023)精心设计系统指令以减轻偏差的干扰。为了获得更便宜的基于语言的反馈,开源大型语言模型也可以通过监督微调(SFT)作为有竞争力的替代品(Wang 等人,2024f;Zhu 等人,2023a;Liang 等人,2024c;Paul 等人,2024)。Shepherd(Wang 等人,2023b)从人类注释和在线社区收集高质量的训练数据来微调评估模型。Auto - J(Li 等人,2024a)从各种场景收集查询和响应,并为每个场景设计评估标准。GPT4 然后根据这些标准生成对响应的评论,并将其评论能力提炼到开源大型语言模型中。Prometheus(Kim 等人,2024b,c)设计了更精细的评估维度。它分别训练一个单独的评估模型和一个成对排序模型,然后通过权重合并将它们统一到一个大型语言模型中。Fennec(Liang 等人,2024c)允许 GPT - 4 确定每个查询的评估标准,并生成相应的语言反馈。与以前的工作相比,Fennec 的评估标准更灵活,生成的评估数据更多样化,并且与人类行为更一致。
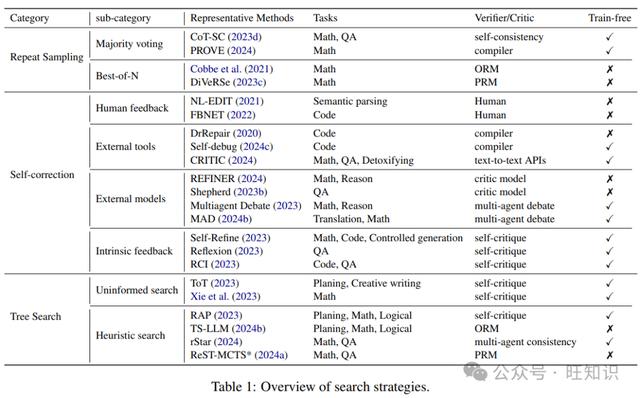
- 重复采样:采样策略如 top - p 和 top - k 是大型语言模型推理中常用的解码算法。它们在解码过程中引入随机性以增强文本多样性,允许并行采样多个生成的文本。通过重复采样,我们有更多机会找到正确答案。重复采样特别适用于可以自动验证的任务,如代码生成,在这种任务中,我们可以使用单元测试轻松从多个样本中识别出正确的解决方案(Li 等人,2022a;Rozière 等人,2024)。对于难以验证的任务,如数学应用题,重复采样有效性的关键在于验证策略。
- 验证策略:验证策略包括两种类型:多数投票和最佳 N 采样(BoN)。多数投票(Li 等人,2024b;Lin 等人,2024a)选择样本中出现最频繁的答案作为最终答案,其动机来自集成学习。多数投票简单有效。例如,自一致性思维链(Wang 等人,2023d)在数学推理任务中比普通思维链的准确率提高了 18%。然而,多数并不总是正确的,因为它们可能会犯类似的错误。因此,一些研究在投票前进行验证和过滤。例如,PROVE 框架(Toh 等人,2024)将思维链转换为可执行程序,如果程序结果与推理链的结果不一致,则过滤掉样本。最佳 N 采样使用验证器对每个生成的结果进行评分,并选择得分最高的作为最终答案(Stiennon 等人,2020;Cobbe 等人,2021;Nakano 等人,2022)。Li 等人(2023c)提出了一种基于投票的 BoN 变体,它根据验证器的分数对所有答案进行加权投票,并选择权重最高的答案。此外,一些工作旨在提高 BoN 的效率。受推测解码的启发,Zhang 等人(2024e);Qiu 等人(2024a);Sun 等人(2024)和 Manvi 等人(2024)使用高效的验证器评估每个推理步骤。他们修剪得分低的采样结果,停止对那些路径的进一步生成,从而显著降低总体时间成本。PRS(Ye 和 Ng,2024)使大型语言模型能够自我评论和自我纠正,以更少的采样次数引导模型生成预期的响应。
- 改进训练:重复采样,特别是 BoN 策略,在许多研究中已被证明是一种简单有效的方法,甚至可以超过使用强化学习微调的模型(Gao 等人,2023a)。然而,它以在实际应用中难以承受的推理时间为代价。因此,许多研究试图通过 BoN 采样训练模型以近似 BoN 分布,从而减少推理过程中的搜索空间。ReST(Gulcehre 等人,2023)从策略模型中采样奖励值高于阈值的响应作为自训练数据,并通过离线强化学习微调策略模型。在每次迭代中,ReST 采样新的训练数据。vBoN(Amini 等人,2024)、BoNBoN(Gui 等人,2024)和 BOND(Sessa 等人,2024)推导 BoN 分布并最小化策略模型的分布与 BoN 分布之间的差异。Chow 等人(2024)设计了一种 BoN 感知损失,使策略模型在微调过程中更具探索性。
- 自我纠正:自我纠正是一种顺序的测试时计算方法,使大型语言模型能够根据外部或内部反馈迭代地修改和完善生成的结果(Shinn 等人,2023)。
- 反馈来源:用于自我纠正的反馈通常以自然语言呈现,并来自各种来源,包括人类评估、工具检查、外部模型评估和内在反馈。人类评估是反馈的黄金标准,但由于其成本高且可扩展性有限,主要用于早期研究以探索自我纠正能力的上限(Tandon 等人,2021;Elgohary 等人,2021;Tandon 等人,2022)。对于某些特定领域的任务,外部工具检查提供准确有效的反馈(Gou 等人,2024;Chen 等人,2024c;Gao 等人,2023b)。例如,Yasunaga 和 Liang(2020)提出在代码修复和生成任务中从编译器获取反馈。外部模型评估是一般任务的有效反馈来源,如第 4.1 节中描述的各种基于语言的评论模型。例如,Paul 等人(2024)首先为自然语言推理任务定义多种错误类型,然后设计相应的反馈模板。他们使用合成反馈训练数据训练评估模型,并通过评论者使推理模型的性能得到显著提高。多智能体辩论(Du 等人,2023;Xiong 等人,2023;Liang 等人,2024b;Chen 等人,2024b;Wang 等人,2024c)是另一种利用外部反馈增强推理能力的机制。在这种方法中,模型没有明确的推理者和评论者角色。相反,多个模型独立进行推理,相互评论,并根据反馈捍卫或完善自己的推理。这个过程一直持续到智能体达成共识或裁判模型总结最终推理结果。多智能体辩论在事实核查(Kim 等人,2024a;Khan 等人,2024)、常识问答(Xiong 等人,2023)、忠实评估(Chan 等人,2024)和复杂推理(Du 等人,2023;Cheng 等人,2024)方面显示出潜力。然而,多智能体辩论可能不稳定,因为大型语言模型容易受到对抗性信息的影响,并且可能会在面对误导性输入时将正确答案修改为错误答案(Laban 等人,2024;Amayuelas 等人,2024)。因此,成功的多智能体辩论要求大型语言模型在面对其他模型的错误答案时保持立场,同时对有效建议保持开放态度(Stengel - Eskin 等人,2024)。一般来说,参与辩论的大型语言模型越多,整体推理性能越强。然而,这显著增加了所需的大型语言模型推理次数和输入上下文的长度,对大型语言模型的推理成本构成了重大挑战(Liu 等人,2024b)。为了降低辩论推理成本,Li 等人(2024d)研究了多个智能体之间拓扑连接的影响,并表明稀疏连接,如环形结构,并不逊于全连接拓扑。GroupDebate(Liu 等人,2024b)将大型语言模型分组,在组内进行辩论,仅在组间共享共识结果。自我评论假设大型语言模型可以自我评估其输出并通过内在反馈进行优化(Yuan 等人,2024b)。这个想法源于计算复杂性理论的一个基本原则:验证一个解决方案是否正确通常比解决问题更容易。Bai 等人(2022)提出通过提示大型语言模型自我纠正有害响应。Self - Refine(Madaan 等人,2023)和 RCI Prompting(Kim 等人,2023)在诸如算术推理等任务中迭代地提示大型语言模型自我纠正其响应。IoE(Li 等人,2024c)观察到大型语言模型在自我评论过程中可能会过度批评自己,导致性能下降,并设计提示来引导大型语言模型评估置信度。
- 有效性争议:自我纠正的有效性一直存在争议。一些关于代码生成(Olausson 等人,2024)、常识问答(Huang 等人,2024)、数学问题解决(Wang 等人,2024b)、规划(Valmeekam 等人,2023)和图着色(Stechly 等人,2023)的实证研究证实,自我纠正并不是提高性能的保证方法。Kamoi 等人(2024)认为自我纠正的有效性被高估了。以前的成功要么依赖于标准答案,要么依赖于弱初始答案。只有能够分解为易于验证的子任务的任务才能真正从自我纠正中受益。他们建议微调特定的评估模型以实现更好的自我纠正。Tyen 等人(2024)将大型语言模型识别和纠正错误的能力解耦,并创建了相应的评估数据集。评估结果表明,大型语言模型在自我纠正过程中并不缺乏纠正错误的能力,其主要性能瓶颈在于定位错误。
- 改进训练:上述大多数自我纠正方法在先进的闭源大型模型或具有超过 70B 参数的开源大型语言模型上表现出显著的性能提升。然而,对于能力较弱的中等规模开源模型,我们需要进一步微调它们以释放其自我纠正能力。监督微调使用高质量的多轮纠正数据优化模型,这些数据可以是手动注释的(Saunders 等人,2022),也可以是从更强的大型语言模型中采样的(Paul 等人,2024;Qu 等人,2024;Gao 等人,2024b;Zhang 等人,2024g;Xi 等人,2024)。GLoRe(Havrilla 等人,2024)认为大型语言模型需要针对不同类型的错误进行全局或局部优化。为了解决这个问题,他们构建了用于全局和局部优化的训练集,训练验证器来识别全局和局部错误,并开发基于不同全局或局部反馈信号进行优化的大型语言模型。虽然监督微调是有效的,但离线生成的自我纠正轨迹的训练数据只能模拟有限的纠正模式。这导致与模型推理过程中的实际自我纠正行为存在分布不匹配。Self - correct(Welleck 等人,2023)采用在线模仿学习,在每个训练周期后重新采样新的自我纠正轨迹进行训练。SCoRe(Kumar 等人,2024)提出使用多轮强化学习方法来提高自我评论和自我纠正能力。
- 树搜索:重复采样和自我纠正分别以并行和顺序的方式扩展测试时计算。人类思维是一种树搜索,在遇到死胡同时,它将头脑风暴与回溯相结合,以找到其他解决路径。搜索算法和价值函数是树搜索中的两个关键组件。
- 搜索算法:在大型语言模型推理中,当前的搜索算法包括无信息搜索和启发式搜索。无信息搜索不依赖于特定的启发式信息,而是按照固定规则探索搜索空间。例如,思维树(ToT)(Yao 等人,2023)采用广度优先搜索(BFS)或深度优先搜索(DFS)进行搜索,而 Xie 等人(2023)使用束搜索。无信息搜索对于具有大搜索空间的问题通常效率较低,因此以 MCTS 为代表的启发式搜索在推理任务中得到广泛应用(Hao 等人,2023;Zhang 等人,2024b;Bi 等人,2024)。MCTS 通过选择、扩展、模拟和反向传播四个步骤逐渐优化搜索结果,接近最优解。Long(2023)使用强化学习训练一个大型语言模型控制器来引导大型语言模型推理器的搜索路径。
- 价值函数:价值函数评估每个动作的价值,并在 MCTS 中引导树向具有更高价值的分支扩展。RAP(Hao 等人,2023)设计了一系列启发式价值函数,包括动作的可能性、状态的置信度、自我评估结果和特定任务的奖励,并根据任务要求将它们组合起来。可靠且通用的价值函数有助于将 MCTS 应用于具有更深搜索空间的更复杂问题。AlphaMath(Chen 等人,2024a)和 TS - LLM(Feng 等人,2024b)用学习到的大型语言模型价值函数替换手工制作的价值函数,在 MCTS 中自动生成推理过程和步骤级评估信号。传统的 MCTS 方法只扩展一个轨迹,而 rStar(Qi 等人,2024)认为当前的价值函数难以准确引导最优路径的选择。因此,rStar 保留多个候选路径,并使用另一个大型语言模型进行推理,最终选择两个大型语言模型推理结果一致的路径。Gao 等人(2024c)受对比解码的启发提出了 SC - MCTS,它利用多个外部奖励模型作为价值函数。
- 改进训练:树搜索可以引导大型语言模型生成长推理过程,这些数据有助于训练具有更强推理能力的大型语言模型。ReST - MCTS*(Zhang 等人,2024a)使用过程奖励作为价值函数来引导 MCTS,收集高质量的推理轨迹和每个步骤的价值,以改进策略模型和奖励模型。由于树搜索的逐步探索,它可以获得更细粒度的步骤级反馈信号。MCTS - DPO(Xie 等人,2024)通过 MCTS 收集步骤级偏好数据,并使用直接偏好优化(DPO)进行偏好学习。最近,许多类似 o1 的技术报告(Qin 等人,2024b;Zhao 等人,2024b;Zhang 等人,2024f)也证实了使用树搜索构建高质量长推理链数据进行训练的必要性。
目前,大多数类似 o1 的模型仅在数学和代码等特定领域表现出强大的深度推理能力,在适应跨领域或一般任务方面仍存在困难。解决这个问题的关键在于增强验证器或评论者的泛化能力。目前,一些工作利用模型集成(Lin 等人,2024b)或正则化约束(Yang 等人,2024;Jia,2024)使验证器更具泛化性。然而,验证器的泛化能力仍有很大的提升空间。此外,弱到强的泛化(Burns 等人,2023)是一个值得进一步探索的课题。人们不再满足于用标准答案解决数学问题;他们希望系统 2 模型能够辅助科学发现和数学猜想的证明。在这种情况下,即使是人类专家也难以提供准确的反馈,而弱到强的泛化提供了一个有前途的解决方向。
在系统 1 思维中,测试时适应(TTA)已成功应用于多模态大型语言模型,提高了在零样本图像分类、图像文本检索和图像字幕等任务中的性能(Zhao 等人,2024a)。然而,系统 2 思维中的测试时计算方法仍局限于文本模态。视觉、语音和其他模态对于模型理解和与世界的交互至关重要。为了实现认知智能,系统 2 模型必须能够充分整合多模态信息进行推理。多模态思维链(Zhang 等人,2024h;Wu 等人,2024b;Mondal 等人,2024;Lee 等人,2024;Gao 等人,2024a)的探索为构建多模态系统 2 模型开辟了可能性。Xu 等人(2024)首次将测试时计算应用于视觉推理任务。他们将视觉推理过程分为四个阶段:任务总结、字幕、推理和答案结论。他们提出了一种阶段级束搜索方法,在每个阶段重复采样并选择最佳结果进入下一阶段。我们认为测试时计算在多模态推理中仍有很大的发展潜力。例如,将更多模态如语音和视频纳入推理任务,将反思机制和树搜索等成功方法应用于多模态推理,或使多模态推理过程与人类认知过程保持一致。
测试时计算的成功应用表明,牺牲推理效率可以带来更好的推理性能。然而,研究人员继续寻求在性能和效率之间取得平衡,旨在在固定的推理延迟预算下实现最佳性能。这需要根据每个样本自适应地分配计算资源。Damani 等人(2024)训练一个轻量级模块来预测问题的难度,并根据其难度分配计算资源。Zhang 等人(2024c)进一步将分配目标扩展到更多超参数。仍有许多开放性问题值得探索,例如如何将推理加速策略(如 KV 缓存压缩、标记修剪和推测解码)与测试时计算相结合,以及如何更准确地预测问题难度。
与训练时计算缩放不同,测试时计算仍然缺乏通用的缩放定律。一些工作试图推导特定测试时计算策略的缩放定律(Wu 等人,2024c;Chen 等人,2024d)。Brown 等人(2024)表明性能与重复采样次数大致呈对数线性关系。Snell 等人(2024)研究了重复采样和自我纠正的缩放定律,并提出了计算最优缩放策略。实现通用缩放定律面临两个主要挑战:首先,当前的测试时计算策略多种多样,每种策略都有不同的引导模型机制,因此缺乏描述它们的通用框架;其次,测试时计算的性能受到多种因素的影响,包括样本难度、反馈信号的准确性和解码超参数,我们需要实证研究来筛选出关键因素。
不同的测试时计算策略适用于各种任务和场景,因此组合多种策略是实现更好的系统 2 思维的一种方法。例如,Marco - o1(Zhao 等人,2024b)结合了 MCTS 和自我纠正,使用 MCTS 规划推理过程,并用自我纠正提高每个步骤的准确性。此外,系统 1 模型中的测试时适应策略也可以与测试时推理策略相结合。Akyürek 等人(2024)将测试时训练与重复采样相结合。他们进一步优化测试样本上的语言建模损失,然后通过数据扩充生成多个候选答案,最后通过多数投票确定答案。他们展示了测试时训练在推理任务中的潜力,在 ARC 挑战中超过了人类平均水平。因此,我们认为对于大型语言模型推理,不仅要关注新兴的测试时策略,还要关注测试时适应方法。通过有效组合这些策略,我们可以开发出达到或超过 o1 水平性能的系统 2 模型。
在本文中,我们对测试时计算的现有工作进行了全面综述。我们介绍了系统 1 和系统 2 模型中的各种测试时计算方法,并展望了该领域的未来研究方向。我们相信测试时计算可以帮助模型更好地处理复杂的现实世界分布和任务,使其成为推动大型语言模型向认知智能发展的有前途的途径。我们希望本文能促进该领域的进一步研究。
测试时计算,特别是系统 2 中的策略,发展迅速。虽然我们努力对现有研究进行全面综述,但要涵盖所有最新进展具有挑战性。本综述包括截至 2024 年 11 月的论文,更多近期进展将在未来版本中更新。测试时适应在计算机视觉任务中有许多成功的应用和特定任务的策略。由于本文的主要受众是自然语言处理领域的研究人员,我们没有系统地介绍这些工作,有兴趣的读者可以参考 Liang 等人(2024a)了解详情。
作者:张长旺,图源:旺知识
- 标题:Test-time Computing: from System-1 Thinking to System-2 Thinking
- 作者:Yixin Ji, Juntao Li, Hai Ye, Kaixin Wu, Jia Xu, Linjian Mo, Min Zhang
- 单位:1School of Computer Science and Technology, Soochow University 2Department of Computer Science, National University of Singapore 3Ant Group
- 标签:人工智能、测试时计算、系统 1 思维、系统 2 思维、深度学习
- 概述:本文综述了测试时计算在系统 1 和系统 2 模型中的研究进展,介绍了相关方法,探讨了未来方向,表明其有助于模型处理复杂任务,推动向认知智能发展。
- 链接:https://arxiv.org/pdf/2501.02497