旺精通~推理大语言模型综述:从系统1到系统2
旺精通:技术细节全解,深度精通技术
基础大语言模型在快速决策方面表现不错,但在复杂推理任务中,因类似系统1推理模式,缺乏深度逻辑分析能力。重要意义在于推理大语言模型能够模仿系统2思维,实现更精准、审慎的推理,有助于推动人工智能迈向更高水平,解决以往模型难以处理的复杂任务。
作者:张长旺,图源:旺知识
文章开篇阐述基础大语言模型类似系统1推理的局限性,引出推理大语言模型对模仿系统2思维的重要性。接着介绍推理大语言模型的基础,包括基础大语言模型进展及早期系统2技术。随后详细分析其构建方法,如特征、核心方法及演进。还介绍了推理大语言模型的基准测试,包括类别、指标及性能比较。最后探讨了面临的挑战及未来方向,旨在全面梳理该领域发展。
摘要&解读
实现人类水平的智能需要完善从快速、直观的系统1到较慢、更审慎的系统2推理的转变。虽然系统1擅长快速、启发式的决策,但系统2依靠逻辑推理来做出更准确的判断并减少偏差。基础大语言模型(LLMs)在快速决策方面表现出色,但缺乏复杂推理的深度,因为它们尚未完全具备真正的系统2思维的逐步分析特征。最近,像OpenAI的o1/o3和DeepSeek的R1等推理大语言模型在数学和编码等领域展示出专家级的表现,紧密模仿系统2的审慎推理,并展现出类似人类的认知能力。本综述首先简要概述基础大语言模型的进展和系统2技术的早期发展,探讨它们的结合如何为推理大语言模型铺平道路。接下来,我们讨论如何构建推理大语言模型,分析它们的特征、实现高级推理的核心方法以及各种推理大语言模型的演进。此外,我们提供推理基准的概述,深入比较代表性推理大语言模型的性能。最后,我们探索推进推理大语言模型的有前景的方向,并维护一个实时的GitHub存储库来跟踪最新进展。我们希望本综述能成为一个有价值的资源,激发这一快速发展领域的创新并推动其进步。
研究背景
:基础大语言模型虽在自然语言处理等方面取得进展,但在复杂推理任务中表现不佳,因其运作方式类似系统1推理,缺乏系统2推理所具备的逐步分析特征。这促使研究人员探索能够模仿系统2思维的推理大语言模型,以实现更精准、深度的推理。
研究贡献
:提出推理大语言模型概念,从多个方面对其进行深入研究。在构建方法上,明确了结构搜索、奖励建模、自我改进、宏观行动和强化微调等核心方法,为模型构建提供了理论和实践指导;在基准测试方面,梳理了各类基准测试类别和评估指标,通过性能比较凸显了推理大语言模型相对基础大语言模型的优势;在未来方向探索上,指出了多个具有潜力的研究方向,为后续研究提供思路。
实现设计
:结构搜索方面利用蒙特卡洛树搜索,通过定义不同行动和奖励方式来探索推理路径;奖励建模采用结果监督和过程监督,过程奖励模型(PRM)更具优势但面临数据收集等挑战;自我改进通过不同探索和改进策略提升模型性能;宏观行动通过特定操作实现测试时缩放和数据合成范式增强;强化微调利用奖励机制引导模型进化,以提高推理能力和准确性。
实验结果
:推理大语言模型在纯文本和多模态基准测试中表现出色,在数学、编码等纯文本任务中,如在AIME 2024、MATH - 500和LiveCodeBench等基准测试上,比基础大语言模型得分更高;在多模态任务中,如在MMMU和MathVista等基准测试上,也优于其相应的基础大语言模型,不过性能提升幅度相对纯文本任务较小。
1 引言
“不要灌输,要激励。”——OpenAI的Hyung Won Chung
实现人类水平的智能需要完善从系统1到系统2推理的转变[1-5]。双系统理论表明,人类认知通过两种模式运作:系统1快速、自动且直观,能够以最小的努力快速做出决策;系统2则较慢、更具分析性且审慎[6,7]。虽然系统1在常规任务中效率很高,但它容易产生认知偏差,尤其是在复杂或不确定的情况下,会导致判断错误。相比之下,系统2依赖逻辑推理和系统思维,能做出更准确、理性的决策[8-11]。通过减少系统1的偏差,系统2为解决问题提供了更精细的方法[12-15]。
基础大语言模型(LLMs)的发展是人工智能(AI)领域的一个重要里程碑。像GPT-4o[16]和DeepSeekv3[17]等模型在文本生成、语言翻译和各种感知任务中展现出了令人瞩目的能力[18-28]。这些模型在大量数据集上进行训练,并使用先进的算法,擅长理解和生成类似人类的回应。然而,尽管取得了令人印象深刻的成就,基础大语言模型的运作方式类似于系统1推理,依赖快速、启发式驱动的决策。虽然它们在提供快速回应方面表现出色,但在需要深度逻辑分析和复杂推理任务精度的场景中往往有所欠缺。在涉及复杂问题解决、逻辑分析或细致理解的情况下,这种局限性尤为明显,这些模型在这些方面仍无法与人类认知能力相媲美。
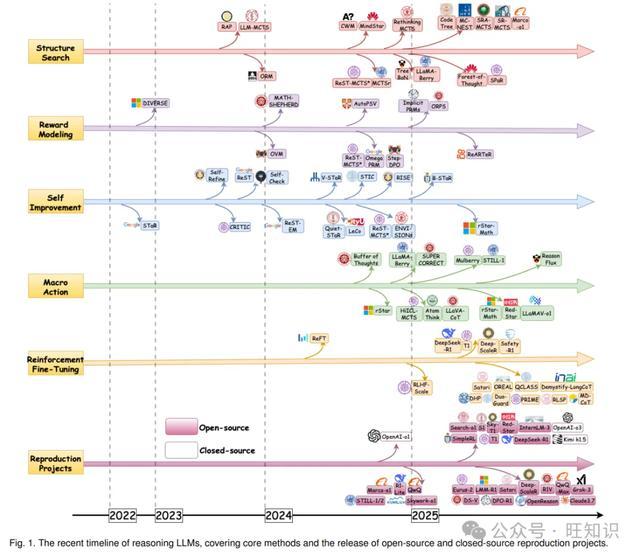
相比之下,推理大语言模型代表了语言模型发展中的一个重大进步。像OpenAI的o1/o3[29,30]和DeepSeek的R1[31]等模型旨在模仿与系统2思维相关的较慢、更审慎的推理。与基础大语言模型不同,推理大语言模型配备了逐步处理信息的机制,使它们能够做出更准确、理性的决策。从快速思考、直观过程向更有条理、推理驱动的模型的转变,使推理大语言模型能够以专家级的表现处理复杂任务,如高等数学[32-37]、逻辑推理[38-44]和多模态推理[45-47],展现出类似人类的认知能力。因此,推理大语言模型越来越被视为能够实现曾经被认为超出人工智能能力范围的任务所需的深度逻辑思维。推理大语言模型的近期发展时间线如图1所示。
1.1 综述结构
本综述全面概述了推理大语言模型发展中涉及的关键概念、方法和挑战。如图2所示,本综述的结构如下:
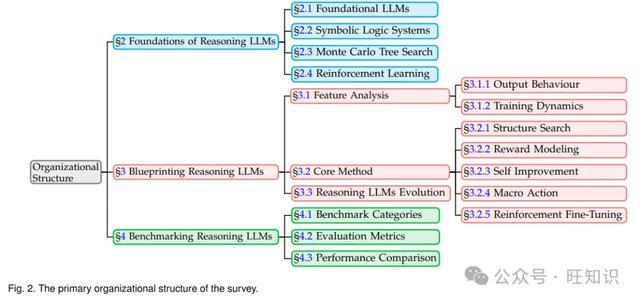
第2节简要概述基础大语言模型的进展(2.1节)以及关键系统2技术的早期发展,包括符号逻辑系统(2.2节)、蒙特卡洛树搜索(MCTS)(2.3节)和强化学习(RL)(2.4节),突出它们与基础大语言模型的结合如何为推理大语言模型铺平道路。
第3节介绍推理大语言模型并概述其构建过程。具体而言,3.1节从两个角度介绍推理大语言模型的特征:输出行为(3.1.1节)和训练动态(3.1.2节),强调它们与基础大语言模型的差异。3.2节确定实现高级推理能力所需的核心方法,重点关注五个方面:结构搜索(3.2.1节)、奖励建模(3.2.2节)、自我改进(3.2.3节)、宏观行动(3.2.4节)和强化微调(3.2.5节)。每一节都深入探讨这些方法的具体特征,并为每种方法介绍代表性的推理大语言模型。3.3节追溯推理大语言模型的演进阶段。
第4节评估代表性的推理大语言模型。具体而言,4.1节回顾当前主流的推理基准,涵盖各种任务类型的纯文本和多模态基准。4.2节概述当前的评估指标,而4.3节根据这些基准分析和比较主流推理大语言模型与其基础模型的性能。
第5节突出现有推理大语言模型的局限性,并概述这些模型未来几个有前景的发展方向。
最后,我们在第6节总结本文,并提供一个实时跟踪的GitHub存储库,以监测该领域的最新发展。
我们希望本综述能成为一个有价值的资源,促进这一快速发展领域的创新和进步。
1.2 综述贡献
最近,对特定技术方法进行了一些分析和复现[48-55],但仍然缺乏系统的分析和整理。研究[56]仅关注测试过程中的慢思考方法。同时,研究[57-59]主要集中在训练或实现推理大语言模型上,通常是从强化学习的角度。
我们的综述在以下方面与现有文献有所不同并做出贡献:
我们不是专注于单一的技术方法,而是全面概述推理大语言模型涉及的关键概念、方法和挑战。
我们总结了早期系统2的关键进展,以及它们如何与基础大语言模型相结合,为推理大语言模型铺平道路,这是先前工作中经常被忽视的关键方面。
我们更全面、更广泛地总结了构建推理大语言模型所需的核心方法,包括但不限于强化学习。
2 推理大语言模型的基础
在本节中,我们简要概述基础大语言模型的进展和关键系统2技术的早期发展,突出这些进展与基础大语言模型结合时,如何为推理大语言模型铺平道路。这些进展包括符号逻辑系统、蒙特卡洛树搜索和强化学习。
2.1 基础大语言模型
2018 - 2019年预训练Transformer[18]的引入,特别是BERT[19]和GPT[21],使得基础大语言模型取得了重大进展。这些模型利用在大量文本语料库上的无监督预训练,然后针对特定任务进行微调。这种方法使它们在专门从事情感分析、实体识别和问答等任务之前,能够发展出广泛的语言理解能力。BERT的双向上下文处理改进了对单词的理解,而GPT凭借其单向设计在文本生成方面表现出色。
2019年发布的拥有15亿参数的GPT-2[22]在生成性能上实现了重大飞跃,尽管它也引发了伦理问题。拥有1750亿参数的GPT-3[23]进一步展示了无监督预训练的力量,在少样本学习方面表现出色,并且在广泛的自然语言处理任务中都有良好表现。在随后的几年里,像CLIP[60]和DALL-E[61]这样的多模态模型出现了,它们整合了文本和视觉输入。这些模型实现了新的任务,比如从文本生成图像,并增强了人机交互。
到2023 - 2024年,像GPT-4/4o[16,62]、LLaMA[25]和LLaVA[27]等模型在推理、上下文理解和多模态推理方面展示出先进的能力,能够处理文本和图像[63-65]。具有6710亿混合专家架构[66-68]的DeepSeek-V3[17]在关键基准测试中优于其他几个大语言模型,同时在效率和处理速度方面有显著提升。基础大语言模型的演进彻底改变了人工智能,在语言理解、问题解决和人机协作方面实现了更复杂的应用。
总结:基础大语言模型的发展从像BERT这样的预训练Transformer发展到像GPT-4这样的多模态模型,增强了语言理解、文本生成和图像处理能力。这一进步在人工智能领域带来了重大突破,改善了语言理解、问题解决和人机交互。基于深度学习的进展[18,69-83],基础大语言模型可以从大量的文本或多模态数据中学习广泛的世界知识和语义关系。这使它们能够展现出诸如上下文学习(ICL)[84,85]、提示工程[86,87]和思维链(CoT)推理[2]等涌现能力,显著提高了它们的适应性和创造性解决问题的能力。
尽管取得了这些进展,基础大语言模型的运作方式与系统1推理类似,依赖快速、启发式驱动的决策,缺乏系统2的逐步分析特征。然而,它们的发展为未来的推理大语言模型奠定了坚实的基础,尤其是当与以下早期系统2技术相结合时。这种结合为更通用、灵活和类人化的推理模型铺平了道路。
2.2 符号逻辑系统
符号逻辑系统标志着人工智能的最早阶段,它利用规则和逻辑原则来表示知识并得出结论[88,89]。它们在结构化领域特别有效,在这些领域中形式逻辑确保了精确性。
Prolog是一种基于一阶逻辑的逻辑编程语言,它允许用户定义事实、规则并通过查询进行推理。它在符号推理系统中,特别是在自然语言处理和专家系统中发挥了关键作用[90-92]。像Prolog这样的基于逻辑的系统使用命题逻辑和谓词逻辑进行形式推理[93,94]。从20世纪60年代到80年代初,这种方法主导了人工智能领域,例如IBM的用于符号计算的LISP[95]和用于自动推理的归结定理证明器[96]。20世纪70年代,Marvin Minsky引入了框架(Frames),它将知识组织成结构化框架,对专家系统和认知科学都产生了影响[97]。
总结:符号逻辑系统是早期人工智能发展的关键里程碑。基于形式逻辑,它们在定义明确的问题中表现出色,尤其是在结构化环境中。然而,它们也暴露了僵化的基于规则系统的局限性。尽管存在这些限制,符号逻辑仍然是人工智能进步的基础。
最近推理大语言模型的进展通过复杂的思维架构(称为宏观行动框架,见3.2.4节)极大地增强了对类人系统2认知过程的模拟。通过将符号模板或规则与基础大语言模型相结合,宏观行动显著提高了它们的推理能力。将宏观行动集成到基础大语言模型中改变了它们处理复杂推理任务的能力,因为分层规划允许模型在深入研究具体问题细节之前做出高级决策,这反映了符号逻辑的结构化方法。
2.3 蒙特卡洛树搜索
蒙特卡洛树搜索(MCTS)是一种用于决策和规划的基于模拟的搜索算法[98]。它通过四个步骤构建搜索树:选择,即使用UCB1公式选择具有最高优先级的子节点:
其中是节点的总奖励,是其访问次数,是父节点的访问次数,用于平衡探索和利用。扩展用于添加新节点,模拟通过随机滚动来评估节点,反向传播用于更新节点统计信息。蒙特卡洛树搜索已广泛应用于诸如围棋等棋盘游戏的策略优化以及机器人路径规划等任务中,它有助于机器人在动态环境中有效导航[100]。
总结:蒙特卡洛树搜索在推理大语言模型的发展中发挥了关键作用,特别是在结构搜索(3.2.1节)方面。通过模拟潜在的未来推理路径并反向传播估计的奖励,蒙特卡洛树搜索帮助基础大语言模型有效地识别最有前景、高回报的路径。这个过程类似于人类的规划,即在采取行动之前考虑决策的未来后果。通过动态探索多个推理轨迹,蒙特卡洛树搜索使模型能够避免陷入次优路径,更容易在复杂的决策空间中导航。这种集成显著增强了大语言模型处理复杂和动态推理问题的能力,例如那些需要长期规划或多步逻辑推理的问题。它使大语言模型能够做出更具战略性和明智的决策,提高了它们在涉及细致推理和战略探索任务中的整体性能。
2.4 强化学习
强化学习是一种机器学习类型,其中智能体通过与环境交互并以奖励的形式接收反馈来学习做出决策,旨在随着时间的推移最大化累积奖励[101]。强化学习的早期突破,如Q学习[102]和深度Q网络(DQNs)[103],通过使用深度神经网络(DNNs)[104]处理复杂的状态空间,彻底改变了该领域。这些方法为将强化学习扩展到现实世界任务铺平了道路,而传统的表格方法在这些任务中表现不佳。深度强化学习的出现是一个重要的进步,它将深度学习的力量与强化学习相结合,以处理高维输入,如图像和非结构化数据。
深度强化学习的一个里程碑式成就是AlphaGo,它通过自我对弈在复杂的围棋游戏中击败世界冠军,展示了强化学习的潜力[105]。这一成功凸显了深度强化学习在具有大的连续动作空间和不确定性的环境中取得成功的能力。在此基础上,AlphaZero通过使用自我对弈、蒙特卡洛树搜索和深度神经网络掌握了多种棋盘游戏(国际象棋、围棋和将棋),进一步推进了这种方法[106]。AlphaZero能够完全从零开始学习,无需事先的人类知识,展示了强化学习在需要长期策略和规划的环境中的力量。
AlphaStar在实时战略游戏《星际争霸II》中表现出色,进一步扩展了深度强化学习的边界。与棋盘游戏不同,《星际争霸II》呈现出动态的、部分可观察的环境,并且需要多步实时决策[107]。AlphaStar在这个领域的成功证明了深度强化学习适应复杂决策场景的能力,这些场景既需要战略规划又需要战术执行。这些在强化学习和深度强化学习方面的进展极大地扩展了人工智能的潜力,从定义明确的静态环境过渡到需要持续学习和适应的动态复杂环境。
总结:深度强化学习在解决复杂决策任务方面已被证明非常有效。AlphaGo通过自我对弈学习策略并击败围棋世界冠军就是一个例证。这种自我对弈的概念为推理大语言模型中的自我改进技术(3.2.3节)奠定了基础,两者都依赖于持续的反馈和调整来优化策略。
在强化学习中,奖励塑造至关重要,特别是对于多步推理任务[108]。通过调整奖励信号以在中间步骤提供更细致的反馈,它帮助智能体在复杂的决策路径中导航。这个概念启发了推理大语言模型中奖励建模(3.2.2节)的发展,特别是过程奖励模型。该模型提供逐步监督,以识别和纠正推理过程中的错误。通过模仿人类推理,过程奖励模型确保了更可靠和可解释的结果,尤其是在数学问题解决和代码生成等任务中,在这些任务中逐步评估至关重要。
此外,强化学习本身是推理大语言模型的强大工具(3.2.5节)。通过奖励机制,强化学习引导基础大语言模型找到最优解,特别是在动态推理问题中。其简单性和效率使强化学习对于训练和优化推理大语言模型非常宝贵,增强了人工智能模型的智能和自我进化能力。强化学习的集成导致了推理大语言模型的重大进展,如DeepSeek-R1[31]所示,提供了更灵活和高效的解决方案。
3 构建推理大语言模型
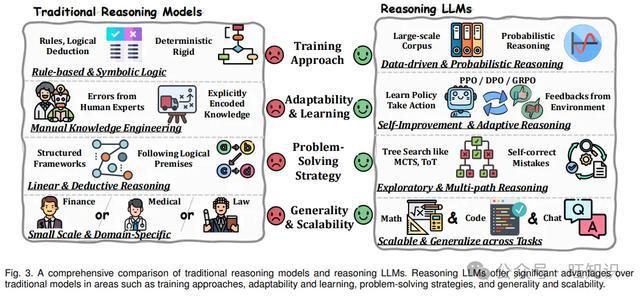
在本节中,我们首先从输出行为和训练动态的角度分析推理大语言模型的特征。然后,我们详细概述实现其高级推理能力的核心方法。最后,我们总结推理大语言模型的演进。传统推理模型和推理大语言模型的全面比较如图3所示。
3.1 推理大语言模型的特征分析
3.1.1 输出行为角度
探索和规划结构:最近的实证研究表明,推理大语言模型在输出结构中表现出强烈的探索行为倾向,特别是与主要依赖传统思维链(CoT)推理方法的模型(如WizardMath[109]和DeepSeekMath[110])相比。这种探索行为在提出新颖假设和寻求替代解决方案路径方面很明显。[49]的研究表明,慢思考模型参与了一个潜在的生成过程,在预测后续标记时尤为明显。[31]的研究支持了这一观点,该研究观察到在强化学习规模训练期间自然会出现类似行为。此外,Quiet-STaR框架[111]引入了一个专注于下一令牌预测的辅助预训练阶段,突出了在内容生成之前内部思考和探索机制的关键作用。这些发现共同强调了先进大语言模型推理过程的复杂性和动态性,强调了在其操作框架内探索与结构化推理之间的相互作用。
验证和检查结构:对OpenAI的o1[29]和o3[30]模型的分析表明,它们的推理框架既包含用于长期战略规划的宏观层面行动,也包含微观层面行动,如 “等待”“稍等”“或者”“让我们暂停一下” 等。这些微观行动有助于细致的验证和迭代检查过程,确保任务执行的精确性。这种双层方法突出了模型在平衡总体目标与细致、注重细节的操作方面的能力,从而提高了其整体功能和可靠性。为了模仿这一特点,Marco-o1[112]在构建长思维链(Long-CoT)的蒙特卡洛树搜索过程中,为每个树节点赋予 “等待!也许我犯了一些错误!我需要重新思考” 的状态,从而促进了长思维链的反思性。华佗o1(Huatuo-o1)[113]采用多智能体框架,通过在验证过程中加入具有 “回溯” 和 “纠正” 功能的提示,来解决思维链生成不正确的问题。
更长的推理长度和时间:最近的研究[49-52,114]表明,推理大语言模型通常会生成超过2000个令牌的输出,以解决编码和数学领域的复杂问题。然而,这种较长的输出长度有时会导致过度思考,即模型在一个问题上花费过多时间,却不一定能改进解决方案。研究[49]强调,虽然自回归生成和经典思维链可以有效地解决较简单的问题,但在处理更复杂的任务时却遇到困难。研究[115,116]表明,在多模态领域,许多问题需要仔细观察、比较和思考。此外,Search-o1[117]认为,慢思考机制在需要外部知识或可能出现知识冲突的领域特别有益。在医疗场景中,复杂问题(如需要测试时缩放技术的问题)显示出显著的改进[52]。
过度谨慎与简单问题陷阱:目前,推理大语言模型在竞争级数学[31,54,118,119]、复杂编码[120]、医学问答[52,113]和多语言翻译[112,121]等领域表现出强大的性能。这些场景要求模型对问题进行细粒度分析,并根据给定条件进行仔细的逻辑推理。有趣的是,即使对于像 “2+3=?” 这样简单的问题,推理大语言模型也可能表现出过度自信或不确定性。最近的研究[122]指出,类似o1的模型在处理较简单的数学问题时,倾向于生成多个解决方案轮次,经常探索不必要的路径。这种行为与在处理简单问题时缺乏多样化的探索行动形成对比,表明模型的推理过程可能存在效率低下的问题。
3.1.2 训练动态角度
惊人的数据效率:与传统方法侧重于扩展具有均匀分布难度级别的指令集不同,研究[52,54]表明,构建侧重于困难样本的慢思考思维链数据集,在医学和数学等领域能带来更好的泛化能力。这种方法与收集多样化且均匀分布的指令数据集的传统做法不同。
稀疏训练方法:与传统观点相反,开发有效的推理大语言模型并不需要大量的数据集或密集的奖励信号。例如,STILL2[51]仅使用5000个蒸馏样本就展示出了令人印象深刻的性能,而Sky-T1[119]仅使用17000个长思维链样本就达到了与QwQ[118]相当的性能。同样,RedStar[54]仅使用4000个核心长思维链样本,就在文本和多模态任务中取得了优异的结果。与简单思维链相比,慢思考监督微调(SFT)数据表现出显著的样本效率,通常仅用1/100的样本量就能产生可比的结果。此外,研究[123]强调了在线强化学习缩放算法的巨大训练潜力,表明非密集的强化学习监督甚至基于规则的奖励结构,就足以实现高性能。
参数特征:以长思维链方法为特征的慢思考大语言模型训练,会导致不同层的梯度范数相对均匀。相比之下,以简化思维链方法为代表的快思考,在早期层产生更大的梯度幅度,并且层间梯度范数存在显著差异。实证证据表明,更大的模型,尤其是超过300亿参数的模型,更适合推理大语言模型的训练,因为它们具有更强的复杂推理能力。此外,RedStar[54]进行的实验表明,数据缩放的好处因模型大小而异,在更大的模型中缩放效应更为明显和有效。Deepseek-R1的研究[31]支持了这一发现,该研究表明,一个6700亿参数的模型实现的性能指标与o1基准非常接近,突出了更大架构在高级推理任务中的可扩展性优势。
3.2 核心方法
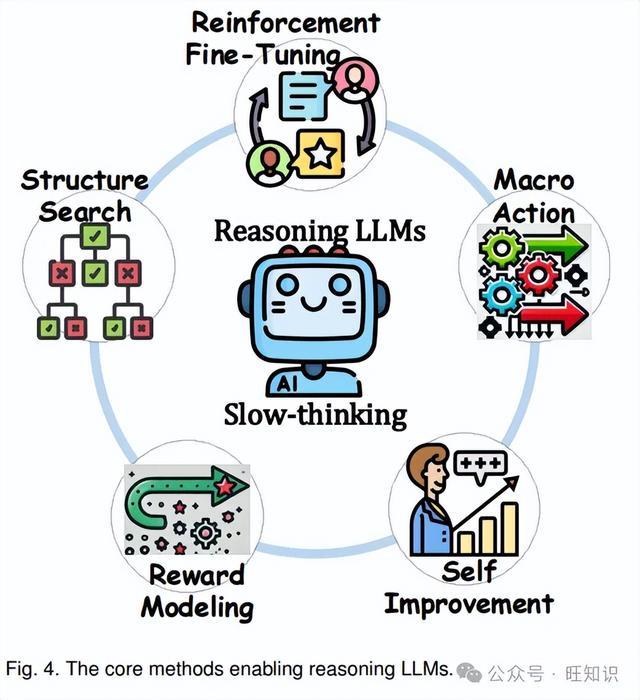
在本节中,我们概述了推动推理大语言模型高级推理能力的核心方法,如图4所示。这些方法包括结构搜索、奖励建模、自我改进、宏观行动和强化微调。我们还突出了每种方法的代表性推理大语言模型。
3.2.1 结构搜索
推理大语言模型旨在通过模仿人类推理的审慎性,在解决复杂问题时实现高精度和深度。然而,尽管最近取得了进展,当前的基础大语言模型在处理复杂推理任务时仍面临固有局限性。这些局限性源于它们缺乏内部世界模型来模拟环境状态,无法预测推理路径的长期结果,以及无法根据未来状态或奖励迭代优化推理步骤[8]。因此,这些缺点阻碍了基础大语言模型在广阔的推理空间中有效平衡探索和利用,给需要多步推理的任务(如复杂数学、逻辑推理或战略决策)带来了挑战[139]。
蒙特卡洛树搜索(MCTS)是一种强大的搜索和优化算法,它通过提供一个结构化框架来系统地探索和评估推理路径,有效地应对了这些挑战。它通过构建推理树来运作,其中每个节点代表一个推理状态,行动通过考虑潜在的下一步来扩展树。通过模拟未来状态和迭代反向传播估计的奖励,蒙特卡洛树搜索使基础大语言模型能够有效地识别高奖励的推理路径,反映了人类的规划过程。这种方法符合推理大语言模型的核心原则,即深入分析和审慎探索对于生成合理的输出至关重要。最近的方法,如RAP[14],通过将蒙特卡洛树搜索与世界模型相结合来增强基础大语言模型,使系统能够迭代优化中间推理步骤并改进未来预测。同样,思维森林(Forest-of-Thought)[125]利用蒙特卡洛树搜索动态探索多个推理轨迹,重新审视有缺陷的路径并优化结果。
蒙特卡洛树搜索在推理任务中的应用,已从传统的问题解决扩展到高度专业化的领域。例如,SRA-MCTS[134]和MC-NEST[133]等框架展示了蒙特卡洛树搜索在应对代码生成和数学推理等技术挑战方面的效用,在这些领域中,中间步骤被迭代评估和优化。在教学对齐领域,SPaR[127]和Marco-o1[112]等框架利用蒙特卡洛树搜索来优化响应,并使推理轨迹与人类偏好或期望结果保持一致。此外,像HuatuoGPT-o1[113]这样的特定任务实现,强调了蒙特卡洛树搜索在导航高度专业化领域(如医学推理)中的关键作用,在该领域中,准确性和稳健性至关重要。
蒙特卡洛树搜索还使模型超越了单遍推理方法,如思维链或思维树,通过纳入动态重新审视、批判和优化推理步骤的机制[131,140]。这种迭代能力对于处理具有广阔决策空间的任务或需要长期规划的任务至关重要,在这些任务中,早期决策会对最终结果产生重大影响。通过允许大语言模型模拟、评估和优化多个推理路径,蒙特卡洛树搜索引入了传统方法所缺乏的适应性和战略探索水平。如类似AlphaZero的树搜索[124]和Searcho1[117]所示,蒙特卡洛树搜索使推理大语言模型不仅在特定任务上实现更好的性能,还能在不同领域展示出更强的泛化能力。
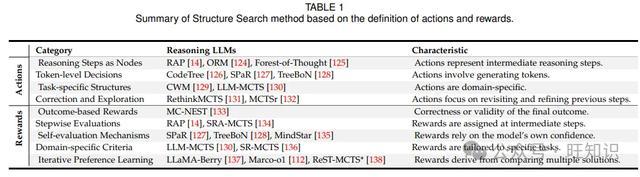
将蒙特卡洛树搜索集成到大语言模型中,取决于定义行动和奖励,以指导推理路径探索和评估质量。如表1所示,我们将先前工作中的行动分为四类:
推理步骤作为节点:行动代表中间推理步骤或决策,如选择规则、应用转换或生成子问题[14,124,125,139]。
令牌级决策:行动涉及生成令牌或序列(例如,下一个单词、短语或代码片段)[126-128,141]。
特定任务结构:行动是特定领域的,如在积木世界中移动积木、在几何问题解决中构建几何图形或在任务规划中修改工作流程[129,130,142]。
自我纠正和探索:行动侧重于重新审视、优化或回溯以改进先前的推理步骤[131,132,143]。
此外,如表1所示,我们将奖励设计分为五类:
基于结果的奖励:奖励侧重于最终结果或解决方案的正确性或有效性,包括推理路径的验证或任务的成功[133,139,142]。
逐步评估:根据每个步骤的质量或其对最终结果的贡献,在中间步骤分配奖励[14,124,134]。
自我评估机制:奖励依赖于模型自身的置信度或自我评估(例如,可能性、下一个单词的概率或置信度分数)[127,128,135]。
特定领域标准:奖励是针对特定任务定制的,如几何中的对称性和复杂性,或文本生成中与人类偏好的一致性[130,136,142]。
迭代偏好学习:奖励来自比较多个解决方案或推理路径,动态指导学习[112,137,138]。
总结:尽管基于结构搜索(即蒙特卡洛树搜索)的推理大语言模型具有优势,但由于需要大量模拟,它们通常会承受巨大的计算负担。这使得它们不太适合需要实时决策或在资源受限环境下运行的任务[144]。此外,蒙特卡洛树搜索的有效性高度依赖于精心设计的奖励机制和行动定义,这些在不同领域可能差异很大,从而对其通用性构成挑战[145]。
3.2.2 奖励建模
处理多步推理任务主要有两种训练范式:结果监督和过程监督。结果监督在更高的粒度上强调最终答案的正确性,由此产生的模型称为结果奖励模型(ORM)[32,158]。相比之下,过程监督为解决方案轨迹提供逐步标签,评估每个推理步骤的质量。由此产生的模型称为过程奖励模型(PRM)[37,159,160]。ORM和PRM之间的主要区别如图5所示。
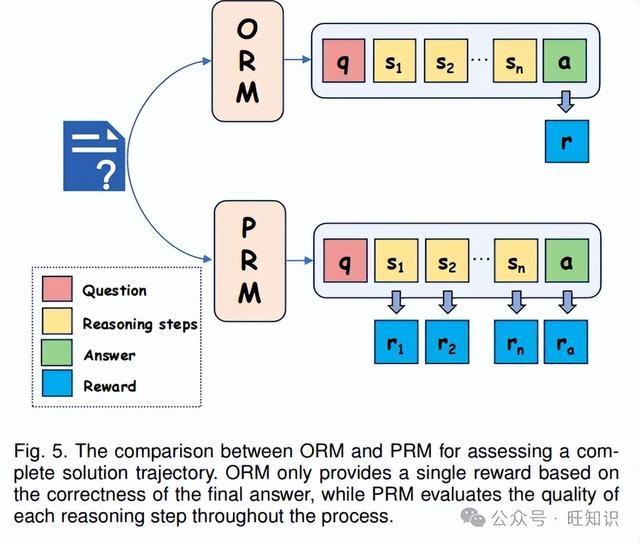
在复杂推理任务中,PRM具有显著优势[147,161],原因有几个关键方面。首先,它提供细粒度的逐步监督,允许识别解决方案路径中的特定错误。这一特性对于强化学习和自动错误纠正特别有价值。其次,PRM紧密模仿人类推理行为,人类推理依赖准确的中间步骤来得出正确结论。与ORM不同,PRM避免了不正确的推理仍可能导致正确最终答案的情况,从而确保更可靠和可解释的推理。虽然PRM主要应用于复杂的数学问题,但它的优势最近推动了其在其他领域的应用。例如,ORPS[155]利用PRM来应对复杂的代码生成挑战,而Step-DPO[156]将过程监督与直接偏好优化(DPO)算法[162]相结合,以改进长链数学推理。奖励建模方法的总结见表2。
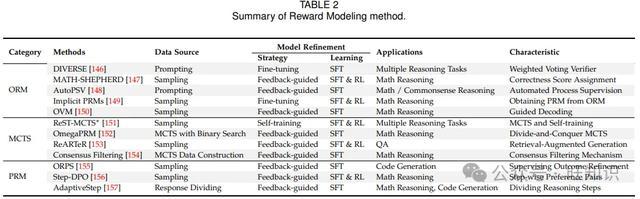
总结:尽管PRM具有优势,但它们也带来了一些挑战。主要困难在于获取过程监督标记的数据,这通常既昂贵又耗时。为了解决与可扩展性、效率和准确性相关的问题,研究人员探索了各种自动注释方法。例如,MATH-SHEPHERD[147]利用最终答案的正确性,根据中间步骤导致正确结果的潜力来定义其质量,从而自动化逐步数据收集过程。ReST-MCTS∗[151]将过程奖励指导与蒙特卡洛树搜索相结合,通过广泛的滚动生成更高质量的推理轨迹。同样,OmegaPRM[152]采用蒙特卡洛树搜索框架,同时引入分治算法来自动生成过程监督数据。另一种新颖的方法是使用ORM来训练PRM。Yuan等人[149]提出在温和的奖励参数化假设下,通过在更便宜的数据集上利用ORM训练来隐式训练PRM。他们还为这种隐式PRM的性能提供了理论保证,证明了其实际可行性和成本效益。
除了数据收集,PRM还面临与可信度相关的挑战,分类如下:
缺乏解释:当前的PRM通常为推理步骤生成分数,但没有充分的解释,这限制了其可解释性,并阻碍了在测试时改进推理的实用性。
训练数据中的偏差:数据收集方法(如蒙特卡洛树搜索)往往会引入分布偏差,给大多数问题分配不成比例的高分。因此,PRM难以有效识别错误的推理步骤。
早期步骤偏差:与接近最终答案的步骤相比,PRM在预测早期推理步骤的奖励时准确性较低。这个问题源于推理过程初始步骤中增加的随机性和不确定性。
3.2.3 自我改进
推理大语言模型体现了从弱监督到强监督的发展,而传统的思维链微调在有效扩展方面面临挑战。自我改进利用模型的探索能力进行自我监督,逐渐提高大语言模型在翻译[167]、数学[163,168]和多模态感知[171]等任务中的性能。这种方法促进了推理大语言模型中的探索和应用[166,184-186]。自我改进方法的总结见表3。
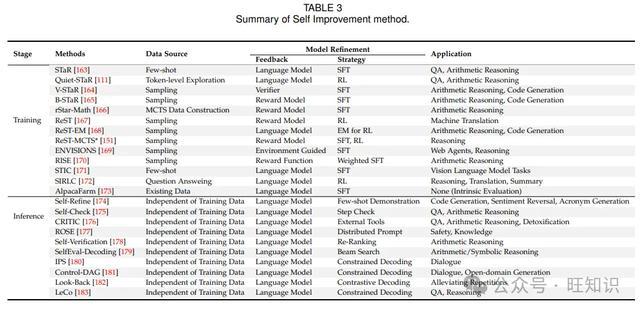
大语言模型中基于训练的自我改进,可以根据探索和改进策略进行分类。探索阶段侧重于数据收集,以促进后续的训练改进,方法上有显著差异。STaR[163]使用少样本示例进行数据收集,而ReST[167]、ReST-EM[168]和ENVISIONS[169]依赖于对完整轨迹的多次采样。Quiet-STaR[111]在令牌级别进行探索,引入了元令牌和非近视损失等概念来增强监督。此外,ReST-MCTS*[151]和rStar-Math[166]通过蒙特卡洛树搜索生成训练数据。
改进策略也表现出显著的多样性。例如,STaR及其衍生模型(如V-STaR和B-STaR[165])将过滤与监督微调相结合。ReST及其变体通常引入创新的奖励计算方法,以增强策略模型的强化学习训练。RISE[170]纳入外部反馈,在改进过程中记录奖励并通过蒸馏优化响应。值得注意的是,rStar-Math[166]表明,小模型通过自我进化的训练方法实现了系统2的反思能力。
测试时自我改进利用模型内部知识的一致性,在推理过程中纠正幻觉。这些方法可以分为三大类:使用提示优化答案的方法[174,175]、利用外部工具的方法[176],以及无需外部工具或提示即可利用对数几率的技术[182,183]。
3.2.4 宏观行动
最近大语言模型的进展,通过复杂的思维架构(通常称为宏观行动框架),推动了对类人系统2认知过程的模拟。这些结构化推理系统超越了传统的令牌级自回归生成,引入了分层认知阶段,如战略规划、内省验证和迭代优化。这种方法不仅增强了推理的深度,还拓宽了解决方案空间,实现了更强大和多样化的问题解决途径。宏观行动方法的总结见表4。
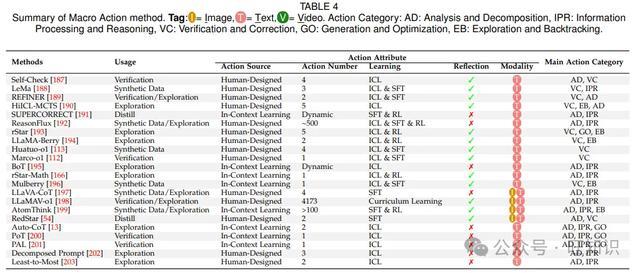
我们将宏观行动的进展分为两个方面:
通过宏观行动操作实现测试时缩放:最近的研究确定了两种关键方法,用于在推理和测试时缩放中提高推理性能。HiICL-MCTS[190]通过对种子数据进行审慎搜索,生成由宏观行动组成的行动链模板,从而促进了一种由行动链引导的测试时推理方法。ReasonFlux[192]利用迭代测试时缩放框架,利用外部高级思维模板迭代优化和更新当前思维链。
宏观行动增强的数据合成范式:宏观行动在复杂推理中的一个关键应用是推理数据的合成。在数据合成和训练框架中,宏观行动架构增强了推理的多样性和泛化能力。最近的研究表明,在推理序列中集成或合成思维链过程与宏观行动,可以显著提高推理链的数据效率。例如,LLaVA-CoT[197]通过跨多种模态外化中间推理步骤,增强了思维链数据合成。AtomThink[199]使用结构化的g1提示[204]生成AMATH-SFT数据集,与传统思维链方法相比,在长视野推理任务中实现了卓越的性能。CoAct[205]引入了一种双智能体协作推理框架,其中全局规划智能体执行总体宏观行动,而局部执行智能体在这些更广泛的行动中执行特定的子行动。
宏观行动在增强自我改进框架方面也起着关键作用。rStar-Math[166]通过对代码增强的思维链进行高级审慎搜索,生成多样化且可靠的解决方案,同时实现主动搜索能力。Satori[206]将思维链与强化学习相结合,融入“反思”式宏观行动,以多样化探索并缓解在线强化学习环境中的策略饱和问题。Huatuo-o1[113]将分层规划与特定领域知识库相结合,以改进医学推理。此外,ReasonFlux[192]动态重新配置推理模板(例如,将微积分问题分解为符号和数值阶段),使其与问题结构保持一致。
3.2.5 强化微调
强化微调(RFT)[207]是OpenAI最近推出的一种创新技术,旨在使开发人员和工程师能够针对特定领域或复杂任务对现有模型进行微调。与一般的监督微调不同,强化微调侧重于通过使用奖励机制来引导模型的进化,从而优化模型的推理过程,进而提高其推理能力和准确性。强化微调的核心在于,利用最少的高质量训练数据[208]、合适的奖励模型[209]以及在长上下文环境中稳定的优化过程[210-213],来提升模型在特定领域的性能。强化微调方法的总结见表5。采用基于验证器奖励策略的DeepSeek-R1[31],与SoS[214]等传统方法相比,性能有了显著提升。其主要优势包括:
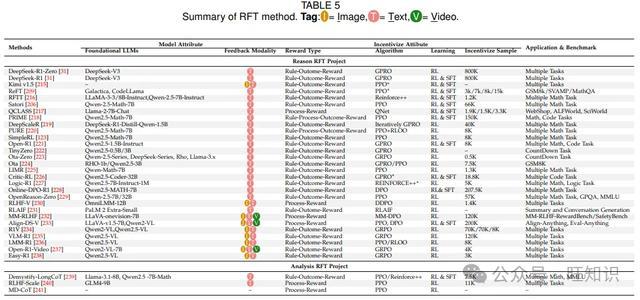
简化训练流程:强化学习监督简化了数据构建和训练过程,无需复杂的逐步搜索机制。
增强可扩展性:在线强化学习训练有助于在大型数据集上高效扩展,特别是对于复杂的推理任务。
涌现特性:DeepSeek-R1[31]展现出独特的涌现能力,例如长思维链推理,这是仅通过监督微调难以实现的。
尽管有这些优势,强化微调也面临以下挑战:
推理背后的机制不明:DeepSeek-R1推理能力提升的潜在机制仍未得到充分理解。例如,虽然DeepSeek-R1展现出涌现特性(如“涌现长度增加”“顿悟时刻”),但[242]等研究表明,像长思维链这样的能力可能已经存在于基础模型中,并非完全源于强化学习训练。此外,在较小的模型(如Qwen-Math2B/7B[243])中观察到的性能提升,并没有明显的“顿悟时刻”,这使得因果关系的解释变得复杂。
奖励模型饱和:许多现有的强化学习算法面临奖励模型饱和问题,通常表现为在大约100个训练步骤后探索崩溃。尽管DeepSeek-R1通过专门的奖励格式化缓解了这个问题,但ReFT[209]和Satori[206]等方法提出交替采样和监督微调蒸馏,以应对奖励作弊和探索崩溃问题。
长思维链生成不稳定:强化微调生成的长推理链容易出现不稳定情况,包括上下文溢出、无法返回最终答案以及对奖励塑造的敏感性[122]。例如,[239]等方法无意中引入了余弦奖励函数,随着迭代次数的增加,性能会下降。O1-Prune[244]使用事后长度修剪技术[215](通过强化学习/监督微调)来稳定输出。
强化微调的未来方向可能包括几个令人兴奋的创新进展,例如:
高效稳定的强化学习框架:需要开发更强大的强化学习算法,以防止奖励饱和和探索崩溃。[239]表明,REINFORCE++[245]与KL散度正则化结合时表现不佳,这表明需要替代方法。未来的工作应该在现代大语言模型训练的背景下重新审视经典的强化学习算法,以优化稳定性和效率。
扩展强化微调:当前的强化学习监督模型依赖于从大规模数据集中精心挑选的、可验证的提示。未来的研究应专注于合成高质量、多样化的提示,以提高泛化能力。[240]表明,仅仅缩放策略/奖励模型或增加样本数量会导致收益递减,而扩展过程奖励模型和R1训练数据的范围更有前景。应该探索混合方法,如将强化学习与监督微调或课程学习相结合,以增强可扩展性。
控制长思维链的稳定性:需要自适应的奖励塑造机制来平衡推理长度、连贯性和答案正确性。O1-Prune[244]等技术展示了事后来度正则化的价值,但动态的训练中控制是必要的。应该研究分层强化学习框架,将长推理链分解为可管理的子任务,以减少不稳定性。
理论和实证分析:必须明确强化学习训练与基础模型能力之间的关系。例如,应该确定涌现特性(如长思维链)是源于强化学习优化,还是基础模型的潜在特征。应该对奖励设计原则(如稀疏奖励与密集奖励、多目标平衡)进行系统研究,以避免诸如奖励作弊等意外行为。
总结:强化微调为推进大语言模型的推理提供了一个有前景的方向,DeepSeek-R1[31]就是证明。然而,奖励饱和、长推理链不稳定以及涌现机制不明确等挑战需要迫切关注。未来的努力应优先考虑算法创新、可扩展的提示合成和理论基础,以充分释放强化学习驱动的推理大语言模型的潜力。
3.3 推理大语言模型的演进
推理大语言模型的演进经历了几个不同的阶段,人们开发了各种策略来克服直接自回归推理的局限性,并构建更先进的慢思考推理架构。
在早期阶段,推理大语言模型主要侧重于通过外部推理算法来增强预训练的大语言模型,而不改变底层模型参数。像思维树(Tree of Thoughts)[265]和通过规划推理(Reasoning via Planning)[14]等方法,利用大语言模型驱动的广度优先搜索、深度优先搜索和蒙特卡洛树搜索[98,125,128,266]来模拟人类的推理过程。这些方法将推理表示为树或图的遍历,其中中间推理状态被描绘为节点,各种推理策略产生不同的推理路径。最终决策通过额外的投票机制[3]或基于蒙特卡洛的价值估计来确定,以识别最优路径。
然而,这些外部化的慢推理方法带来了一些挑战:
探索空间有限:基于搜索的方法需要对搜索空间的广度、深度和粒度进行预定义的约束,这通常将大语言模型的探索限制在一个狭窄的推理空间内。此外,同一父节点的不同子节点之间的推理策略往往缺乏足够的多样性,进一步限制了探索。
经验共享有限:不同路径之间的探索经验和推理信息只能基于奖励模型或结果之间的自一致性进行评估。此外,基于搜索的方法显著增加了计算开销,依赖于如过程奖励模型/结果奖励模型(PRM/ORM)等奖励模型进行树剪枝或推测解码技术来加速推理。
为了克服这些限制,随后的模型,如rSTaR[193]、LLaMAV-o1[198]、HiICL-MCTS[190]、Mulberry[196]、g1[204]和Thinking-Claude[267]引入了更丰富的行动空间。这些增强的行动空间提供了高级规划线索,拓宽了模型的探索范围,实现了更全面的结构化搜索过程。然而,这种方法需要对行动空间进行仔细设计,以确保其有效性。
随着o1[29]和QwQ[118]等模型的出现,外部推理范式被内化到大语言模型的上下文中。这些模型最初进行探索性的宏观规划,以生成初始推理路径,然后对替代路径进行上下文探索。通过“重新思考”和“验证”等机制,这些模型产生了更长的推理链。为了复制这种内化能力,STILL-1[266]将树搜索输出线性化为具有“重新思考”“等待”和“探索新路径”等属性的长推理链。同样,STILL-2[53]和sky-T1[119]使用蒸馏技术合成长推理链。然而,基于搜索方法线性化的推理链在质量上难以与蒸馏方法产生的推理链相媲美。
最近的进展,包括DeepSeek-R1[31]和Kimi-k1.5[215],展示了强化学习增强如DeepSeek-V3[17]等模型的潜力,导致了长推理链、反思性推理和高级规划能力等复杂行为的出现。值得注意的是,这些复杂行为是通过简单的强化学习扩展实现的。SimpleRL[123]试图使用简化的管道和最小的代码库来复制这些能力,而R1V[234]则探索了基于多模态基础架构的多模态推理模型的开发。
总结:推理大语言模型的演进已从外部增强推理转向内部嵌入推理。最近的发展强调了基于强化学习的扩展在解锁高级能力方面的潜力。
4 推理大语言模型的基准测试
开发一个强大的基准对于记录推理大语言模型能力的进步以及确定未来有前景的研究方向至关重要。在这里,我们从三个关键方面回顾基准测试:类别、评估指标和性能比较,同时提供我们的思考和见解。
4.1 基准测试类别
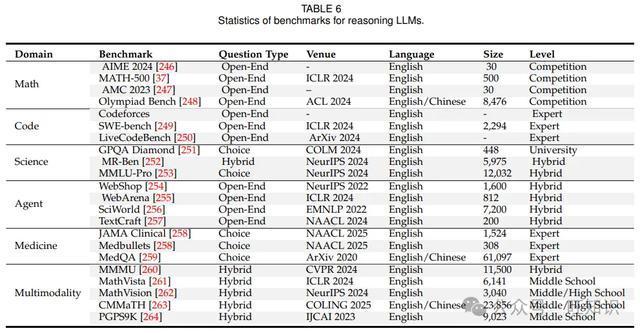
我们根据任务类型对推理基准进行分类,大致可分为数学、代码、科学、智能体、医学和多模态推理。这些基准的详细统计信息见表6。
4.1.1 基准测试介绍
数学问题:我们记录当前流行的竞赛级数学基准,以展示推理大语言模型的能力,包括2024年美国数学邀请赛(AIME 2024)[246]、MATH-500[37]、2023年美国数学竞赛(AMC 2023)[247]和奥林匹克基准(Olympiad Bench)[248]。
代码问题:代码问题需要坚实的基础和较高的逻辑思维能力,以评估推理大语言模型的推理能力,如Codeforces、软件工程师基准(SWE-bench)[249]和实时编码基准(LiveCodeBench)[250]。
科学问题:科学基准,如研究生水平谷歌-proof问答基准(GPQA Diamond)[251]和多任务语言理解专业版(MMLU-Pro)[253],涉及化学、生物学和物理学等多领域的推理,这需要广泛的知识积累和综合推理能力。
智能体推理:现实任务通常涉及复杂的规划和工具使用,这导致了智能体推理基准的创建[268]。例如,WebShop[254]和WebArena[255]专注于网络操作,而SciWorld[256]和TextCraft[257]则围绕科学研究展开。
医学推理:医学从根本上涉及复杂的推理,涵盖从诊断决策到治疗规划等任务。《美国医学会杂志》临床挑战(JAMA Clinical Challenge)[258]、医学子弹(Medbullets)[258]和医学问答(MedQA)[259]等基准提供了模拟医生疾病诊断的模型测量。
多模态推理:多模态推理,如大规模多学科多模态理解与推理基准(MMMU)[260]和数学视觉基准(MathVista)[261],需要结合文本和图像的跨模态思维。特别是对于那些以视觉为中心的问题,在MathVision[262]、MathVerse[269]、中文多模态数学技能评估基准(CMMaTH)[263]和PGPS9K[264]等基准中,对推理大语言模型提出了更高的要求。
4.1.2 总结
近年来,大语言模型领域发展迅速,基准测试性能不断提高。简单的推理基准,如GSM8K[32]、MATH-500[37]和科学问答(ScienceQA)[270],已接近性能饱和。最近对推理大语言模型的研究[54,166]表明,为长推理链设计的模型在这些基准上,并不比为短推理链设计的模型表现好很多。这凸显了建立新基准的迫切需求,以便更有效地评估推理大语言模型的推理能力。此外,当前的基准存在局限性,主要侧重于确定性推理任务。软推理基准缺乏明确定义的正确答案,提供了更细致的评估,能更好地捕捉类人推理的复杂性和微妙之处。此外,解决评估过程中的数据泄露问题也至关重要[271]。确保评估数据的保密性和中立性,对于维护基准测试结果的完整性和可靠性至关重要。
4.2 评估指标
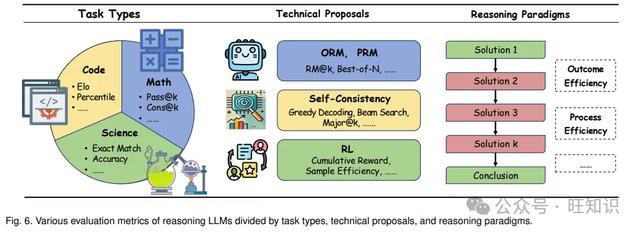
根据任务类型、技术方案和推理范式,为推理大语言模型引入了各种评估指标,如图6所示。这些指标旨在更准确地评估模型在处理复杂推理任务中的性能,确保有效衡量生成解决方案的质量和连贯性。
4.2.1 任务类型
在基准测试类别方面,数学推理通常使用两个主要指标:Pass@k和Cons@k。Pass@k指标评估模型在k次尝试内生成正确解决方案的能力,衡量在有限次数尝试内成功的可能性。另一方面,Cons@k评估模型是否始终生成正确或逻辑连贯的解决方案,突出其推理能力的稳定性和可靠性。对于代码任务,关键指标是Elo和Percentile,这两个指标都衡量与其他模型或人类程序员相比,生成正确代码的相对技能。在科学任务中,评估通常分别使用精确匹配(EM)和准确率来评估填空题和选择题。EM指标判断模型的输出是否与预期解决方案完全匹配,而准确率衡量正确答案在总问题数中的比例。
4.2.2 技术方案
基于技术路线,采用结果奖励模型(ORM)或过程奖励模型(PRM)的方案通常利用RM@k和Best-of-N这两个评估指标。RM@k衡量奖励模型是否能根据奖励分数,在k个候选答案中把好的答案排在前面,而Best-of-N从N个生成的推理轨迹中选择得分最高的解决方案。自一致性方法使用贪心解码、束搜索和Major@k进行评估。贪心解码和束搜索通过限制采样范围来控制推理过程的随机性。Major@k从k个候选解决方案中选择结果最一致的解决方案。在强化学习中,指标既反映实现期望结果的性能,也反映学习过程的效率。例如,累积奖励衡量智能体随时间收到的总奖励,而样本效率评估智能体在学习过程中样本使用的效率。
4.2.3 推理范式
对于推理大语言模型中多轮解决方案生成的推理范式,最近提出了结果效率和过程效率[122],以专门评估长思考的效率。结果效率指标通过实证评估后续解决方案对提高准确性的有效程度,计算为对得出正确答案有贡献的有效令牌数与所有输出令牌数的比率。过程效率指标通过实证评估后续解决方案对解决方案多样性的贡献,具体表示为不同解决方案的令牌数与所有解决方案令牌数的比率。这两个指标在一定程度上揭示了现有推理大语言模型对简单问题的过度思考问题。
4.2.4 总结
现有的评估指标大多根据最终答案进行判断。鉴于推理计算消耗大,开发一个综合考虑推理过程各个方面的评估框架势在必行。当前流行的评估框架,如大语言多模态模型评估(LMMs-Eval)[278]、OpenCompass[279]和过程奖励模型基准(PRMBench)[280],缺乏效率,其指标也没有充分考虑推理过程的计算和时间效率。为了解决这些缺点,我们强烈建议探索更有效的代理任务作为潜在解决方案。通过识别和利用能更好捕捉长推理链细微差别的任务,我们可以开发更强大和有效的评估指标,以增强整体评估框架,确保它不仅能衡量最终输出的准确性,还能评估整个推理过程的效率和连贯性。
4.3 性能比较
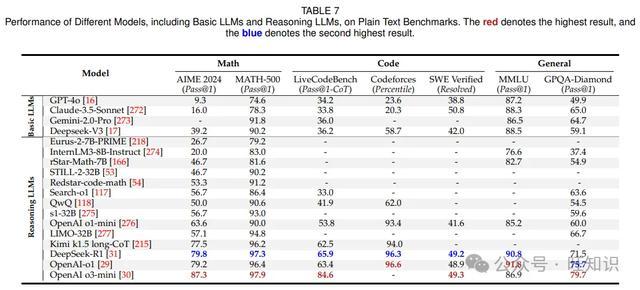
在本节中,我们比较不同推理大语言模型及其相应基础大语言模型在纯文本基准(如数学和代码问题)以及多模态基准上的性能。全面的实时排行榜可在Arena上查看。
4.3.1 纯文本基准上的性能
如表7所示,像DeepSeek-R1[31]和OpenAI-o1/o3[29,30]等推理大语言模型,在包括数学、编码和其他一般任务在内的广泛任务中表现出色。这些模型在多个纯文本基准(如AIME 2024、MATH-500和LiveCodeBench)上取得了高分,展示了它们强大的基于文本的推理能力。相比之下,基础大语言模型,如GPT-4o[62]、Claude-3.5-Sonnet[272]和DeepSeek-V3[17],在数学和编码任务(如AIME 2024和Codeforces)中,通常比推理大语言模型表现较差。例如,OpenAI-o1在这些任务上分别比GPT-4o高出69.9%和73%。此外,基于DeepSeek-V3架构的DeepSeek-R1,在所有基准上都超过了其前身,进一步凸显了推理大语言模型的优势。
4.3.2 多模态基准上的性能
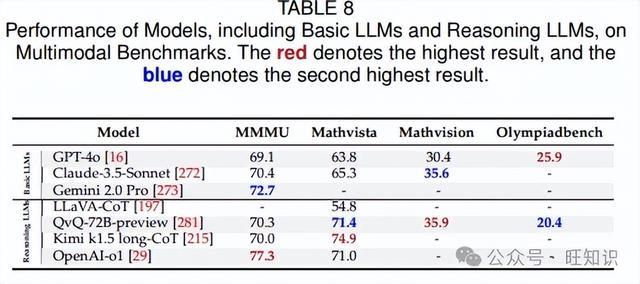
如表8所示,推理大语言模型在多模态任务中继续表现出色。OpenAI-o1[29]在视觉任务中表现强劲,在MMMU上获得了77.3%的最高分,在MathVista上比其相应的基础大语言模型GPT-4o[62]高出7.2%。然而,与纯文本任务相比,多模态任务中的性能提升并不那么明显。这部分归因于当前多模态推理大语言模型技术的局限性,以及缺乏足够的数据集来全面评估推理大语言模型的多模态能力。
4.3.3 总结
总之,推理大语言模型在纯文本和多模态基准上都表现出强大的性能,在数学和编码任务中尤其出色,在这些任务中它们比基础大语言模型有很大优势。尽管在多模态任务中的改进不如纯文本任务明显,但推理大语言模型仍然优于其对应的基础模型,凸显了它们处理图像和文本数据的潜力。这些结果强调了推理大语言模型在广泛的推理任务中的通用性和有效性,以及在多模态推理技术方面进一步发展的潜力。
5 挑战与未来方向
尽管推理大语言模型发展迅速,但仍存在一些挑战,限制了它们的通用性和实际应用。本节将概述这些挑战,并突出解决这些问题的潜在研究方向。
5.1 高效的推理大语言模型
虽然推理大语言模型通过扩展推理在解决复杂问题方面表现出色,但它们在大规模架构中依赖长自回归推理,这带来了显著的效率挑战。例如,在Codeforces等平台上,许多问题需要超过10,000个词元的推理,导致延迟较高。正如[122]中所指出的,即使推理大语言模型很早就识别出了正确的解决方案,它通常也会花费大量时间来验证其推理过程。最近的报告,如关于Deepseek-R1[31]的报告表明,通过强化学习进行自我改进在较大的模型中更有效,而较小规模的大语言模型(SLMs,例如[123]、[222]和[239]所研究的30亿和70亿参数模型)在慢思考推理任务中难以达到相同的性能。
未来的研究应集中在两个关键领域:第一,集成外部推理工具,以实现早期停止和验证机制,从而提高长推理链的效率;第二,探索在不牺牲性能的情况下,在较小规模大语言模型中实现慢思考推理能力的策略。
5.2 协同的慢思考和快思考系统
推理大语言模型面临的一个关键挑战是快思考能力的缺失,这导致在简单任务需要不必要的深度推理时效率低下。与人类能够灵活地在快思考(系统1)和慢思考(系统2)之间切换不同,当前的推理大语言模型难以保持这种平衡。虽然推理大语言模型确保了审慎和全面的推理,但快思考系统依赖先验知识来快速做出响应。尽管有诸如系统1 - 2切换器[115]、推测解码[282-284]和交互式持续学习[285-287]等尝试,但整合这两种思考模式仍然具有挑战性。这通常会导致在特定领域任务中的效率低下,以及在更复杂场景中未能充分发挥优势。
未来的研究应专注于开发自适应切换机制、联合训练框架和共同进化策略,以协调快思考系统的效率和推理大语言模型的精确性。实现这种平衡对于推动该领域的发展以及创建更通用的人工智能系统至关重要。
5.3 用于科学研究的推理大语言模型
推理大语言模型在科学研究中发挥着至关重要的作用[288],能够进行超越基于启发式的快思考模型的深度、结构化分析。它们的价值在需要复杂推理的领域,如医学和数学中尤为明显。在医学领域,特别是在鉴别诊断和治疗规划方面,推理大语言模型(例如推理时缩放技术)增强了人工智能的逐步推理能力,在传统缩放方法不足的地方提高了诊断准确性[52]。在数学领域,像FunSearch[289]这样的方法结合了慢思考原则,推动了超越先前发现的研究,展示了人工智能与人类协作的潜力。
除了这些领域,推理大语言模型还可以通过完善模型构建和假设检验,促进物理学、工程学和计算生物学的发展。投资于推理大语言模型的研究,不仅可以弥合人工智能计算能力与类人分析深度之间的差距,还为更可靠、可解释和开创性的科学发现铺平了道路。
5.4 神经与符号系统的深度融合
尽管推理大语言模型取得了显著进展,但它们有限的透明度和可解释性限制了在更复杂的现实世界推理任务中的表现。对大规模数据模式的依赖以及缺乏清晰的推理路径,使得它们难以有效地处理复杂或模糊的问题。早期的符号逻辑系统虽然适应性较差,但提供了更好的可解释性和更清晰的推理步骤,在这种情况下能带来更可靠的性能。
一个有前景的未来方向是神经与符号系统的深度融合。谷歌的AlphaGeometry[290]和AlphaGeometry2[291]将推理大语言模型与符号引擎相结合,在国际数学奥林匹克竞赛(IMO)中取得了突破。特别是AlphaGeometry2利用基于Gemini的模型[273,292,293]和更高效的符号引擎,通过减少规则集和增强关键概念处理来提高性能。该系统现在涵盖了更广泛的几何概念,包括轨迹定理和线性方程。一种新的搜索算法和知识共享机制加速了这一过程。这个系统解决了2000 - 2024年IMO几何问题的84%,超过了金牌得主的平均水平。相比之下,像OpenAI-o1[29]这样的推理大语言模型未能解决任何问题。神经与符号系统的融合提供了一种平衡的方法,提高了适应性和可解释性,在数学几何问题之外的复杂现实世界推理任务中具有巨大潜力。
5.5 多语言推理大语言模型
当前的推理大语言模型在英语和中文等高资源语言中表现良好,在翻译和各种推理任务中展示出强大的能力[112,121]。这些模型在有大量数据和多样化语言资源的环境中表现出色。然而,它们在低资源语言中的性能仍然有限[294],面临着与数据稀疏性、稳定性、安全性和整体性能相关的挑战。这些问题阻碍了推理大语言模型在缺乏大量语言数据集和资源的语言中的有效性。
未来的研究应优先克服低资源语言中数据稀缺和文化偏见带来的挑战。诸如在推理大语言模型之间共享参数以及逐步注入特定领域知识等创新方法,有助于缓解这些挑战,使慢思考能力能够更快地适应更广泛的语言。这不仅将提高推理大语言模型在这些语言中的有效性,还将确保更公平地获取先进的人工智能技术。
5.6 多模态推理大语言模型
将慢思考推理能力从基于文本的领域扩展到多模态环境仍然是一个重大挑战,特别是在需要细粒度感知的任务中[116,295,296]。虽然像Virgo[297]这样的方法试图将基于文本的慢思考推理提炼到多模态大语言模型中,但在需要详细视觉理解的任务(如MathVision[262])中,它们的性能提升甚微。
关键的研究方向包括开发分层推理大语言模型,以实现针对音频、视频和3D数据等模态独特特征的细粒度跨模态理解和生成。
5.7 安全的推理大语言模型
像OpenAI-o1[29]和DeepSeek-R1[31]等推理大语言模型的快速发展,导致了能够持续自我进化的超级智能模型的出现。然而,这一进展带来了安全和控制方面的挑战[298-300]。强化学习作为一种关键的训练方法,引入了诸如奖励作弊、泛化失败和语言混合等风险,这些都可能导致有害的结果。确保像DeepSeek-R1这样的系统的安全性迫在眉睫。虽然强化学习增强了推理能力,但其不可控的性质引发了对安全引导这些模型的担忧。监督微调解决了一些问题,但并不是一个完整的解决方案。需要一种结合强化学习和监督微调的混合方法,在保持模型有效性的同时减少有害输出。
随着这些模型超越人类认知能力,确保它们的安全、负责任和透明使用至关重要。这需要持续的研究来开发控制和引导它们行为的方法,从而在人工智能的能力与道德决策之间取得平衡。
6 结论
本文提供了一项全面的综述,推动了推理大语言模型的研究。我们首先概述了基础大语言模型的进展以及早期关键系统2技术,包括符号逻辑、蒙特卡洛树搜索和强化学习,探讨了它们与基础大语言模型结合时,如何为推理大语言模型铺平道路。然后,我们详细分析了最新推理大语言模型的特征,研究了实现其高级推理能力的核心方法,并突出了代表性模型。通过回顾主流推理基准和性能比较,我们对该领域的当前状态提供了有价值的见解。展望未来,我们确定了有前景的研究方向,并通过我们的实时GitHub存储库继续跟踪发展动态。本综述旨在激发推理大语言模型这一快速发展领域的创新,并促进其进步。
作者:张长旺,图源:旺知识
参考资料
标题:From System 1 to System 2: A Survey on Reasoning Large Language Models
作者:Zhong - Zhi Li, Duzhen Zhang, Ming - Liang Zhang, Jiaxin Zhang, Zengyan Liu, Yuxuan Yao, Haotian Xu, Junhao Zheng, Pei - Jie Wang, Xiuyi Chen, Yingying Zhang, Fei Yin, Jiahua Dong, Zhijiang Guo, Le Song, Cheng - Lin Liu
标签:大语言模型、人工智能、推理技术、系统2推理、自然语言处理
概述:文章全面综述推理大语言模型,涵盖其发展基础、构建方式、评估及未来方向等内容。
链接:https://arxiv.org/pdf/2502.17419