DeepSeek推理时间扩展技术:从R1到GRM引领通用奖励建模新变革
旺晓通:深入浅出解读,轻松通晓技术
在科技飞速发展的今天,大语言模型(LLMs)就像超级智能大脑,能帮我们写文章、回答问题、陪我们聊天。而强化学习(RL)则是训练这个超级大脑的“秘密武器”,通过给模型奖励信号,让它知道自己做得好不好,从而变得越来越聪明。但这个奖励信号从哪来呢?这就涉及到奖励建模(RM),它是RL里的关键一环。今天,咱们就来深入了解DeepSeek最新关于奖励建模的科研新成果,看看它是怎么让大语言模型更上一层楼的!
作者:张长旺,图源:旺知识
一、大语言模型的“成长烦恼”:奖励信号从哪来?
大语言模型近年来取得了巨大的进步,能完成各种复杂的任务,比如写小说、做数学题、编写代码等。这背后,强化学习起到了重要作用。强化学习通过给予模型奖励信号,引导模型做出符合人类期望的行为。想象一下,大语言模型是个正在学习各种技能的“学生”,奖励信号就是老师给的小红花,做得好就给一朵,这样学生就知道自己做对了,会继续保持。
但问题来了,在很多情况下,给模型准确的奖励信号并不容易。在一些特定领域,比如数学计算和编程,我们可以通过设定明确的规则来判断模型的回答是否正确,就像数学考试,答案对了就得分。但在更广泛的领域,比如日常对话、创意写作,奖励的标准变得复杂多样。比如写一篇故事,有人喜欢情节跌宕起伏,有人喜欢语言优美,很难有一个固定的标准来衡量。这就好比评判一幅画的好坏,不同人有不同的审美标准,很难有一个绝对正确的答案。
现有的奖励建模方法存在一些问题。比如标量奖励模型,它就像一个简单的打分机器,给每个回答一个固定的分数,缺乏灵活性,不能很好地适应多样化的任务。半标量奖励模型虽然有所改进,但在推理时间扩展(Inference-Time Scaling)方面表现不佳。而生成式奖励模型(GRMs)则为解决这些问题带来了新的希望,它能生成更丰富的奖励表示,就像给回答写一段详细的评语,而不仅仅是一个分数。
二、点向生成式奖励建模:灵活奖励的“新钥匙”
在众多奖励建模方法中,点向生成式奖励建模(GRM)脱颖而出,它就像一把能打开各种锁的万能钥匙,具有独特的优势。
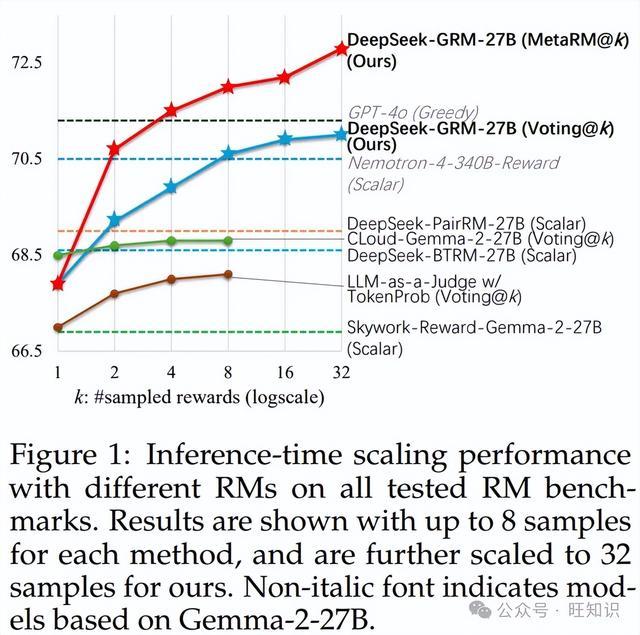
GRM可以统一对单个、成对和多个响应进行评分,而且是在纯语言表示的框架下进行。这意味着它能轻松应对各种类型的输入,不管是一个简单的回答,还是多个不同的回答,它都能给出合理的评分。打个比方,以前的奖励模型可能只能处理一种题型,比如选择题,而GRM就像一个全能选手,无论是选择题、填空题还是简答题,它都能应对自如。
另外,GRM在推理时间扩展方面也有很大潜力。通过多次采样,它可以生成不同的奖励结果,然后综合这些结果给出最终评分。这就好比我们买东西时,多问几家店的价格,综合考虑后再做决定,这样能得到更准确、更合理的结果。在实际应用中,这可以提高奖励信号的质量和粒度,让模型对回答的评估更加精确。
三、自我原则批判调整(SPCT):让奖励更智能
为了让GRM更好地发挥作用,研究人员提出了一种创新的方法——自我原则批判调整(SPCT)。这一方法就像是给GRM注入了一种“智能基因”,让它能够更聪明地生成奖励。
SPCT分为两个阶段:拒绝微调(Rejective Fine-Tuning,RFT)和基于规则的在线强化学习(Rule-Based RL) 。
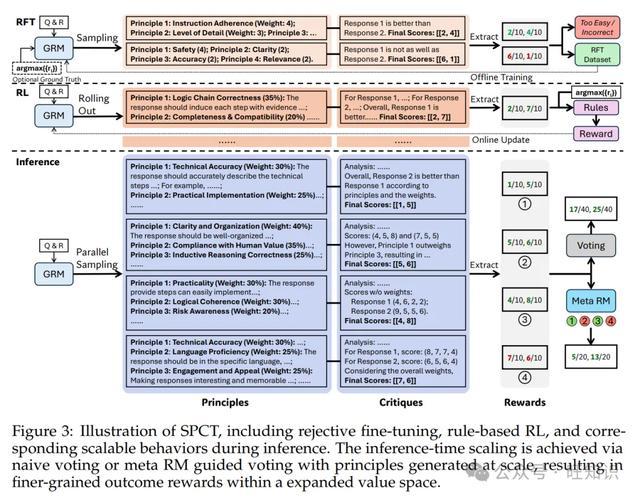
拒绝微调阶段是SPCT的“热身运动”。在这个阶段,GRM就像一个刚入学的学生,需要适应新的学习环境和规则。它要学会生成符合正确格式的原则和批判,并且能够处理各种不同类型的输入。研究人员通过构建特定的数据集来训练GRM,这个数据集就像是一本包含各种题型的练习册,有简单的,也有复杂的。对于那些预测奖励与真实情况不符的样本(就像学生做错的题目),或者所有样本都预测正确的简单题目,就像太简单的送分题,会被拒绝,不用于训练,这样可以让GRM专注于更有挑战性的任务,提高它的能力。
基于规则的在线强化学习阶段,是SPCT的核心“升级装备”。在这个阶段,GRM开始真正展现出它的智能。它根据输入的查询和响应生成原则和批判,然后将预测奖励与真实奖励进行比较。如果预测正确,就像学生答对了题,会得到奖励;如果预测错误,就会得到惩罚。通过不断地这样训练,GRM学会了如何根据不同的情况生成更准确的原则和批判,就像学生在不断练习中掌握了正确的解题方法,从而提高奖励生成的质量,使模型在推理时间扩展方面表现得更好。
四、推理时间扩展策略:让模型更高效
为了进一步提升DeepSeek-GRM在通用奖励生成方面的性能,研究人员探索了基于采样的推理时间扩展策略,就像是给模型找到了一条“加速跑道”。
(一)生成奖励投票法
生成奖励投票法是一种简单有效的策略。想象一下,你要决定去哪家餐厅吃饭,于是问了很多朋友的意见,每个人都给出了自己的选择。然后你统计大家的选择,选择得票最多的餐厅。在模型中,这个过程就类似投票。通过多次采样,GRM会生成多组奖励,每组奖励都可以看作是一个“朋友”的意见。然后将这些奖励进行累加,得到最终的奖励。这样做的好处是,随着采样次数的增加,奖励空间会扩大,就像征求的朋友意见越多,你对餐厅的选择就越有把握,模型就能生成更准确、更细致的奖励,提高奖励的质量和粒度。
(二)元奖励建模引导投票
不过,生成奖励投票法也有一些小问题,就像朋友们的意见可能也不完全靠谱一样。由于采样的随机性和模型的局限性,生成的一些原则和批判可能存在偏差或质量不高。为了解决这个问题,研究人员引入了元奖励建模引导投票。
元奖励建模就像是一个“裁判”,专门用来判断GRM生成的原则和批判是否正确。它是一个点向标量奖励模型,通过训练来识别GRM生成内容的正确性。在投票过程中,元奖励建模会为采样得到的奖励打分,然后只选择得分高的奖励进行投票,就像在众多朋友的意见中,你更倾向于听取那些你觉得更靠谱的朋友的建议,这样可以过滤掉低质量的样本,进一步提高投票的准确性和模型的性能。
五、实验见真章:新方法表现如何?
研究人员对提出的方法进行了一系列实验,就像一场严格的考试,来检验DeepSeek-GRM的性能。
(一)实验设置
研究人员选择了多个不同领域的奖励建模基准测试,包括Reward Bench、PPE、RMB和ReaLMistake。这些基准测试就像是不同科目的考试试卷,涵盖了聊天、推理、安全等多个方面,用来全面评估模型的能力。
在实验中,研究人员将DeepSeek-GRM与其他公共模型和基线方法进行对比。基线方法就像是其他同学的答卷,用来和DeepSeek-GRM的表现进行比较。为了保证实验的公平性,研究人员基于相同的基础模型(Gemma-2-27B)重新实现了这些基线方法,并使用了相同的训练数据和设置。
(二)实验结果与分析
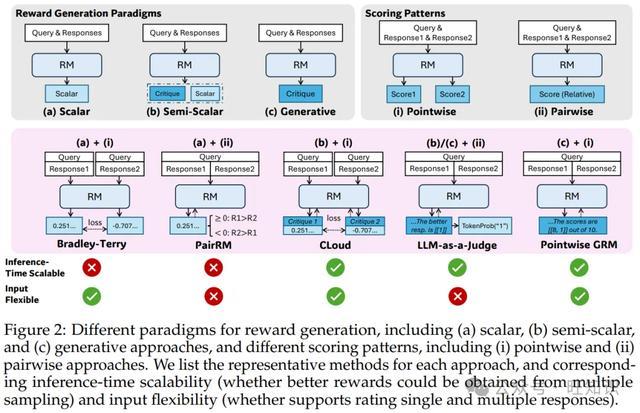
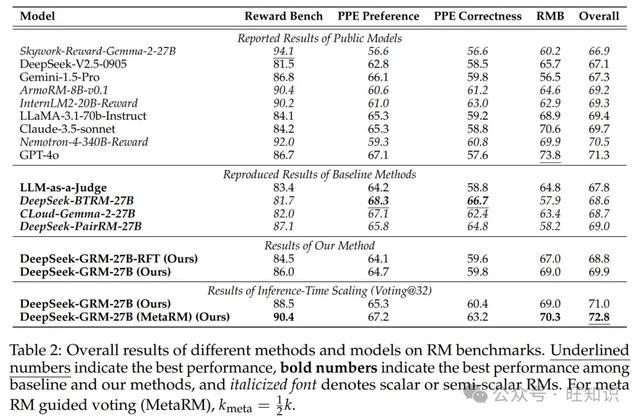
实验结果令人惊喜!在整体性能上,DeepSeek-GRM-27B超过了基线方法,并且与一些强大的公共奖励模型,如Nemotron-4-340B-Reward和GPT-4o相比,也有很强的竞争力。经过推理时间扩展后,DeepSeek-GRM-27B的性能进一步提升,取得了最好的总体结果。
在推理时间可扩展性方面,DeepSeek-GRM-27B表现出色。随着采样次数的增加,它的性能提升幅度最大,这意味着它能充分利用更多的推理计算资源,不断优化奖励生成。元奖励建模在过滤低质量轨迹方面也发挥了重要作用,进一步提升了模型的性能。
通过消融实验,研究人员还发现了一些有趣的现象。比如,原则生成对于DeepSeek-GRM-27B的性能至关重要,就像地基对于高楼大厦一样,没有坚实的原则生成,模型的性能就会大打折扣。另外,非提示采样似乎比提示采样更重要,这可能是因为提示采样有时会让模型走“捷径”,影响了它的学习效果。
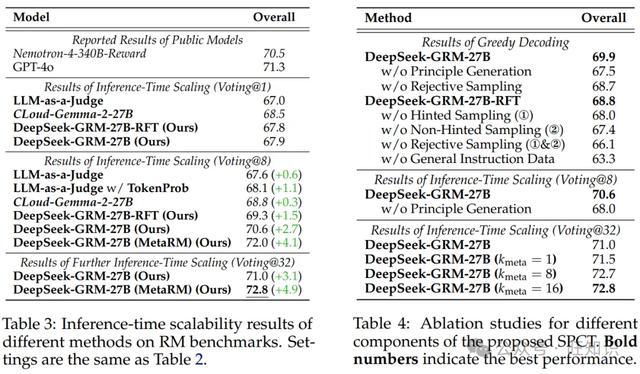
研究人员还比较了DeepSeek-GRM-27B在推理时间扩展和训练时间扩展(增加模型参数)方面的性能。结果发现,DeepSeek-GRM-27B通过推理时间扩展,使用32次采样的直接投票就能达到与671B参数模型相当的性能,而使用元奖励建模引导投票时,仅用8次采样就能取得最佳结果。这表明,在提升模型性能方面,推理时间扩展可能比单纯增加模型参数更有效。
六、研究成果的意义与未来展望
这项研究成果对于大语言模型的发展具有重要意义。自我原则批判调整(SPCT)方法显著提高了生成式奖励模型(GRMs)的推理时间可扩展性和奖励质量,让大语言模型在不同领域的表现更加出色。
从实际应用角度来看,DeepSeek-GRM可以为大语言模型在各种任务中提供更准确的奖励信号,帮助模型更好地理解人类的需求和偏好,从而生成更符合人类期望的回答。比如在智能客服中,它可以更准确地评估回答的质量,提高客户满意度;在智能写作辅助工具中,它可以为生成的内容提供更合理的评价和建议,帮助用户创作出更好的作品。
在未来,研究人员还计划从多个方向进一步探索和改进。例如,将工具集成到奖励模型中,就像给模型配备各种实用的工具,让它在处理需要特定知识或严格步骤的任务时,能够生成更准确的批判,避免出现错误。另外,研究人员还考虑将原则和批判的生成过程分解为单独的阶段,以提高模型的效率,让它在实际应用中更加高效地运行。同时,DeepSeek-GRM还有望用于大语言模型的离线评估,帮助我们更好地了解模型的优势和不足,为模型的改进提供方向。
虽然目前的方法在效率和特定任务上还面临一些挑战,但随着研究的不断深入,这些问题有望得到解决。相信在未来,大语言模型在奖励建模技术的推动下,会变得越来越智能,为我们的生活和工作带来更多的便利和惊喜!
作者:张长旺,图源:旺知识