晓|一文读懂统一多模态理解&生成模型:现状、挑战与未来
旺晓通:深入浅出,轻松通晓
最近,AI界的大动作可真不少!相信大家或多或少都听说过,现在的人工智能不仅能理解文字、生成图片,还在不断拓展新技能。就像一个不断进化的超级大脑,变得越来越聪明、越来越全能。这背后,统一多模态模型的发展功不可没。今天,咱们就来深入聊聊这个前沿的AI技术领域,看看它到底是如何改变我们与AI互动的方式。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、多模态模型的前世今生
在深入了解统一多模态模型之前,我们得先搞清楚它的“家族成员”。多模态理解模型和图像生成模型,这两个在AI领域举足轻重的角色,有着各自独特的发展轨迹。
(一)多模态理解模型:从“单语交流”到“图文双全”
以前的语言模型,就像是只懂一门语言的“书呆子”,只能处理文字信息。但随着技术的发展,多模态理解模型出现了,它让AI学会了“看”图说话,就像给这个“书呆子”戴上了一副能理解图像的“魔法眼镜”。
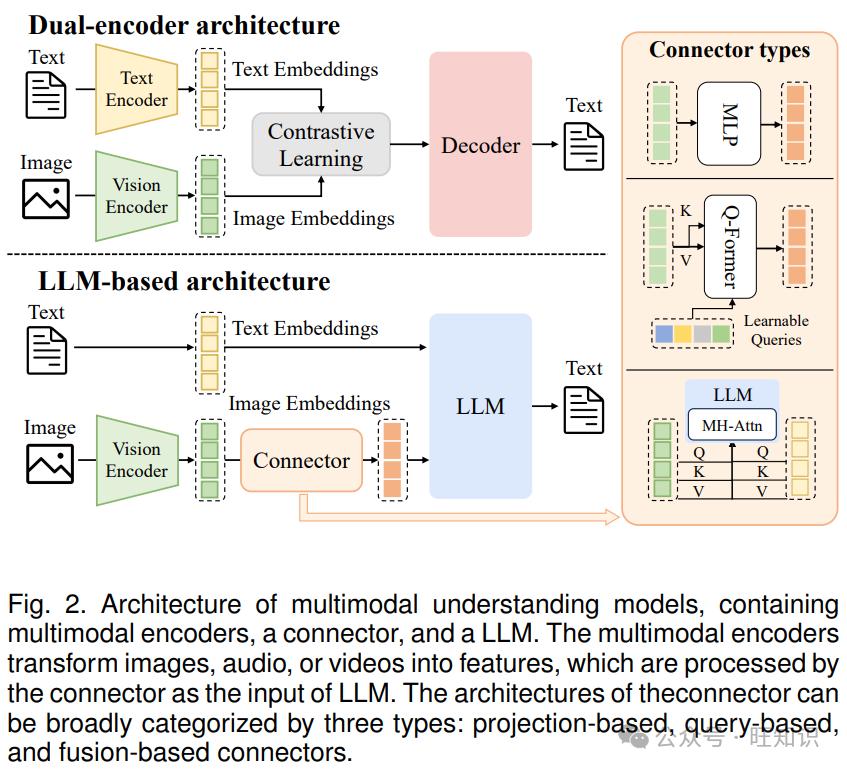
早期的视觉语言理解(VLU)模型,比如CLIP、ViLBERT等,就像刚学画画的孩子,通过分别编码图像和文本,再尝试将它们对齐来理解视觉和文本信息。这种方法虽然有了一定的进步,但还存在很多局限性,就像孩子画画时只能简单临摹,缺乏灵活性和扩展性。
后来,随着强大的大语言模型(LLMs)出现,VLU模型迎来了升级。它们逐渐转向基于解码器的架构,就像孩子开始发挥自己的创意,用更高效的方式将图像和文本融合在一起。像MiniGPT-4,它通过一个可学习的层,把CLIP得到的图像嵌入投影到Vicuna的token空间,实现了更好的视觉语言对齐。还有GPT-4V、Gemini等模型,更是展示了强大的视觉推理、图像字幕生成和多模态对话能力,让我们看到了多模态理解模型的无限潜力。
(二)图像生成模型:从“模糊涂鸦”到“高清写真”
图像生成模型的发展历程,就像是从拿着简陋画笔随意涂鸦,到使用专业绘画工具创作高清写真的过程。
早期,生成对抗网络(GANs)在图像生成领域占据主导地位。它就像两个互相竞争的画家,一个努力画画,另一个努力挑刺,在这种对抗中提升画作质量。但GANs也有自己的问题,比如容易出现模式崩溃,就像画家总是画同一种风格的画,缺乏多样性。
后来,扩散模型(DM)横空出世,成为了图像生成领域的新宠。扩散模型的原理有点像给一幅干净的画逐渐蒙上一层又一层的雾(添加噪声),然后再通过学习如何把雾去掉(反向去噪),还原出原来的画。早期的扩散模型在像素空间或潜在特征空间进行扩散,比如GLIDE、Imagen等。但这些模型计算成本高,于是Latent Diffusion Models(LDMs)出现了,它在预训练的变分自编码器的潜在空间中操作,大大提高了计算效率,还能保持高质量的图像生成效果。像Stable Diffusion系列,就是基于LDMs的成功案例,它们能根据文本描述生成非常逼真的图像。
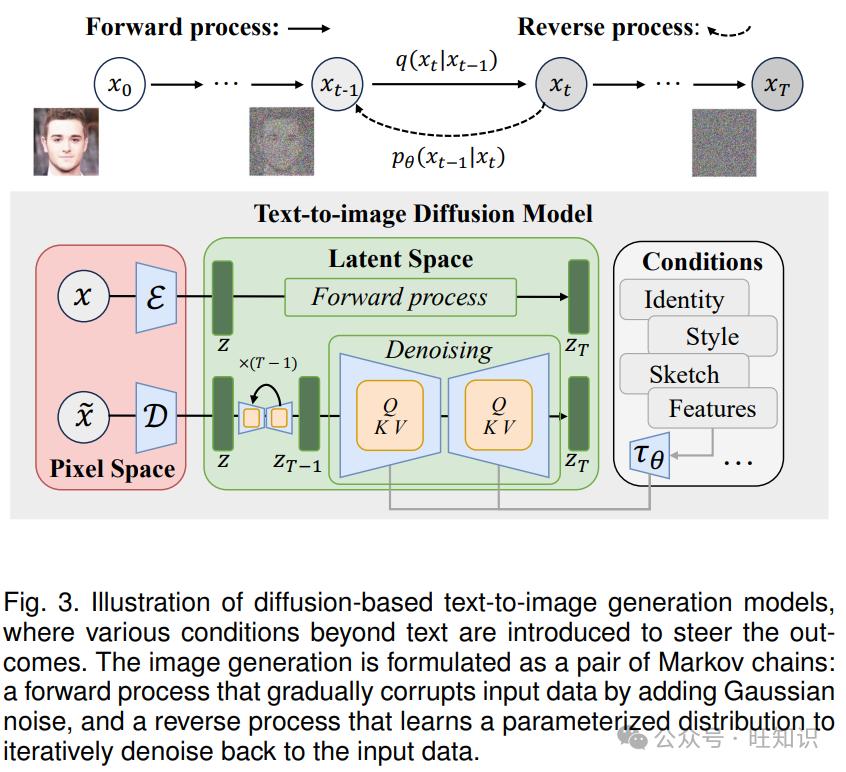
随着Transformer架构的发展,基于Transformer的扩散模型也不断涌现。这些模型利用Transformer强大的处理能力,进一步提升了图像生成的质量和多样性。同时,为了让图像生成模型更好地理解文本,研究者们还引入了对比学习等方法,让图像和文本在共享的潜在空间中对齐,使得生成的图像能更精准地符合文本描述。
二、统一多模态模型:AI界的“全能选手”
看到多模态理解模型和图像生成模型各自发展得有声有色,研究者们就想:能不能把它们的优点结合起来,打造一个“全能选手”呢?于是,统一多模态模型应运而生。
统一多模态模型的目标是构建一个单一的架构,让它既能理解多种模态的数据,又能生成不同模态的输出。想象一下,有一个智能助手,你既可以给它一张图片,让它描述图片内容;也可以给它一段文字,让它根据文字生成一张图片,是不是很方便?这就是统一多模态模型想要实现的功能。
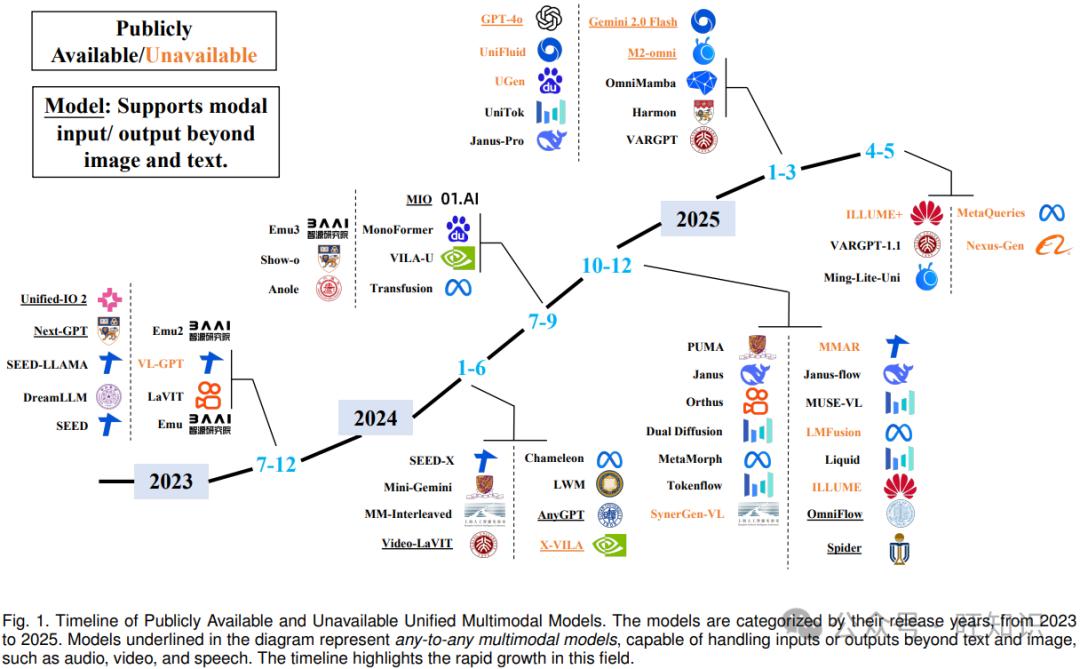
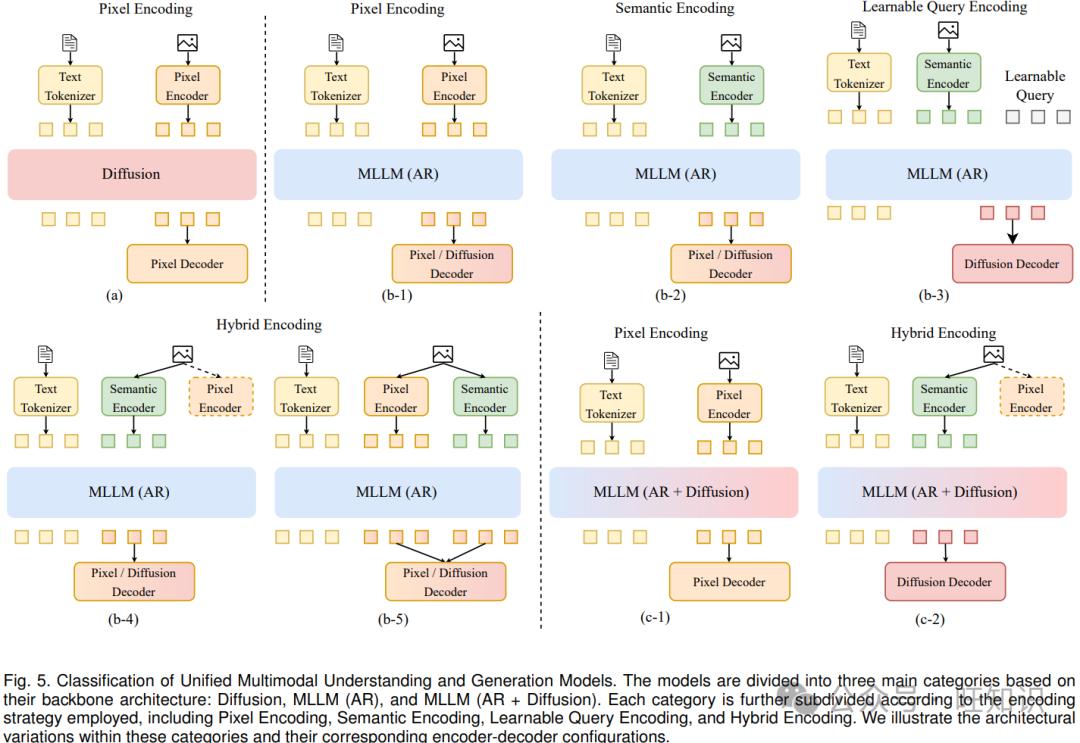
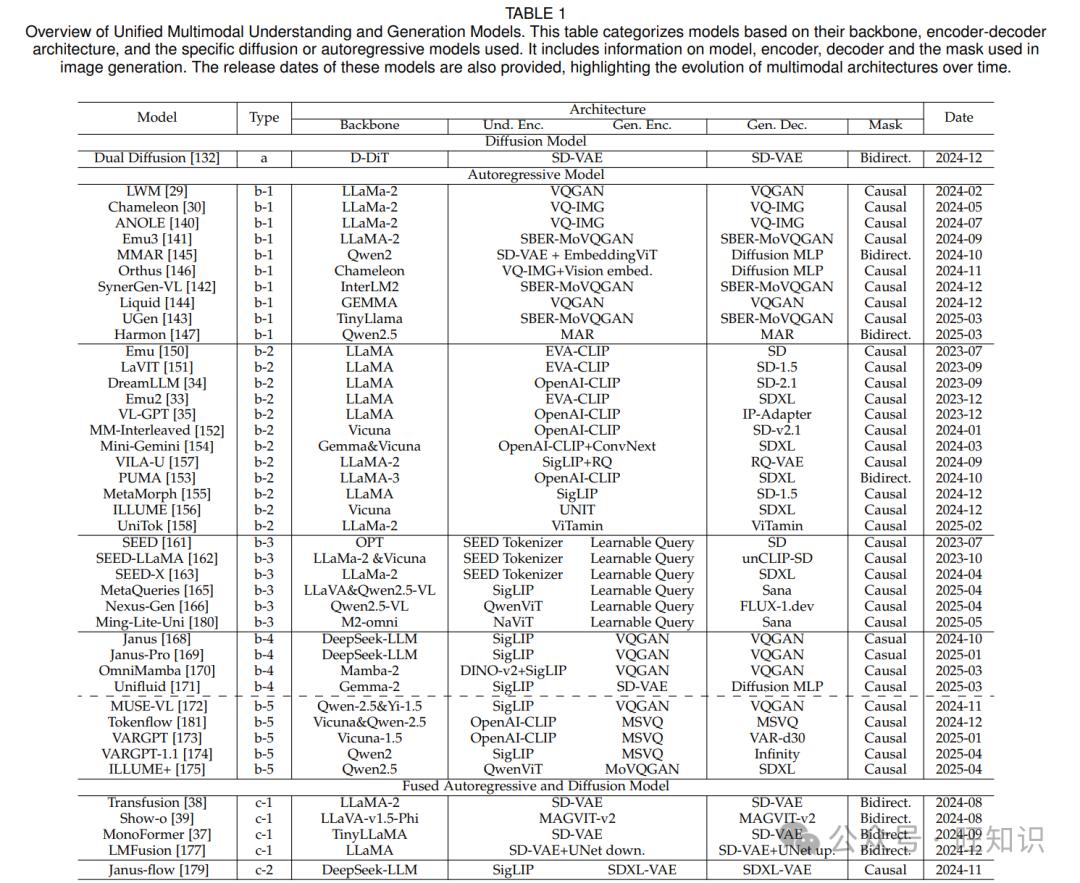
目前,统一多模态模型主要可以分为三大类:基于扩散的模型、基于自回归的模型,以及融合自回归和扩散机制的混合模型。
(一)基于扩散的统一模型:雾里看花,变出“真容”
基于扩散的统一模型,就像是一个神奇的“图像魔法师”,它利用扩散模型在图像生成方面的优势,实现多模态的生成。
以Dual Diffusion为例,它就像有两条“魔法通道”,一条处理文本,一条处理图像。在生成过程中,它先把文本和图像分别编码成不同的表示,然后给它们都加上噪声,就像给它们蒙上了一层雾。接着,通过两个专门的“去噪器”,在反向去噪的过程中,让文本和图像的潜在表示相互关注,就像两个蒙着眼睛的人互相指引,逐渐去除噪声,最终生成自然语言文本和高质量的图像。
不过,这个“魔法师”也有一些小烦恼。它的计算效率不高,因为需要进行多次扩散迭代,就像要解开一团复杂的线团,花费的时间比较长。而且,它的双分支架构增加了模型的复杂性和训练的不稳定性,对噪声也比较敏感,有时候会影响生成的效果。
(二)基于自回归的统一模型:按部就班的“创作家”
基于自回归的统一模型,则像是一个按部就班的“创作家”,它通过序列化视觉和语言的token,按照顺序进行建模和预测。
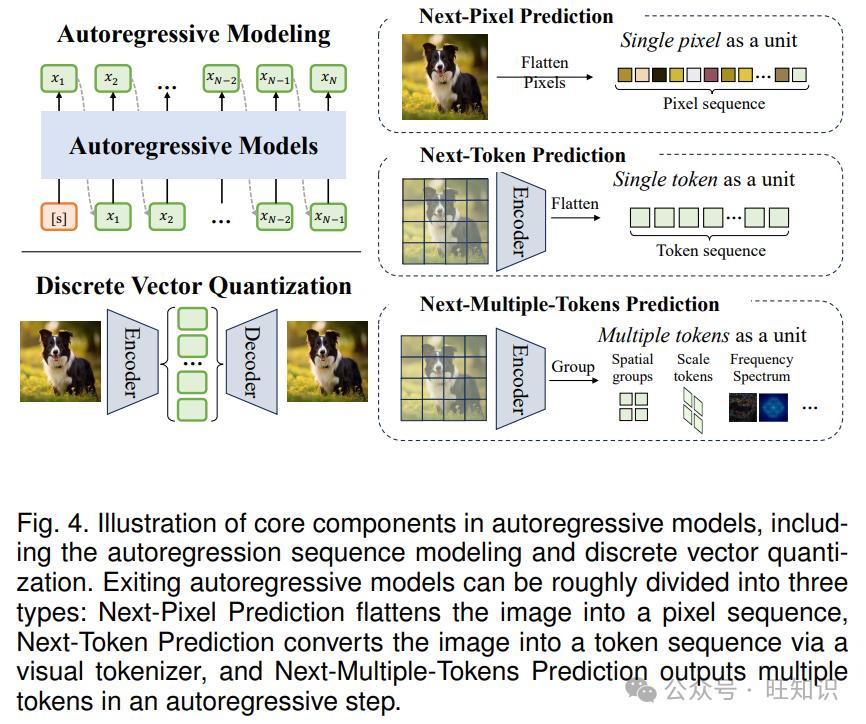
这类模型在处理图像时,有不同的编码方式。像素级编码就像是把图像拆分成一个个小像素块,然后像排列积木一样,根据前面生成的像素来预测下一个像素。这种方法虽然能保留图像的细节,但缺乏高层次的语义抽象,就像只看到了积木的形状,却不明白它们组合起来代表什么。而且,像素级编码会产生密集的token序列,增加了计算和内存的负担。
语义编码则是利用预训练的文本对齐视觉编码器,把图像转化为与语言特征对齐的视觉嵌入。这就好比给图像贴上了语义标签,让模型更容易理解图像的含义。像Emu、LaViT等模型,就采用了这种编码方式,它们在多模态理解和生成任务中表现出色。但语义编码也有缺点,它在像素级的可控性较差,难以进行精细的图像编辑。
还有可学习查询编码,它像是给模型配备了一个“智能搜索器”,通过引入可学习的查询token,动态地从图像特征中提取有用的信息。这种方法能生成适应性强、语义丰富的表示,但计算开销较大,对模型的灵活性也有一定的挑战。
最后是混合编码,它结合了像素级和语义级编码的优点,就像把两种不同风格的绘画技巧融合在一起。不过,这种方法也面临着一些问题,比如如何有效地融合两种不同类型的特征,以及如何避免模态不平衡和冗余等。
(三)混合模型:取其精华的“融合大师”
融合自回归和扩散机制的混合模型,就像是一个“融合大师”,它结合了自回归模型在推理和文本生成方面的优势,以及扩散模型在高质量图像合成方面的优势。
在这类模型中,文本token通过自回归方式生成,就像我们写文章一样,按照顺序一个词一个词地写;而图像token则通过扩散过程生成,就像前面提到的扩散模型一样,从噪声中逐步生成清晰的图像。像Transfusion、Show-o等模型,就采用了这种混合策略,在视觉语言生成任务中取得了不错的效果。
不过,混合模型也并非完美无缺。基于像素的编码方式在训练和推理时计算开销大,而且文本和视觉模态的对齐也比较困难。混合编码虽然提供了更丰富的图像表示,但模型的复杂性增加,计算成本和训练时间也相应增加。
(四)任意到任意多模态模型:打破界限的“跨界高手”
除了上述三种主要类型,还有一类任意到任意多模态模型,它们就像是打破了各种限制的“跨界高手”,能够处理和生成多种不同模态的数据,包括音频、视频、语音等。
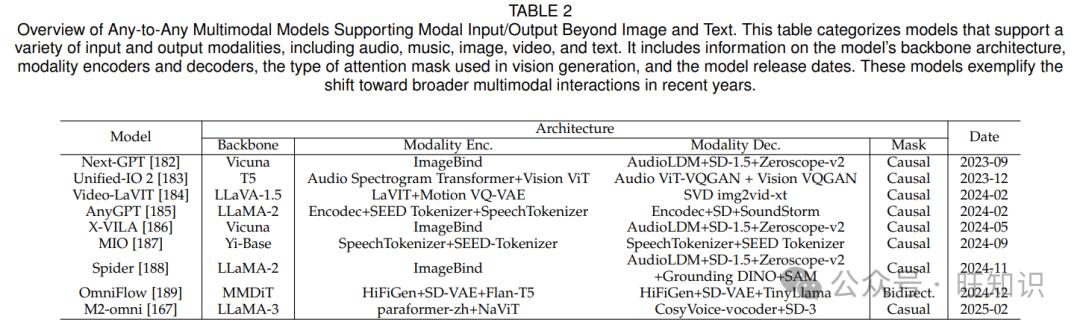
这些模型大多采用模块化设计,每个模态都有专门的编码器和解码器,就像一个分工明确的团队。例如,OmniFlow集成了HiFiGen用于音频和音乐生成,SD-VAE用于图像处理;Spider、X-VILA等模型则利用ImageBind将多种模态映射到一个共享的嵌入空间,实现灵活的条件生成。
然而,这些“跨界高手”也面临着一些挑战。比如模态不平衡,文本和图像模态往往占据主导地位,其他模态的数据相对较少;还有可扩展性问题,支持多种模态会增加模型的复杂性,导致推理延迟增加和资源需求增大。
三、数据与基准:统一多模态模型的“成长养料”和“能力标尺”
统一多模态模型的发展离不开大量的数据和有效的评估基准,它们就像是模型成长过程中的“养料”和“能力标尺”。
(一)数据集:丰富多样的“知识宝库”
为了让统一多模态模型学习到丰富的知识和技能,研究者们创建了各种各样的数据集。这些数据集涵盖了多模态理解、文本到图像生成、图像编辑等多个领域。
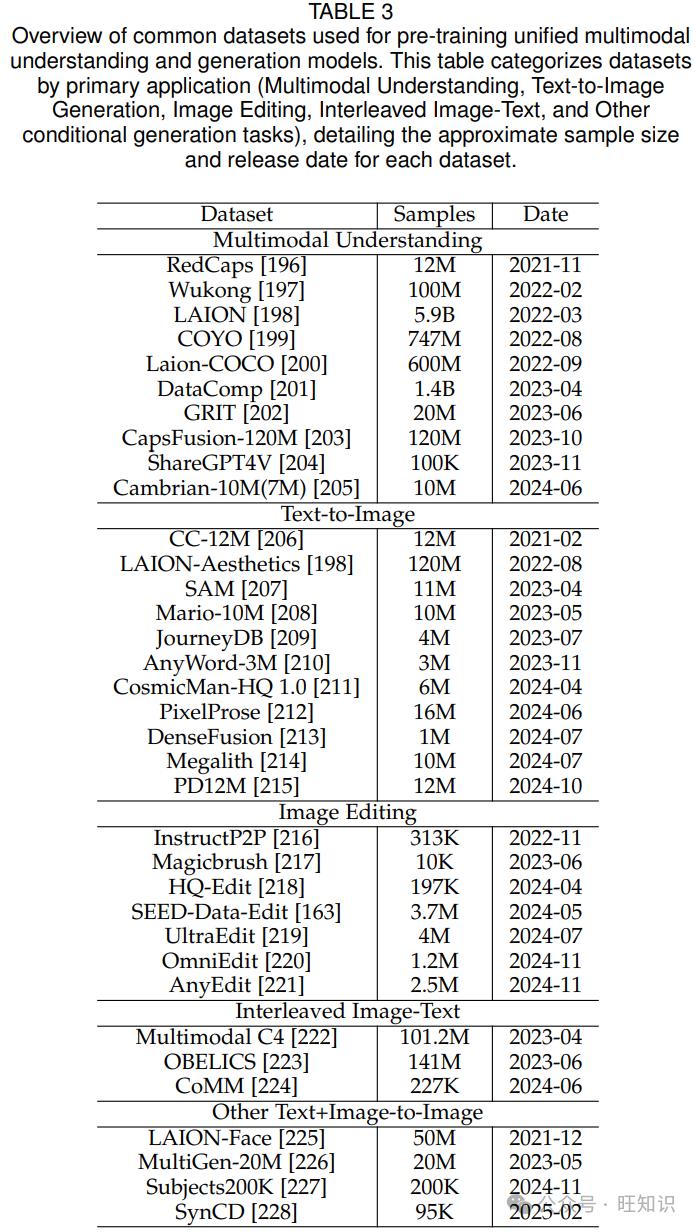
多模态理解数据集就像是一个装满了各种图像和文本故事的“图书馆”,里面的图像和文本描述对应,帮助模型学习如何理解视觉和语言信息。比如RedCaps数据集,它包含了1200万个来自Reddit的图像文本对,记录了很多日常生活中的场景,让模型能更好地理解我们身边的事物。还有Wukong数据集,它有1亿个中文图像文本对,为中文多模态模型的发展提供了重要支持。
文本到图像生成数据集则像是一个充满创意的“艺术素材库”,里面的图像和文本对更注重图像的美学质量和内容丰富度。像CC-12M数据集,它的文本描述简洁明了,很适合训练文本到图像模型。JourneyDB数据集则是由Midjourney平台生成的高质量图像提示对,能帮助模型学习生成复杂、艺术风格的图像。
图像编辑数据集就像是一个“图像改造工厂”,包含了源图像、编辑指令和目标图像的三元组,让模型学习如何根据指令对图像进行修改。InstructPix2Pix数据集通过合成的方法生成了大量的训练样本,MagicBrush数据集则是手动标注的高质量数据集,涵盖了各种真实、精细的编辑操作。
此外,还有交错图像文本数据集,如Multimodal C4,它将图像交错到文本中,就像把图片插入到文章里,帮助模型更好地理解和生成多模态内容。以及其他文本 + 图像到图像的数据集,用于增强模型在特定任务上的能力。
(二)基准测试:公平公正的“能力考试”
有了丰富的“知识宝库”,还需要一个公平公正的“能力考试”来评估模型的能力。基准测试就是这样的“考试”,它从理解、图像生成和交错生成等多个方面对模型进行评估。
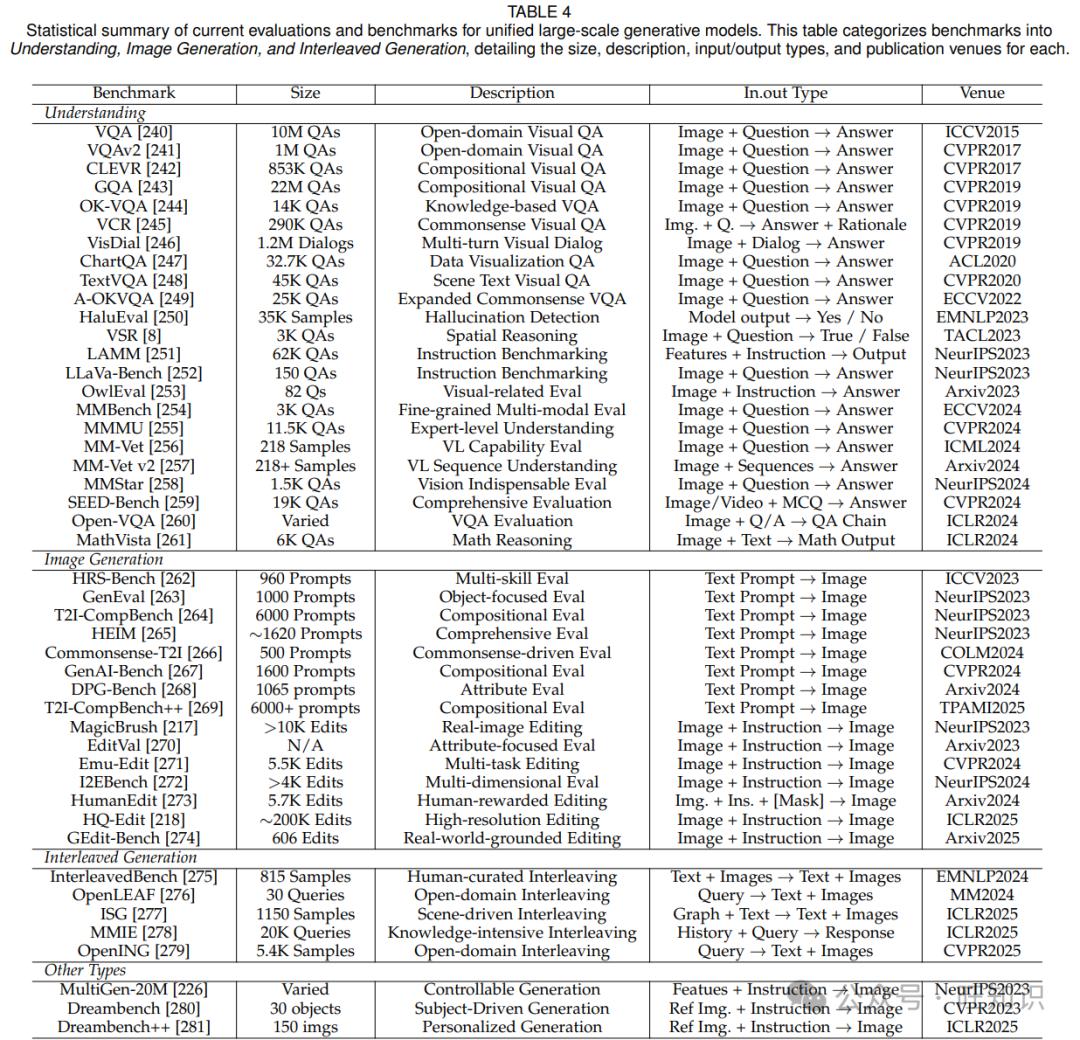
在理解能力测试中,有像VQA这样的视觉问答基准,它就像一场图像知识问答竞赛,要求模型根据图像回答各种问题,考验模型对图像内容的理解。还有CLEVR基准,通过系统地变化图像中物体的属性和空间关系,测试模型的推理能力,就像给模型出了一道道逻辑推理题。
图像生成能力测试则包括文本到图像生成、图像编辑等方面的评估。在文本到图像生成评估中,GenEval会测试模型在生成单个物体、控制颜色等多个细粒度任务上的表现,就像检查画家在不同绘画技巧上的水平。图像编辑评估中,MagicBrush、HQ-Edit等数据集用于评估模型在指令引导下的图像编辑能力,看看模型能不能按照要求对图像进行修改。
交错生成能力测试主要评估模型在文本和图像模态之间交替生成的能力,这就像评估一个人能否在写作和绘画之间自由切换,创作出图文并茂的作品。InterleavedBench、OpenING等基准就是为此设计的,它们涵盖了各种真实场景的任务,检验模型在交错生成方面的能力。
四、统一多模态模型面临的挑战与机遇
统一多模态模型虽然取得了不少进展,但目前还处于发展的初期阶段,就像一个刚刚起步的孩子,面临着很多挑战,同时也有着巨大的机遇。
(一)挑战:成长路上的“绊脚石”
首先,视觉和文本数据的高维度导致token序列非常长,这就像是要处理一本超级厚的书,给模型的计算和内存带来了很大的压力。因此,需要更高效的tokenization和压缩策略,就像发明一种更简洁的语言来表达书中的内容,在减少成本的同时保持信息的完整性。
其次,随着图像分辨率和上下文长度的增加,跨模态注意力机制成为了性能瓶颈。这就好比一个人同时要关注很多事情,注意力很容易分散。因此,需要探索像稀疏或分层注意力机制这样的替代方案,提高模型的注意力效率。
再者,预训练数据集往往包含噪声或有偏差的图像文本对,这就像在学习知识时,参考资料里有错误信息。所以,可靠的数据过滤、去偏和合成方法至关重要,确保模型学习到正确、无偏差的知识。
最后,现有的评估协议通常是针对单个任务设计的,而统一多模态模型需要更综合的评估。这就好比用单一的考试成绩来评价一个学生的综合素质是不准确的,需要更全面的考核方式。
(二)机遇:前方的“宝藏”
尽管面临挑战,但统一多模态模型的发展前景十分广阔。目前,大多数模型主要侧重于图像理解和文本到图像生成,而像图像编辑、空间控制图像生成、主题驱动图像生成和交错图像文本生成等功能还有很大的发展空间。
通过改进架构设计,就像为模型打造一个更坚固、更智能的“大脑”;提高训练效率,让模型学习得更快更好;精心策划数据集,为模型提供更优质的“学习资料”;优化评估方法,更准确地衡量模型的能力,我们有望推动统一多模态模型的进一步发展,挖掘出更多的“宝藏”。
五、未来可期:统一多模态模型的无限可能
统一多模态模型的发展为人工智能带来了新的突破和可能性。它就像一把万能钥匙,未来可能打开各种应用的大门,无论是在创意设计、智能教育,还是医疗诊断、自动驾驶等领域,都有着巨大的应用潜力。
参考资料
• 标题:Unified Multimodal Understanding and Generation Models: Advances, Challenges, and Opportunities
• 作者:Xinjie Zhang, Jintao Guo, Shanshan Zhao, Minghao Fu, Lunhao Duan, Guo-Hua Wang, Qing-Guo Chen, Zhao Xu, Weihua Luo, Kaifu Zhang
• 单位:阿里巴巴集团,香港理工大学,南京大学,武汉大学
• 标签:统一多模态模型、多模态架构、数据集、基准测试、人工智能
• 概述: 文章全面综述统一多模态模型,涵盖架构分类、对应数据集与基准测试,分析挑战并展望未来发展方向。
• 链接:https://arxiv.org/pdf/2505.02567