晓|阿里ZeroSearch:不用搜索引擎,大语言模型也能学会高效搜索
旺晓通:深入浅出,轻松通晓
在人工智能飞速发展的今天,大语言模型(LLMs)越来越融入我们的生活。从智能聊天机器人到智能写作助手,它的身影无处不在。不过,大语言模型也有自己的“烦恼”,其中一个大问题就是,它肚子里的“知识墨水”受限于训练时的数据,就像一个人只读过有限的几本书,遇到新问题时,很容易“胡说八道”,给出错误或者过时的答案。
作者:张长旺,图源:旺知识
那怎么解决这个问题呢?给大语言模型找个“知识小助手”,也就是让它能从外部获取信息,是个好办法。检索增强生成(RAG)技术就是干这个的,它能把外部知识融合到模型的生成过程里。但现有的方法,要么得精心设计提示词,对模型推理能力要求高;要么计算成本太大,实际用起来不太方便。
最近,用强化学习来提升大语言模型的推理和搜索能力成为热门研究方向。不过,这种方法在和真实搜索引擎合作时,又碰到了新麻烦:一是搜索引擎返回的文档质量不稳定,时好时坏;二是使用搜索引擎API的成本高得吓人,严重限制了模型的扩展。
这时候,一项名为ZEROSEARCH的新技术横空出世,它提出了一个大胆的想法:能不能让大语言模型不依赖真实搜索引擎,也能学会高效搜索呢?接下来,咱们就深入了解一下这个神奇的技术。
一、ZEROSEARCH是什么?
简单来说,ZEROSEARCH是一个强化学习框架,它能让大语言模型在不与真实搜索引擎互动的情况下,学习到搜索策略,提升搜索能力。
研究员们发现,大语言模型在大规模预训练过程中,已经积累了海量的世界知识。给它一个搜索查询,它是有能力生成相关文档的。真实搜索引擎和模拟大语言模型返回内容的主要差别,就在于文本风格。经过简单的监督微调,就算是参数相对较少的大语言模型,也能有效模拟真实搜索引擎的行为。
这就好比,大语言模型本来就有一定的知识储备,只是缺乏像搜索引擎那样快速找到信息的“技巧”。通过监督微调,研究员们教会大语言模型模仿搜索引擎的“说话方式”和“找信息的思路”,让它能像模像样地扮演起“搜索引擎”的角色。
二、ZEROSEARCH如何运作?
(一)训练模板:有条理地找答案
ZEROSEARCH给大语言模型设定了一个清晰的“思考流程”,就像我们平时解决问题的步骤一样。模型遇到问题时,要先在<think>标签里进行内部推理,梳理一下自己的思路,看看对这个问题有没有初步的想法。如果发现自己缺一些关键知识,就可以在<search>标签里发出搜索查询。最后,等找到了足够的信息,就在<answer>标签里给出答案。
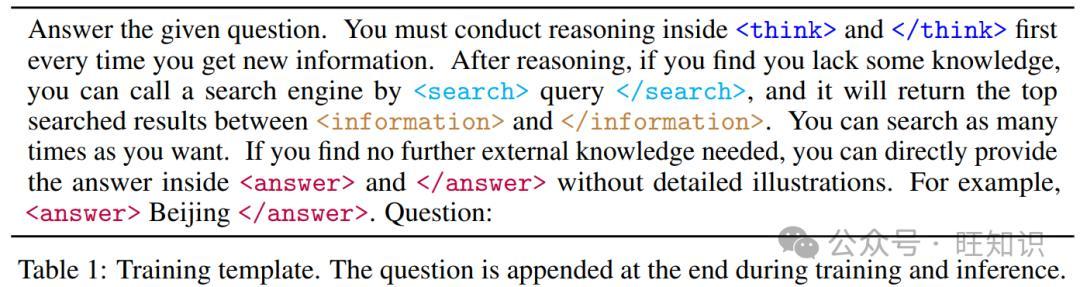
打个比方,你要找一家好吃的餐厅,首先你会自己想想,平时爱吃什么口味,家附近或者经常去的地方有没有印象不错的餐厅,这就是<think>阶段。要是想不起来,你就会打开美食App搜索,这就相当于<search>。等你看了一堆餐厅评价,心里有了主意,决定去某一家,这个决定就是<answer>。通过这样明确的步骤划分,大语言模型的决策过程变得更有条理,答案也更可靠。
(二)搜索模拟微调:让“假引擎”更逼真
直接让大语言模型生成文档,和真实搜索引擎的结果比起来,风格差异明显。为了解决这个问题,研究员们采用了一种轻量级监督微调(SFT)的方法。
他们先让大语言模型和真实搜索引擎多轮互动,收集互动过程中的轨迹。如果最终得到了正确答案,就把这条轨迹标记为正样本,说明检索到的文档很有用;要是答案错了,就标记为负样本,意味着这些文档是“捣乱”的噪声。然后,从这些正负样本轨迹里提取查询 - 文档对,用它们来微调大语言模型。
这就像是训练一个模仿秀选手,先让选手观察被模仿对象的各种表现,把好的表现和不好的表现都记录下来。然后,针对这些表现进行专项训练,让选手能越来越像被模仿对象。经过微调后,大语言模型生成的文档,质量高低就能被灵活控制了。
(三)课程式搜索模拟:循序渐进地学习
在训练过程中,为了让大语言模型逐渐适应复杂的搜索场景,ZEROSEARCH引入了课程学习的思想。简单来说,就是随着训练的推进,逐渐降低生成文档的质量。
刚开始训练时,模型接触到的大多是高质量、有用的文档,这样它能先熟悉基本的输出结构和任务要求,就像小朋友学走路,先在平坦的路上练习,掌握基本的行走技巧。随着训练步数增加,生成噪声文档的概率逐渐提高,模型要面对越来越有挑战性的检索场景,锻炼自己在“混乱信息”中找到正确答案的能力,这就好比小朋友开始在有障碍物的路上行走,提升应对复杂情况的能力。
通过这种方式,大语言模型不会一下子被大量噪声信息“淹没”,能稳步提升自己的推理和搜索能力。
(四)奖励设计:激励模型找对答案
在强化学习里,奖励就像是给模型的“小红花”,引导它做出正确的行为。ZEROSEARCH采用了基于F1分数的奖励函数,这个函数综合考虑了预测答案和正确答案之间的重叠程度,平衡了答案的精确性和完整性。
之前用精确匹配(EM)作为奖励指标时,模型发现只要答案写得很长,就更容易包含正确内容,于是出现了“奖励作弊”的情况。而F1分数能更合理地评价模型的回答质量,让模型专注于找到真正正确的答案,而不是靠“凑字数”拿奖励。
(五)训练算法:多种算法协同工作
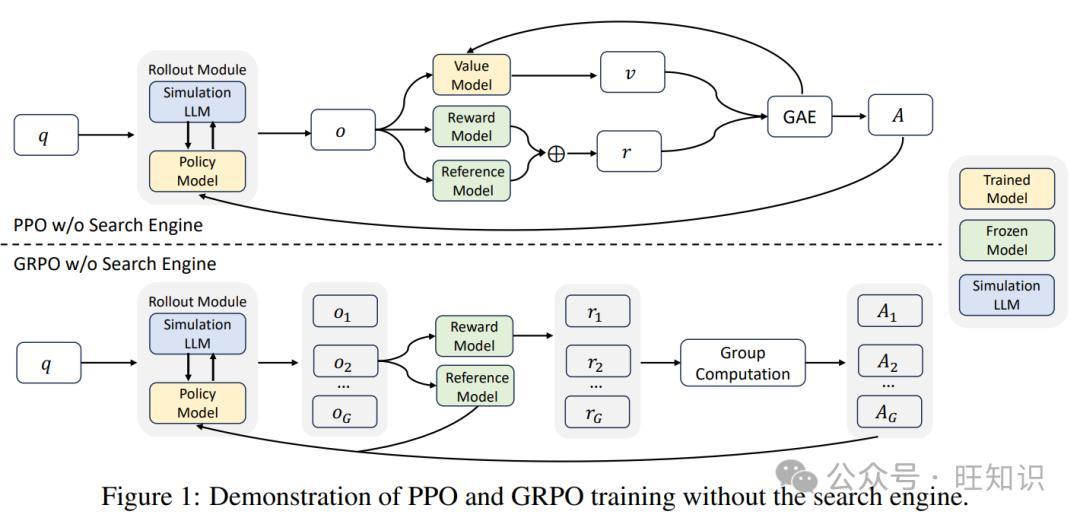
ZEROSEARCH兼容性很强,能和多种强化学习算法合作,比如近端策略优化(PPO)、组相对策略优化(GRPO)和Reinforce++等。不同的算法就像不同的工具,各有各的优势,能从不同角度优化检索增强推理。
在训练过程中,由于大语言模型生成的内容和模拟搜索引擎返回的文档性质不同,如果统一用相同的优化方法,可能会导致训练不稳定。就像给不同体质的人吃同样的补药,可能有的人不适应。因此,ZEROSEARCH引入了损失掩码机制,只对模型自己生成的输出计算梯度,确保训练过程稳定,让模型能更好地学习。
三、ZEROSEARCH效果如何?
(一)实验数据集和评估指标
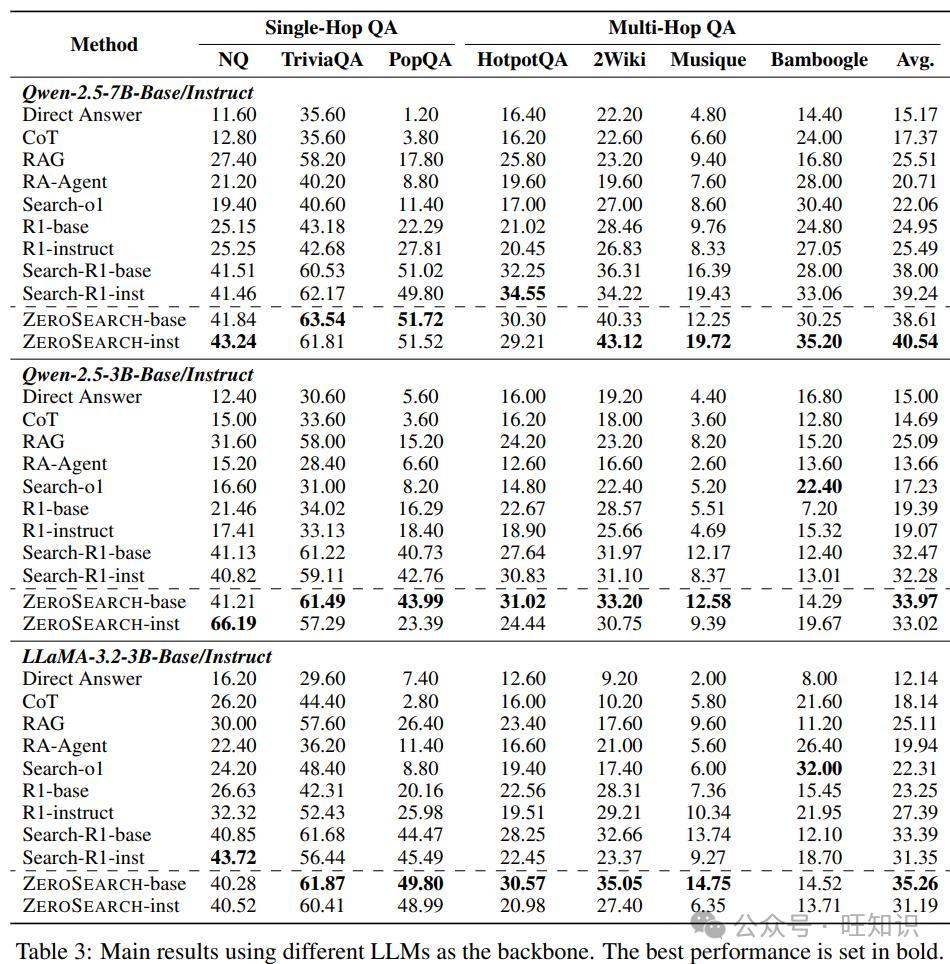
为了检验ZEROSEARCH的实力,研究员们在多种问答基准数据集上进行了测试,包括单跳问答和多跳问答数据集。评估时,他们采用精确匹配(EM)作为指标,如果模型的预测答案和正确答案完全一致,就算答对。
(二)对比基线方法
研究员们找了好多“对手”和ZEROSEARCH进行对比,这些“对手”涵盖了各种不同的方法。像直接提示、思维链(CoT)和标准检索增强生成(RAG)这些普通的提示方法;RAgent、Search-o1这些先进的RAG方法;还有R1、Search-R1这些基于强化学习的调整方法。
在对比时,为了公平起见,所有基于强化学习的方法都采用F1分数作为奖励指标。而且,和基于强化学习的搜索基线方法对比时,主要选择Search-R1,因为它避免了复杂的奖励设计和训练流程,能让真实搜索引擎和ZEROSEARCH的模拟搜索引擎进行更直接、公平的较量。
(三)实验设置
实验选用了三个模型家族:Qwen-2.5系列和LLaMA-3.2系列,每个系列都有基础模型和指令调整模型。为了模拟真实的检索场景,研究员们用Google Web Search作为外部搜索引擎,并且规定所有方法每次检索的文档数量都是五个。
在数据集方面,他们把NQ和HotpotQA的训练集合并起来,用于基于微调的方法。评估则在七个数据集上进行,这样能全面考察模型在不同领域的表现。对于基于提示的基线方法,使用指令调整模型,因为基础模型不太擅长理解任务指令。对于基于强化学习的方法,同时评估基础模型和指令调整模型,看看ZEROSEARCH在不同类型模型上的通用性。
在训练模拟大语言模型时,研究员们以Qwen-2.5-3B、Qwen-2.5-7B和Qwen-2.5-14B为基础,采用轻量级监督微调,学习率设为1e-6。训练ZEROSEARCH时,选用GRPO和PPO这两种强化学习算法,并且设置了不同的学习率,还使用了广义优势估计(GAE),让训练效果更好。
(四)性能表现
实验结果显示,ZEROSEARCH的表现十分出色,把一众基线方法远远甩在身后。不管是在训练数据所属的领域内,还是在没见过的领域外数据集上,它都表现得很稳健,成绩优异。
和依赖真实搜索引擎的方法比起来,ZEROSEARCH也毫不逊色。比如和Search-R1相比,ZEROSEARCH的性能更胜一筹,这说明在大规模强化学习场景里,它完全有潜力替代真实搜索引擎。而且,ZEROSEARCH的泛化能力很强,不管是哪个模型家族、多大参数规模的模型,也不管是基础模型还是指令调整模型,它都能让模型的搜索能力得到提升,并且模型参数越大,效果越好,展现出良好的扩展性。
四、进一步分析
(一)与真实搜索引擎对比:训练过程更稳定
将ZEROSEARCH和使用真实搜索引擎的Search-R1对比,会发现它们的奖励曲线变化趋势相似,随着训练的进行,奖励分数都在上升,这表明两种方法都能让模型学会和搜索引擎互动,找到正确答案。
但ZEROSEARCH的学习曲线更稳定、更平滑。一开始,它的表现可能不如Search-R1,但后来居上,而且波动更小。这得益于它的课程机制,就像一个人慢慢积累经验,从简单任务开始,逐渐掌握复杂技能,能更好地学会使用搜索工具。
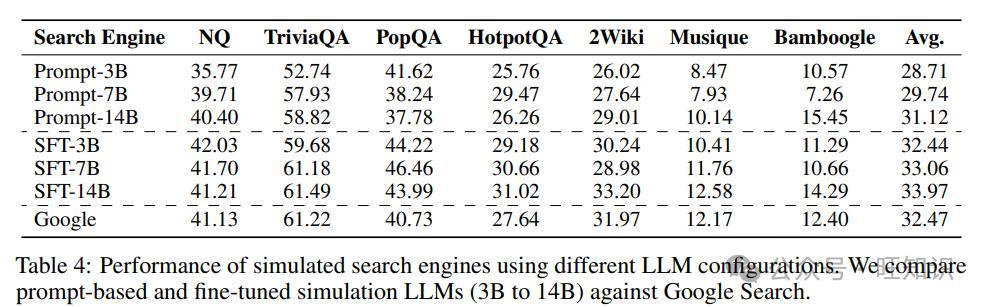
(二)模拟大语言模型的选择:越大越精细越好
研究不同配置的模拟搜索引擎对性能的影响时发现,经过微调的7B模拟引擎,性能和Google Search差不多,14B的模拟引擎甚至更厉害,这证明了用训练好的大语言模型替代真实搜索引擎是可行的。
同时,微调后的模拟引擎比基于提示的模拟引擎表现好很多。虽然基于提示的方法也努力模仿真实搜索引擎的回答风格,但和真实情况还是有差距,导致性能不佳。而且,模型规模越大,性能越好。大模型模拟能力更强,能更精准地区分相关和不相关的文档,在训练时让课程学习效果更好。
(三)交互轮数研究:训练中不断优化策略
分析ZEROSEARCH训练过程中的奖励变化和交互轮数发现,训练初期,模型不太会正确调用搜索引擎,导致交互轮数多,但奖励增加慢。就像新手开车,操作不熟练,走了很多冤枉路。
随着训练推进,模型学会了有效检索相关文档,交互轮数和奖励曲线都快速上升,然后趋于稳定。不过,由于课程机制,后期任务难度其实在不断增加,模型必须持续优化自己的策略,提升推理能力,才能保持好的表现,这就像开车技术越来越好,但遇到的路况也越来越复杂,需要不断提升驾驶技巧。
(四)不同强化学习算法:GRPO更稳定
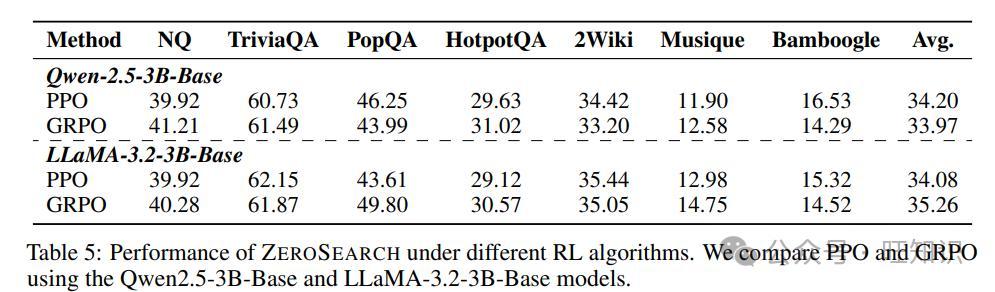
在ZEROSEARCH框架下评估PPO和GRPO这两种常用的强化学习算法,发现它们都能提升模型的搜索能力,这体现了ZEROSEARCH的通用性。但相比之下,GRPO在不同模型上的表现更稳定。虽然在和真实搜索引擎互动时,GRPO的重复滚动机制会产生更高的API成本,但在ZEROSEARCH的模拟搜索环境里,这个问题就不存在了,更凸显出它的实用性。
(五)反向课程研究:由易到难效果好
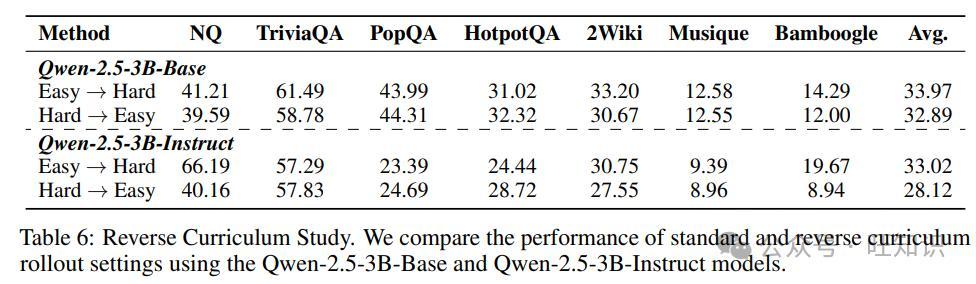
把正常的课程式训练(从简单到困难)和反向课程训练(从困难到简单)对比,结果表明,正常的课程式训练效果更好。从更容易的搜索结果开始训练,模型能先学会如何调用搜索引擎,掌握基本的输出格式。随着训练深入,再接触更具挑战性的场景,有助于提升推理能力。这就好比学武功,先从基础招式练起,打好根基,再学习高级招式,才能事半功倍。
五、总结与展望
ZEROSEARCH作为一种创新的强化学习框架,成功解决了大语言模型搜索能力训练中的难题,不用依赖真实搜索引擎,就能有效提升模型的搜索能力。它通过监督微调把大语言模型变成能生成不同质量文档的检索模块,利用课程式训练机制逐步提升模型的推理能力。实验证明,ZEROSEARCH性能优异,泛化能力强,能和多种强化学习算法配合。
不过,ZEROSEARCH也有一些小缺点。比如,部署模拟搜索的大语言模型需要GPU服务器,虽然比使用商业API成本低,但还是增加了基础设施成本。研究员们也在想办法解决这个问题,比如让多个训练任务共享一台模拟服务器,提高资源利用率。
未来,随着研究的深入,相信ZEROSEARCH会不断优化和完善,在大语言模型的发展道路上发挥更大的作用,说不定以后我们使用的各种智能设备,背后都有它的“功劳”,让我们的生活更加智能和便捷。