晓|DeepSeek最新论文解读:当AI遇见硬件瓶颈,DeepSeek突出重围
旺晓通:深入浅出,轻松通晓
在AI领域,大语言模型(LLM)的发展正如火如荼。从GPT-4o到LLaMA-3,模型的能力不断突破,仿佛人类正站在通用人工智能(AGI)的门槛前。然而,这场轰轰烈烈的技术革命背后,一场看不见的"暗战"正在上演——当模型规模呈指数级增长时,硬件架构的局限性逐渐暴露:内存墙、计算效率瓶颈、网络带宽不足,如同三只拦路虎,挡住了AI前进的道路。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
DeepSeek-V3的出现,打破了这一僵局。这支由中国团队DeepSeek-AI打造的大模型,仅用2048块NVIDIA H800 GPU,就实现了成本效益与性能的双重突破。它的背后,是一场精密的"软硬件协同作战",揭示了AI发展的新范式:当算法与硬件深度融合,竟能迸发出如此惊人的能量。
一、内存危机:当AI遭遇"内存墙"
1.1 内存不够用?低精度计算来救场
想象一下,你在电脑上同时运行十个大型软件,内存告急的提示不断弹出——这就是大模型训练面临的"内存危机"。传统的BF16精度模型,如同占据大量空间的"胖子",而FP8混合精度训练,就像给模型来了一场"瘦身手术"。
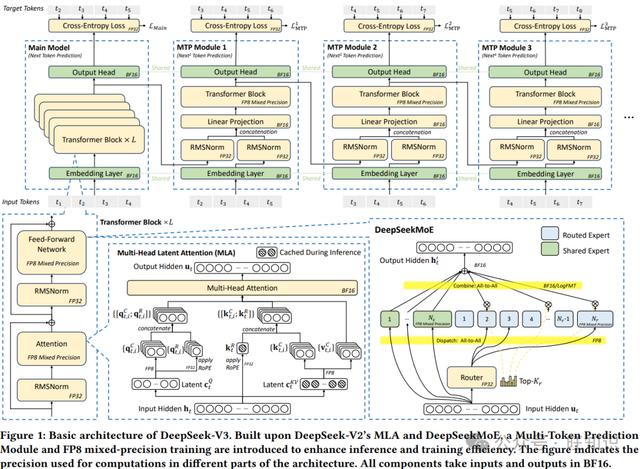
FP8究竟有何魔力?简单来说,它将数据的存储精度从16位压缩到8位,直接节省了一半的内存空间。这就好比把高清电影压缩成标清格式,虽然画质有所损失,但关键信息依然保留。DeepSeek-V3通过精细的量化策略,确保在压缩过程中模型性能损失低于0.25%,实现了"瘦身不瘦脑"。
1.2 KV缓存压缩:Attention机制的"内存瘦身"
在大模型的推理过程中,Attention机制需要缓存大量的Key-Value(KV)向量,这成为内存消耗的"大户"。传统方法中,每个注意力头都需要独立存储KV缓存,如同每个快递员都单独配备一辆货车,效率低下且浪费资源。
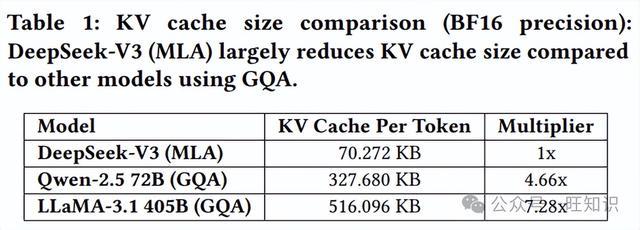
DeepSeek-V3引入的多头潜在注意力(MLA)机制,就像一个高效的"物流调度中心"。它通过投影矩阵将所有注意力头的KV表示压缩成一个更小的潜在向量,只需缓存这个向量即可。这相当于让多个快递员共享一辆货车,大幅减少了内存占用。数据显示,DeepSeek-V3的KV缓存大小仅为LLaMA-3.1的1/7,效率提升显著。
1.3 未来方向:线性注意力与稀疏注意力的探索
尽管MLA已经取得了显著成效,但Transformer架构的二次复杂度依然是长上下文处理的难题。研究员们正在探索线性注意力(如Mamba-2)和稀疏注意力等新技术,试图从根本上改变计算模式。这就好比从传统的"逐字翻译"转向"段落大意概括",有望在计算成本与模型性能之间找到新的平衡点。
二、计算效率革命:MoE架构的"因材施教"
2.1 MoE:让专家只做擅长的事
大模型训练的计算成本堪称天文数字。一个百亿参数的模型,每训练一次的电费就可能高达数十万元。如何在保证性能的前提下降低计算成本?混合专家(MoE)架构给出了答案。
MoE的核心思想是"因材施教":将模型拆分为多个专家模块,每个专家负责处理特定类型的任务。当输入数据到来时,模型会根据内容选择最合适的专家进行处理,而非调动所有参数。这就好比医院的专科门诊,让心脏科医生专注于心脏疾病,而不是让全科医生包揽所有病症,大大提高了效率。
2.2 成本对比:MoE vs 密集模型
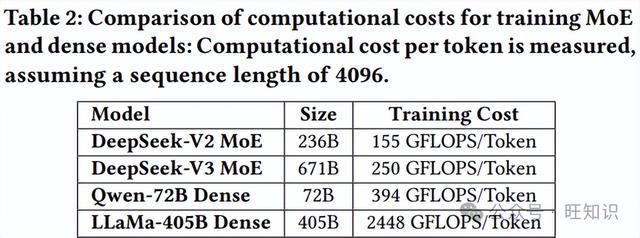
以DeepSeek-V3为例,其参数规模达6710亿,但每次训练仅激活370亿参数,计算成本为250 GFLOPS/Token。相比之下,同样性能的密集模型LLaMA-3.1(4050亿参数)需要2448 GFLOPS/Token,计算成本相差近十倍。这就好比用电动车和燃油车跑同样的路程,电费成本远低于油费。
2.3 个人部署:MoE的"亲民"一面
MoE架构不仅在训练阶段节省成本,在推理阶段同样表现出色。DeepSeek-V2(2360亿参数)在消费级GPU上就能实现近20 tokens/秒的生成速度,而同等能力的密集模型(如700亿参数)仅能达到个位数TPS。这意味着,未来普通用户的电脑也可能运行大型模型,实现本地化的智能体服务,无需完全依赖云端服务器。
三、推理速度提升:从"龟速"到"闪电"的蜕变
3.1 计算与通信的"双人舞"
在大模型的推理过程中,计算与通信是一对相互制约的"冤家"。传统方法中,计算和通信依次进行,如同接力赛中的交接棒,存在明显的延迟。DeepSeek-V3采用的双微批处理重叠技术,让计算和通信同时进行,如同双人舞般默契配合。
具体来说,当第一个微批处理进行注意力计算时,第二个微批处理同步进行通信调度;反之亦然。这种流水线式的操作,使GPU始终处于满负荷运转状态,大大提高了系统吞吐量。在实际应用中,这种设计使DeepSeek-V3的在线推理系统效率提升了近一倍。
3.2 多Token预测:打破自回归的"枷锁"
自回归模型每次只能生成一个Token,如同逐字书写的书记员,效率低下。DeepSeek-V3引入的多Token预测(MTP)模块,就像一位能同时书写多个字的"快手"。它通过轻量级的子模型并行预测多个候选Token,然后进行验证,大幅提升了生成速度。
实验数据显示,MTP模块对第二个后续Token的预测准确率高达80%-90%,使生成速度提升了1.8倍。这就好比从手写升级到打字,效率的提升显而易见。
3.3 硬件带宽的"天花板"与突破
尽管软件优化能提升推理速度,但硬件带宽依然是制约性能的关键因素。以CX7 400Gbps InfiniBand网络为例,其理论上的通信延迟为120.96微秒,而采用GB200 NVL72高带宽互连时,延迟可降至6.72微秒,速度提升近20倍。这表明,硬件升级将是未来推理速度突破的重要方向。
四、硬件架构创新:从"单车道"到"多平面"的网络革命
4.1 多平面胖树网络:堵车?不存在的!
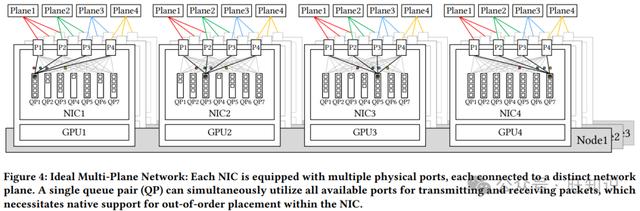
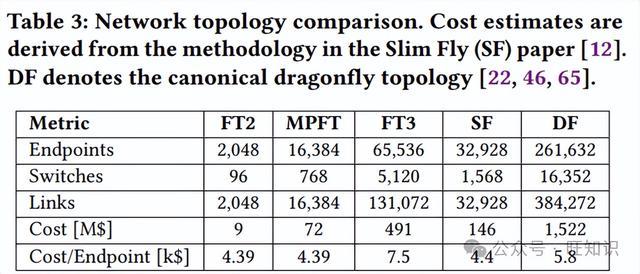
传统的三层胖树网络(FT3)如同城市中的单车道公路,随着车辆增多,拥堵问题日益严重。DeepSeek-V3采用的两层多平面胖树网络(MPFT),则像拥有多条车道的高速公路,每个平面独立运行,互不干扰。
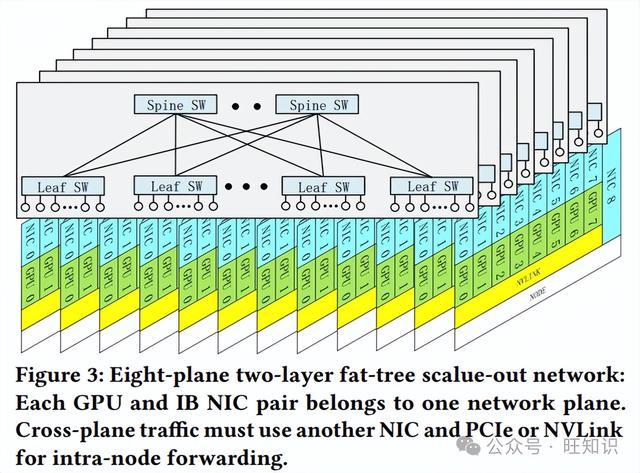
MPFT通过将GPU和NIC划分为多个独立平面,实现了流量隔离和负载均衡。实验数据显示,其网络成本仅为FT3的1/7,而吞吐量却不相上下。这就好比将单一的高速公路扩建为多车道,并设置独立的应急车道,既降低了成本,又提高了效率。
4.2 节点受限路由:让数据"抄近路"
在H800架构中,节点内的NVLink带宽(200GB/s)远高于节点间的IB带宽(50GB/s)。DeepSeek-V3利用这一特性,设计了节点受限路由策略:将专家模块分组部署在同一节点内,使大部分通信通过NVLink完成,减少对IB的依赖。
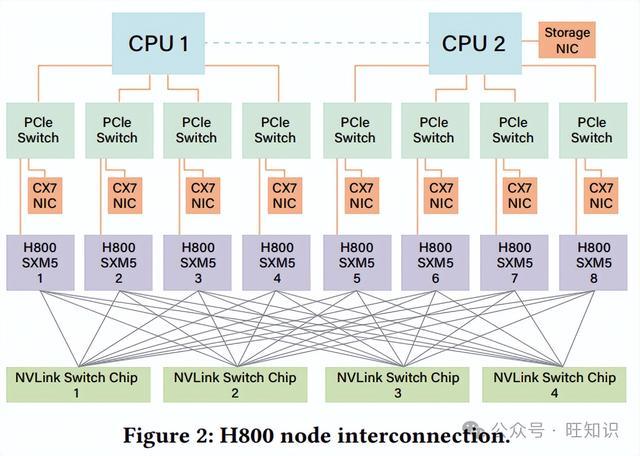
这就好比在城市中寄送快递,同城快递优先选择本地配送,而非通过长途运输。数据显示,该策略使通信成本降低了50%以上,有效缓解了带宽瓶颈。
4.3 未来网络:从"单一连接"到"智能融合"
研究员们对未来硬件架构提出了诸多设想:统一的网络适配器、专用通信协处理器、灵活的转发机制等。这些创新将实现节点内与节点间通信的无缝融合,如同将城市中的地铁、公交、出租车等交通方式整合为一个智能交通系统,进一步提升整体效率。
五、DeepSeek-V3的启示:软硬件协同的未来
DeepSeek-V3的成功,揭示了一个重要趋势:AI的发展不再是算法与硬件的单打独斗,而是两者的深度协同。从FP8混合精度训练到MoE架构,从多平面网络到节点受限路由,每一项创新都是算法与硬件相互妥协、相互成就的结果。
对于普通用户而言,这意味着未来的AI应用将更加高效、亲民:手机可能流畅运行智能体,本地服务器能处理复杂推理任务,AI不再是云端的"黑箱",而是触手可及的工具。
然而,挑战依然存在:内存墙尚未完全突破,网络延迟仍需降低,硬件成本有待进一步下降。但正如DeepSeek-V3的研究员们在论文中所说:"硬件与模型的协同设计,是应对AI工作负载不断增长的关键。"这场软硬件的"暗战",或许才刚刚开始。
DeepSeek-V3的故事,是AI领域"螺蛳壳里做道场"的典范——在硬件限制的夹缝中,通过精妙的算法设计和架构创新,实现了性能与成本的平衡。它不仅为大模型训练提供了可借鉴的蓝图,更向我们展示了人类在技术瓶颈面前的创造力。
未来的AI发展,或许不再单纯追求"更大的模型",而是转向"更聪明的协同"。当算法能感知硬件的极限,当硬件能理解算法的需求,两者的深度融合将开启一个全新的AI时代。而DeepSeek-V3,正是这个时代的敲门砖。
作者:张长旺,图源:旺知识
参考资料
• 标题:Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures
• 作者:Chenggang Zhao, Chengqi Deng, Chong Ruan, Damai Dai, Huazuo Gao, Jiashi Li, Liyue Zhang, Panpan Huang, Shangyan Zhou, Shirong Ma, Wenfeng Liang, Ying He, Yuqing Wang, Yuxuan Liu, Y.X. Wei
• 单位:DeepSeek-AI
• 链接:https://arxiv.org/pdf/2505.09343