晓|当大语言模型遇上联邦学习:一场隐私与智能的双向奔赴
旺晓通:深入浅出,轻松通晓
在数字时代,我们每天都在享受大语言模型(LLMs)带来的便利——从智能聊天机器人到自动文档生成,从实时翻译到数据分析,这些基于海量数据训练出的“智能大脑”正在重塑我们的生活。但鲜为人知的是,这些模型的训练背后隐藏着一个棘手的问题:数据隐私困境。当医疗记录、金融数据等敏感信息成为训练燃料时,如何在不泄露隐私的前提下让模型变得更聪明?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
联邦学习(FL)的出现,为这个问题提供了一种新思路。简单来说,联邦学习就像是一场“分布式的学习派对”,数据不动模型动,各个参与者在本地训练模型,仅共享更新后的参数,就像大家各自在家做题,只把解题思路汇总到一起,从而避免原始数据的暴露。而当大语言模型与联邦学习结合,一个全新的研究领域——联邦大语言模型(FLLM)诞生了。不过,这对“组合搭档”在实际应用中却面临着诸多挑战,就像新手组队打副本,需要闯过一道道难关。
一、可行性挑战:训练成本的“高山”
大语言模型的训练堪称“数据与算力的狂欢”。以GPT-3为例,其训练需要消耗数千块GPU,历经数月时间,产生的通信和计算成本令人咋舌。而联邦学习要求多个客户端协同训练,这无疑让成本问题雪上加霜——想象一下,让一群配置不一的手机同时参与训练一个万亿参数的模型,不仅计算资源可能跟不上,网络传输也会因为参数规模过大而陷入“堵车”。
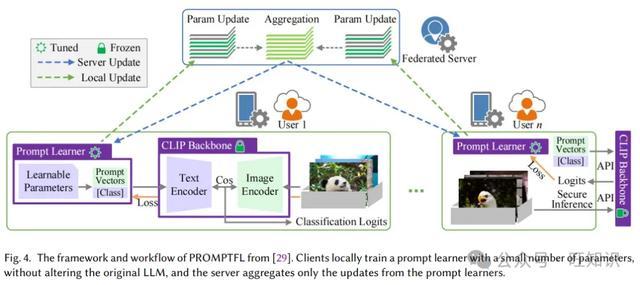
为了攻克这一难题,研究员们提出了联邦参数高效微调(FedPEFT)技术,就像给模型训练“瘦身”。传统的全参数微调需要更新模型的所有参数,如同让学生重新学习所有课程,既耗时又耗力。而FedPEFT则采用了“选择性学习”策略,比如只调整部分关键参数(如偏差项),或者在模型中插入轻量级的适配器(Adapter)或低秩矩阵(LoRA),就像给模型配备“学习笔记”,只需记住针对特定任务的关键内容。例如,在法律领域的联邦训练中,通过FedPEFT技术,研究员们成功在隐私保护的前提下对RoBERTa模型进行了微调,通信效率提升了3.8倍。
除了参数调整,提示调优(Prompt Tuning)则是另一种巧妙的思路。它就像给模型一个“解题线索”,通过优化输入提示的嵌入向量,引导模型生成特定任务的输出,而无需修改模型本身的参数。这就好比老师给学生一道题的解题思路,学生只需按照思路思考,而不用重新学习整个知识体系。例如,在图像-文本联合训练中,客户端通过生成特定提示并聚合更新,显著降低了计算和通信成本。
二、鲁棒性挑战:异质环境的“迷雾”
在联邦学习的“派对”中,参与者的设备、数据和任务可能千差万别,就像一群来自不同班级的学生,有的擅长数学,有的擅长语文,有的用笔记本电脑做题,有的用手机。这种异质性会导致模型训练不稳定,甚至“学偏”。
资源异质性是首当其冲的问题。有的客户端计算能力强,能处理复杂的参数更新,而有的客户端(如边缘设备)可能连基本的训练任务都难以完成,就像让小学生和大学生一起参加奥数比赛,进度难以协调。研究员们通过动态调整策略来解决这一问题,例如FlexLoRA允许客户端根据自身资源动态调整低秩矩阵的秩,资源丰富的客户端可以使用更高的秩,贡献更多通用知识,而资源有限的客户端则专注于局部任务,就像分组完成项目,各尽所能。
数据异质性则是另一个难题。不同客户端的数据分布可能差异极大,比如有的医院数据集中于心脏病,有的集中于糖尿病,直接聚合参数会导致模型“营养不良”,无法泛化到其他场景。为此,研究员提出了双模块架构,如FDLoRA为每个客户端配备两个LoRA模块,一个捕捉本地个性化知识,一个学习全局通用知识,通过自适应融合提升模型的鲁棒性,就像同时拥有“本地教材”和“全国统编教材”,兼顾特色与共性。
任务异质性让问题更加复杂。当有的客户端需要处理文本分类,有的需要进行机器翻译时,模型就像被要求同时参加不同科目的考试,难以兼顾。M2FEDSA框架通过在服务器和客户端分别插入任务适配器和模态适配器,就像给模型配备“多学科辅导老师”,让其在不同任务间灵活切换,有效提升了对多任务的适应性。
三、安全挑战:隐私泄露的“暗礁”
联邦学习的初衷是保护隐私,但大语言模型与联邦学习的结合却可能引入新的安全风险,就像在加密的保险箱里放入了易碎品,需要加倍小心。
隐私泄露攻击是最直接的威胁。恶意服务器或客户端可能通过模型参数或梯度推断出训练数据的细节,例如通过分析梯度更新还原出用户输入的文本内容,就像通过解题步骤反推出原题。DAGER攻击就利用了自注意力层的低秩结构和令牌嵌入的离散性,成功从共享梯度中恢复出完整的输入文本批次。为了应对这种攻击,研究员们采用了多层防御机制,如FedSecurity在训练的前、中、后阶段分别进行模型评分、几何中位数聚合和噪声添加,就像给数据加上“三重锁”,层层防护。
中毒攻击则试图污染模型的“学习内容”。恶意客户端可能在训练数据或模型参数中注入恶意样本,导致模型在特定输入下输出错误结果,就像在题库中混入错误答案,误导学生学习。例如,Backdoor攻击通过在模型中植入隐藏触发条件,使模型在遇到特定关键词时输出恶意内容。针对这类攻击,Dim-Krum算法通过计算客户端参数的维度距离,识别并剔除恶意更新,就像在考试中筛选出异常的答题思路,保证全局模型的纯净。
四、未来方向:突破边界的“新地图”
尽管面临诸多挑战,联邦大语言模型的未来却充满想象空间。研究员们正从以下几个方向探索新的可能性:
小样本学习:在医疗、金融等数据稀缺且敏感的领域,如何利用少量标注数据训练出高性能模型?FedIT-U2S框架通过Few-Shot提示技术,将非结构化文本自动生成结构化的指令-响应数据对,就像用少量例题推导出解题规律,大大降低了对大规模标注数据的依赖。
机器遗忘:当用户要求删除其数据时,模型需要“忘记”相关信息,这在联邦环境中尤为复杂,因为数据可能分散在多个客户端的历史更新中。CGKD框架通过知识蒸馏和适配器模块,在不影响模型性能的前提下删除特定数据的影响,就像从大脑中精准删除一段记忆,避免隐私泄露。
知识产权保护:大语言模型的训练成本高昂,如何防止模型被非法复制或滥用?FedIPR框架通过在模型参数中嵌入二进制水印或植入后门触发样本,就像给模型打上“电子指纹”,一旦被盗用即可追踪溯源,保护开发者的权益。
结语:隐私与智能的平衡艺术
联邦大语言模型的发展,本质上是一场隐私保护与人工智能发展的平衡探索。它既需要突破技术瓶颈,解决计算成本、异质性和安全风险,也需要在实际应用中建立信任机制,让数据所有者放心共享数据,让技术真正服务于社会。
或许在不久的将来,我们会看到这样的场景:医疗数据在各医院本地参与训练,共同提升疾病诊断模型的准确性,而患者隐私始终得到严格保护;金融机构通过联邦学习协同优化风控模型,既降低欺诈风险,又避免用户金融数据的泄露。这场隐私与智能的双向奔赴,正在为人工智能的可持续发展开辟新的道路。正如研究员们在论文中所言,联邦大语言模型的未来,需要更多跨学科的创新与协作,让技术在安全与效率的轨道上稳健前行。
作者:张长旺,图源:旺知识
参考资料
• 标题:Federated Large Language Models: Feasibility, Robustness, Security and Future Directions
• 作者:Wenhao Jiang, Yuchuan Luo, Guilin Deng, Silong Chen, Xu Yang, Shihong Wu, Xinwen Gao, Lin Liu, Shaojing Fu
• 单位:National University of Defense Technology
• 链接:https://arxiv.org/pdf/2505.08830