深度解析 Qwen3 Embedding:基于大模型的文本嵌入与重排序技术突破
旺精通:细节解读,深度精通
在自然语言处理与信息检索领域,文本嵌入与重排序技术始终是支撑搜索引擎、问答系统、推荐系统等核心应用的底层基石。随着大语言模型(LLM)的快速发展,如何将其强大的语义理解能力注入传统嵌入与重排序框架,成为学术界与工业界共同探索的前沿方向。近日,阿里巴巴通义实验室的研究员们提出了基于Qwen3大模型的新一代文本嵌入与重排序模型系列,在多语言语义表征、复杂指令理解及跨模态检索等任务上实现了突破性进展。
我们详细翻译解读最新论文,文末有相关信息。
作者:张长旺,图源:旺知识
一、技术架构:从大模型到专用模型的深度适配
Qwen3 Embedding系列模型的核心架构深度依托于Qwen3大模型的底层能力,采用"基础模型初始化+任务定向优化"的双层设计思路。在模型初始化阶段,直接复用Qwen3的0.6B、4B、8B三种规模的稠密模型参数,继承其在多语言文本理解、长序列建模和指令遵循方面的原生能力。
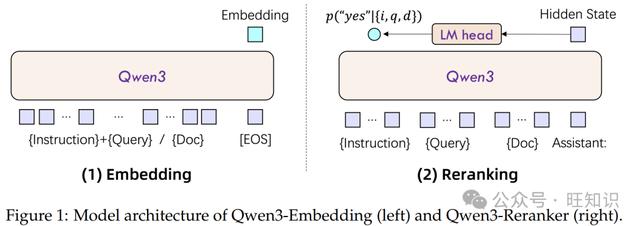
对于文本嵌入任务,模型采用因果注意力机制,通过在输入序列末尾添加[EOS]标记,提取最后一层隐藏状态作为最终嵌入向量。为实现指令感知能力,输入格式设计为"{指令}{查询}<|endoftext|>",使嵌入向量能够显式编码任务意图。例如在代码检索场景中,指令可指定"提取Python函数的逻辑特征",引导模型生成领域敏感的语义表示。
重排序模型则采用基于LLM的逐点排序架构,将相似度判断转化为二元分类问题。输入遵循Qwen3的对话模板,通过系统提示固定任务格式:"判断文档是否满足查询和指令要求,答案只能为'yes'或'no'"。这种设计使重排序模型能够直接利用LLM的推理能力,对查询-文档对的语义相关性进行深度语义匹配,例如在跨语言检索中,可通过指令指定"将法语查询与西班牙语文档进行语义对齐"。
二、训练范式创新:多阶段学习与数据智能合成
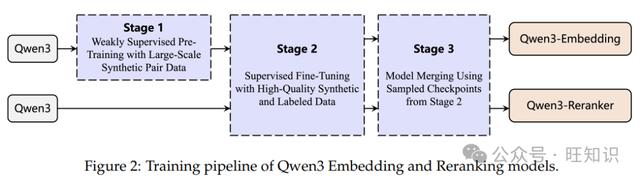
Qwen3 Embedding的训练流程突破传统Embedding模型的单阶段对比学习模式,构建了"大规模弱监督预训练-高质量监督微调-模型融合优化"的三阶段流水线:
1. 弱监督预训练:基于大模型的数据生成革命
传统方法依赖开源社区数据(如问答论坛、学术论文)构建弱监督训练对,面临数据分布偏差和语言覆盖不足的问题。Qwen3 Embedding创新性地利用Qwen3-32B模型的文本生成能力,通过多维度提示工程合成15亿对弱监督数据。具体实现包括:
角色注入:从Persona Hub获取500万用户角色,为每个文档生成符合特定角色的查询(如"作为机器学习工程师,如何优化Transformer模型训练效率")
任务定制:支持查询类型(关键词、事实型、摘要型)、难度等级(高中、大学、博士)、语言(覆盖106种语言)等12个维度的参数化控制
领域扩展:在代码领域,利用Qwen3预训练语料中的开源代码库,生成"代码功能描述-代码片段"对,覆盖Python、Java、C++等主流编程语言
2. 监督微调:质量优先的数据筛选机制
从弱监督数据中通过余弦相似度过滤(保留相似度>0.7的样本),得到1200万对高质量监督数据。这些数据在任务分布上进行了均衡化处理,包含52%的跨语言检索对、31%的长文档匹配对和17%的复杂指令对。在训练目标上,嵌入模型采用改进的InfoNCE损失函数,引入难负样本挖掘和虚假负样本过滤机制;重排序模型则使用标准交叉熵损失,强化对"yes/no"标签的预测准确性。
3. 模型融合:基于球面插值的参数优化
受启发于模型合并技术,训练后期对多个检查点进行球面线性插值(slerp),融合不同训练阶段的模型状态。实验表明,该步骤使MTEB多语言基准的平均任务得分提升3.2%,证明了通过模型多样性增强泛化能力的有效性。
三、性能突破:多维度基准测试中的领先表现
Qwen3 Embedding系列在四大类12个基准测试中展现出显著优势,尤其在多语言和代码领域实现对现有模型的全面超越:
1. 多语言语义表征:MTEB基准的全面领先
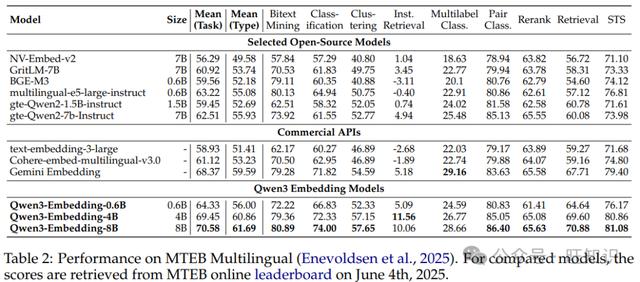
在覆盖250种语言的MMTEB基准中,Qwen3-Embedding-8B以70.58的平均任务得分刷新纪录,较谷歌Gemini-Embedding提升3.2%。在中文专项测试CMTEB中,8B模型在长文档检索任务上达到78.21的nDCG@10得分,较gte-Qwen2-7B-instruct提升9.3%。值得注意的是,0.6B轻量级模型在多语言任务上已接近Gemini水平,展现出卓越的参数效率。
2. 代码检索能力:突破跨语言代码语义鸿沟
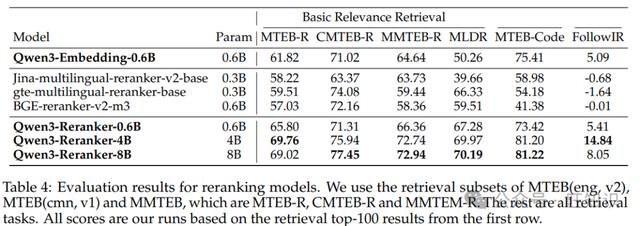
在MTEB-Code基准中,Qwen3-Embedding-8B在CodeSearchNet任务上取得92.66的nDCG@10得分,较英伟达NV-Embed-v2提升6.8%。其重排序模型Qwen3-Reranker-4B在代码编辑搜索任务中达到82.53分,证明了对代码语义细节的深度理解能力,这对软件开发场景中的代码推荐、漏洞检测等应用具有重要价值。
3. 复杂指令执行:FollowIR基准的指令跟随能力
在需要深度语义推理的FollowIR基准中,Qwen3-Reranker-8B在复杂指令检索任务中达到14.84的平均增益,较BGE-reranker-v2-m3提升237%。这表明模型能够有效解析"查找同时涉及量子计算和机器学习的最新研究,并排除理论性文章"等多层级指令,满足智能体(Agent)系统对精准信息筛选的需求。
四、技术价值与开源生态
Qwen3 Embedding的技术突破不仅体现在性能提升,更在于构建了"大模型驱动的嵌入学习"新范式:
数据生成工业化:通过LLM实现数据生成的参数化控制,使训练数据的语种覆盖、领域分布、任务类型可按需定制,尤其适合低资源语言场景
任务适配灵活化:支持自定义指令的模型设计,使同一套模型架构可快速迁移至电商搜索、法律文书检索、医疗文献匹配等垂直领域
模型部署轻量化:提供从0.6B到8B的多规格模型,兼顾边缘设备的实时响应需求与数据中心的复杂推理场景
目前,该系列模型已通过Hugging Face、ModelScope等平台开源(Apache 2.0协议),并提供完整的训练代码和测评工具链。开源仓库中包含针对金融、生物医学等领域的微调示例,为行业开发者提供了可落地的解决方案。
五、未来展望
在技术报告的结论部分,研究员们指出未来研究将聚焦于三个方向:一是探索基于跨模态大模型的图像-文本联合嵌入,二是开发支持实时反馈的动态重排序机制,三是优化模型在少样本场景下的快速适配能力。随着大模型与信息检索技术的深度融合,Qwen3 Embedding所代表的新一代语义理解框架,有望为智能搜索、知识图谱构建、智能体系统等领域开辟新的技术路径。
参考资料
《Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models》,Yanzhao Zhang等,阿里巴巴通义实验室,https://arxiv.org/pdf/2506.05176
《MMTEB: Massive multilingual text embedding benchmark》,Kenneth Enevoldsen等,https://openreview.net/forum?id=zl3pfz4VCV
《Gemini embedding: Generalizable embeddings from gemini》,Chankyu Lee等,https://arxiv.org/abs/2503.07891