手机也能跑大模型?MiniCPM4 如何让端侧 AI 突破算力天花板
旺晓通:深入浅出,轻松通晓
在这个AI大模型狂飙突进的时代,普通人对AI的印象似乎还停留在"云端巨兽"的阶段——需要庞大的数据中心、海量的算力支撑,才能让GPT这样的大模型"开口说话"。但最近,一个名为MiniCPM4的AI模型却打破了这种固有认知:它不仅能在手机、车载终端等端侧设备上流畅运行,还能在长文本处理任务中实现比同类模型快7倍的速度。这究竟是如何做到的?今天,我们就来揭开这个"端侧AI加速器"的神秘面纱。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、当大模型遇上"端侧困境":一场算力与性能的博弈
想象一下,你正在用手机处理一份几万字的合同,希望AI能快速帮你提取关键信息。但传统大模型可能会告诉你:"抱歉,算力不够,无法处理。"这就是当前AI应用面临的"端侧困境"——终端设备(如手机、平板、智能家电)的算力和存储资源有限,而大模型对计算资源的需求却呈指数级增长。
以常见的80亿参数大模型为例,其运行时需要的内存容量往往超过普通手机的硬件配置,更别提处理长文本时那令人崩溃的等待时间了。这就好比让一个壮汉挤在婴儿车里跑步,既施展不开,又容易"卡壳"。
研究员们早就意识到了这个问题。"我们不能总是依赖云端,"MiniCPM4团队的核心成员在论文中指出,"端侧设备才是AI与普通人交互的最前线。"于是,他们开始了一场旨在让大模型"瘦身"又"提速"的技术攻关。
二、MiniCPM4的四大"瘦身秘籍":从架构到推理的全链路优化
1. 建筑大师的"空间魔法":InfLLM v2稀疏注意力机制
传统大模型处理长文本时,就像一个强迫症患者,必须逐字逐句"精读"整个文档,哪怕只是找一个关键词。这种"密集型"注意力机制在算力有限的端侧设备上,简直就是"灾难"。
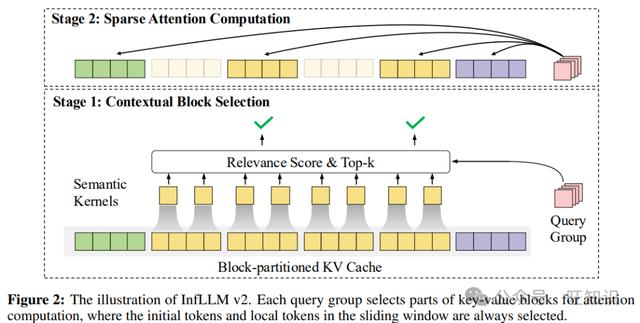
MiniCPM4的研究员们借鉴了图书馆管理员的工作方式——把长长的书架分成多个"区块",每次只关注最可能有需要书籍的几个区块。这就是他们提出的InfLLM v2稀疏注意力机制。
具体来说,InfLLM v2就像给大模型配备了一个"智能导航仪":
• 它会把输入的长文本分成多个"语义块",就像把图书馆的书按主题分类;
• 当处理新内容时,模型会先判断"最可能相关的几个区块",而不是全盘扫描;
• 通过动态调整关注的区块,它能在保持精度的同时,大幅减少计算量。
这种机制带来的效率提升是惊人的:在处理128K长度的文档时,MiniCPM4-8B相比Qwen3-8B实现了7倍的速度提升。就像从用放大镜逐字看书,变成了用目录快速定位关键章节。
2. 数据界的"精品超市":UltraClean与UltraChat v2的数据优化
大模型训练就像人类学习:吃进去的"知识"质量越高,学习效率就越高。但互联网上的数据就像一个大杂烩市场,充斥着大量重复、低质的信息。
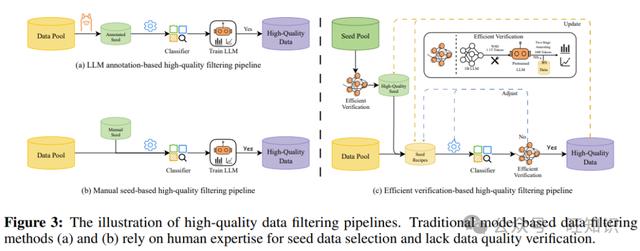
MiniCPM4的研究员们打造了两个"精品超市"级的数据处理系统:
• UltraClean:就像一个严格的"食材筛选师",它会用预训练好的模型作为"质检员",从海量网络数据中筛选出知识密度高、逻辑连贯的内容。传统方法可能需要36万亿tokens(token可理解为语言模型的基本处理单元)才能达到的效果,UltraClean只需8万亿tokens就能实现。
• UltraChat v2:专注于提升模型的"对话质量"。它不像普通对话数据那样追求表面多样性,而是注重多轮深度推理和任务复杂性,就像专门训练模型进行有深度的"学术讨论",而非闲聊。
这种"少而精"的数据策略,让MiniCPM4在知识密集型任务(如MMLU学术评估)中,以0.5B参数的模型规模,性能超过了1B参数的Llama3.2和Gemma3。
3. 训练算法的"智能教练":ModelTunnel v2与Chunk-wise Rollout
大模型训练就像运动员训练:找到最佳训练策略至关重要。但传统方法往往需要大量"试错",耗费大量算力。
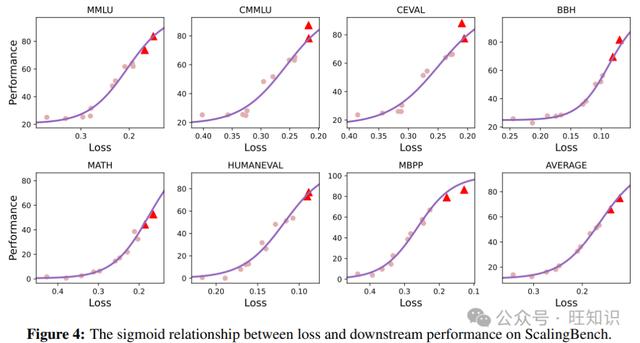
MiniCPM4带来了两位"智能教练":
• ModelTunnel v2:它会先在小模型上进行"模拟训练",就像教练先在沙盘上推演战术。通过构建ScalingBench评估体系,它能准确预测大模型的性能,将训练参数搜索成本降低90%以上。
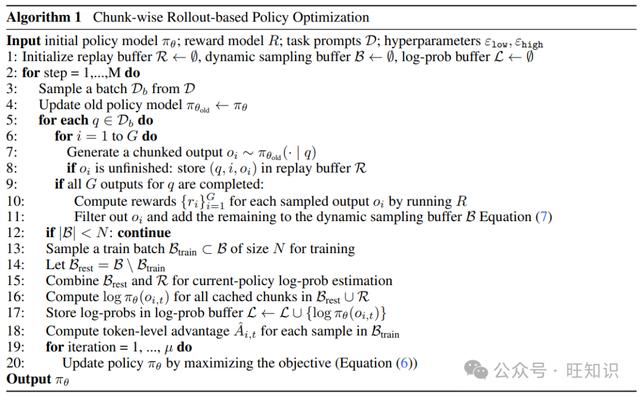
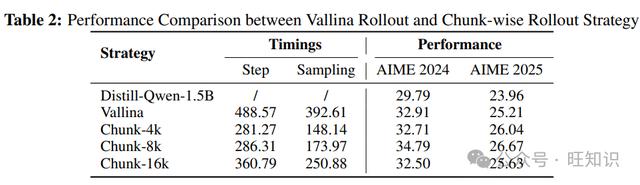
• Chunk-wise Rollout:针对强化学习中的"负载不均衡"问题,它把长序列生成任务分成多个"小块",就像把马拉松分成多个短跑段,每次只专注完成一小段,避免了传统方法中因长序列生成导致的算力浪费。实验显示,这种方法能将训练效率提升30%以上。
4. 推理系统的"极速引擎":CPM.cu与ArkInfer
即使模型"瘦身"成功,端侧设备的硬件差异仍是一大挑战。MiniCPM4打造了两套"定制引擎":
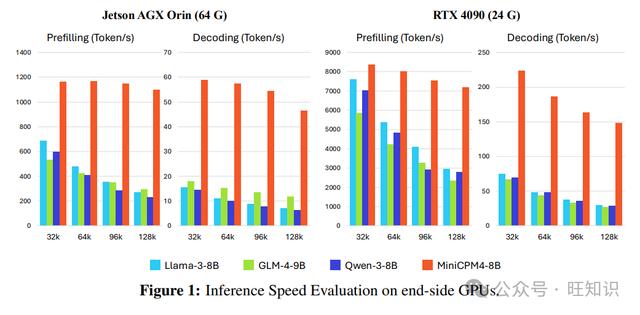
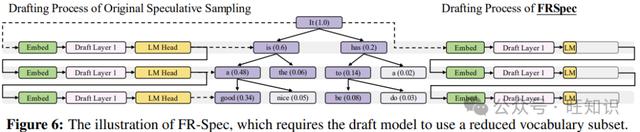
• CPM.cu:专为NVIDIA GPU设计的"极速引擎"。它集成了稀疏注意力、模型量化和投机采样技术,就像给汽车装上了涡轮增压。在Jetson AGX Orin设备上,处理32K长度文本时,MiniCPM4的解码速度达到了1400 Token/s,远超Llama-3-8B的600 Token/s。
• ArkInfer:跨平台的"万能适配器"。它能让模型在不同芯片(如联发科、高通)上高效运行,就像一个多语言翻译官,消除了硬件差异带来的障碍。
三、端侧AI的"超能力"展示:从长文本处理到工具调用
1. 长文本处理:从"龟速"到"闪电"
在长文本处理领域,MiniCPM4展现出了惊人的"速读"能力。传统模型处理128K长度的文档时,就像老牛拉车,而MiniCPM4借助InfLLM v2的稀疏注意力机制,实现了"跳跃式阅读"。
实验数据显示:在RTX 4090显卡上,MiniCPM4-8B处理128K文本的预填充速度达到了9000 Token/s,是Qwen3-8B的11倍。这意味着处理一份10万字的报告,MiniCPM4只需几秒钟就能完成初步分析,而传统模型可能需要一分钟以上。
2. 知识密集型任务:"小身材"也有"大智慧"
在衡量模型综合能力的MMLU(大规模多任务语言理解)评估中,MiniCPM4-0.5B的得分达到了55.55,超过了Llama3.2-1B的46.89和Gemma3-1B的41.64。这就像一个中学生在大学课程考试中,成绩超过了许多大学生。
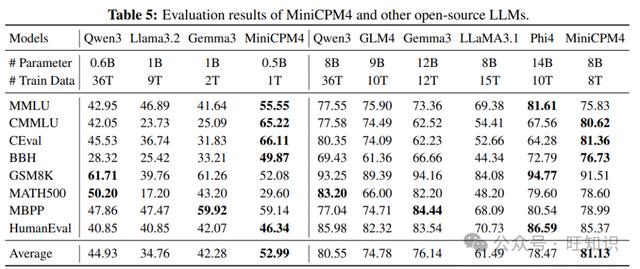
更令人印象深刻的是,MiniCPM4-8B在CMMLU(中文大规模多任务语言理解)评估中得分80.62,远超Qwen3-8B的77.58和GLM4-9B的74.49,展现出了在中文场景下的独特优势。
3. 工具调用:AI的"十八般武艺"
MiniCPM4还展现出了出色的"工具使用"能力。通过Model Context Protocol(MCP),它能像熟练的工匠一样,根据任务需求调用不同工具。
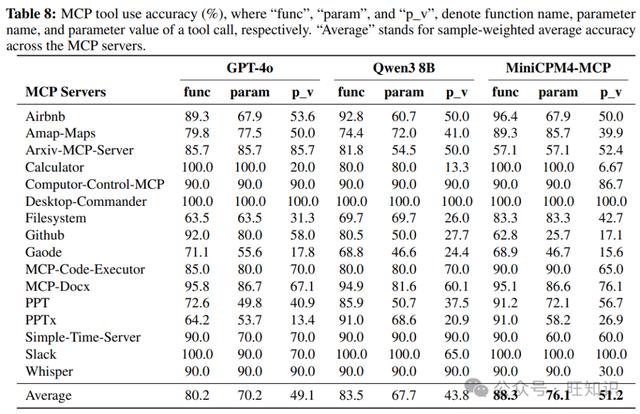
在实验中,MiniCPM4-MCP在工具调用的参数准确性上表现突出,尤其是在处理学术文献检索、数据分析等复杂任务时,其调用工具的准确率超过了Qwen3-8B。这意味着未来我们可能会看到这样的场景:手机上的MiniCPM4能自动调用文献数据库查找资料,再调用数据分析工具处理数据,最后生成一份完整的研究报告。
四、未来已来:端侧AI的无限可能
MiniCPM4的出现,标志着AI正在从"云端"走向"身边"。这种端侧大模型的普及,可能会带来以下变革:
1. 隐私保护的新境界
当AI模型在本地设备运行时,用户的数据无需上传到云端,这大大降低了隐私泄露的风险。就像把重要文件锁在自己家里的保险柜,而不是寄存在别人家。
2. 离线场景的全面赋能
在网络信号不好的地方(如地下停车场、偏远山区),端侧AI仍能正常工作。想象一下,在没有网络的航班上,你的手机AI能帮你处理文档、规划行程,甚至陪你下棋解闷。
3. 边缘设备的智能化升级
智能家居、自动驾驶汽车等边缘设备,将因端侧大模型的引入而变得更加"聪明"。例如,车载AI能实时理解乘客的复杂指令,甚至根据路况和乘客偏好自动调整导航和娱乐系统。
4. 算力成本的大幅降低
企业无需再为昂贵的云端算力付费,只需在终端设备上部署优化后的模型,就能实现类似的功能。这对于中小企业而言,无疑是降低AI应用门槛的福音。
五、结语:AI民主化的新里程碑
MiniCPM4的突破,本质上是AI民主化的重要一步。它让普通人无需依赖昂贵的云端服务,就能在自己的设备上享受到强大的AI能力。就像个人电脑的普及让计算能力走进千家万户一样,端侧大模型的发展可能会让AI能力成为每台智能设备的"标配"。
当然,挑战依然存在:如何进一步降低模型大小、提升效率,如何在更多类型的设备上实现高效部署,如何确保端侧AI的安全性和可靠性等。但MiniCPM4团队的研究员们已经迈出了坚实的一步,他们在论文中展望:"未来,我们将致力于让LLM(大语言模型)在端侧设备上处理'无限长'的序列,并构建更丰富的推理密集型数据集。"
或许不久的将来,我们每个人的口袋里,都会装着一个能理解、会思考、懂协作的"AI伙伴",它无需联网,就能随时为我们解决各种问题,让AI真正成为提升生活和工作效率的得力助手。
参考资料
《MiniCPM4: Ultra-Efficient LLMs on End Devices》,MiniCPM Team,https://arxiv.org/pdf/2506.07900v1
《InfLLM: Training-free Long-context Extrapolation for LLMs with an Efficient Context Memory》,Chaojun Xiao等,https://arxiv.org/abs/2402.04617
《Ultra-FineWeb: Efficient Data Filtering and Verification for High-quality LLM Training Data》,Yudong Wang等,https://arxiv.org/abs/2505.05427
《FR-Spec: Accelerating Large-vocabulary Language Models via Frequency-ranked Speculative Sampling》,Weilin Zhao等,https://arxiv.org/abs/2502.14856