XALPHA:当AI学会“反思”,用记忆驱动闭环研究,颠覆量化因子发现
“XALPHA: A Memory-Driven AI Quant Researcher for Hypothesis-to-Code Alpha Discovery”
量化投资的圣杯,是持续发现那些能穿越牛熊、预测未来的交易信号(Alpha)。然而,金融市场噪声弥漫、结构瞬息万变,传统的因子挖掘如同在迷雾中蒙眼寻宝——手工设计效率低下,机器学习模型黑箱不透明,而即便最前沿的大语言模型(LLM)框架,也大多在孤立地生成或搜索因子,缺乏人类研究员那种“读报告、提假设、写代码、回测、反思、再来一次”的完整科研循环。
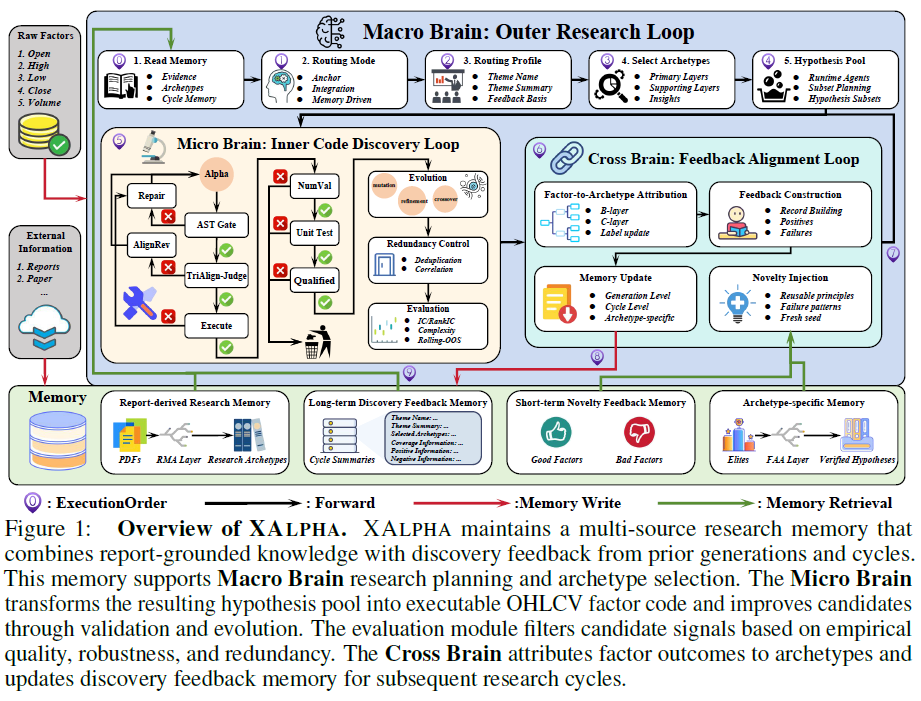
为了打破这一僵局,香港大学与Grace Investment Machine的研究团队提出了XALPHA——一个记忆驱动的AI量化研究员。它的核心创新,在于为AI装上了一套“科研记忆系统”:既能吸收研报中的金融知识,又能记住每一次挖掘的成功与失败。在这个基础上,一个“宏观大脑”负责制定研究方向、避开已知陷阱;一个“微观大脑”则精确地将金融假设转化为可执行的因子代码,并严格检验其逻辑与金融合理性;最后的“交叉大脑”将实验结果固化为经验,反哺给下一次的研究循环。这种闭环设计,让XALPHA的Alpha挖掘过程从一个“一次性生成”的孤立任务,蜕变为一个持续“阅读、假设、实现、验证、反思、进化”的自主研究过程。在CSI300指数上的实证表明,其发现因子的信息比率(IR)高达1.54,远超第二名AlphaAgent的0.95,在预测力和鲁棒性上实现了质的飞跃。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
金融市场具有噪声大、非平稳和高维度的特点,使得发现具有预测力和鲁棒性的交易信号(即Alpha)变得困难。现有的Alpha发现方法大多自动化了因子生成、搜索和评估等孤立步骤,而非作为端到端的量化研究员,去吸收外部知识、闭环假设验证并学习累积的发现反馈。为填补这一空白,本文提出了XALPHA,一个用于持续“假设到代码”Alpha发现的记忆驱动型AI量化研究员。
XALPHA维护一个多源研究记忆系统,将报告中的金融知识与先前迭代和研究周期的发现反馈相结合。在此记忆系统的引导下,宏观大脑(Macro Brain)规划研究主题并选择合适的研究原型(Archetype);微观大脑(Micro Brain)将假设池转化为可执行的因子代码,并验证假设、代码逻辑与金融合理性之间的事前三方对齐;交叉大脑(Cross Brain)则将实证结果整合为面向未来探索的反馈。通过这种方式,XALPHA将Alpha挖掘从孤立的因子生成转变为一个持续“阅读、假设、实现、验证、反思、进化”的闭环研究过程。在CSI300上的实验表明,XALPHA在整体Alpha发现性能上优于代表性基线方法。
简介
Alpha挖掘旨在发现能根据历史市场观测预测未来资产收益的交易信号,是量化投资的核心问题,但因市场噪声和非平稳性而颇具挑战。当前自动化方法多聚焦于因子的搜索、生成或评估等孤立环节,而非像人类量化研究员那样进行完整的“假设到代码”闭环研究。传统人工因子设计可解释性强但耗时且难以规模化。机器学习与进化搜索方法虽提升了建模能力,但所学信号通常不透明或缺乏经济逻辑。
最近,基于大语言模型(LLM)的系统开始在因子生成、公式优化和多智能体协同方面自动化更高层次的研究决策,但现有系统仍未将外部知识吸收、研究记忆、假设规划、代码实现、实证验证和反馈整合为一个闭环的、持续演进的AI量化研究员。为弥补这一空缺,本文引入XALPHA,一个将Alpha挖掘构建为报告支撑、记忆驱动、持续“假设到代码”研究循环的AI量化研究员。
相关工作
基于LLM的Alpha挖掘
自动化Alpha挖掘已从人工设计发展到机器学习、遗传规划和强化学习。近期LLM方法,如AlphaGPT、FAMA、AlphaAgent、AlphaJungle、RD-Agent(Q)等,尝试利用语言模型进行金融推理和因子生成,但大多聚焦于因子构建或优化,而非完整的研究循环。更近的框架如FactorMiner引入了技能和经验记忆,CogAlpha则将Alpha表示为可执行代码并应用进化搜索,但均未完全整合报告知识、宏观规划和发现反馈。
自主研究智能体
近来,AI科学家、AI协同科学家(AI Co-Scientist)和进化科学家(EvoScientist)等自主研究智能体展示了LLM在长期科学研究工作流中的潜力。这些系统强调了记忆、自我进化和外部知识获取的重要性。然而,它们并非为金融Alpha发现而设计。XALPHA将该范式适配到金融领域,通过一个持续的研究循环,将金融知识中的假设落地为因子代码,并验证其合理性与实证表现
方法
XALPHA被设计为一个持续“假设到代码”Alpha发现的AI量化研究员,由报告到记忆吸收层(RMA)、宏观大脑、微观大脑和交叉大脑四部分组成,形成一个迭代研究循环。
报告到记忆吸收层(RMA)
受结构化记忆构建启发,RMA层负责将外部研究报告转化为结构化的、可检索的知识记忆,使其兼容于日频OHLCV因子工作流。RMA通过一个三层A/B/C分类法组织知识:
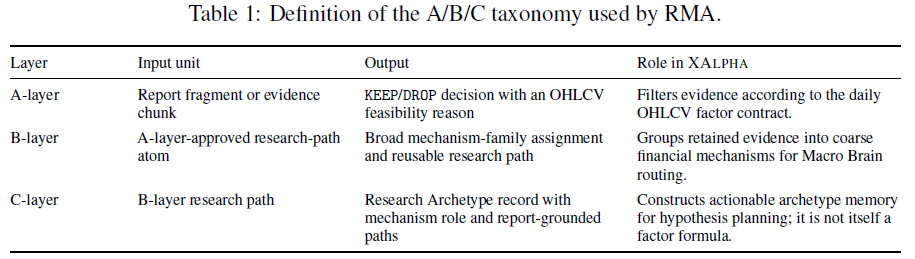
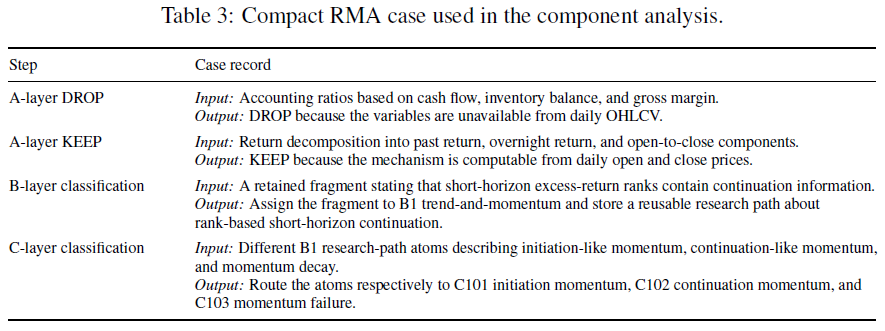
A层(OHLCV可行性层):评估报告片段的核心机制是否能用日频开、高、低、收、量数据直接观察、推断或稳定代理。可行的保留(KEEP),不可行的丢弃(DROP)。例如,基于现金流、存货的会计比率因无法由OHLCV数据表示而被否决,而包含过去收益、隔夜收益和开盘到收盘收益分解的片段则被保留。
B层(机制族层):将保留的研究路径归类为如趋势与动量、反转与均值回归等宽泛的金融机制族,供宏观大脑路由。
C层(可操作原型记忆层):将B层研究路径特化为“研究原型”记录,包含机制角色和报告依据的研究路径,作为后续假设生成的检索提示。C层原型本身不是因子公式。
宏观大脑:研究规划与原型路由
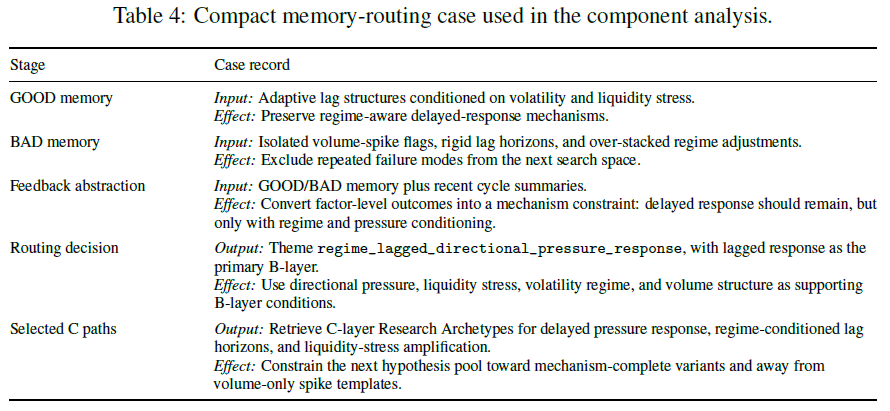
宏观大脑是XALPHA的周期级研究规划器。它根据检索到的B/C层知识和累积的发现反馈,确定研究主题,选择合适的研究原型并构建假设池。其路由模式包括:固定主题、粗略引导和记忆驱动。默认情况下,XALPHA先进行5轮粗略引导周期初始化反馈,然后切换到记忆驱动模式。在记忆驱动模式下,宏观大脑利用好/坏(GOOD/BAD)摘要、周期结局和原型覆盖记录来识别信息缺口,避免饱和或反复失败的研究方向。随后,它选择1个主要B层和3-4个辅助B层,并检索相应的C层研究原型,组织成“活跃研究智能体包”,输出给微观大脑。
微观大脑:从假设到代码的因子进化
微观大脑是XALPHA内部的因素发现循环。它首先将宏观大脑生成的假设池转化为可执行的Python因子代码作为初始因子。之后主要通过代码进化生成新因子,进化操作包括:
变异: 创建父因子的机制级变体。
交叉: 重组两个父因子的机制形成新的联合假设。
精炼: 保留核心机制,简化非必要实现。
所有生成的因子在实证评估前必须通过质量流程,包括AST静态检查(拒绝无效语法、静态未来泄漏等)、三方对齐校验(验证假设、代码与金融合理性)、数值验证以及截断和未来噪声扰动单元测试以检测动态泄漏。通过检验的因子进入进化过程。此外,微观大脑还在配置的中间点执行新颖性注入(当前设置为每4代触发一次),以刷新搜索空间。新注入的因子需与现有池的相关性低于0.95以避免冗余。
因子评估与选择
评估模块使用标准横截面预测指标,如信息系数(IC)、IC信息比率(ICIR)、排名IC(RankIC)和排名ICIR(RankICIR)。因子方向被对齐,使更高分数表示更强的预测质量。选择过程包含:
常规门控(Normal Selection):基于训练集证据,用于维护后续进化的父代池。它要求RankIC>0.005且正比例>0.50,预热期保留前45%。
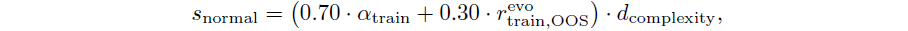
精英门控(Elite Selection):使用训练-验证证据,门槛更高(RankIC>0.01,正比例>0.55),用于保留跨代强健机制。预热期仅保留前15%。
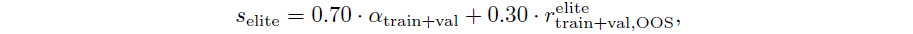
库收录(Library Admission):在周期结束时进行,刷新并重新评估精英因子,超过阈值0.65且排名前一半的候选进入最终库。报告库中最多保留40个最大绝对相关性低于0.60的因子。
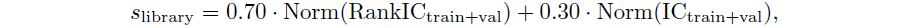
交叉大脑:因子归因与反馈整合
交叉大脑将实证因子结果与研究分类和反馈记忆连接起来,其功能包括:
因子到原型归因(FAA):为经过修复、变异或交叉的精英因子重新分配有效的B层机制族和匹配的C层研究原型。
GOOD/BAD反馈构建:将因子结果转化为机制层面的GOOD/BAD摘要,记录验证过的机制、失败模式及可复用原则或规避规则,而非仅存储得分。
多级记忆更新:将反馈写入三级记忆:原型级(为C层原型贡献已验证的假设)、代际级(为周期内新颖性注入提供短期反馈)和周期级(生成端到端摘要指导后续路由)。
实验
实验设置
数据集:CSI300,来自Qlib的日频数据,预测目标为10日未来调整后开盘到开盘收益率。时间划分:训练(2011-2020)、验证(2021)、测试(2022-2025)。
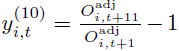
模型与运行:默认LLM为gpt-oss-120b,使用Ridge回归(α=10.0)用于组合报告。每个挖掘周期从64个初始种子因子开始,维护最多80个父代池,运行10代,新颖性注入间隔为4。常规和精英选择百分位阈值分别为60和80。
与代表性基线的比较
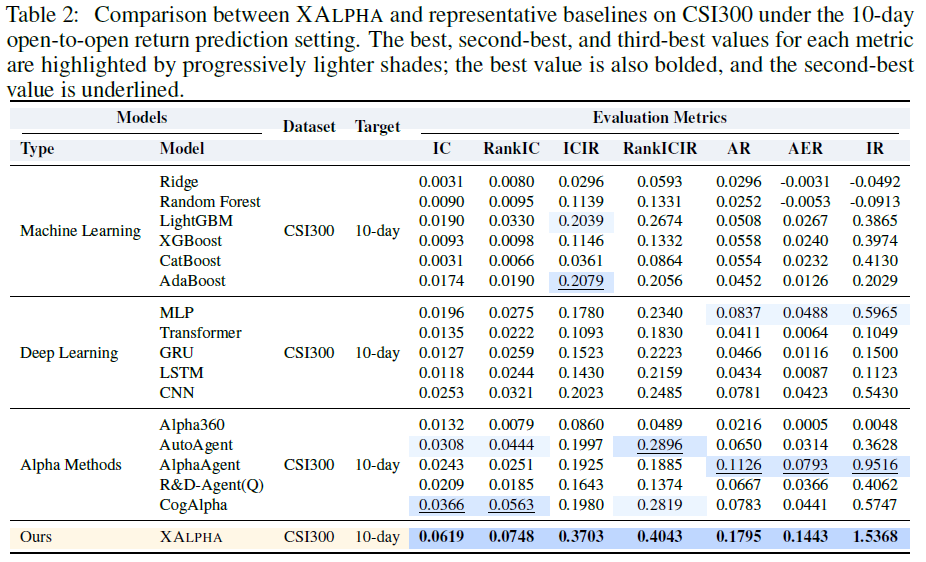
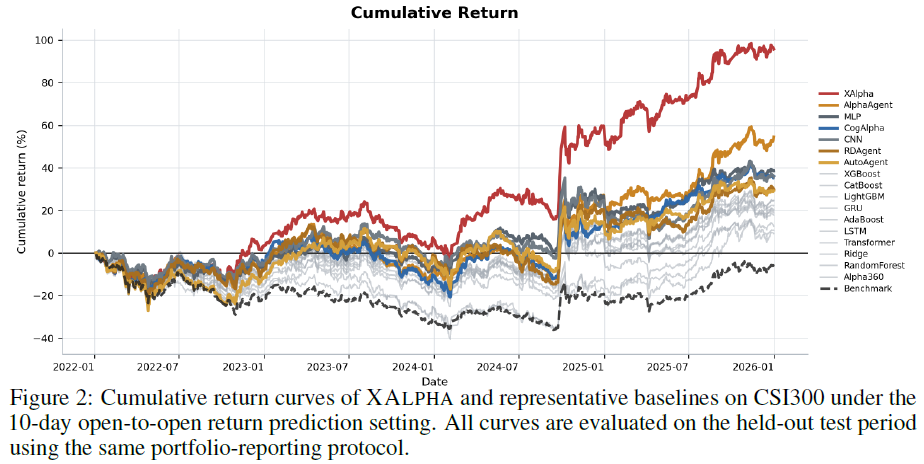
在CSI300的10日设置下,XALPHA与多种机器学习、深度学习及Alpha方法基线对比。在所有七个报告指标(IC、RankIC、ICIR、RankICIR、年化收益率AR、年化超额收益AER、信息比率IR)上,XALPHA均取得最佳值。其IC为0.0619,RankIC为0.0748,ICIR为0.3703,RankICIR为0.4043,AR为0.1795,AER为0.1443,IR为1.5368。相较于第二名AlphaAgent(IR为0.9516),XALPHA的持有期组合表现显著更优。
组件分析
RMA案例分析:展示了RMA如何将报告片段转换为A/B/C记忆,例如一个短期超额收益排名包含持续信息的片段被归类为B1趋势与动量族,并路由至C101启动动量、C102持续动量和C103动量失败等原型。
记忆路由案例分析:展示了宏观大脑如何利用GOOD/BAD记忆将“适应性滞后结构”确立为有用方向,同时排除“孤立成交量尖峰”等失败模式,最终路由到主题regime_lagged_directional_pressure_response,并选择相应B层和C层路径。
精英单因子多样性
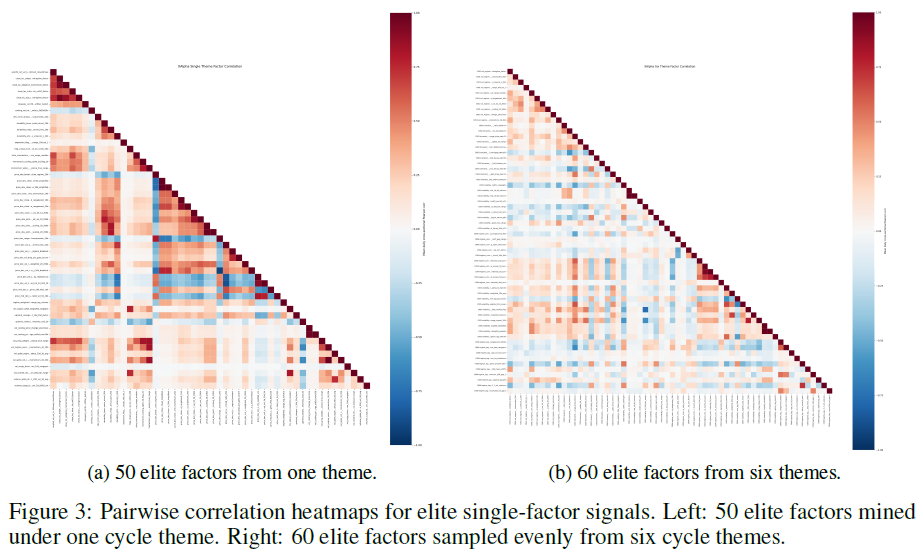
分析显示,在单一主题(vol_regime_breakout_interaction)下挖掘的50个精英因子,平均绝对成对相关性为0.234,中位数为0.181,68%的因子对相关性低于0.3。从六个主题中采样的60个精英因子,平均绝对相关性降至0.142,中位数降至0.099,87.1%的因子对相关性低于0.3。这表明XALPHA既能在一题内挖掘多样性因子,也能跨主题扩大机制覆盖。
生成因子的可解释性
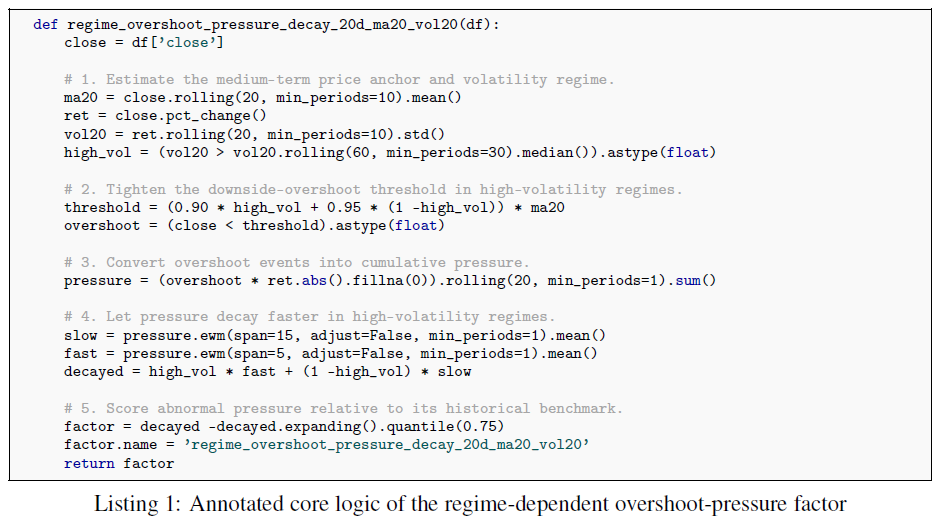
展示了一个代表性精英因子:基于波动率状态的下行超调压力衰减因子。该因子计算20日均线锚点、20日波动率状态,对下行超调事件按绝对收益加权,累积后用状态依赖的指数加权移动平均(EWMA)进行平滑,最后以历史基准居中。其训练-验证IC为0.0382,RankIC为0.0564;测试集IC为0.0440,RankIC=0.0634。这证明了代码级Alpha发现仍能产生具有清晰金融逻辑的可读信号。
计算成本
在主要CSI300设置下,生成一个因子平均耗时约15秒,运行一代(10代)约16分钟,一个完整挖掘周期约3小时。所有主实验在两张H100 GPU上进行,进化过程使用本地部署的gpt-oss-120b模型,无外部API成本。
总结
本文研究了如何在噪声、非平稳和高维的金融市场中构建一个持续进行Alpha发现的AI量化研究员。XALPHA通过报告支撑、记忆驱动的“假设到代码”研究循环,连接了外部知识、可执行因子实现、实证验证和发现反馈。在CSI300上的实验证明XALPHA能发现比代表性基线更具预测力和鲁棒性的Alpha因子。未来工作将扩展到更广泛的股票池、更多预测周期、更丰富的金融数据源以及真实交易环境,以进一步验证其实用性。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
