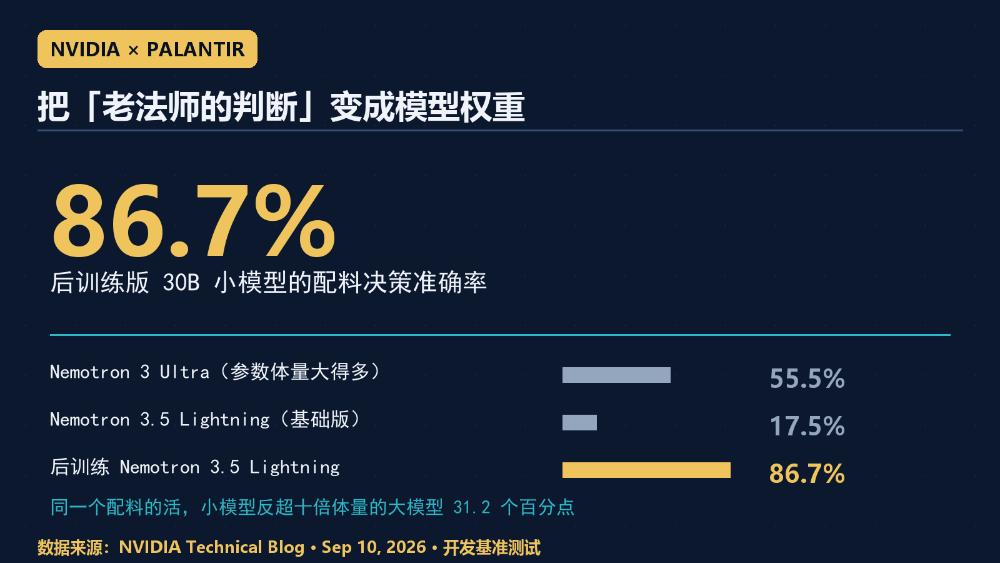
摘要:英伟达用 Palantir Ontology 捕获配料决策的理由与结果,后训练 Nemotron 3.5 Lightning,在开发基准上做到 86.7%,反超体量大得多的大模型 31.2 个百分点。
文末阅读原文可获取原文 PDF 和中文解读 PPT
▍ 一、先看一个反差的数字
86.7%。
这是英伟达一个 300 亿参数的模型,在一项"该给哪个工厂分多少料"的任务上拿到的准确率。
同一份测试数据,这家公司体量大得多的 Nemotron 3 Ultra 拿了 55.5%。而没经过后训练的基础版 Nemotron 3.5 Lightning,只有 17.5%。
也就是说,这个 300 亿参数的小模型,比大它一个数量级以上的通用大模型高了 31.2 个百分点,比自己没训过的版本高了 69.2 个百分点(数据来源:NVIDIA Technical Blog,2026 年 9 月 10 日《From Wafer-Out to First Token》)。
一个大厂用最小的模型打赢了自己最大的模型——如果只看数字,这是个可以被写烂的标题。
但我读完原文之后,觉得真正值得写下来的不是这 86.7%,而是英伟达为了让这个数字成立,先花了多大力气去记录"人为什么这么决定"。
这篇文章想讲的就是这件事:一个工业级的决策智能飞轮,是怎么从"老师傅的直觉"一路变成"模型权重"的。
▍ 二、背景:英伟达的供应链到底难在哪
先摆几个原文里的数字,感受一下规模。
英伟达的供应链绩效,用一个词衡量:从晶圆出厂到第一个 token(wafer-out to first token)。这个区间被切成两段——Time-to-rack 是硅片离开晶圆厂、到装好的整机落地数据中心地板;Time-to-token 是之后的所有事,供电、散热、网络、以及让这套基础设施第一天就能干活的软件栈。
这套系统的复杂度长这样:
• Grace Blackwell NVL72 平台涉及数百万个零件、数千家供应商,分布在全球,最终整机由数十家 OEM 和 ODM 组装完成。
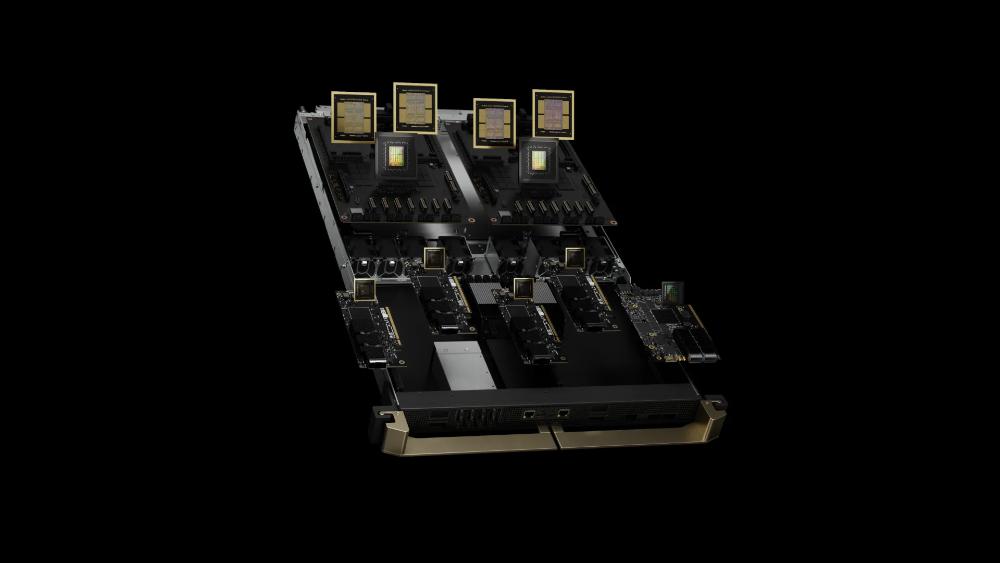
• 单个机架里有 18 个 compute tray,而其中一个 compute tray 就要 2 颗 Grace CPU、4 颗 Blackwell GPU、32 组 HBM3e 堆叠。
• 为 Vera Rubin 建的那条供应链,规模是 Grace Blackwell 的两倍。
而 CPU、GPU、内存全是关键件,且可用性每周都在变——这周卡住这个机型的料,下周可能到处都是。
原文里有句话我觉得写得特别准:把这些乘以上机架里每一个子装配,"结果就不太像一条供应链,更像一个让人头皮发麻的组合数学问题"。
在这个背景下,英伟达每周要做一件事:决定把什么料、多少量,分给哪个制造基地。这叫关键物料分配问题(critical material allocation),目前是每周人工重排一次。
分配窗口覆盖本季度和下一季度,其中最近的几周已经承诺出去了,所以每周进来的新数据,主要改变的是更远期的安排。
原文明确说,压缩 time-to-rack 需要四样东西:
1. 实时可见性,能随时定位关键瓶颈;
2. 冗余,避免单点故障停线;
3. 可靠性,让上游的生产承诺站得住;
4. 把人的专业判断固化下来(codified human expertise),让复杂分配决策背后的判断变成可累积的持久知识。
原文紧接着补了一句很关键的话:前三样是运营基线,但真正带来转变的,是第四样。
——这就是全篇的题眼。
▍ 三、方法:先搭地基,再让机器算
▪ 3.1 在 Palantir Foundry 里建一个指挥中心
英伟达供应链运营团队和 Palantir 合作,做了一件事:把每一次物料分配决策所依赖的全部输入,收进同一个视图。
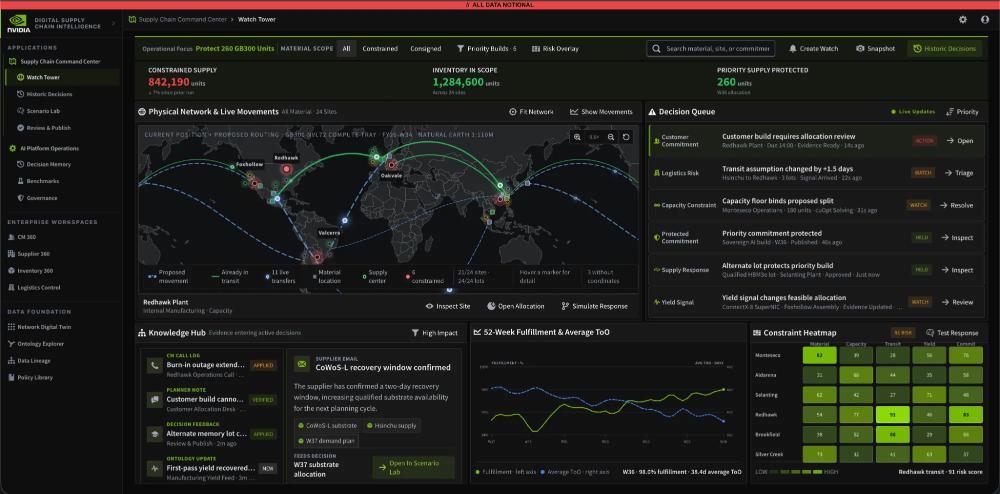
他们管这个叫 Digital Supply Chain Intelligence 指挥中心。它的作用是把风险、阻塞项和其他信号浮到面上——这些东西过去散落在互不相通的数据源里,其实一直在影响决策,只是没人能一眼看全。
底层是 Palantir Foundry 提供运行上下文,核心是 Ontology(本体):它把物料、制造基地、生产承诺、产能、分配、产出,以及非结构化的定性信号,连成一个受治理的数据层。
原文有一句定义式的描述我建议记住:它由对象和链接(objects and links)构成,而不是行和表(rows and tables),因此形成了对运营现实的完整表达。
这句话是整个技术方案的枢纽。行和表只装得下"数字",对象和链接才装得下"关系"和"上下文"——而人的判断,恰恰活在关系里。
有了这层表达,分配计划员就能模拟和分析各种场景,对决策空间的访问范围一下子大得多,也为后面那台"AI 飞轮"铺好了地基。
图 · 图1 单个 GB200 NVL72 compute tray 的关键组件
图 1(原文 Figure 1):这块 compute tray 需要 2 颗 Grace CPU、4 颗 Blackwell GPU、32 组 HBM3e——全是可用性每周都在变的关键件。原文图注:The GB200 NVL72 compute tray requires two Grace CPUs, four Blackwell GPUs, and thirty-two HBM3e stacks, all of which are critical components with dynamic availability
图 · 图2 Palantir Foundry 中的统一运营视图
图 2(原文 Figure 2):指挥中心的真实面貌。左侧是应用与企业工作区,中间是全球物料与物流视图(含产能/在库/优先需求/受限物料四个关键计数),右上角是"决策队列"——客户承诺、物流风险、产能受阻、受保护承诺逐条列出并标注动作(Action / Triage / Resolve / Inspect),底部三块是知识中枢、52 周履约与平均 TOO 曲线、约束热力图。原文图注:Unified operating picture for NVIDIA supply chain in Palantir Foundry
▪ 3.2 用 cuOpt 解那个"数学问题"
分配问题首先是个定量问题。原文把它的建模思路说得很清楚:
决策变量是——在接下来这段时间里,每种受限物料给哪个基地、给多少、什么时候给。
约束环绕在周围:
• 能做某个 Blackwell 子装配的所有制造商,以及物料落地后各基地能吃下的产能;
• 每一个必需零件反向映射出来的依赖图,这样求解器才知道"一个 compute tray 是被它最紧缺的那一项卡的,而不是被平均情况卡的";
• 客户已经做出的承诺——它决定了某个基地出现缺口到底意味着多大代价。
而那个卡脖子的约束不是固定的,它在几个维度之间游走:GPU、CPU、内存的紧张程度每周换人;三条供应路线的到货时间;已承诺的客户订单;几千个变量和约束,最后收敛成每周一个分配方案。
干这件事的是 NVIDIA cuOpt,一个开源、GPU 加速的决策优化库。它从 Ontology 取输入,把结果写回 Ontology 作为一次分配决策。分配被建模成混合整数线性规划(MILP),目标函数是最小化 Time of Ownership(TOO)。
cuOpt 给出的不只是分配结果。它还会报告哪些约束是紧的(binding)——所以计划员能看到,压住本周这个数字的是台湾的产能,而不是内存供给。
因为求解够快,计划员还能在答案周围探路:如果这期内存少 10% 会怎样?如果上线一个新的制造基地会怎样?
原文对这一幕的概括我很喜欢:计划员不再问求解器"答案是什么",而是开始问它"代价是什么"。
▪ 3.3 数学停在哪里
这是全文最重要的一节。
英伟达和 Palantir 做了一件事:把历史上的分配决策,拿回去和实际发生的结果做回测(back-test)。结果暴露了一个 cuOpt 没捕捉到的因素——人的因素。
计划员当时用的是求解器看不见的信息:
• 那一周和合作伙伴往来的邮件;
• 关键地区预报里的恶劣天气,或者正在发生的地缘政治事件;
• 上一次供应商复盘电话的会议记录;
• 以及多年积累的经验。
原文对此的表述非常坦率:这些输入喂养出一种关于"接下来这期该怎么分料"的直觉,而正是这种直觉,让人比数学更准。
看到这句话时我停了一下。这不是一篇评测文,这是一篇英伟达自己发的技术博客。它公开承认:在真实决策里,人类专家系统性地优于他们自己的定量模型。
而且它没有去想办法消灭这个人。相反,整个工作流是围绕这些人建的。
具体做法是:捕获分配决策本身、决策背后的理由(rationale)、预期结果、以及实际结果。于是机构知识变成了显式的、可复核的决策逻辑;又因为这些数据活在 Ontology 里,它就顺理成章地成了训练一个大模型去学习专家判断的底座。
——从"记录人",到"学习人"。这一步转折,是整篇文章真正的分水岭。
▍ 四、结果:把决策智能固化下来
▪ 4.1 训什么样的模型
英伟达评估了 Nemotron 系列之后,选了 Nemotron 3.5 Lightning。
选它的理由和"能力最强"无关,而是定位:它是专门为智能体工作流的执行层打造的。也就是说,它不负责统筹,它负责在一个模型系统里干专门的活——更大的变体用于编排和通用任务,它负责落地执行。
它的 MoE(混合专家) 架构适合高效推理。体量上,300 亿参数、每次前向传播约 30 亿激活——够轻,但仍然大到能学一个聚焦的策略。
这个尺寸的选择是有讲究的:原文说得很直白,更小的模型学得更快,训练和部署所需算力都远少于大模型,这才让"后训练循环"这件事在工程上可行。
还有一个前提是开放的:因为 Nemotron 是开源的,它可以在你自己的算力边界内做后训练。任何组织都能拿自己的运营数据跑同一套飞轮,而不必把数据暴露出去。
训练目标写得很具体:固化一个分配策略,让它能够评估生产风险、给出分配区间、指出推荐背后的因素、并向供应链团队解释自己的推理。
而同一份记录还兼职干第二件事——它就是评测装置:拿每一条历史决策重放,只喂当天可知道的信息,把结果藏起来,然后把模型推荐和计划员当时的判断、以及实际发生的结果三方对比。
原文给这个评测定了一个问题,我认为是全文最好的一句话:
"If this model had been running last month, would it have made the right allocation call?"
(如果上个月就跑了这个模型,它会做出正确的分配决策吗?)
▪ 4.2 数据从 Ontology 到专用模型的四步
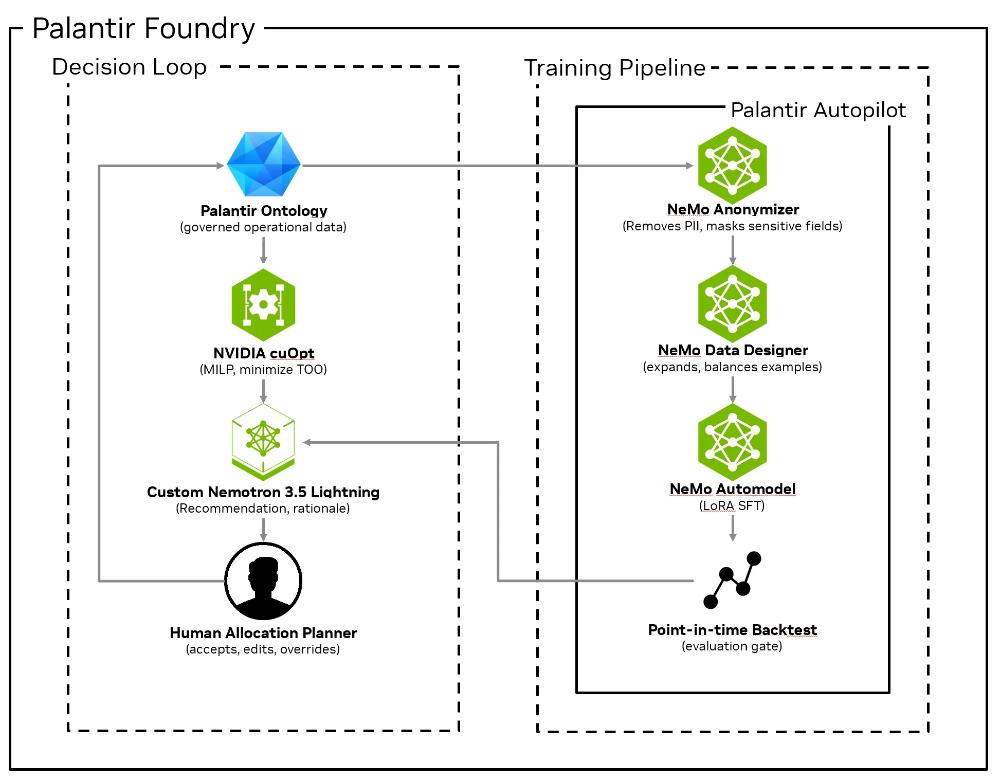
图 · 图3 决策循环与训练流水线共享同一受治理数据层
图 3(原文 Figure 3):左边是决策循环——Palantir Ontology(受治理的运营数据)→ NVIDIA cuOpt(MILP,最小化 TOO)→ 定制 Nemotron 3.5 Lightning(推荐 + 理由)→ 人类分配计划员(接受、编辑、覆盖);右边是训练流水线——NeMo Anonymizer(去 PII、遮蔽敏感字段)→ NeMo Data Designer(扩增、平衡样本)→ NeMo AutoModel(LoRA SFT)→ 时点回测(评估门)。两侧通过 Palantir Autopilot 串成一条首尾相接的链路。原文图注:Allocation decisions and model training share one governed data layer. Planner decisions become training data, and a point-in-time backtest gates every deployment
这张图值得多看一眼,因为它把"飞轮"画成了两条相互咬合的链路:
左边是决策日循环——数据(Ontology)→ 求解(cuOpt)→ 建议(模型)→ 人类拍板,人拍板的结果又流回 Ontology。
右边是训练循环——同一份 Ontology 数据过四道工序:
1. 匿名化(NeMo Anonymizer):训练前移除个人可识别信息,遮蔽敏感字段。
2. 合成数据生成(NeMo Data Designer):扩增并平衡样本,让模型不只看到routine 的普通周,还能看到保供加量、产能受限、供应中断这些异常场景。
3. 监督微调(NeMo AutoModel):只训练一小组 LoRA 适配器参数,基础权重保持冻结——从而压低训练时间、显存占用和检查点体积。
4. 评估(时点回测):把同一批历史决策分别喂给基础模型和后训练模型,隔离出"后训练到底加了什么"。
而 Palantir Autopilot 端到端管这条生命周期:每次作业都从 Ontology 数据启动,监控部署后的定制 Nemotron,并保持从数据到模型版本到推荐结果的血缘完整。
部署之后,模型读当前运营上下文,返回推荐 + 理由 + 附带风险。计划员看一遍,做最终决定。
——注意这个分工:模型有建议权,人有决定权。 原文从头到尾没有让步过这一点。
▪ 4.3 飞轮怎么转完全圈
每一次接受、编辑、覆盖,以及每一个实际产出,都写回 Ontology,一路累积,直到有足够代表性的数据,来支撑下一次受治理的训练。
未来这套反馈会用于强化学习:被接受和被覆盖的推荐会构成偏好对(preference pairs),奖励项覆盖分配正确性、策略合规性、证据扎根性。
原文有一句很硬的约束我必须原文引出来:"The model never retrains itself in production."(模型从不在生产环境里自己重训。)
这句话是整个方案的分量所在。飞轮转得再快,每一圈都要过治理门。
收益是复利的,分两条:计划员少花时间重建常规决策,能覆盖更多基地和产品;同时分配经验变成机构知识,缩短新人上手周期,把关键经验扩散到整个组织。
▪ 4.4 后训练到底交付了什么
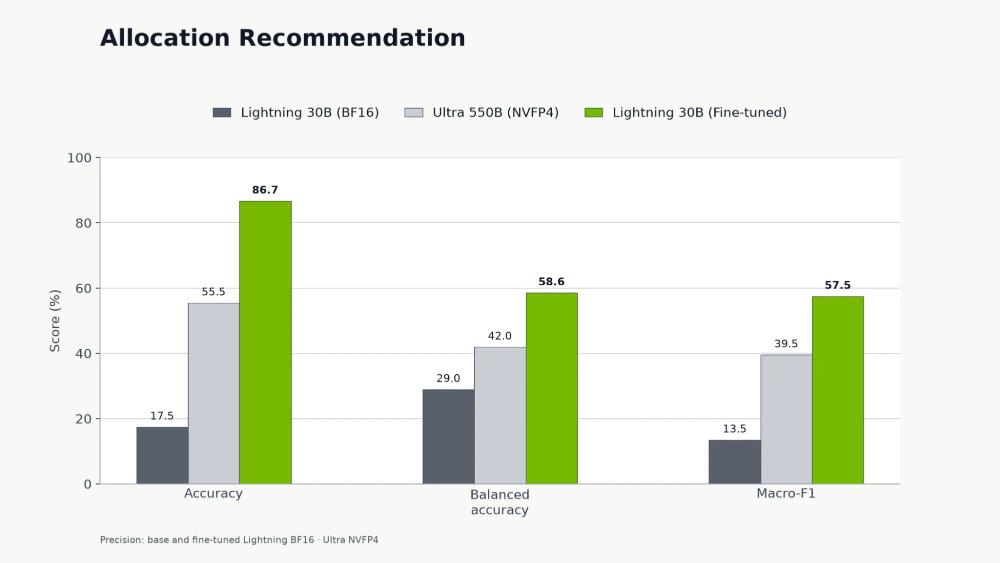
图 · 图4 后训练模型与 Ultra 的准确率对比
图 4(原文 Figure 4):三组模型在同一任务、同一评测数据上的对比。原文图注:Accuracy scores of post-trained Nemotron Lightning compared against Nemotron Ultra
英伟达供应链运营团队和 Palantir 一起,先定清楚了三件事:模型能看到什么、允许推荐什么、推荐结果怎么打分。这套工作流后来同时变成了应用本身和分配决策智能基准。
对照的三组是:
• 基础版 Nemotron 3.5 Lightning(BF16)
• Nemotron 3 Ultra(NVFP4)
• 后训练版 Nemotron 3.5 Lightning(BF16)
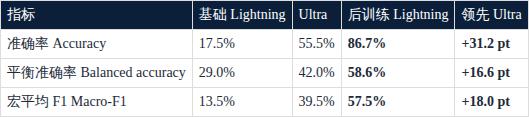
结果(开发基准):
后训练版比自己的基础版,准确率高出 69.2 个百分点。
后两个指标为什么重要?原文解释得很清楚:
平衡准确率对每一类的召回取平均,所以稀有的决策和常见的决策权重一样。宏平均 F1 对每一类的 F1 取平均,把精确率也纳进来,所以模型没法靠"多猜稀有类"来虚增召回。
之所以必须看这两个指标,是因为在供应受限的大背景下,计划员砍量的次数远远多于加量。这意味着如果只看普通准确率,一个只会猜多数类的模型也能拿到好看的分数。英伟达主动把这两个更严格的指标摆出来,这一点是值得肯定的。
原文给的结论非常克制,我逐字引:
"On a bounded allocation task, a specialized 30B model can outperform a general-purpose model that is more than an order of magnitude larger."
(在一个边界清晰的分配任务上,一个专门的 30B 模型可以胜过体量大它一个数量级以上的通用模型。)
接着它自己补了两句限定,我觉得比结论本身更有价值:
第一,这不代表小模型整体上能力更强。它的增益集中在被后训练过的那个领域里。
第二,未来的生产风险预测即使做了微调依然很难。原文原话是:"Specialization improved the decision task but failed to solve every prediction problem attached to it."(专业化改善了决策任务,但没有解决挂在这个任务上的所有预测问题。)
最后是工程上的可行性:这次 LoRA 训练跑在 2 张 NVIDIA B200 GPU 上,分钟级完成,轻到可以在反馈积累之后反复重跑,让每一次新经验都能及时回到模型里。
原文把它总结成"主权 AI 的实践形态":专有的供应链数据、模型权重、推理,全部留在同一个受治理的环境里。
▍ 五、我的解读:这篇为什么不只是"小模型打赢大模型"
先摆结论。我认为这篇最有价值的一点,不是那个 31.2 个百分点,而是它公开承认并系统性利用了"模型算不过人"这件事。
▪ 5.1 它做的是"把人补进数学模型",不是"把人换掉"
原文那句 "that instinct is what makes the human experts better than the math" 是可以被误读的。把它读成"AI 没用"是错的——英伟达没有因为回测结果不利于 cuOpt 就放弃定量优化,cuOpt 至今还在每周求解那个 MILP。
真正的动作是:承认定量模型有一个边界,然后把边界外的人的信息,显式地变成数据。
邮件、天气预报、地缘事件、供应商复盘记录——在传统信息化视角里,这些全是"非结构化噪声",进不了模型。但 Ontology 用对象 + 链接把它们装了进去(图 3 里那行小字 "governed operational data" 才是重点),于是它们第一次具备了被学习的资格。
所以这不是"人 vs 机器",而是先把人的判断变成机器读得懂的数据,再让机器去逼近它。
▪ 5.2 真正的技术资产不是模型,是"决策记录的结构"
我想强调一个容易滑过去的点:模型只是这条链路的第三顺位。
请看原文描述他们捕获的是什么:决策本身、决策的理由(rationale)、预期结果、实际结果。四件东西。
• 只有"决策"→ 你只能做模仿学习,学出来的是相关性;
• 加上"理由"→ 模型能学到判断的依据,输出的推荐才可能带解释;
• 加上"预期结果"→ 有了对照的基准;
• 加上"实际结果"→ 才做得了那个时点回测,才答得出"如果上个月它就在,会不会做对"。
这四件里少任何一件,86.7% 都拿不到。 而积累这套记录,是和模型无关的组织工程——它需要在决策发生的当下就把它记下来,还要带着理由和结果一起记。
这就是为什么我在下面把它列成复制的第一道门槛。
▪ 5.3 "时点回测"是这套方案里最被低估的机制
用同一批历史决策重放,只喂当天可知的信息、把结果藏起来——这个设计的严格程度,值得单独说。
它一次性解决了三个问题:
防未来函数。 如果评测时不小心把事后信息漏进去,任何模型的成绩都会虚高,而且高得看不出来。把"当天可知道"当作硬约束,是在数据层面堵死这条路。
防基准造假。 对照的是同一个任务、同一份评测数据下的三组模型,连精度格式都标了出来(BF16 vs NVFP4)。这种透明度在厂商自评里并不常见。
可复用。 因为每条决策都要重放,这套评测装置和训练数据是同一份记录。不用额外建一套评测集,也就没有"训练集和评测集口径漂移"的空间。
我会把这条列为本篇第一个可迁移的方法论。
▪ 5.4 我的保留意见
讲完价值,得说边界。以下是我的判断,不是原文的观点。
第一,86.7% 是开发基准,不是生产成绩。原文明确写的是 "on the development benchmark"。它回答的是"历史重放能不能做对",而不是"上线后连续三个月表现如何"。这两件事之间的落差,在工业场景里通常是最大的。
第二,样本量没有披露。 分配决策是每周一次的节奏。哪怕攒了三年,也只是百来条决策。在这个量级上做 LoRA 微调、再切分评测集,过拟合的风险是真实存在的,而且很难从外部证伪。原文没有给训练/评测样本数,这是我认为最需要补的一项信息。
第三,"自动化"这个词在这里要小心。原文自始至终的表述是建议 + 人拍板,是"缩短计划员重建常规决策的时间"。所以它提升的是决策吞吐,而不是决策替代。如果你的场景本来就需要专家签字,这套东西不会帮你绕开签字。
第四,这也是最重要的一点——它的价值高度依赖"人本来就做得好"。整篇方案成立的前提,是回测发现人类计划员系统性优于模型。反过来说,如果一个环节人类表现本身不稳、专家判断无法一致复现,那么这个"学习对象"的质量就存疑,飞轮转起来学到的可能是噪声。这套方法本质上是把已有的优秀实践放大,而不是凭空创造优秀实践。
▪ 5.5 一个我觉得很妙的设计取舍
最后说一个工程细节:LoRA + 2 张 B200 + 分钟级。
这三个条件放在一起,意味着这套东西的迭代成本低到可以做成例行公事。原文说的是"light enough to repeat as feedback accumulates"——轻到可以随反馈积累反复重跑。
这才是"飞轮"能真的转起来的原因。如果一次后训练要花几周和一大笔算力,那么无论方案设计得多漂亮,它都只会变成一年跑一次的年度项目,机构知识也就无从累积。
反过来看,这也解释了他们为什么选一个 300 亿的模型,而不是直接用最大的那个。在"持续可重训"这个目标面前,模型的绝对能力是次要的,迭代的周转速度才是第一位的。
——我认为这是本篇最实用的一条经验:当你要种一棵会长大的树,先看你能不能天天浇水。
▍ 六、产业影响:这套东西能搬到哪里
原文自己给了答案:这套供应链工作流并不专属于半导体。任何"由有经验的人、依据碎片化信号来分配关键产能"的场景,都能跑同一套飞轮。
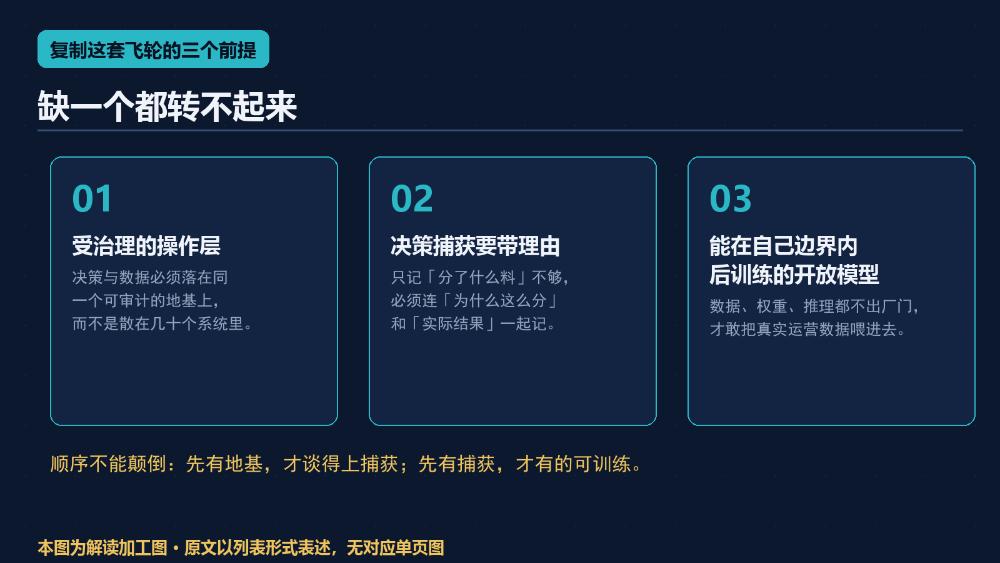
原文列了三个必需条件:
1. 一个受治理的操作层;
2. 决策捕获,且必须同时包含理由与结果;
3. 一个能在你自己安全算力边界内做后训练的开放模型。
图 · 复制这套飞轮的三个前提
本图为解读加工图 · 原文以列表形式表述,无对应单页图
我把这三个条件按我的理解排了个序,因为我觉得它们不是并列关系,而是有先后依赖的:
第一步是地基。"受治理"这三个字不是修辞。它包含可审计、有血缘、权限清晰。没有它,决策记录就是一堆无法回溯的日志,模型学到了什么、依据是什么,你都答不出来。
第二步才是捕获,而且是带理由的捕获。这一步最容易被做残——很多组织愿意记"结果",不愿意记"理由",因为写理由费事、还可能暴露判断失误。但恰恰是"理由"这一栏,让模仿学习变成了可解释的策略学习。
第三步反而是最容易的一步。开放权重模型现在到处都有,能在自己边界内后训练,工程上已经不难。真正的门槛在前两步,而前两步是组织问题,不是技术问题。
这也是我读完最想说的一点:这套方案里最难复制的部分,没有一行代码。
它可以迁移到哪些场景?我按贴合度排一下:
• 制造业产能分配:多条产线、多个订单、关键设备有限——结构几乎同构。
• 医院手术室与床位调度:高年资调度员的经验显著影响周转效率,且信号极度碎片化。
• 电网与算力资源的跨区调配:受限容量 + 动态约束 + 已承诺负荷,和文中的 MILP 结构高度接近。
• 运力与舱位分配:季节性、天气、突发事件的权重极高,正是模型看不见的那部分。
• 医药供应链与临床用药保障:强合规 + 多来源 + 断供风险,且"合规性"本身可以直接写成奖励项。
共同点是:关键资源稀缺、决策可以每周/每天重复、且已有经验丰富的人在拍板。
▍ 七、局限与争议
按本号惯例,这里要认真讲边界。
从原文已知的边界(作者自己承认的):
1. Future production risk forecasting 依然困难,即使做了微调也没解决——专业化改善了决策任务,但没有解决挂在这个任务上的所有预测问题。
2. 小模型的增益集中在被后训练的领域内,不代表整体能力更强。这是原文主动加的限定,很诚实。
3. 结果口径是开发基准,且是单一企业内部的任务。
我认为还需要追问的(本号判断,原文未提):
1. 样本量未披露。每周一次决策的频次下,可用样本天然稀少。这个约束对方法的普适性是决定性的,但原文没给数。
2. "86.7%" 的评测集与训练集是否同源? 原文说用时点回测、用同一份记录,这在工程上很优雅,但也意味着评测集和训练数据来自同一条决策流。如果切分不严格,成绩会偏乐观。原文没有交代切分规则。
3. 过度依赖历史决策,会锁死过去的判断。 模型学的是"过去的人怎么决定"。如果某次判断其实是错的(只是当时没暴露),模型会把它一起学走。这套飞轮放大的是既有经验,包括其中的偏见。
4. 治理成本被低估。"模型从不在生产环境自训"意味着每一轮都要人审。轮次越密,治理负担越重——而这部分人力,原文没有量化。
5. 利益相关声明。 这是一篇英伟达官方技术博客,作者是英伟达员工,Palantir 是其合作方。所有数据属厂商自评,方法论与边界如上。技术判断本身有参考价值,但读者应当知道这个立场。
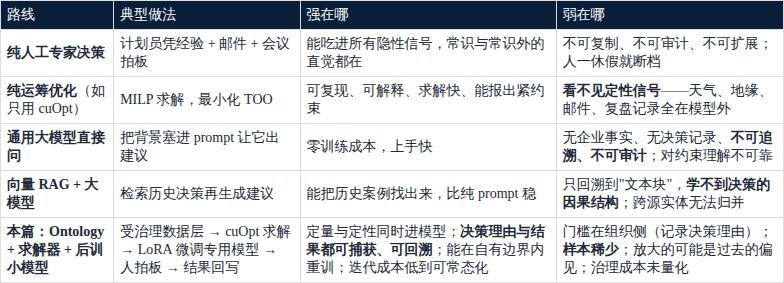
▍ 八、同类对比:这件事各家怎么解
坐标定位:它不在"更强的模型"这条赛道上,而在"把专家判断变成可累积的组织资产"这条赛道上。和前三行的根本差别是:前三行解决"这次怎么分",它解决"下一次能不能分得更好、而且说得清为什么"。
▍ 九、结尾:飞轮转的不是模型,是知识
回到开头那个 86.7%。
现在再看这个数字,我觉得它的含义变了。它不是一个模型能力指标,而是一个组织把多少隐性知识显性化了的度量。
原文最后一段的收尾我很认同,翻译过来是:
运营数据训练模型,模型改善决策,而决策又成为下一轮受治理训练的新的运营数据。这就是英伟达和 Palantir 压缩从晶圆出厂到第一个 token 的方式,也是世界上最可靠的 AI 基础设施供应链,"学习得比增长更快"的方式。
三句话,前两句是机制,第三句是它的野心。
而中间那个"受治理"(governed)才是真正的关键词。数据要受治理,训练要受治理,部署要受治理,就连模型自己也不被允许在生产环境里偷偷长大。
所以如果有人问我这篇最该拿走什么,我的答案是——
别急着训模型。先去把你最好的那个老师傅,每周做决定时的理由,一条一条记下来。
记够一年,你会发现真正难的那部分,你其实已经做完大半了。
往期推荐
三层本体&图谱驱动的医药企业级新一代AI知识平台
Palantir的真正秘密武器——本体论(Ontology)
本体论、知识图谱与大模型融合技术研讨会圆满落幕:产学研共探AI融合新路径
本体论Ontology:让企业级AI大模型真正有效运作的隐藏层
大语言模型时代,本体论还有用吗?
本体论神经符号架构如何破解企业AI幻觉难题?——构建可信赖的智能体Agent系统
超越通用大模型,动态本体重新定义企业知识工程 - Stardog
本体论:让AI真正听懂你的业务语言
ONTOKG- 知识图谱构建新范式:本体导向与内在-关系路由机制
Elsevier旗下SciBite的本体论赋能制药研发:AI与科学专业知识Ontology的完美协同
用LLM打造会自我进化的下一代个人AI知识库及本体价值 - OpenAI联创Karpathy
本体论与3DI:从解释现实到证明真实
AI时代的医药研发专家的一天:本体论驱动的知识引擎如何重塑医药行业超级个体和前沿组织形态
大模型时代本体论Ontology驱动的AI知识引擎助力企业智能决策系统的未来进化-一篇献给企业董事会和CIO的深度思考(第一篇)
智能体AI究竟是什么?本体论能否为其赋能?以生物医药研发为例详细解析
诺华Data42平台:利用Palantir本体论驱动的AIP重塑药物发现的未来
诺和诺德数字化转型之路:本体论Ontology驱动的数据管理革新
AI Agent的认知架构:为什么AI智能体需要本体论和知识图谱
Palantir 会是下一个 Oracle 吗?Ontology本体论重塑制药行业的AI催化剂
我的AI智能体需要本体论Ontology吗?
Palantir “本体论”:是跨时代的AI架构,还是精心包装的“建表”骗局?
Palantir 本体论与知识图谱深度分析及实现路径
微软企业级本体大模型Fabric IQ平台深度解析:从企业数据平台到智能平台的范式转变
将复杂性转化为意识:探索本体论与Palantir的操作性本体模型
AI智能体为何需要本体与图谱存储:构建可靠的长时记忆架构
解锁企业知识图谱的“黑匣子”:OntoEKG重塑本体构建范式,AI赋能数据价值释放
Palantir本体构建指南:Ontology Building – 打造组织的运营层与数字孪生
人工智能本体论:大模型辅助构建AI概念层级体系
知识图谱与大模型的结合:Stardog的本体论和符号化知识蒸馏技术解析
Palantir官方深度解析本体 Ontology系统及知识图谱、大模型:企业自主决策的核心AI引擎
11份深度报告拆解 Palantir:从“本体政治”到 AI 操作系统,揭秘全球最神秘巨头的真相
统治数据的“先知”:Palantir 16 份官方白皮书首度解密,从本体论到战场决策的进化路径
大模型环境下的企业级语境图谱Context Graphs:Palantir 本体论之争的误区,一场价值万亿美元的对话
知识图谱和Prolog在大模型时代的角色对比:逻辑与本体的完美融合
大模型重塑本体工程和知识图谱构建综述:从静态规则驱动到动态生成范式的革命性演进
本体论与知识图谱:揭示语义技术的核心差异
企业级实用本体论及构建指南(4/4):通过Foundry Actions激活数据生态系统
企业级实用本体论与构建指南(3/4):Palantir Foundry中的对象、事件与时间序列
企业级实用本体论的实践指南(2/4):Palantir Foundry如何将组织数据映射到本体概念及关键设计考量
企业级实用本体论及构建指南系列(1/4):Palantir 数据建模的哲学与实践
OntoMetric:破解ESG报告难题的“大模型+本体知识图谱”新范式,准确率提升10倍
零噪声知识图谱提取革命:构建自适应本体驱动GraphRAG系统
Palantir的"本体论"(Ontology)究竟是什么?这个晦涩的哲学术语是其AI业务的核心秘密
工业标准文档的本体知识图谱框架:通过层次化和命题结构实现智能解析
从人类专家到机器:大模型支持的人机协同本体与知识图谱自动构建
本体论:大模型时代企业数据治理的关键基础设施及企业级大模型规模化落地的真正瓶颈
Palantir本体论及AI数字孪生深度解析:构建组织智能的语义操作系统
颠覆认知的知识引擎:Palantir 公司的本体论及其对未来的启示
本体论的力量:为大模型智能体提供可靠的框架,减少不确定性并提高输出质量 - 海外知识图谱公司Stardog的大模型演进
从RAG到GraphRAG:知识图谱、本体论与更智能的AI
70+美国巨头齐聚Palantir AIPCon 8,核能竞赛、制药革命与灾难响应的智能升级。如何用AIP&本体重塑行业未来?
Palantir AIP 深度解析(一):超越 RAG,用本体增强生成(OAG)重塑企业决策
"本体+数据"的魔法力量:Palantir如何从反恐前线到企业级AI的领军者的高速增长故事
Palantir本体论是否在中国可行?颠覆数据建模范式兼论Kimball星型模型。
Palantir CTO重磅解读:将你的业务编译成代码,“本体论”才是数字时代的终极武器
Palantir的“数据操作系统”革命 - 本体Ontology系统
Palantir发布的“本体驱动的智能体”,是AI迈向自主决策的终极形态?
Palantir官方揭秘:如何在商业、国防领域运用本体论和AI基础设施
Palantir揭秘:为什么说“本体”是AI时代的真正护城河?
突破企业级GenAI落地的关键:知识图谱与大模型驱动的本体
解锁知识的力量:深入探究Palantir的本体论与知识图谱
从知识图谱到企业数字孪生:Palantir本体驱动企业级AI应用创新路径
精准人工智能:Timbr的语义本体如何让大模型更智能
什么是“本体论”?——LLM驱动的自动本体生成、数据建模新范式与AI语义层全解