让机器解几何题时,我们到底在教它什么
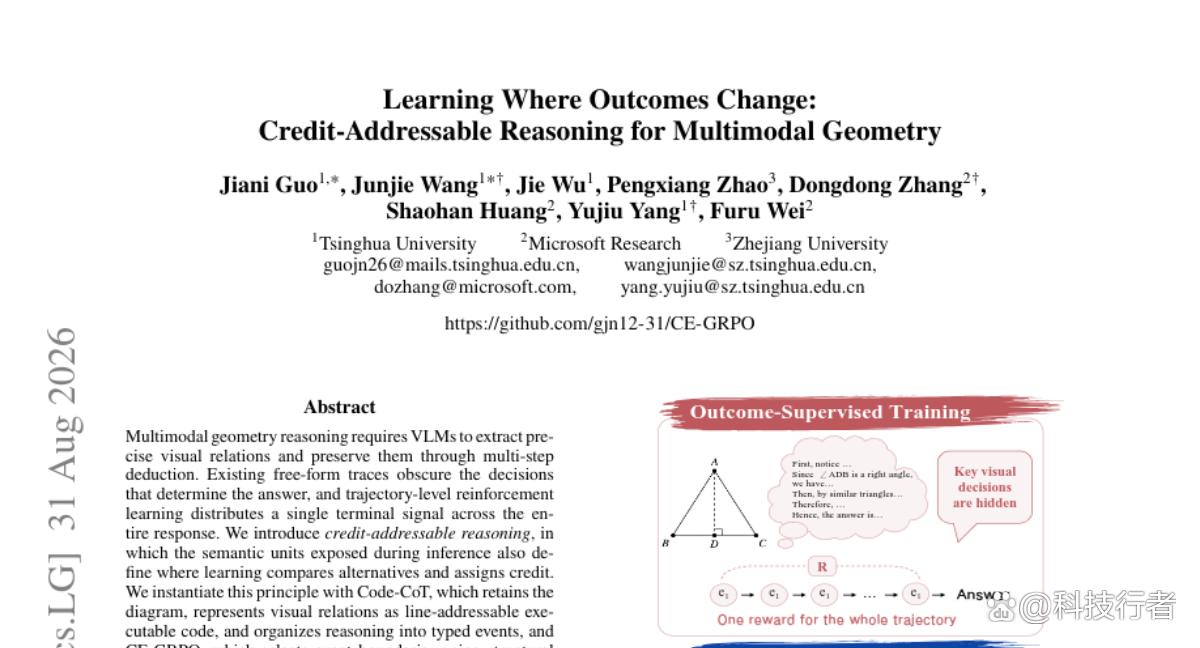
有一道几何题摆在面前:等腰三角形ABC,AB等于AC等于13,BC等于10,BD等于2,求AD的长度。
一个大模型开始推理。它先说"因为三角形ABC是等腰的",然后画风一转,接了一句"所以AD垂直于BC"。这句话是错的,BD等于2不等于BC的一半,这条辅助线根本不是对称轴,可模型没意识到,它顺着这个错误的假设算了下去,算出AD等于12。正确答案是3根号17,大约12.37。数字看起来很接近,但从头到尾这条推理链的地基就是歪的。
问题不是模型不会算三角形。问题是,这个错误的转折点藏在一整段密密麻麻的文字里,没人告诉模型"这一步是关键,这一步错了,后面全错"。等到最后答案出来,你只能给它打一个笼统的"错"或者"对",却没法精确指出,到底是哪句话把整条推理带偏的。
这篇来自清华大学、微软研究院和浙江大学的论文,就是在琢磨这件事:能不能让机器学习的时候,精确知道是哪个决策点出了问题,而不是把整段推理一起奖励或者一起惩罚。
强化学习*:一种让模型通过"试错加反馈"来改进自己的训练方式。模型生成一个答案,系统根据答案对错给一个分数(奖励),模型根据这个分数调整自己下次的行为。
传统做法只在一件事上打分:最终答案对不对。这就像期末考试只看总分,不管你是哪道题、哪一步失了分。对于几何推理这种链条很长、中间任何一步出错都会导致全盘皆输的任务,这种打分方式太粗糙了。
一步错,步步错,可惜没人告诉你哪一步
几何推理这件事,难点从来不只是"算术",而是"看图"。
模型要先看懂图里有哪些点、哪些线、哪些角,然后一步步推导下去,任何一步理解错了,比如把一个角看成了另一个角,把一条辅助线的位置搞错了,后面全是白费功夫。论文里提到一个现象:现有的自由式推理过程,就是模型想到哪写到哪,把关键的视觉判断藏在了一大段文字里,外人根本看不出来哪句话是决定成败的那一步。
而现有的强化学习训练方法,比如业界常用的GRPO,只能给整段回答打一个分。
GRPO*:全称Group Relative Policy Optimization(群体相对策略优化),是DeepSeek团队提出的一种强化学习算法,让模型生成多个答案,比较它们的相对好坏来打分,不需要额外训练一个"打分模型"。
这就好比一个团队做项目,最后老板只说"这个项目失败了",却不指出到底是谁的哪个环节出了问题。整个团队都会被连带扣分,那个真正犯错的人和那些做得很好但被拖累的人得到了同样的负面反馈。下次团队还是不知道该改哪里。如果不解决这个问题会怎样?团队里表现好的成员会觉得委屈,慢慢失去改进的动力,而真正的问题环节因为没被单独指出来,下次还是会重复犯错。这正是论文里说的"credit gap",也就是信用分配的缺口。
论文的作者们想到一个思路:既然自由式文字推理没法定位关键决策,那就让推理过程本身变得可以定位。这就是这篇论文的核心创新,叫做"credit-addressable reasoning",可以理解为"可寻址的推理"。
可寻址推理*:指推理过程中暴露出来的语义单元(比如一个思考步骤、一个操作)本身,也同时是训练时用来比较好坏、分配奖惠的单位。换句话说,推理时怎么切分,学习时就怎么打分,两者用的是同一套"地址簿"。
为了验证这个思路的价值,作者们先做了一个很扎实的对照实验。他们让六个模型(三个开源模型InternVL3.5-8B、Qwen2.5-VL-7B、Qwen3.5-9B,三个商业模型Kimi-K2.6、Claude-Opus-4.8、Gemini-3.1-Pro)分别在四种输入条件下做几何题:只看图、只看外部生成的代码、图加代码一起看、只看自己生成的代码。
结果很有意思。图加代码一起看,效果永远是最好的,六个模型无一例外。但更关键的发现是:这些模型自己生成的代码,比外部专业模型生成的代码,准确率低了11.7到16.6个百分点。也就是说,瓶颈不在于"代码这种表达方式有没有用",而在于"模型自己会不会写出靠谱的代码"。这个发现直接决定了后面整个方案的设计方向:代码这种表示方式必须留下来,但必须让模型自己学会怎么可靠地生成它,而不是靠提示词临时糊弄。
让几何图变成一行一行可以引用的代码
基于上面那个发现,作者提出了第一个核心组件,叫Code-CoT。
Code-CoT*:全称Code Chain-of-Thought(代码式思维链),是一种让模型先把输入的几何图转写成一行行带编号、可执行的Matplotlib代码,然后在后续推理中用"引用第几行代码"的方式来调用视觉信息的方法。
具体来说,模型看到一张几何图之后,先生成一段Python绘图代码,把图里的点、线、角度、圆全部用代码的方式描述出来,而且每一行代码都有编号。接下来模型继续推理的时候,如果需要用到某个视觉事实,比如"角A等于50度",它不再是含糊地说"因为图上角A等于50度",而是明确地写"参考第4行代码",这一行确实写着angle A等于50度,可以被程序验证核实。
这个设计有一个特别巧妙的地方:原始图片本身并没有被丢弃,代码是补充,不是替代。这就像你去一个陌生城市旅游,光靠地图App的语音导航是不够的,你还需要偶尔抬头看看真实的街景来确认自己没走错。如果只依赖代码转写而丢掉原图,一旦转写过程中漏掉了某个细节(比如某条辅助线的角度稍微画歪了),后面所有推理都会建立在这个错误的转写上,而且没有办法回头核对。保留原图,相当于给模型留了一个随时可以回头核实的锚点。
除了这行编号代码,Code-CoT还把整个推理过程拆成了几种明确的"事件类型":
reference(引用)*:从已有的代码行里提取支持某个几何事实的证据,比如引用第4行来说明角A的度数。
auxiliary(辅助构造)*:在已有几何关系基础上添加新的元素,比如连接两点、作垂线、设中点。
coordinate(坐标设定)*:建立一个可执行的坐标系,把几何关系转化为具体的坐标数值。
think(思考)*:在已有信息基础上进行的纯逻辑推理步骤,不涉及生成新的代码或引用。
这四种事件类型,加上前面提到的代码本身,构成了一套"可寻址"的推理结构。每一个事件都有明确的边界(用标签包裹),程序可以自动切分出来,知道每个事件从哪里开始、到哪里结束、属于哪个类型。这就为下一步的训练方法铺好了路。
在关键决策点上,让模型"重新做一次选择"
有了可寻址的事件结构,接下来的问题是:怎么利用这个结构来训练模型?这就是论文的第二个核心贡献,叫CE-GRPO。
CE-GRPO*:全称Critical-Event Group Relative Policy Optimization(关键事件群体相对策略优化),是本文提出的训练方法,核心思路是在推理过程中选出某个关键事件节点,保持它之前的所有内容不变,让模型从这个节点往后重新生成好几个不同的续写,再比较这几个续写最终答案的对错,从而只针对这个节点给出精准的奖惠信号。
这个设计的巧妙之处在于"共享前缀分支"这个操作。想象你在写一篇高考作文,写到第三段的时候,老师说:"这一段的立意有问题,你不用改前两段,就把第三段重写三个不同的版本,我看看哪个版本能让整篇文章拿高分。"如果三个版本都拿了差不多的分,说明这一段其实不是决定性的,老师就不会针对这一段做特别的批注。但如果其中一个版本明显拿了高分,另外两个明显拿了低分,那说明这一段的写法真的很关键,老师就能精确地告诉你:"以后遇到这种情况,就用第一个版本的写法。"
这正是CE-GRPO做的事情。系统固定推理过程中某个事件节点之前的所有文字(也就是"前缀"),让模型从这个节点开始,采样生成好几个不同的续写,一直续写到最终答案。每个续写会各自得到一个奖惠分数。如果几个续写的分数差异很大,说明这个节点确实是个"关键事件",这个差异就会被转化成精确的训练信号,只更新这个节点及其之后的部分,前面固定不变的前缀不会被误伤。如果几个续写的分数差不多,说明选错了节点,白白浪费了一次计算,但至少不会引入错误的训练信号。
那怎么知道该在哪个节点做这种分支实验呢?总不能对推理过程里的每一个事件都试一遍,那样计算成本会爆炸。论文用了两个信号来挑选候选事件。
第一个信号叫"结构先验",简单说就是优先选择第一个真正涉及几何判断的think事件,或者第一个reference动作,因为这些位置往往是决定后续推理方向的关键岔路口。第二个信号叫"类型归一化熵"。
熵*:在这里指模型对下一个词的预测有多不确定。熵越高,说明模型在这个位置犹豫不决、可能出错的概率更大;熵越低,说明模型很自信这么写是对的。
之所以要做"类型归一化",是因为不同类型的事件天生的熵水平差别很大。论文里提到一个具体数字:think事件的平均熵大约是reference事件的7.7倍。如果不做归一化处理直接比较熵值,几乎所有高熵候选都会落在think类型里,reference和auxiliary这些动作事件永远选不上。这就好比拿一个班级学生的考试分数和另一个班级比较,如果两个班的题目难度完全不同,直接比总分是不公平的,你得先按各自班级的平均分和标准差做一次校准,才能看出谁在自己班里真正是"异常突出"的那个。归一化之后,每种类型内部单独比较熵值,才能真正找出"在同类事件里显得特别犹豫不决"的那个候选。
论文做了一个离线实验来验证这套选择机制到底有没有用。结果显示,用结构先验选出来的事件,有28.9%的概率是真正的"关键事件"(也就是重新生成之后答案确实会变),而随机选择只有22.2%,相对提升了大约30%。结构加熵两者结合,关键事件命中率基本持平(28.7%),但奖惠变化幅度最大,达到0.409,而且每识别出一个关键事件平均花费的token数量从8.5万降到了7.5万,效率更高。
方法 关键事件命中率 奖惠变化幅度 每个关键事件耗费token数
随机选择 0.222 0.327 81.3k
仅用原始熵 0.259 0.376 75.8k
仅用类型归一化熵 0.254 0.374 75.7k
仅用结构先验 0.289 0.405 85.0k
结构加熵 0.287 **0.409** **75.0k**
九个几何数据集上的成绩单
方法说清楚了,接下来就是实打实的数字。研究团队在九个几何推理数据集上做了系统性评测,涵盖视觉理解、平面几何、辅助线构造、过程级推理四大类。
基准模型是Qwen3-VL-8B,一个80亿参数规模的多模态大模型。直接给这个模型套用Code-CoT提示词而不做训练,效果反而比原生模型下降了18.69个百分点,只有49.26分。这个结果说明一件事:让模型按照这种结构化的方式思考,光靠提示词是不够的,必须真正训练模型学会这套协议。
经过监督微调,也就是先用一批标注好的Code-CoT范例教模型怎么写这种结构化推理,平均分升到了69.55。再加上CE-GRPO强化学习训练,最终平均分达到76.04,比原生模型高出8.09分,比业界常用的传统GRPO训练方法高出3.43分。
方法 平均准确率
原生Qwen3-VL-8B 67.95
套用Code-CoT提示词(未训练) 49.26
Code-CoT监督微调 69.55
传统GRPO训练 72.61
**CE-GRPO(本文方法)** **76.04**
更值得说的是不同任务类型之间的差异。在GeoLaux-mini这个专门考验辅助线构造能力的数据集上,CE-GRPO比传统GRPO高出15.16分;在MM-Math这个过程级推理数据集上高出9.44分。这两类任务恰恰是那种"中间某一步构造或判断会影响后面很多步"的任务。相反,在一些相对简单的视觉识别任务上,两种方法的差距就小得多,甚至有些指标传统GRPO反而略胜一筹。
这个规律其实说得通。如果一道题的推理链条很短,中间没有太多可能出错的分支点,那整段一起打分和精确定位关键节点打分,效果差不了太多。但推理链条一长,中间涉及很多相互依赖的判断,传统的"整段一起打分"就像把一整锅粥的味道好坏归咎于最后一口,完全说不清楚是哪一味调料放错了。
论文还专门做了一个统计分析,把CE-GRPO相对于传统GRPO的优势幅度,和每道题平均涉及多少个中间事件数量做了相关性分析。结果是相关系数达到0.866,统计显著性p值为0.0016,意味着事件数量越多,CE-GRPO的优势就越明显,平均每多一个中间事件,优势就扩大3.77个百分点。反过来,传统GRPO的表现随着事件数量增加反而明显下滑,平均每多一个事件,相对于监督微调基线的优势就下降5.55个百分点。这个对比清楚地说明:整段打分的策略,在推理链条变长之后信号会被稀释掉,而精确定位到具体事件的策略,不会有这个问题。
代码到底有没有更"忠实"地反映图里的信息
除了最终答案对不对,研究团队还专门检验了一件更基础的事情:模型转写出来的那段Matplotlib代码,到底有没有真实反映图片里的几何信息。
他们找了100道数学题,用另一个模型(Gemini-3.1-Pro)先提取每张图里应该包含哪些可见的几何事实,再让一个独立的评判者去打分,看模型生成的代码有没有覆盖到这些事实。
结果显示,只做提示词而不训练的基线模型,代码覆盖率只有55.21%,代码渲染成功率89.0%。经过Code-CoT监督微调,覆盖率提升到70.16%,渲染成功率提升到95.0%。经过CE-GRPO进一步训练,覆盖率达到80.43%,渲染成功率达到99.0%。这说明CE-GRPO带来的提升,不只是"猜答案变准了",而是模型真正学会了更忠实、更准确地把视觉信息转成可执行代码。
条件 图文事实覆盖率 代码渲染成功率
基线(提示词,未训练) 55.21% 89.0%
Code-CoT监督微调 70.16% 95.0%
CE-GRPO **80.43%** **99.0%**
另外一个有意思的发现是关于"文本主导"和"纯视觉"这两种题型的差距。MathVerse这个数据集把同一批题目,从文字提示很多、图很少参考价值的版本,逐渐过渡到几乎完全依赖看图的版本。基准模型在这两种版本之间的准确率差距高达30.07个百分点,也就是说,一旦题目变成纯靠看图,模型的表现会大幅下滑。经过CE-GRPO训练之后,这个差距缩小到14.09个百分点,几乎减半。这说明这套方法真正加强的,是模型"看懂图"这个环节的能力,而不只是碰巧提高了文字理解能力。
Q&A
Q1:Code-CoT和CE-GRPO分别解决了什么问题?
A:Code-CoT把几何图转成一行行可引用的代码并把推理拆成明确的事件类型,解决了推理过程中关键决策"看不见"的问题;CE-GRPO则通过固定关键事件之前的内容重新采样续写,比较不同续写的最终结果差异,解决了传统方法只能给整段回答打一个分、无法精确定位错误来源的问题。
Q2:为什么模型自己生成的代码效果比外部生成的代码差那么多?
A:论文的对照实验发现,三个开源模型自己生成的代码,准确率比专业外部模型生成的代码低了11.7到16.6个百分点,说明瓶颈不在于代码这种表达方式本身有没有用,而在于模型自身还没学会怎么可靠地把图转写成代码,这正是CE-GRPO要重点训练的能力。
Q3:CE-GRPO在什么类型的题目上优势最明显?
A:在需要辅助线构造和多步过程推理的任务上优势最明显,比如GeoLaux-mini数据集上比传统GRPO高出15.16分,MM-Math数据集上高出9.44分。统计分析显示,题目涉及的中间推理事件数量越多,CE-GRPO相对传统方法的优势就越大。