AI能不能自己造出更强的AI
2027年某个清晨,一家实验室的AI研究助手写完了一段代码,训练出了一个新模型。这个新模型比上一代聪明了一点点,于是被派去继续写代码、继续做实验。它训练出的下一代模型,又聪明了一点点。
这个循环会一直持续下去吗?会不会在某一天突然加速,变成谁都拦不住的雪崩?
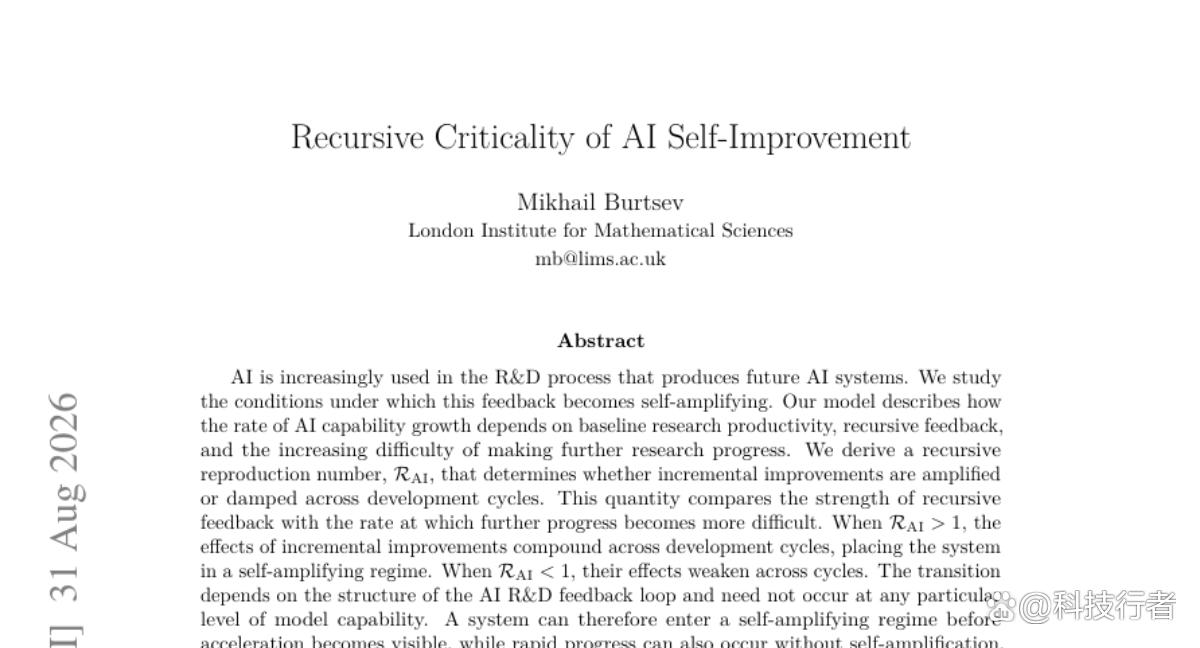
伦敦数学科学研究所的Mikhail Burtsev想搞清楚这件事到底在什么条件下会发生。他没有去猜AI什么时候会变得多聪明,而是换了个角度:不管AI多聪明,这个"自己造自己"的循环本身,有没有一个明确的临界点,一旦跨过去就会自我加速,跨不过去就只是正常进步?
这篇论文的答案挺出人意料:能不能自我加速,和AI现在有多强,几乎没关系。
**这是两件完全独立的事情。**
一个很弱的AI系统可能已经站在临界点上,一个看起来突飞猛进的AI系统可能压根没有自我加速。听起来有点反直觉,我们下面慢慢拆开讲。
问题到底难在哪
先说说为什么这个问题不能靠直觉判断。
大部分人想象AI自我改进,脑子里的画面是这样的:AI变强 → 能力提升 → 更强的AI → 能力再提升,一路狂奔到天上去。这套叙事从1965年数学家I.J.Good提出"超级智能爆炸"开始就存在了,几十年来一直是科幻和学术讨论的共同背景。
但现实中的AI研发从来不是一个孤立的模型在自己跟自己较劲。
它是一整套系统:写代码的AI、跑实验的服务器、评估结果的流程、把新模型真正训练出来并且部署上线的整个工程链条。人类研究员往往还嵌在这套系统里面,负责审核、把关、拍板。
**Burtsev把这套系统叫作"AI-R&D系统",而不是某个孤立的智能体。**
这个区分很关键。因为真正决定这套系统会不会自我加速的,不是AI有多聪明,而是这套系统里的反馈环路是"正"还是"负",强度多大。
这就好比问一个音响系统会不会啸叫。啸叫和音响的音质好坏没有直接关系,一台音质很差的音响,只要话筒和喇叭的摆位不对,照样会啸叫;一台音质极好的音响,只要摆位得当,怎么开都不会叫。**决定啸叫与否的是反馈环路的增益,不是设备本身有多高级。**如果只盯着音响参数表去判断会不会啸叫,那就永远猜不对,因为真正的答案藏在环路结构里,不在设备参数里。
AI自我改进也是同一个逻辑。
一个数字,判断你有没有站在悬崖边上
论文的核心贡献是提炼出一个数字,叫做**递归再生数**(论文里写作RAI,字面意思是"每一轮改进能带来多少下一轮改进")。
先解释几个铺垫概念。
> 递归增益(recursive gain, 记作a):现有AI能力对未来研发效率的提升作用有多强。如果AI帮你写代码、设计实验、分析数据的能力越强,这个数值就越大。
> 操作闭合度(operational closure, 记作χ):AI做出的研发贡献,有多大比例真正能穿过评估、审核、训练、部署这一整套流程,变成下一代系统里实实在在的能力提升。哪怕AI写出了绝妙的代码,如果没人看得懂、没通过审核、没被采纳,这部分贡献就白费了,闭合度就是低的。
> 前沿硬化率(frontier hardening, 记作σ):随着能力越来越接近某个技术路线的天花板,再往前挪一寸有多难。越难,这个数值越大。
把这三者放在一起,公式长这样:
RAI = χ × a / σ
分子是"实际能兑现的递归增益"(闭合度乘以增益),分母是"前沿变硬的速度"。
**当RAI大于1的时候,每一轮微小的改进都会在下一轮被放大,一轮接一轮地滚雪球,这就是自我加速状态。当RAI小于1的时候,改进的效果一轮轮衰减,最终趋于平稳。**
这个数字长得像不像流行病学里的基本再生数R0?没错,论文特意借用了这个类比:R0大于1,疫情就会蔓延;小于1,疫情就会自己熄灭。递归再生数在AI研发里扮演的是同样的角色,判断的是"一件事会不会自我复制放大",而不是判断"这件事现在有多严重"。
这里就要回应开头那个反直觉的结论了。
论文证明了一件事:在最简化的模型里,**提高研发投入(更多算力、更多人力、更多经费)会让进步的速度变快,但完全不改变RAI这个数字。**
这是因为研发投入(论文里叫作baseline research productivity,基础研发生产率,用r表示)同时放大了分子和分母两边的效应,跑得快不代表跑对了方向。这就像油门踩得再猛,也不能决定一辆车是不是装了刹车失灵的隐患,油门只管你跑多快,不管你会不会失控。**一个系统可以在表面上突飞猛进的同时,完全处于稳定收敛的状态;也可以在进展缓慢、外表毫无异常的时候,已经悄悄跨过了临界点。**
论文管这个叫作"自我加速的开端":**转变发生在系统跨过某个稳定性边界的那一刻,而不是发生在它达到某个特定智能水平的那一刻。**
为什么临界点跨过去了,你可能还没发现
这里有个更细思极恐的地方。
论文推导出,即使RAI已经大于1,系统一开始的放大速度也可能非常慢,慢到跟正常的进步几乎没法区分。
数学上,这个放大速度取决于反馈延迟(论文里的τ,指一次能力提升到它真正转化为下一轮研发生产率之间的时间间隔)和研发节奏的乘积。当研发吞吐量还比较低的时候,即便RAI刚过1一点点,放大效应也几乎察觉不到;只有当研发节奏加快,或者反馈延迟缩短,这个放大效应才会变得肉眼可见。
这就好比一个组织内部悄悄滋生的效率陷阱,比如某个部门开始把决策权层层下放却缺乏监督,短期内看起来一切正常,效率甚至还在提升,但只要给它足够多的运转周期,问题就会开始自我强化,从"看起来没事"演变成"突然全面失控"。**关键在于这套失控机制一开始就已经存在了,只是还没有跑够足够多的循环让它显形。**如果只根据眼前的运转状况判断安全与否,那就正好错过了最该干预的窗口。
论文还给出了一个更精确的极限:当研发吞吐量趋于无穷大时,放大速度不会无限加快,而是会收敛到一个固定值,这个值只由RAI和延迟τ决定,ln(RAI)/τ。
**换句话说,哪怕你把研发速度提到天际,反馈延迟本身也会变成放大效应的天花板。**
想成功地压制自我加速,仅仅拖慢研发投入是不够的,因为投入根本不改变RAI;真正管用的是拉长反馈延迟,或者降低递归增益、降低闭合度,直接从分子分母上动手。
天花板真的存在吗
一个自然的追问是:既然RAI大于1就会一直放大下去,那AI能力会不会真的失控到无穷大?
论文给出了一个冷静的回答:不会,至少在固定的技术路线内不会。
论文引入了一个"有限研究疆域"模型,假设当前技术路线有一个能力上限X(比如某种模型架构、某种训练范式能够达到的最好效果),当能力x越来越接近X时,前沿硬化率σ会趋向无穷大。
数学推导的结果非常干脆:**只要系统的能力趋近这个上限,RAI就必然趋向于0,系统会自动从超临界状态回落到亚临界状态。**
也就是说,在一条固定的技术路线里,自我加速不是永动机,它更像是一场烟花。**可以炸得很猛,但迟早会熄灭,因为可探索的研究空间是有限的。**
这解释了论文里几个模拟场景中很有意思的现象。论文设定了一个"参照时间线",假设不存在任何递归反馈,AI达到通用人工智能水平(AGI,泛指在广泛任务上达到人类水准的AI系统)大约需要24年,达到超级人工智能水平(ASI,指显著超越AGI表现的系统)需要96年,这个24年的基准是参考了2023年AI专家调查的中位数预测校准出来的。
然后论文对比了四种不同的递归增益强度。在增益最弱的场景里,RAI始终小于1,是完全的亚临界状态,AGI提前了2.7年,ASI提前了22年,说明就算没有跨过临界点,递归反馈本身也能带来实打实的加速。而在增益最强的场景里,AGI只用了4.5年,ASI只用了4.95年,两者之间的间隔从72年硬生生压缩到了不到半年。
**递归反馈对越靠后的门槛影响越大,因为它是一路复利下来的效应,越往后累积得越多。**
这就像存钱生息,本金相同、利率只差一点点,头几年看不出区别,但拉长到几十年,最后的余额可能天差地别。**利率差一点,前几年感觉不到,可复利跑得够久,最后的结果可以判若云泥。**如果只看头几年的余额去判断两笔存款的差异,你会严重低估复利的杀伤力。
一个实验室不够危险,一堆实验室凑在一起可能就够了
论文最后把这套逻辑从"一家实验室内部的循环"扩展到"多个研究主体互相连接的网络"。
这一步的洞察相当锋利。
现实中的AI研发从来不是各个实验室各自闭门造车,论文里点出,实验室之间会互相观察竞争对手的进展、交流科研成果、复用彼此的开源软件、共享同一批人才、甚至有时候直接共用底层的模型或工具。这些渠道都能让一个机构的进步,转化成另一个机构未来的研发效率。
论文把这套多主体系统写成一个矩阵形式,对角线元素代表每个主体内部自己的递归再生数,非对角线元素代表主体之间的技术溢出强度。判断整个网络是否会自我加速,靠的不再是单个RAI,而是这个矩阵的**谱半径**(数学上衡量矩阵"整体放大倍数"的一个指标),记作ρ(K)。
论文证明的结论是:**只要网络之间的技术流动足够强,即使每一家机构单独看都处于亚临界的安全状态,整个生态系统依然可能变成超临界的自我加速状态。**
这就好比一群本身都不容易起火的干草堆,单独一堆放在那里安然无恙,可一旦它们紧挨着排列成一条线,风一吹,火星就能从这堆蹿到那堆,最后烧成一片。**每一堆草单独测是安全的,但排列方式本身构成了新的风险,这种风险不会出现在任何一堆草的单独检测报告里。**
论文用三个虚构场景对比了这个效应:封闭的头部实验室竞争、开放的技术生态、全球阵营竞争。有意思的是,开放生态里每个参与者单独看都是亚临界的(内部再生数都小于1),研发投入还比参照基准低了20%,但因为彼此之间的技术传递非常强,整个网络的谱半径达到了1.55,ASI到AGI的间隔被压缩到了2.82年,是三个场景里最短的。反倒是那个投入最猛、竞争最激烈的全球阵营场景,虽然AGI来得最早,但因为跨阵营的信息流动比较慢、比较不对称,AGI到ASI反而拖得更久一些。
**这说明砸钱砸算力砸人力,远不如搞清楚技术是怎么在网络里流动的重要。**
硬件和电力会不会兜底
除了软件层面的能力提升,论文还专门讨论了一个很现实的约束:物理基础设施。
哪怕AI软件能力涨得再快,真正把它训练出来、部署上线,还得靠实打实的芯片、电力、散热和数据中心,这些东西是按照建筑施工的节奏在推进的,不可能一夜之间翻倍。
论文引入了一个"物理余量"的概念,衡量当AGI在软件层面达成的那一刻,现有基础设施能不能撑得住部署它所需的算力。如果余量充足(论文举例是原本需求的8倍),基础设施跑在软件进度前面,不构成瓶颈;如果余量紧张(比如只有2倍),那么在AGI到ASI这段期间,物理建设速度会反过来卡住整体进度,拉长这段过渡期;如果余量本来就不够(比如只有0.75倍),那么连AGI这道门槛本身都会因为造不出足够的算力设施而被推迟。
这里有一个重要的区分:**物理算力约束和递归增益是两码事。**算力约束卡的是"这个能力能不能被部署出来",而不直接改变RAI这个反馈强度本身。当然,如果算力增加反过来提升了操作闭合度、加强了研发增益、或者缩短了开发周期,那算力也会间接影响到反馈动力学,但这是另外一条作用路径,不是它作为"部署瓶颈"的那条路径。
写在后面
读完这篇论文,一个念头一直在我脑子里转:**我们平常讨论AI风险的时候,总是不自觉地把"AI变得多强"和"AI会不会失控"绑在一起谈,好像只要智能水平够高,失控就是自然结果。**这篇论文最锋利的地方,恰恰是把这两件事彻底切开了。一个能力普通的系统,只要反馈环路的结构不对,照样可能已经站在悬崖边;一个能力惊艳的系统,只要环路结构稳,怎么跑都不会失控。
这意味着,光盯着跑分、benchmark成绩去判断安全边界,可能从一开始就问错了问题。真正该追问的是:这一轮的能力提升,有没有让下一轮的提升变得更容易?这个问题的答案藏在研发流程本身的结构里,不藏在模型能考多少分里。
论文里那个"多主体网络反而比单一主体更危险"的结论也让我多想了一层。我们现在讨论AI治理,很多时候是以单个公司、单个实验室为单位在设监管红线的。但如果真正的风险藏在机构之间的技术流动里,那种一家一家去卡的监管思路,可能压根抓不住重点,因为风险不长在任何一家机构身上,它长在它们之间的连接方式上。
这篇论文没有回答的问题是:这些参数,递归增益、闭合度、前沿硬化率,现实中到底怎么测?论文自己也承认,目前的AI评测体系(像MLE-bench、RE-Bench这些用来测AI科研能力的基准)测的是AI在单个任务上表现如何,还没有一套方法能测出"这一轮能力提升,到底给下一轮研发生产率带来了多少因果性的提升"。这个测量鸿沟,可能才是这整套理论框架从纸面走向现实预警系统之前,最难啃的一块骨头。
Q&A
Q1:递归再生数RAI是什么,怎么判断AI研发是否会自我加速?
A:RAI是递归增益乘以操作闭合度、再除以前沿硬化率得到的数值。当RAI大于1时,AI能力的每一轮提升都会被放大到下一轮,形成自我加速;当RAI小于1时,提升效果会逐渐衰减。这个临界点和AI当前有多聪明没有直接关系,一个能力较弱的系统也可能已经跨过了这个边界。
Q2:AI自我改进会不会一直加速下去,直到能力无限强?
A:不会,至少在固定技术路线内不会。论文证明,当能力接近某条技术路线的天花板时,前沿硬化率会趋向无穷大,导致RAI自动趋近于0,系统会从自我加速状态回落到平稳状态。除非出现新的架构突破或科学发现拓展了能力上限,否则自我加速是阶段性、会自然熄灭的,不是永动机式的失控。
Q3:为什么多个AI实验室组成的网络可能比单个实验室更危险?
A:论文发现,即使每家实验室单独看都处于安全的亚临界状态,只要实验室之间的技术交流和成果传播足够强,整个研发生态系统的谱半径仍可能超过临界值,变成整体自我加速。模拟显示开放的技术生态即使投入较低,也可能比投入更高但联系较弱的封闭竞争环境更快压缩AGI到ASI的过渡期。