座舱助手为什么总打断你?两张表看懂VAD与EoT
上个月陪客户实车验收座舱语音,出了个尴尬场面。
车主说:"导航去机场……我说的是首都机场。"
中间那个停顿,大概 0.6 秒。系统判定"说完了",ASR 截断、意图下发、导航已经开始搜"机场"——后半句直接丢了。车主盯着屏幕,半天憋出一句:"这玩意儿故意跟我作对是吧。"
全场安静。我们当晚就把这个问题拉了个专项。
排查到最后发现:这根本不是 ASR 的锅,也不是大模型的锅。问题出在两个很多团队从没认真设计过的组件上——VAD 和 EoT。
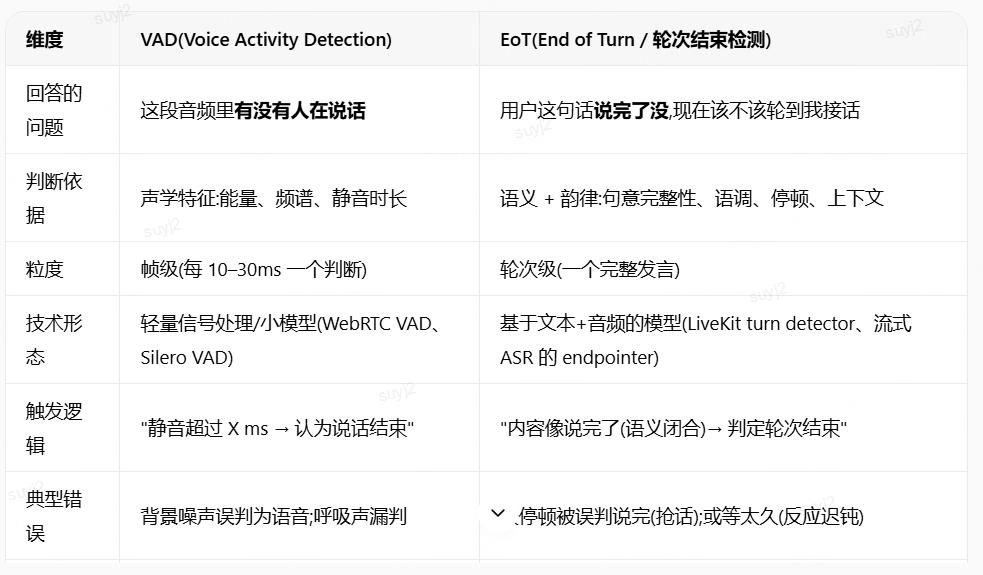
这篇文章,我把这两个概念从原理到座舱落地完整讲一遍,文末有可以直接抄的代码骨架。
VAD 是什么:门口听"有没有动静"的保安
VAD,Voice Activity Detection,语音活动检测。
一句话定义:判断当前这段音频里,到底有没有人在说话。
它工作在声学层,只看声音信号本身,不理解任何语义。你可以把它理解成门口保安——他不关心你说什么,只关心"门口现在有没有人"。
主流实现分三代:
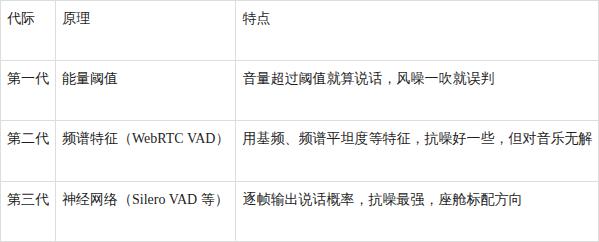
座舱环境对 VAD 极其不友好:风噪、胎噪、空调风、音乐外放、后排小孩喊叫,全在干扰判断。所以车载场景几乎都用神经 VAD,而且必须配合 AEC(回声消除)——否则助理自己在播报,VAD 会把扬声器的声音当成"用户在说话",出现诡异的自问自答。
VAD 的输出很简单,就是一串逐帧的 0/1:这段有语音,这段没有。
注意,它只回答"有没有",不回答"完没完"。这个区别,就是全部麻烦的起点。
EoT 是什么:判断"你说完了没有"的秘书
EoT,End of Turn,话轮结束检测(也叫语义端点检测,Semantic Endpointing)。
一句话定义:判断用户这句话是不是已经说完了,系统能不能开始干活了。
它工作在语义层,看的是文字内容,不是声音。类比一下:好的秘书不会等你闭嘴 3 秒才行动,他能从你的措辞里听出"这事儿交代完了"。
传统方案没有 EoT,只有静音超时:VAD 检测到连续静音超过阈值(通常 500-800ms),就认定用户说完了。
问题就出在这:
人的停顿,不等于说完。
"导航去机场……(思考 0.6 秒)……我说的是首都机场。"这句话中间有天然停顿。静音超时机制分不清这是"说完了"还是"在想词",只能一刀切——宁可早判,不然响应太慢。于是用户被掐断,体验崩了。
语义 EoT 的思路完全不同:把 ASR 的实时转写文本流喂给一个小模型,让它实时预测"这句话完整的概率"。说到"导航去机场",模型给 0.62——句子不完整,继续等;说到"我说的是首都机场",概率跳到 0.93——可以动手了。
一张表看清两者区别
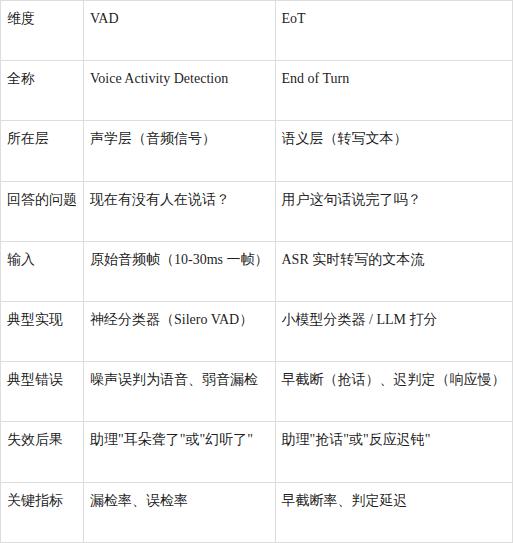
VAD 决定系统听没听到你,EoT 决定系统等不等你。一个管耳朵,一个管脑子。
两者必须配合:VAD 负责切出"一段有人说话的音频"送去 ASR,EoT 负责决定"这段转写够不够完整"送去下游执行。
代码骨架:一个能直接抄的协同实现
先看 VAD 状态机,管理"开始收音 → 收音中 → 出现静音"的流转:
# 流式 VAD 状态机(车载简化版)class VadStateMachine:"""状态:IDLE(无人说话)→ SPEAKING(收音中)→ TRAILING(出现静音,观察期)- frame_ms: 单帧音频时长,通常 10-30ms- speech_thresh: 神经 VAD 输出的说话概率阈值- silence_timeout_ms: 静音超时,传统方案的截断线"""IDLE, SPEAKING, TRAILING = "idle", "speaking", "trailing"def __init__(self, speech_thresh=0.5, silence_timeout_ms=700):self.state, self.speech_thresh = self.IDLE, speech_threshself.silence_timeout_ms = silence_timeout_msself.silence_ms = 0 # 已累计静音时长def on_frame(self, speech_prob: float, frame_ms: int) -> str:if speech_prob >= self.speech_thresh: # 有语音,静音清零self.silence_ms = 0self.state = self.SPEAKINGreturn "keep_listening"# 无语音:累加静音,进入观察期self.silence_ms += frame_msself.state = self.TRAILINGif self.silence_ms >= self.silence_timeout_ms:return "vad_timeout" # 静音超时,触发截断判定return "keep_listening"
这段代码做了一件事:把"静音超时"从一个拍脑袋的全局常数,变成状态机里一个显式、可调节的旋钮。但注意——vad_timeout 只是候选截断信号,最终截不截,要交给 EoT 拍板:
# 语义 EoT 打分:判断转写文本是否构成完整指令(简化版)def eot_score(partial_text: str) -> float:"""返回这句话"已说完"的概率,生产上由小模型输出,此处为规则示意:- partial_text: ASR 实时转写的累积文本"""if not partial_text.strip():return 0.0# 悬空连接词/介词结尾:大概率没说完("导航去""放一首")dangling = ("去", "到", "放", "放一首", "搜索", "打开")if partial_text.rstrip().endswith(dangling):return 0.35# 修正性表述("不是…我说的是…"):等待最终落点if "我说的是" in partial_text and not partial_text.rstrip().endswith(("场", "站", "店")):return 0.5# 有明确槽位(目的地/温度/歌名),判定完整return 0.92EOT_THRESHOLD = 0.8 # 高于此值才允许截断下发def decide_endpoint(partial_text: str, vad_event: str) -> str:if vad_event == "vad_timeout" and eot_score(partial_text) >= EOT_THRESHOLD:return "fire" # 静音超时 + 语义完整 → 下发执行if eot_score(partial_text) >= 0.95:return "fire" # 语义高度完整,可提前截断,抢回延迟return "wait" # 继续等,给用户把话说完的机会
白话解读:VAD 喊"他停下来了",EoT 看一眼文字说"句子还不完整,再等等"——两个信号一票否决制,任何一个说没完,系统就继续等。开头那个"导航去机场……我说的是首都机场"的案例,就是靠 eot_score 在第一次停顿时返回 0.35 拦下来的。
这套机制还有个隐藏收益:语义完整度足够高时(≥0.95),可以不等静音超时就提前截断,把平均首响延迟抢回 200-400ms。截得准,反而比纯静音超时更快。
座舱特有的三个附加题
第一题:打断场景下,EoT 要防"接飞刀"。
助理正在播报,用户突然插话。此时音频流里混着 TTS 的回声,VAD 容易把回声当人声。必须先过 AEC,再让 VAD 判定打断是否成立——打断确认后才切换到"听用户"模式,EoT 重新开始判完整。
第二题:免唤醒场景,EoT 阈值要更保守。
可见即可说、免唤醒指令没有唤醒词做"起点标记",系统不知道用户从哪一刻开始下指令。这时 EoT 的完整度阈值建议从 0.8 提到 0.85-0.9,宁可多等 100ms,也不能把半句闲聊当指令执行。
第三题:多音区下,每个音区一条独立管线。
主驾和副驾同时说话,意味着两套并行的 VAD + ASR + EoT 实例,各自维护自己的静音计时和完整度打分。用一条全局管线混着算,两个座位的停顿会互相干扰——这是很多团队做多音区时栽过的坑。
避坑指南:3 个我们付过学费的参数
坑 1:静音超时全局一刀切。控车指令用户说得干脆,500ms 够了;问路、闲聊用户会边想边说,要 800ms 以上。按意图类别动态调超时,别用一个常数应付所有场景。
坑 2:只看平均延迟,不看早截断率。有团队把静音超时从 800ms 压到 400ms,平均首响确实快了,但早截断率从 2% 飙到 11%——那 11% 的用户体验是灾难级的。EoT 的优化目标永远是"早截断率 < 3% 的前提下,最小化判定延迟",顺序不能反。
坑 3:EoT 模型离线不可用就整个回退静音超时。隧道场景端侧小模型跑不动完整版,正确做法是降级到"规则版 EoT"(就像上面代码里的悬空词检测),而不是裸奔回纯静音超时——降级方案也要分层。
趋势判断
现在头部座舱方案已经在把 VAD 和 EoT 往一个端到端模型里收——音频和文本联合建模,直接输出"该不该动手"的决策,省掉两段式拼接的误差累积。
但我的判断是:在未来两三年内,"VAD 管听、EoT 管等"的两段式架构仍是主流,因为它可解释、可分别调优、可分级降级——这三点对车规级产品比什么都重要。
VAD 决定系统听没听到你,EoT 决定系统等不等你。把这两件事分开设计、分开度量、分开背指标,座舱语音的"抢话"和"迟钝"才能真正根治。
你们的车机被用户投诉过"抢话"吗?最后定位到是哪个环节?评论区聊聊,这个问题我怀疑全行业都踩过。
如果这篇文章帮你在评审会上多了一个说服人的论据,顺手转发给做语音交互的同事——这两个概念,太多团队到现在还是混着叫的。
举报/反馈
对本文内容有合作意向?
我们将在 1 个工作日内与您联系