HIST 深读:Qlib 榜单第一的模型,在挖人类没定义过的「隐藏板块」
这是「Qlib 榜单逐模型深读」系列的第一篇。上一篇《顶级基金实盘在跑的冷门模型,和时序大模型的真相:那些很强但很冷门的架构,以及时序大模型到底有没有用》里,我们对着微软 Qlib 官方榜单说了一句欠账:榜首那幾個模型要一个个拆开讲。今天兑现,从第一名 HIST 开始。
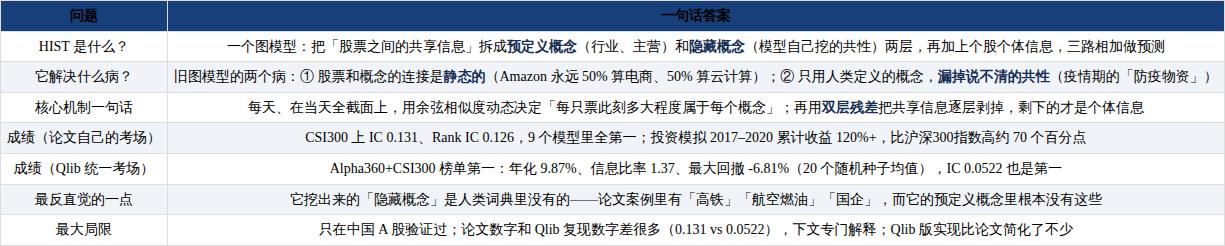
开场:从榜首说起,先记住一个数字
上一篇我们看过 Qlib 官方榜单(Alpha360 数据集、CSI300 股票池、20 个随机种子取均值):HIST 年化 9.87%,第一;第二名 IGMTF 9.46%,第三名 TRA 9.20%;而纯时序的 LSTM 6.47%、GRU 7.20%,Transformer 直接亏钱(-2.70%)。
当时留下一句话没展开:前五名里有三个是图模型。也就是说,在这个统一考场里,「把股票之间的关系用起来」这件事,系统性地赢了「每只票各算各的」。
今天要拆的 HIST,是这里面想得最深的一个。先记住一个数字,整篇文章都围着它转:在 A 股日频数据上,单只股票明天涨跌的相当一部分方差,不是它自己决定的,而是它「跟谁一起动」决定的。 这句话我用真实数据实测过,先看图:
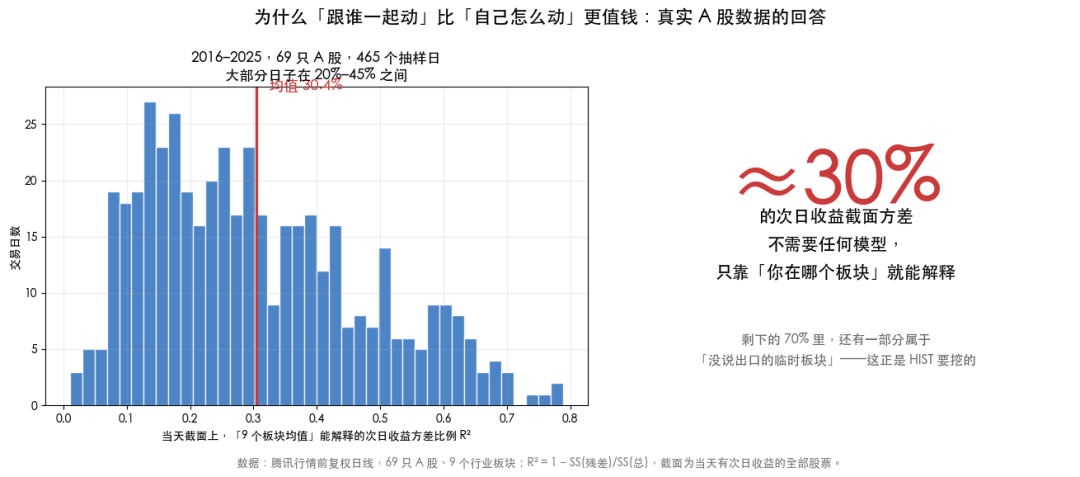
这张图在说什么:我用 69 只 A 股、2016–2025 年的前复权日线算了 465 个抽样日——不做任何建模,只问「9 个行业板块当天的平均次日收益,能解释截面上多少方差」。答案是平均 30.4%、中位数 27.6%。也就是说,你只知道一只票属于哪个板块、板块明天整体怎么动,就能解释它明天涨跌的三成方差。而剩下的七成里,还有一部分属于没被行业分类收录的「临时板块」。HIST 要做的,就是把这两部分都榨出来。
先讲透一件事:为什么股票会「同涨同跌」
你不需要任何金融背景。想象一个教室,考试分数 = 学生天赋 + 班级氛围 + 当天状态。
- 班级氛围就是「共享信息」:同一个班的学生,分数会同涨同跌;
- 当天状态就是「个体信息」:某人昨晚没睡好,只有自己倒霉。
一个只盯着单个学生历史分数做预测的模型(LSTM、GRU 这类「单票模型」),永远看不到班级氛围。而教室里大部分分数波动,其实来自氛围。
股票市场是同一个结构,只是「班级」不止一个、而且随时在换:
- 茅台和五粮液在「白酒」这个班里;
- 茅台和恒瑞医药平时不同班,但市场炒作「核心资产」的那几个月,它们临时同班;
- 2020 年 3 月,做口罩的和做电商的突然同班了——这个班没有名字,人类的花名册上查不到。
HIST 的全部设计,就是为了把这三层(固定班级、临时班级、个人状态)分开建模,再合起来预测。 下面进入论文。
HIST 要治的两个病
论文(arXiv:2110.13716,2021 年 10 月,第一作者徐文涛,中山大学与微软研究院合作)开篇就给旧方法定了两条罪状。
病症一:静态连接。 旧图模型按「两只票同属一个概念」建边,然后一年不变。但现实里,Amazon 和「电商」概念的绑定强度,在 2020 年封控期和平时完全不同——封控期它涨是因为电商爆单,不是因为云计算。静态图把两路信息永远按固定比例混在一起,等于让模型戴着固定墨镜看一个变色的世界。
病症二:概念花名册不全。 旧方法只用人类预定义的概念(行业、板块、主营业务)。可市场里大量共性是人类没命名的:论文举的例子,一家做个人防护装备的公司和一家电商公司,因为疫情突然同涨同跌——它们共享的「疫情受益」这个概念,不在任何花名册上。等人类把它写进花名册,行情早结束了。
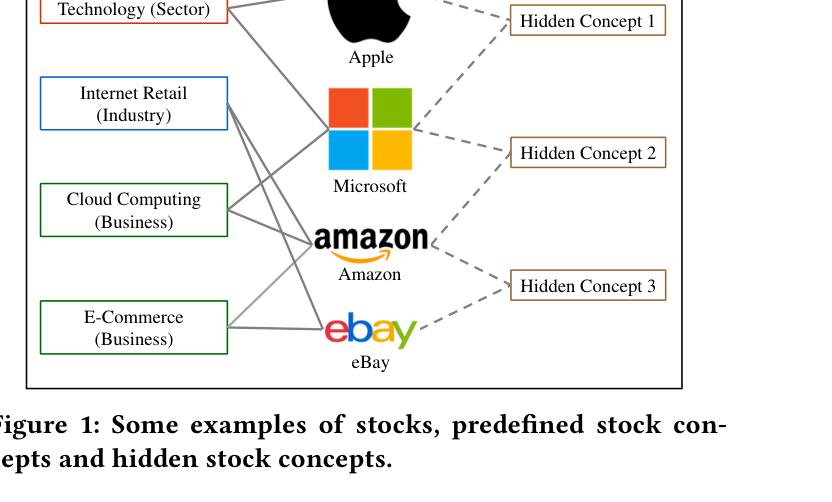
这张图在说什么:左边是人类花名册上的概念(科技板块、互联网零售行业、云计算业务、电商业务),中间四只票,右边三个隐藏概念——虚线框表示「人类没定义、但模型应该自己发现的共性」。Apple 既在科技板块又在隐藏概念 1、2 里。整篇论文的目标就是同时用好这两种概念。
为了让你对「动态」这件事有体感,看这张示意:
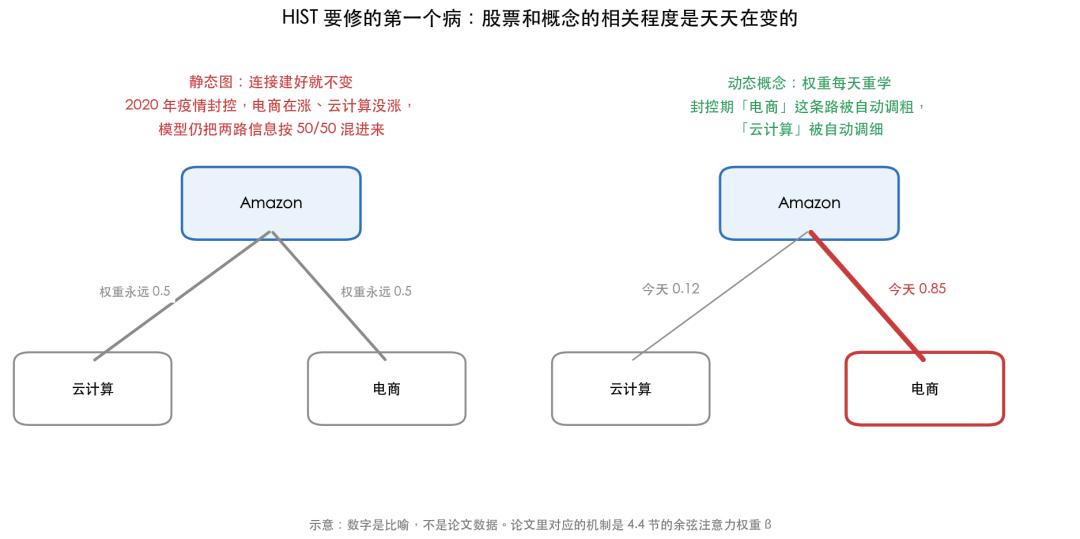
这张图在说什么:左图是旧图模型——Amazon 到「云计算」和「电商」的两条边权重永远相等;右图是 HIST 想要的——权重每天重新学习,封控期「电商」那条边自动变粗。数字是比喻,论文里实现这件事的机制是后面的余弦注意力。
总体架构:一条「剥洋葱」流水线
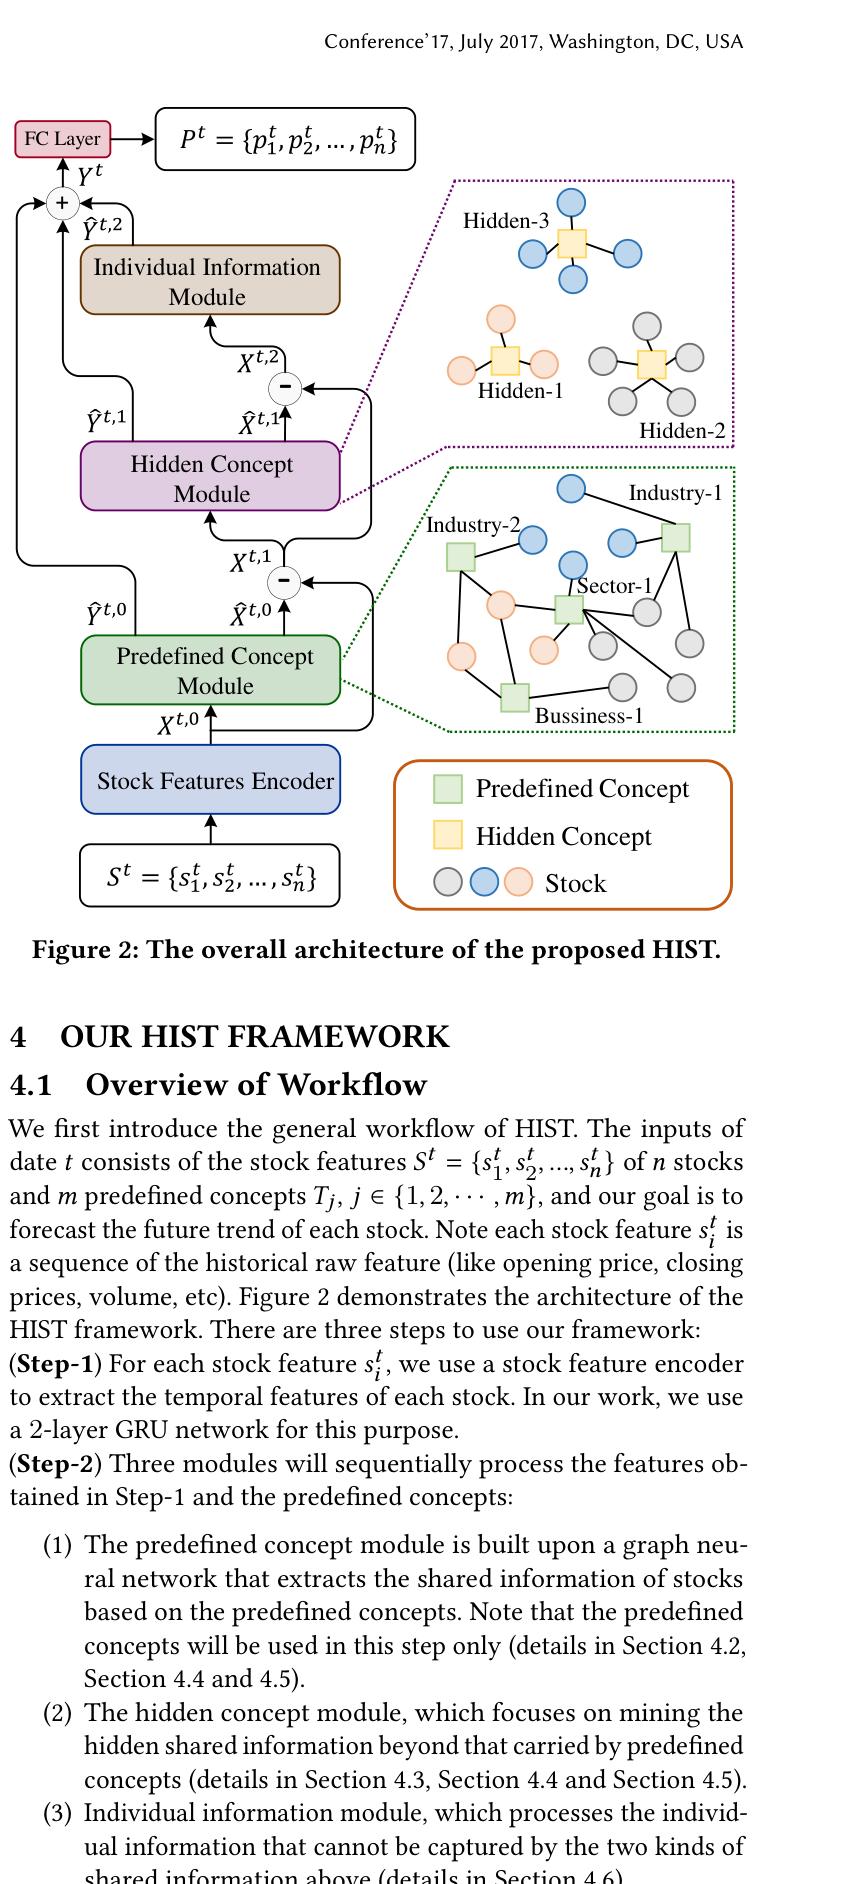
这张图在说什么:从下往上看。最底层是每只票的原始量价序列,先过一个两层的 GRU 编码器,把「60 天 × 6 个字段」压成一个向量。然后信息流进三个模块:预定义概念模块(绿)、隐藏概念模块(紫)、个体信息模块(棕)。注意每个模块旁边都有一个「减号」圆圈——上一路共享信息被从输入里减掉,剩下的才交给下一个模块(这就是「双层残差」,借自时序预测名作 N-BEATS 的思路)。三个模块各出一个预测值,右上角相加,过一个线性层,输出每只票明天涨跌的预测。右侧两个虚线框是两种图:绿框是股票-预定义概念二分图,紫框是每天现挖的隐藏概念小集团。
我把它翻译成一张更直的图:
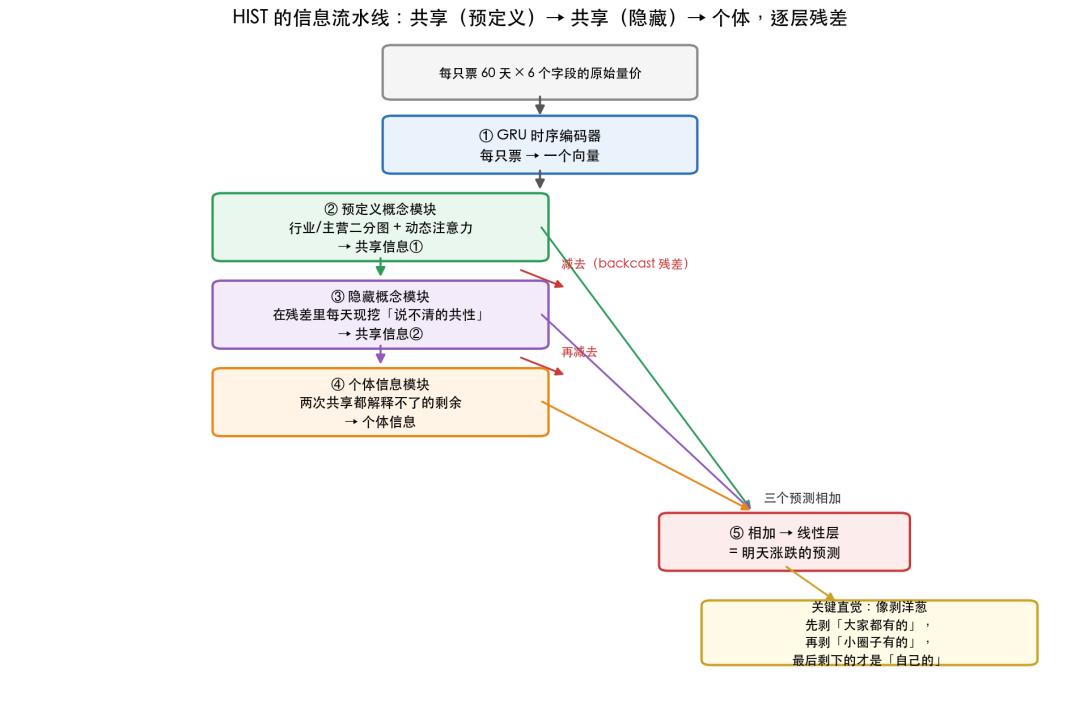
这张图在说什么:像剥洋葱。第一层剥「大家都有的」(预定义概念共享信息),第二层剥「小圈子有的」(隐藏概念共享信息),最后剩下的才是「这只票自己的」。三层各出一个预测,加起来做最终判断。
为什么这样设计好?后面「为什么好」一节细说,先记住直觉:它把一道难题拆成了三道简单的题。
预定义概念模块:指数加权法 + 点名修正
这个模块分两步,对应论文 4.2 节。
第一步,初始化概念表示——抄股票指数的作业。 一个概念(比如「白酒」)的向量,怎么从成员票得来?论文的做法和指数公司编指数一模一样:按市值加权求和(公式 4、5)。茅台市值大,它对「白酒」这个概念长什么样的发言权就大。这很符合金融直觉:板块的「脸色」本来就看权重股。
第二步,修正概念表示——给花名册补漏、降级。 拿到初始概念向量后,论文让所有股票(不只是花名册上登记在册的)跟所有概念算余弦相似度,softmax 归一化后重新加权聚合(公式 6、7)。这一步同时治两个病:
- 某只票没登记在「电商」概念下,但跟「电商」向量高度相似 → 自动补进去(查漏);
- 某只票登记在「云计算」下,但跟它相似度很低 → 权重自动变小(降级)。
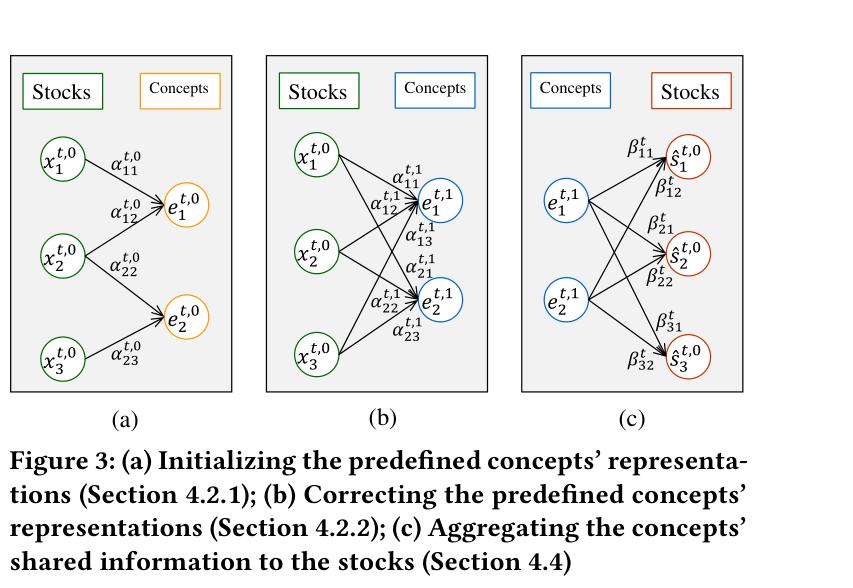
这张图在说什么:(a) 按市值加权把成员票聚合成概念向量;(b) 用相似度注意力修正——注意虚线箭头,没登记的票也可能被拉进概念,登记了的票也可能被冷落;(c) 修正后的概念向量再反向聚合回每只票,得到这只票的「预定义共享信息」。
隐藏概念模块:在残差里每天挖「说不清的共性」
这是全文最精彩的部分,论文 4.3 节。注意它的输入:已经减掉预定义共享信息之后的残差向量。这个顺序很重要——行业能解释的部分先拿走,剩下「行业解释不了但票与票之间仍然同涨同跌」的部分,才是隐藏概念的地盘。
算法只有五步,朴素得让人意外:
- 每个残差向量先自封一个「隐藏概念」:n 只票就假设 n 个候选概念,用票自己的向量初始化;
- 两两算余弦相似度:当天全截面,n×n 的相似度矩阵;
- 每只票只连最像的那一个邻居(排除自己);
- 没人连的候选概念删掉;被连上的概念,把自己(自连接)也加回去;
- 连在一起的票加权求和,得到这个隐藏概念的表示。
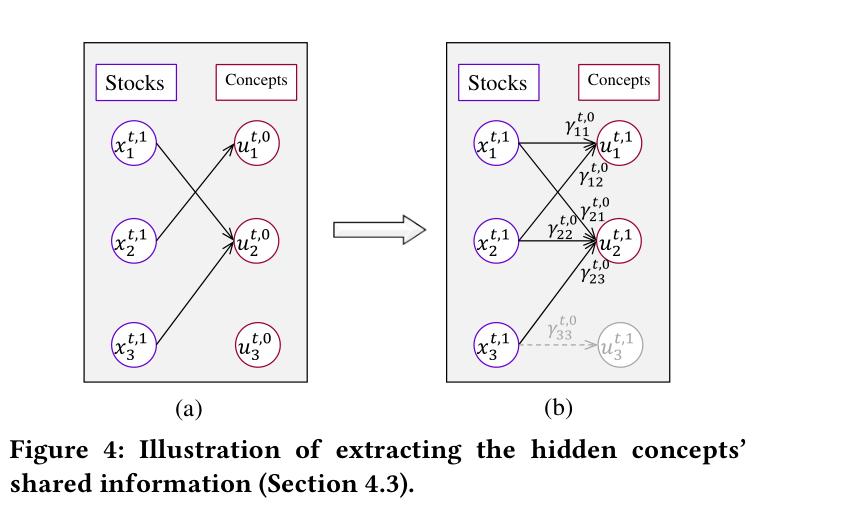
这张图在说什么:左图是第 2、3 步——每只票朝自己最像的邻居连一条边,H3 没人连,删掉;右图是第 4 步——活下来的概念加上自连接。就这样,当天的「隐藏板块」自动浮现。
再用我自己的话画一遍这五步:
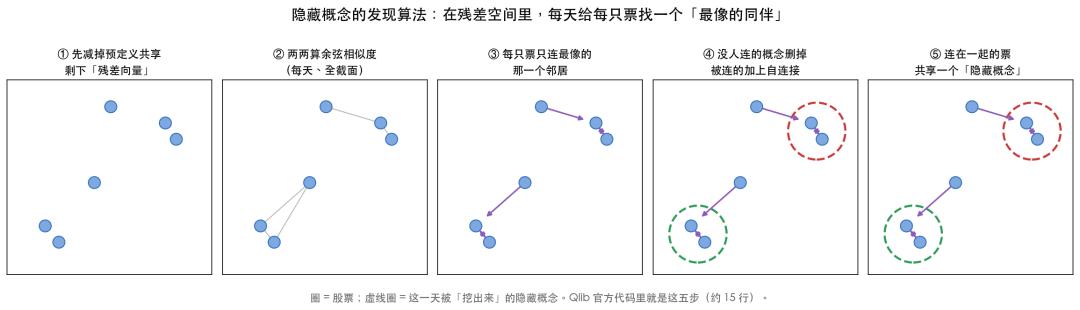
这张图在说什么:六个点是六只票当天的残差向量。第③步之后,它们自动两两(或成组)结对;虚线圈就是「这一天被挖出来的隐藏概念」。明天数据变了,残差变了,圈子就重新结——所以隐藏概念是每天重新发现的,不是学死的一组参数。
说实话,「每只票只连一个最像的邻居」是个非常粗暴的假设(1-近邻图)。但它赢在两点:零超参数(不用预先定有几个概念),零额外监督(不需要任何标签)。论文用结果证明了这个粗暴假设够用。
概念→股票:每天重学的余弦注意力
挖出概念表示后,还要把概念信息聚合回股票。这里就是治「病症一」的关键机制(论文 4.4 节,公式 10、11):
每只票和每个概念算余弦相似度,对概念维度做 softmax,得到权重 β。β 的含义极其直白:「这只票今天有多大比例属于这个概念」。封控期的 Amazon,β(电商) 自动变大、β(云计算) 自动变小——不需要任何人告诉模型。
预定义模块和隐藏模块共用这一套聚合机制。两个模块各产出两路输出(论文 4.5 节,公式 12):
- forecast 输出:送往最终预测;
- backcast 输出:从下一模块的输入里减掉(双层残差)。
最后,个体信息模块(4.6 节)把两次减剩下的残差过一个全连接层,作为「这只票自己的信息」。三路预测相加,过线性层,输出(公式 3、14)。训练目标就是最普通的 MSE——没有任何花哨的损失函数,全部增益来自结构。 这一点和我们在 Forecast Collapse 那篇里看到的「损失函数决定模型在考什么」互为镜像:HIST 的论文证明,有时候换结构比换损失更根本。
代码走读:Qlib 官方实现比论文简化了什么
Qlib 把 HIST 收进了官方模型库(qlib/contrib/model/pytorch_hist.py),榜单数字就出自这份代码。逐行读下来,它和论文有两处实质差异,必须讲清楚——因为榜单上的 HIST 不等于论文里的 HIST。
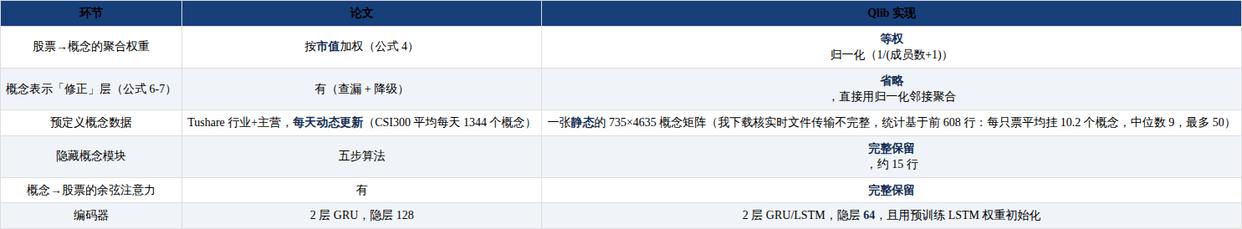
换句话说:动态注意力 + 隐藏概念挖掘这两个核心机制原封不动,被简化的是预定义概念那条支线。 下面这段是官方实现里隐藏概念模块的浓缩版(变量名与原代码一致):
# —— 隐藏概念模块(qlib/contrib/model/pytorch_hist.py 浓缩)——
i_shared_info = x_hidden - e_shared_back          # ① 残差:减掉预定义共享信息
S = cal_cos_similarity(i_shared_info, i_shared_info)  # ② 当天全截面两两余弦
S = S * (ones - eye)                              #    排除自己
column = S.max(1)[1];  value = S.max(1)[0]        # ③ 每只票只保留最像的一个邻居
S = zeros;  S[row, column] = value
S += diag((S.sum(0) != 0) * diag_orig)            # ④ 有人连的概念加自连接,没人连的删掉
hidden = i_shared_info.T @ S .T                   # ⑤ 概念表示 = 成员加权求和
i_concept_to_stock = softmax_t2s(cos(res, hidden))# 概念→股票:余弦注意力(softmax 在概念维)
i_shared_info = fc_is(i_concept_to_stock @ hidden)
读这段代码时最让我停顿的是第③步:S.max(1)[1]——一个 argmax,每只票只认一个同伴。没有注意力头,没有可学习矩阵,就是「找最像的邻居」。整个隐藏概念发现机制在工程上这么轻,是这篇文章最迷人的地方:它把「发现板块」这件听起来需要知识图谱的事,变成了一个最近邻问题。
想在本地原样跑出榜单数字,官方给了完整入口,三条命令:
pip install pyqlib
python -m qlib.run.get_data qlib_data --target_dir ~/.qlib/qlib_data/cn_data --region cn
qrun examples/benchmarks/HIST/workflow_config_hist_Alpha360.yaml   # 需要一张 GPU,200 epoch
而决定「跑出来是什么口径」的,是这份 yaml 里的几行,值得逐行看懂:
model:
  class: HIST
  kwargs:
    d_feat: 6# Alpha360 = 6 个字段 × 60 天;代码内部 reshape 成 [N, 60, 6] 当序列喂给 GRU
    hidden_size: 64# 论文 Table 3 用 128,Qlib 用 64 —— 榜单数字出自这一份
    lr: 1e-4# 论文最优 2e-4
    base_model: LSTM
    model_path: benchmarks/LSTM/model_lstm_csi300.pkl# 编码器用预训练 LSTM 权重初始化
    metric: ic# early stopping 看验证集 IC,不是看 loss
label: ["Ref($close, -2) / Ref($close, -1) - 1"]        # 次日收益;shift 一天避免 lookahead
strategy: TopkDropoutStrategy(topk=50, n_drop=5)# 持 50 只、每天最多换 5 只
exchange_kwargs: {limit_threshold: 0.095, open_cost: 0.0005, close_cost: 0.0015}  # 涨跌停+双边成本
最后一行尤其重要:这个榜单的回测是带涨跌停限制和真实成本假设的,这是它比一般论文回测可信的原因,也是论文 120% 累计收益和榜单 9.87% 年化不能直接对表的另一个技术细节。
基准一:论文自己的考场
论文在 CSI100 和 CSI300 两个股票池上跑,数据是 Qlib 的 Alpha360(每只票 60 天 × 6 个字段的原始量价),时间切分:2007–2014 训练、2015–2016 验证、2017–2020 测试。标签是次日收盘价涨跌幅,同一天的标签做归一化。每个结果重复 10 次报均值和标准差。
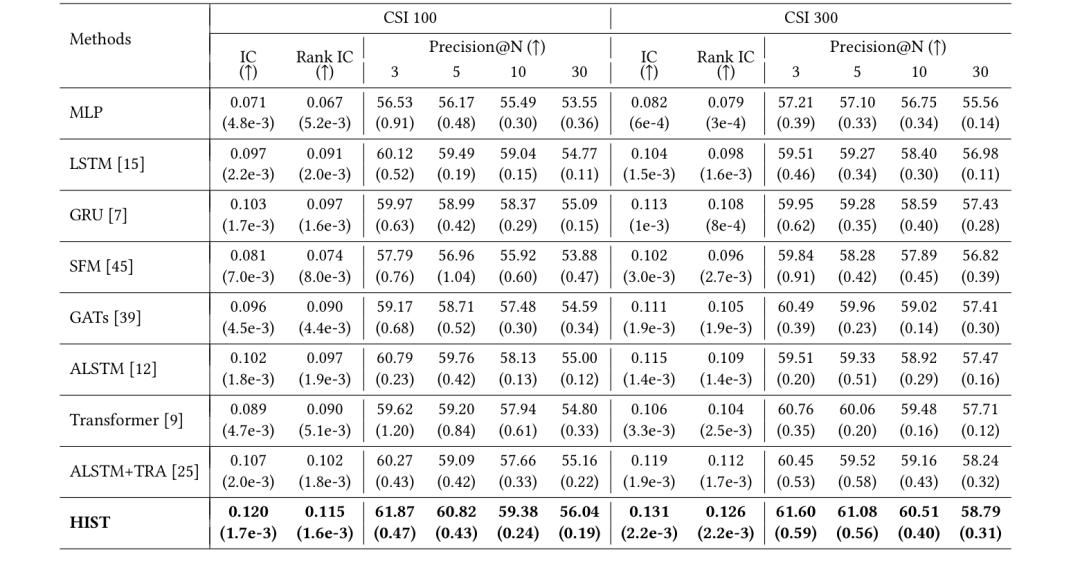
这张表在说什么:CSI300 上,HIST 的 IC 0.131、Rank IC 0.126,对第二名 ALSTM+TRA(0.119/0.112)是明显的身位差;Precision@30(每天预测最看好的 30 只里真正上涨的比例)58.79%,比最强基线高 0.55 个百分点、比 GRU 高 1.36 个百分点。CSI100 上同样全第一(0.120/0.115)。
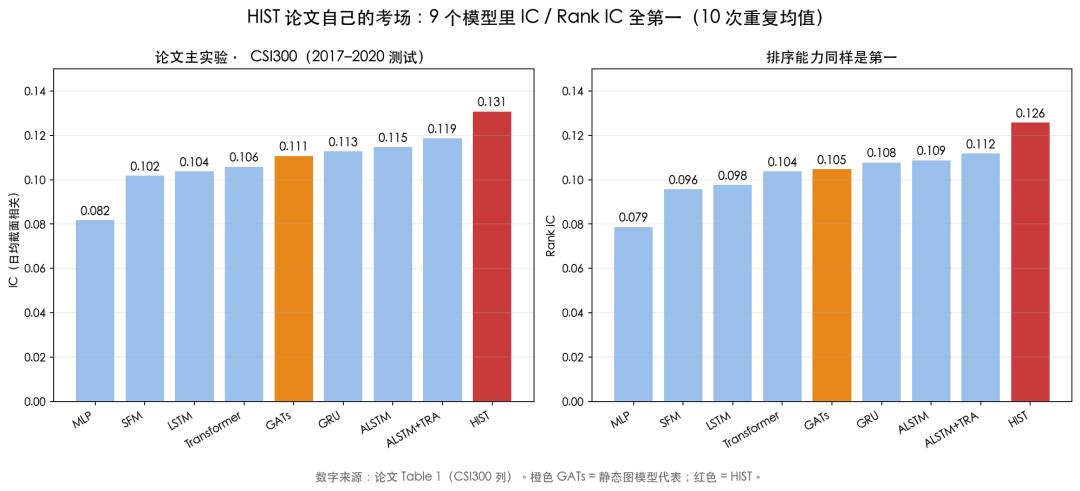
这张图在说什么:把 CSI300 那列画成条形图。注意两个细节:一是 HIST 对 GRU(0.113)的优势约 0.018 个 IC 点——上一篇讲过,在日频截面上这是「完全不同的两条净值曲线」的差距;二是图模型 GATs(0.111)并没有比 ALSTM(0.115)强,说明「用上股票关系」本身不保证赢,怎么用才决定胜负——静态关系的 GATs 输给了动态概念的 HIST。
消融实验(Table 2)把每个组件的贡献拆给你看(CSI300):
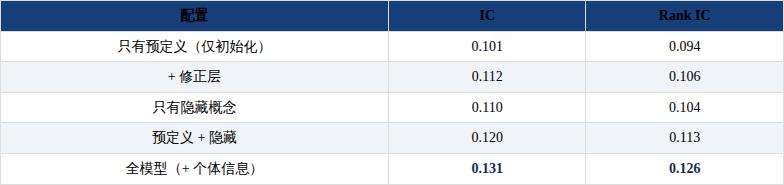
三个读数:修正层单独贡献 +0.011 IC(「查漏降级」真的有用);只用隐藏概念、完全不看花名册的版本(0.110),几乎追平走完两步的完整预定义模块(0.112)——人类花名册和模型自挖共性,信息量几乎对等;三路全开最高,说明三者互补。
投资模拟(论文 5.5 节):每天按预测排序买最看好的 k 只、等权、卖出掉出榜单的,k 在验证集上从 {10,20,30,40,50} 里网格搜出 30;初始资金 1 亿,买入成本 0.05%、卖出 0.15%。2017–2020 四年,HIST 累计收益 120%+,比沪深300指数高约 70 个百分点,且扛过了 2018 年的熊市。
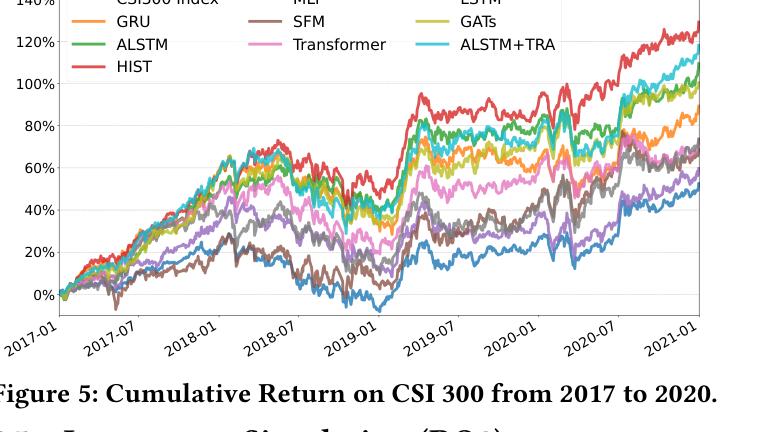
这张图在说什么:红线是 HIST,全程基本压在所有模型头上;2018 年全市场下跌时它也回撤,但回撤后创新高的速度最快。蓝线群里有两条(Transformer、SFM)四年下来几乎原地踏步——在截面预测这个考场上,架构选错的代价是整整四年。
基准二:Qlib 统一榜单
论文自己的考场再公平,也是「自己出题自己考」。Qlib 榜单的价值在于统一流程:同样的数据、同样的回测规则(TopkDropout 策略:持 50 只、每天最多换 5 只;涨跌停 9.5% 限制;买 0.05%/卖 0.15% 成本)、20 个随机种子报均值±标准差。
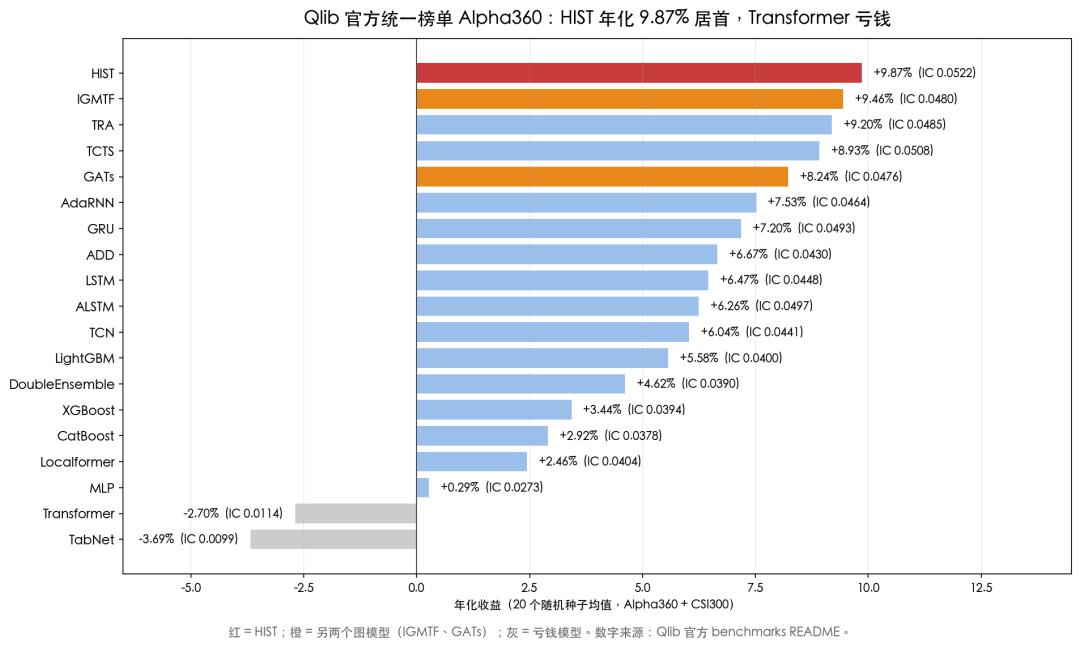
这张图在说什么:19 个模型按年化收益排序。HIST 9.87% 第一,IC 0.0522、Rank IC 0.0667、信息比率 1.37 也全是第一;最大回撤 -6.81% 与最优档同列(唯一比它更小的是年化只有 5.58% 的 LightGBM,-6.59%)——收益、排序、稳定性三个维度同时站在榜首,这张榜上独此一家。作为对照:Transformer 年化 -2.70%,TabNet -3.69%。
这里必须停下来,讲一件很多解读文章会绕过去的事。
一个必须正面回答的问题:0.131 和 0.0522
论文自己考场里 IC 0.131,Qlib 统一考场里 IC 0.0522——差了两倍半。同一个模型,为什么?
我不能给你一个「就是因为 X」的确定答案(那需要把两套流水线逐行对齐重跑,超出本文范围),但把能核实的事实摆出来,你可以自己判断:
- Qlib 版实现是简化版:市值加权变等权、修正层被删、动态概念表变静态矩阵(见代码走读一节)。论文消融里仅「修正层」就值 0.011 IC,简化掉它必然掉点。
- 两套数据管道不同:论文的概念数据来自 Tushare、每天更新(CSI300 平均每天 1344 个概念);Qlib 用的静态矩阵只有 4635 个概念列、且不再随时间变。
- 标签与归一化不同:Qlib 流程对标签做截面 rank 归一化(CSRankNorm)、特征做稳健 z-score,回测还有涨跌停与换手约束——整套更接近真实交易,也更难「考高分」。
- 超参不同:论文隐层 128、学习率 2e-4;Qlib 配置隐层 64、学习率 1e-4。
这四条加起来,足以解释大部分差距。而这件事本身值得当成一个独立结论记住,它和上一篇《真实世界里的时序模型》的核心观点是同一个:论文里的数字和榜单上的数字,都是「流水线的数字」,不是「模型的数字」。 比较模型之前,先比较流水线。HIST 在两个流水线上都拿第一,这才是它可信的原因——绝对值不同,相对位次稳定。
我们自己的教学实验:机制在真实数据上看得见吗
声明:这一节不是复现论文。我们用自己的数据(69 只 A 股、9 个行业板块、2016–2025 日前复权日线,数据源为腾讯行情接口;训练 2016–2021 / 验证 2022 / 测试 2023–2024)搭了一个教学版实验,目的是回答一个问题:HIST 的核心机制,换一批数据还看得见吗? 模型规模、概念粒度都远小于论文,数字只用于横向比较,不要拿去和论文绝对值比。
三个结果,好坏都报。
结果一:机制是看得见的,而且非常清楚。 测试期每个交易日,隐藏概念模块给每只票指派一个「最像的同伴」;我们统计这个同伴与它同行业的比例:78.0%,而随机结对的期望只有 9.9%——8 倍。注意模型从头到尾只看见量价,没看过行业标签:它凭价格行为自己重新认出了那 9 个板块。
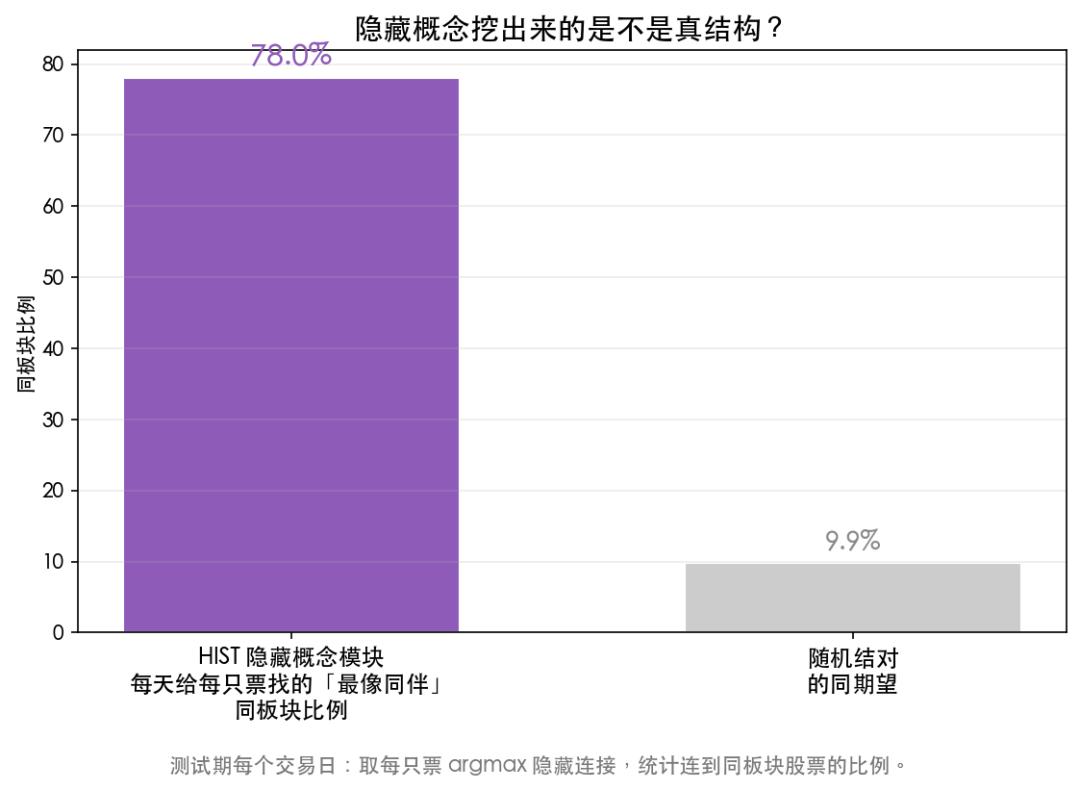
这张图在说什么:左柱是 HIST 隐藏概念模块每天 argmax 连接里「连到同行业股票」的比例(78%),右柱是随机结对的同期望(约 10%)。这就是「隐藏概念挖出来的是真结构」在教学数据上的版本——论文用 2017 年一天的热力图定性展示的事,我们用 726 个交易日做了定量验证。
结果二:内部消融的方向和论文一致。
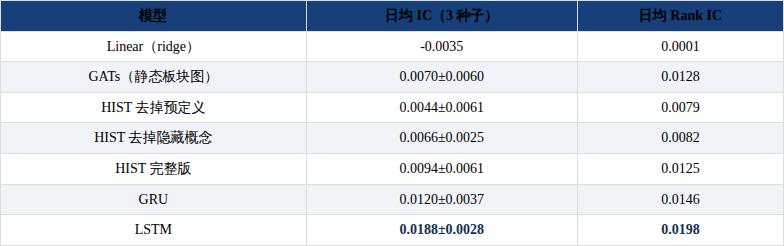
完整 HIST(0.0094)> 去掉隐藏(0.0066)> 去掉预定义(0.0044)——三个模块逐个做贡献,方向和论文 Table 2 完全一致;静态图的 GATs 也如论文那样处在中间位置。
结果三:但完整 HIST 输给了 LSTM。 0.0094 对 0.0188,差一倍;top-10 组合的累计收益(2023–2024,未扣成本)也是 GRU 21.4% > LSTM 18.2% > HIST 10.6%。这个负结果必须原样摆出来,而且它本身就是本文最重要的教学点之一:
HIST 的优势是「截面规模 × 概念丰富度」的函数。 论文有 300 只票、平均每天 1344 个动态概念;Qlib 版有 300 只票、4635 个概念列;我的实验只有 69 只票、9 个 one-hot 板块。隐藏概念的 1-近邻图需要足够密的截面才能连出有意义的结构(69 个点里找最近邻,噪声占比大得多),粗概念又让预定义模块退化成「板块哑变量」。于是:结构是真的(结果一、二),但结构转化为收益需要数据条件(结果三)。这也顺带解释了为什么 Qlib 的实现简化掉论文好几个组件仍然拿第一——300 票 × 几千概念的截面足够厚,核心机制(动态注意力 + 残差挖概念) alone 就吃得开。
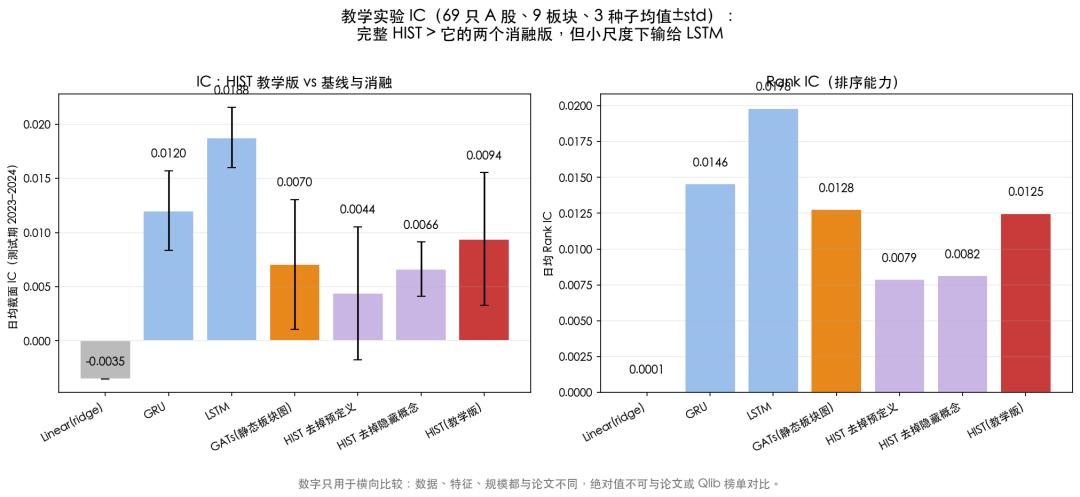
这张图在说什么:七个配置的 IC / Rank IC。读法不是「谁第一」,而是两组对比:HIST 家族内部逐级递增(结构在干活),家族整体在 LSTM 之下(小尺度下干不过纯序列模型)。
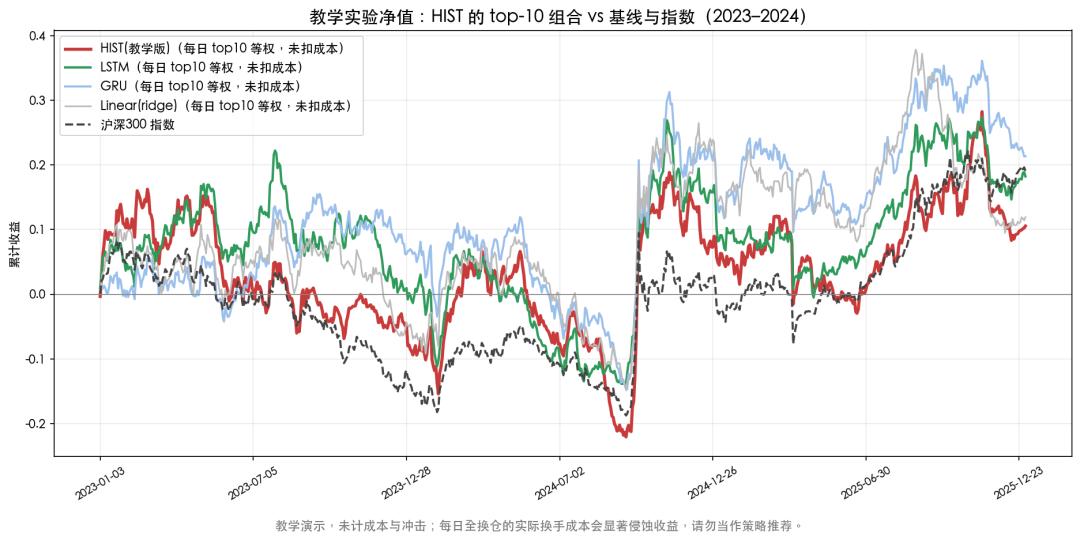
这张图在说什么:按各模型每日预测选 top-10 等权持有、次日换仓(未扣成本)的累计收益,对照沪深300。它和 IC 的排序互相印证。再次强调:每日全换仓的换手成本会严重侵蚀这些数字,这里只用于模型间横向对照,不是策略推荐。
代码附录:最小 HIST,抄走就能跑
上面教学实验用的就是我自己的精简实现。这里给出完整可运行的最小版本——论文公式 2–14 的全部核心,约 50 行,与 Qlib 官方实现逐行对应(我验证过前向和反向都能跑):
import torch, torch.nn as nn, torch.nn.functional as F

def cos_sim(x, y):   # x[N,d] 与 y[M,d] 的行间余弦相似度矩阵
    return (x @ y.T) / (x.norm(dim=1, keepdim=True)
                        @ y.norm(dim=1, keepdim=True).T + 1e-6)

class MiniHIST(nn.Module):
    def __init__(self, d_feat=6, win=30, hidden=32):
        super().__init__()
        self.d_feat, self.win = d_feat, win
        self.gru = nn.GRU(d_feat, hidden, num_layers=2, batch_first=True)
        # 每条分支两个出口:fore 去预测,back 去残差(backcast,公式 12)
        self.fc_es, self.fc_es_back, self.fc_es_fore = (nn.Linear(hidden, hidden) for _ in range(3))
        self.fc_is, self.fc_is_back, self.fc_is_fore = (nn.Linear(hidden, hidden) for _ in range(3))
        self.fc_indi, self.fc_out = nn.Linear(hidden, hidden), nn.Linear(hidden, 1)

    def forward(self, x, s2c):
        # x [N, win*6] 当天 N 只票的窗口;s2c [N,C] 概念隶属 0/1 矩阵
        h = self.gru(x.view(-1, self.win, self.d_feat))[0][:, -1]      # 公式 2
        # —— 预定义概念模块:聚合 → 余弦注意力(公式 10)→ 双出口 ——
        agg = (s2c / (s2c.sum(0, keepdim=True) * s2c + 1)).T @ h       # Qlib 版等权聚合
        concepts = agg[agg.sum(1) != 0]                                # 删掉空概念
        es = self.fc_es(F.softmax(cos_sim(h, concepts), 1) @ concepts) # β 注意力回聚合
        e_back, out_es = self.fc_es_back(es), F.leaky_relu(self.fc_es_fore(es))
        # —— 隐藏概念模块:残差里五步找同伴(4.3 节)——
        res = h - e_back                                               # ① 剥掉预定义共享
        S = cos_sim(res, res) * (1 - torch.eye(len(res), device=res.device))  # ② 两两余弦,去自连
        val, nbr = S.max(1)                                            # ③ 每票只连最像的一个
        L = torch.zeros_like(S); L[torch.arange(len(res)), nbr] = val
        L = L + torch.diag((L.sum(0) != 0).float() * S.diagonal())     # ④ 有人连的加自连接
        hidden = ((res.T @ L).T); hidden = hidden[hidden.sum(1) != 0]  # ⑤ 概念=成员之和
        i_sh = self.fc_is(F.softmax(cos_sim(res, hidden), 1) @ hidden)
        i_back, out_is = self.fc_is_back(i_sh), F.leaky_relu(self.fc_is_fore(i_sh))
        # —— 个体模块 + 三路相加(公式 3)——
        indi = h - e_back - i_back
        return self.fc_out(out_es + out_is
                 + F.leaky_relu(self.fc_indi(indi))).squeeze(-1), L    # L 可用于分析挖到的圈子
训练与评估的骨架同样有讲究——HIST 必须按「交易日」组 batch,因为它的两个核心机制(余弦注意力、最近邻图)都是当天截面上的运算,把不同天的票混进一个 batch 在语义上就是错的:
model = MiniHIST(); opt = torch.optim.Adam(model.parameters(), 1e-3)
for epoch in range(30):                                   # Qlib 用 200 + early stop 20
    for t in train_days:                                  # 一个交易日 = 一个 batch
        x, s2c, label = panel[t]                          # 接你自己的数据面板
        yl = (label - label.mean()) / (label.std() + 1e-8)  # 当日标签归一化(论文/Qlib 同款)
        pred, _ = model(x, s2c)
        loss = ((pred - yl) ** 2).mean()                  # 公式 14:最普通的 MSE
        opt.zero_grad(); loss.backward()
        torch.nn.utils.clip_grad_value_(model.parameters(), 3.0)  # 与 Qlib 官方一致
        opt.step()
    # early stopping 看验证集 IC(Qlib 的 metric: ic),别看 loss —— 我们要的是排序能力

def daily_ic(pred, y):                                    # 评估:每天截面 Pearson,再对天平均
    p, y = pred - pred.mean(), y - y.mean()
    return float((p * y).sum() / (p.norm() * y.norm() + 1e-9))
两个容易踩的坑,都是我自己跑的时候摔过的:一是 s2c.sum(0, keepdim=True) * s2c + 1 这个归一化别写成普通 softmax,它等价于「概念取成员的等权平均再加一点自持」,和 Qlib 官方逐行一致;二是评估一定要先按天算 IC 再平均,把全部 (股票, 日期) 对池在一起算总 IC 会得到虚高得多的数字——这个坑在 Forecast Collapse 那篇里专门讲过。
forward 返回的 L 别扔:它就是当天挖出来的隐藏概念连接矩阵。本文「78% 同板块」和共连热力图,就是对它做了两行统计:j = L.argmax(1),然后数 sector[j] == sector[i] 的比例。
数据获取也附上(本文教学实验用的是腾讯源,东财源代码同构、字段更全;公共接口请低速调用):
import json, urllib.request
def kline_tencent(code, beg="2016-01-01", end="2026-01-01"):   # 前复权日线
    sym = code.lower()                                          # "SH600519" -> "sh600519"
    url = ("https://web.ifzq.gtimg.cn/appstock/app/fqkline/get"
           f"?param={sym},day,{beg},{end},800,qfq")             # 单次上限 800 根,长区间分段取
    d = json.load(urllib.request.urlopen(url, timeout=30))["data"][sym]
    return d.get("qfqday") or d.get("day")                      # [date, open, close, high, low, vol]
把 kline_tencent 的返回值按「日期 → 截面」组织成 panel[t] = (x, s2c, label),上面整条流水线就能从裸数据一直跑到 IC 报表。
案例:HIST 挖出过什么
论文 5.6 节把 2017 年 1 月 3 日的隐藏概念权重矩阵做了层次聚类热力图,放大后人工辨认了几个圈子:
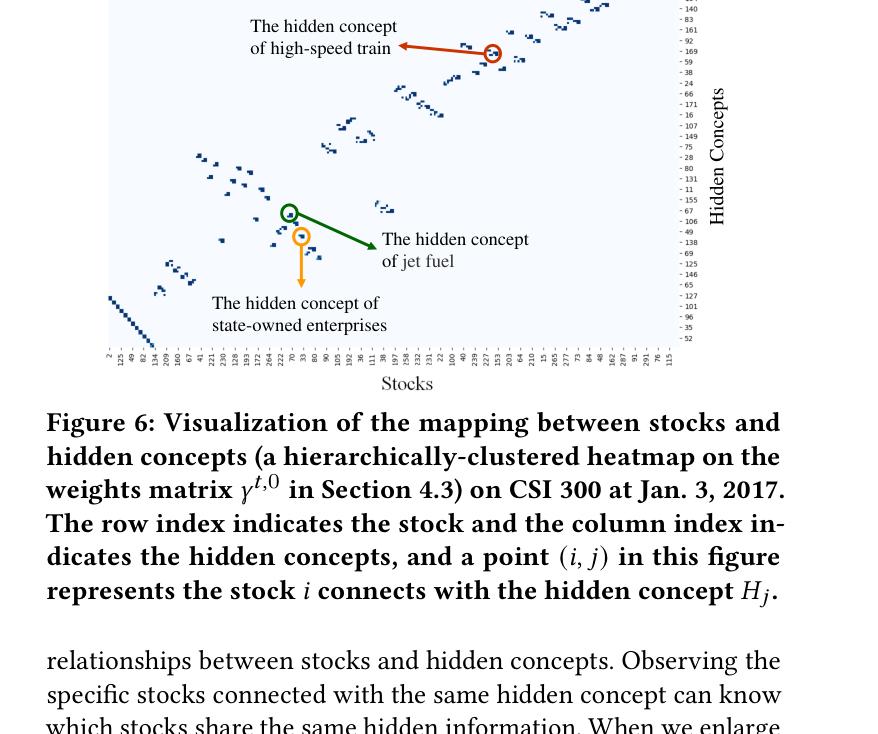
这张图在说什么:行是股票、列是隐藏概念,一个点表示「这只票当天连上了这个概念」。红圈里的四只票分别是铁路建设、车辆制造、高铁维护公司——它们共享的隐藏概念被作者命名为「高铁」;绿圈是石化+航空,命名为「航空燃油」;橙圈是「国企」。这三个概念都不在预定义花名册里——行业分类不会把「航空公司」和「石化公司」放进同一个篮子,但它们的利润确实被同一桶原油推动。
这是全文我最喜欢的一张图。它说明隐藏概念模块挖出来的不是噪声团,而是人类事后能点头的经济逻辑。模型没有读新闻,它只是从「残差里的同涨同跌」里,重新发现了原油这条产业链。
我们用教学实验做了一个「群体版」的验证:把测试期 726 个交易日里所有 argmax 隐藏连接累加成一张 69×69 的共连矩阵,按真实行业排序画热力图。
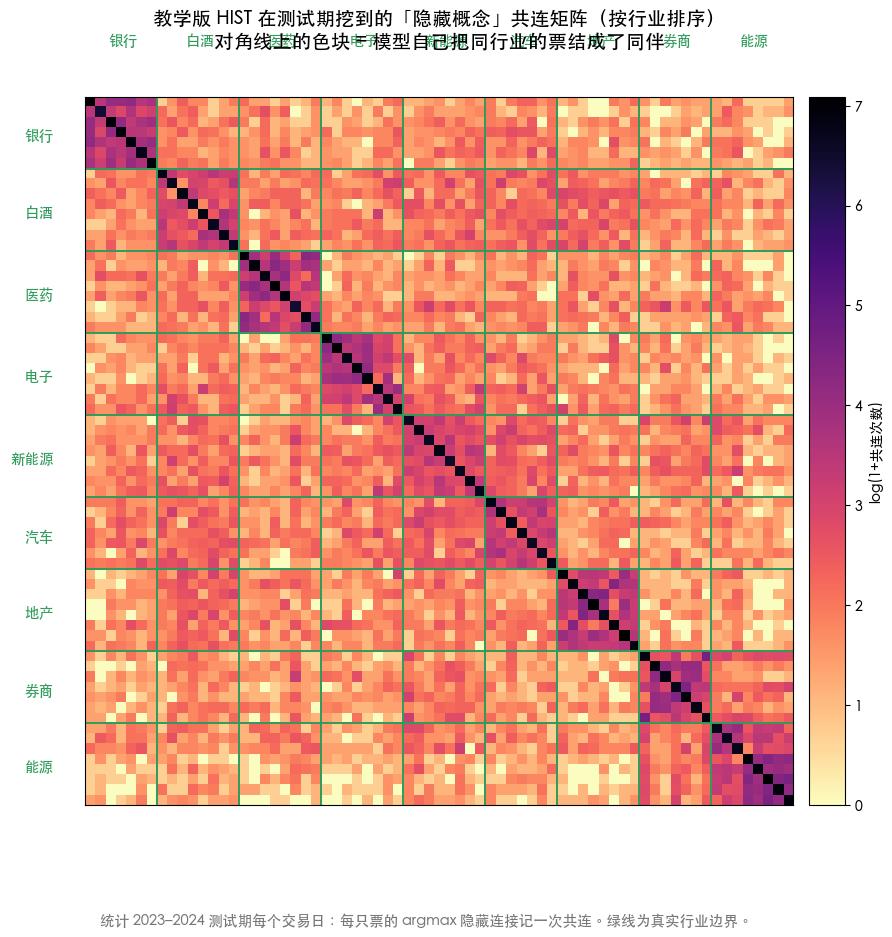
这张图在说什么:如果隐藏概念挖到的是真结构,那么按行业排好序后,矩阵应该呈现沿对角线的色块——同行业的票互相结为同伴的次数远高于跨行业。结果正是这样:银行、白酒、能源等板块的对角块明显发亮(78% 的同板块比例就是这张图的统计摘要)。模型没有读过任何行业资料,它从「残差里的同涨同跌」里,把板块重新发明了一遍。
为什么好:三层理解
把所有证据摆在一起,我给 HIST 的优势找三层解释,从具体到抽象:
第一层(工程层):动态注意力修好了静态图。 GATs 在论文考场和 Qlib 考场都稳定地输给它,差的不是容量,是「连接会不会随时间变」。
第二层(信息层):它把横截面信息变成了主菜。 上一篇我们说过,Qlib 榜单的赢家都在解决「如何利用股票之间的横截面关系」。HIST 做得最彻底:GRU 只负责把单票历史压成向量,真正的预测增量全部来自当天截面上的互相参照。这正好解释了为什么 Transformer(纯单票序列建模)在这个考场上亏钱——它不是模型差,是考卷不考它复习的内容。
第三层(统计层):残差分解降低了任务难度。 预测「茅台明天涨多少」很难;预测「白酒板块明天整体的方向」+「茅台相对板块的偏离」,两个子任务各自都更简单。双层残差强迫模型先答容易的共性题、再答难的个性题——和 N-BEATS 把序列拆成趋势+季节是同一个思想,只不过拆的维度从时间换成了截面。
这三层里,第二层和我们这个系列的主线直接相关:日频股票预测里,alpha 的主要来源是截面排序,而截面排序的信息主要在「票与票的关系」里。 HIST 是这条主线目前最完整的实现。
什么时候该想到 HIST
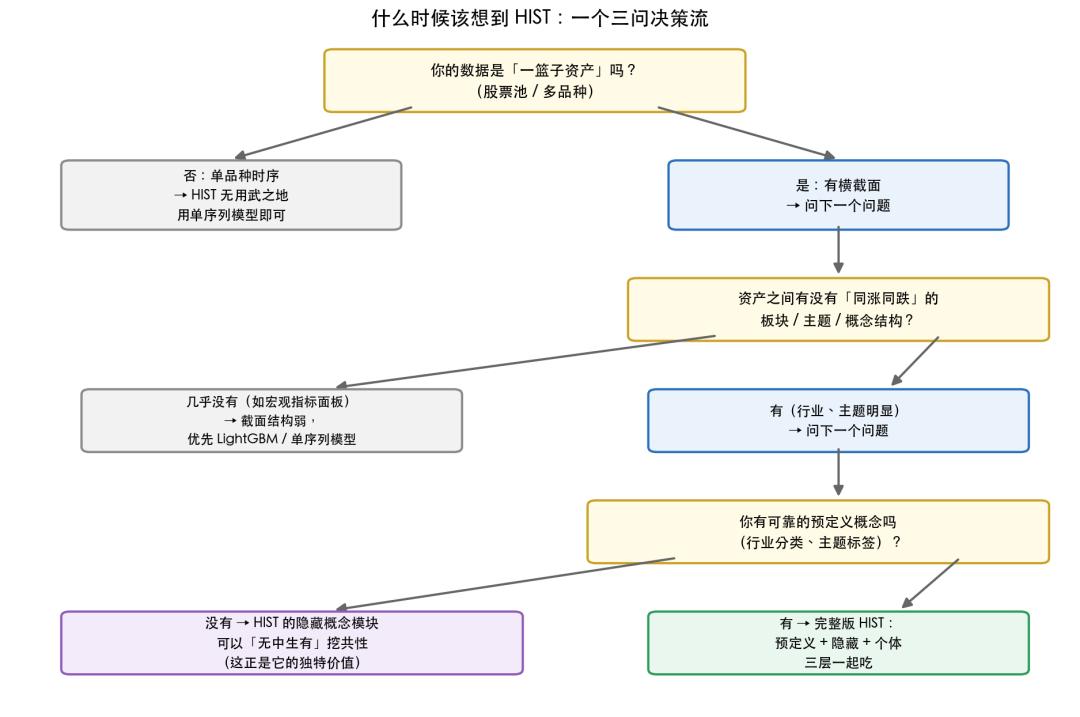
这张图在说什么:三个问题顺着问——你的数据是一篮子资产吗?资产之间有没有同涨同跌的板块结构?你有没有可靠的预定义概念?三个都「有」,上完整版 HIST;最后一个「没有」,恰恰是 HIST 最独特的用武之地——它的隐藏概念模块可以在没有花名册的情况下自己挖共性;前两个问题答「没有」,就别用,单序列模型或树模型更合适。
冷静清单:这篇的边界
- 单一市场验证:论文只在 A 股(CSI100/CSI300)做过实验。美股、加密、其他频率上是否成立,论文没说,我也不知道。
- 论文数字与复现数字的落差:0.131 vs 0.0522,原因分析见专节。引用任何一边时请带上流水线。
- Qlib 实现是简化版:榜单第一的 HIST 没有论文的市值加权和修正层。想复现论文满血版,需要自己补。
- 隐藏概念 = 1-近邻图,假设极强:每天每只票只认一个同伴。它够用,但不优雅;圈子超过两只票的结构要靠传递性间接浮现。
- 预定义概念依赖外部数据质量:论文用 Tushare 的行业+主营,Qlib 用静态矩阵。概念表错了或旧了,第一层就在垃圾上进垃圾。
- 回测不是实盘:Qlib 回测已算涨跌停和成本,但没有冲击、容量、融券约束。9.87% 是回测数字。
- 榜单标准差提醒:上一篇讲过,20 个种子的年化标准差有 2-3 个百分点。HIST 的 ±0.02 已经很小,但单次运行仍可能骗你。
- 我的教学实验规模小(69 票、9 个手工板块),只证明机制可见,不证明收益可复现。
结尾:下一篇
HIST 是榜单第一,但它第二名 IGMTF(9.46%)出自同一组作者,思路是「用模型自己学出来的隐式关系建图」,和 HIST 的显式概念路线正好互补。下一篇拆它。
在那之前,带走一句话就够了:当你手里有一篮子会互相影响的资产,别只让模型看每只票自己的历史——它「跟谁一起动」这件事里,藏着一半以上的答案。而有些「一起动」的圈子,人类还没起好名字。
参考文献与出处
- HIST 论文:Wentao Xu, Weiqing Liu, Lewen Wang, Yingce Xia, Jiang Bian, Jian Yin, Tie-Yan Liu. HIST: A Graph-based Framework for Stock Trend Forecasting via Mining Concept-Oriented Shared Information. arXiv:2110.13716v2(2021 年 10 月,v2 2022 年 1 月)。本文全部论文数字(Table 1、Table 2、投资模拟、概念案例)的唯一来源:https://arxiv.org/abs/2110.13716
- HIST 官方代码仓库:https://github.com/Wentao-Xu/HIST
- Qlib 官方基准榜单(Alpha360/Alpha158 全部数字、20 种子均值±标准差):https://github.com/microsoft/qlib/blob/main/examples/benchmarks/README.md
- Qlib HIST 实现:
qlib/contrib/model/pytorch_hist.py,代码走读一节的来源:https://github.com/microsoft/qlib - Qlib HIST 训练配置:
examples/benchmarks/HIST/workflow_config_hist_Alpha360.yaml(隐层 64、学习率 1e-4、LSTM 预训练初始化、TopkDropout(50,5) 等数字的来源) - 概念矩阵与股票索引:
qlib_csi300_stock2concept.npy(735×4635,SunsetWolf/qlib_dataset 发布页)、qlib_csi300_stock_index.npy - N-BEATS(双层残差思想的来源,论文参考文献 [30]):Oreshkin et al., arXiv:1905.10437
- GAT(基线 GATs 的原始架构):Veličković et al., ICLR 2018,arXiv:1710.10903
- 本系列上一篇:《顶级基金实盘在跑的冷门模型,和时序大模型的真相:那些很强但很冷门的架构,以及时序大模型到底有没有用》——Qlib 榜单的口径、20 种子标准差问题、IC 数量级直觉
图表说明:论文原图(Figure 1–6、Table 1)裁自论文 PDF;其余条形图、流程图为我根据论文与 Qlib 官方数据自绘;「静态 vs 动态」「五步算法」等示意图已标注为比喻。