TIEM:时间门控下的金融预测革命——用超图证据与技能记忆跨越“证据鸿沟”
“TIEM: Temporal Integration of Hypergraph Evidence and Skill Memory for Event-Driven Financial Forecasting”
在金融预测领域,事件驱动的催化剂-结果推断正成为大型语言模型(LLM)应用的前沿。然而,一个被称为“证据鸿沟”的困境长期困扰着研究者:报告中的亮眼准确率,在真实部署中往往大幅缩水,其根源在于训练数据污染与时间泄露——模型在训练时可能“偷看”了未来信息,导致看似优异的预测能力实为数据记忆的假象。
为破解这一难题,来自南洋理工大学、Hithink Research、新加坡国立大学和上海交通大学的研究团队提出了TIEM——一个时间戳门控框架,通过三个精心设计的组件实现真正的时序集成:
事件-证据超图(EEH) 构建了从日级别到片段、主题的多层级时间结构,确保检索到的证据严格早于决策时间;
基于案例的技能记忆(CSM) 为每个技能记录完整的来源谱系,通过类EMA机制稳定地积累可迁移经验;
异质证据-经验融合推理(HEFR) 则将五个预算流与并发事实打包为单次上下文的联合推理。
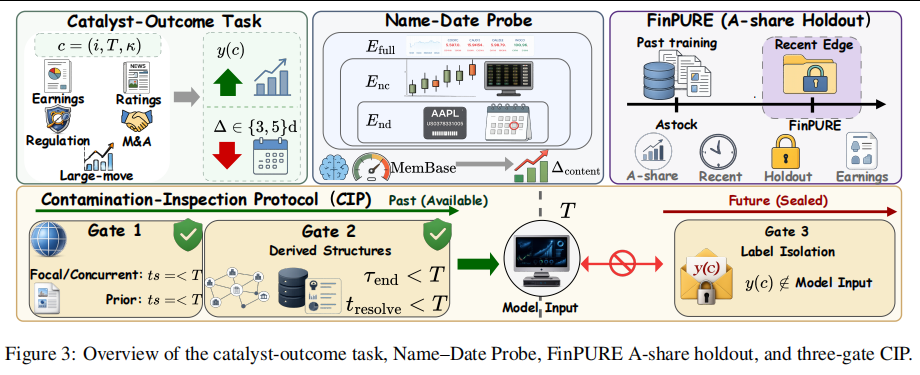
研究还引入了FinPURE这一近期A股保留基准和名称-日期探针来透明化评估模型对名称-日期线索的敏感性。
在Astock、FinPURE、CMIN-US、EDT和CSMD五个基准上的实验显示,TIEM全面超越当前基线,并展现出良好的跨后端一致性与准确率-令牌权衡。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
事件驱动的催化剂-结果预测越来越多地使用检索增强和记忆增强的大型语言模型(LLM)智能体。然而,训练数据污染和时间泄露可能造成报告准确性与真实预测能力之间的“证据鸿沟”。本文提出 TIEM,一个带有时间戳门控的框架,包含三个协同组件:事件-证据超图(EEH),用于时间戳过滤的多层级检索;基于案例的技能记忆(CSM),用于存储带来源标签的时间技能;以及异质证据-经验融合推理(HEFR),用于证据与经验的融合及预测。
此外,本文还引入了 FinPURE,一个近期A股市场保留基准,并使用名称-日期探针(Name-Date Probe) 来评估每个模型对名称和日期的敏感性,而非假设训练截止日期。在五个金融预测基准上的结果表明,TIEM 的性能优于当前基线。
简介
事件驱动的催化剂-结果预测从催化剂事件文本推断价格变动,是LLM在金融领域的重要应用。研究已从价格时间序列模型、公告情绪分析发展到检索增强生成(RAG)和具有可进化记忆的LLM智能体,提升了事件理解、结果预测和决策支持能力。然而,训练数据污染和时间泄露会扩大“证据鸿沟”,使得基准分数无法可靠地代表真实世界预测性能。
现有方法(如GraphRAG、HyperGraphRAG、HippoRAG、LightRAG、Mem0、A-MEM、MemGPT)仍面临三个关键挑战:
多尺度时间结构:催化剂事件跨越同股票事件链和跨行业主题联动,但扁平的单时间戳检索会丢失多尺度结构并引入未来信息,加剧泄露风险。
经验稳定性与来源元数据:可迁移知识需要稳定的记录和来源元数据,但扁平记忆缺乏此类元数据或时间戳门控写入约束,加重了污染问题。
异质证据融合:催化剂结果取决于耦合的焦点事件、同股票先验、事件片段、跨股票主题和历史经验,现有方法常将其扁平化或分阶段处理,破坏了多源联合上下文。
为解决这些问题,本文提出 TIEM,一个时间戳门控框架,通过在一个时间分层的超图和基于案例的技能记忆上运行的三个协同组件来实现时间集成。同时,引入了 FinPURE,一个近期A股保留基准,并使用探针评估每个模型对名称和日期的敏感性。TIEM的三个组件是:
EEH:组织原子事件事实和更高级别的记录,并带有明确的时间范围,用于时间戳过滤的多层级检索。
CSM:通过EVOKE、REVISE、MERGE和RETIRE原语维护带来源标签的技能,并提供检索到的技能流。
HEFR:在一个提示中融合五个预算流(焦点、先验、片段、主题、经验)以及同日并发事实。
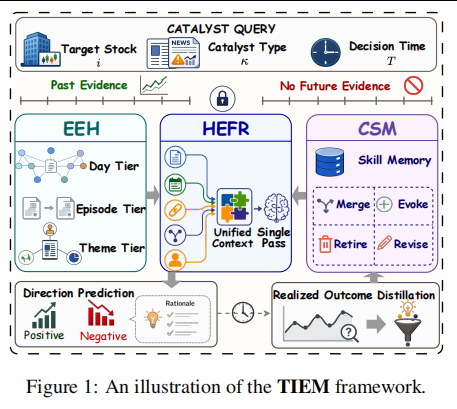
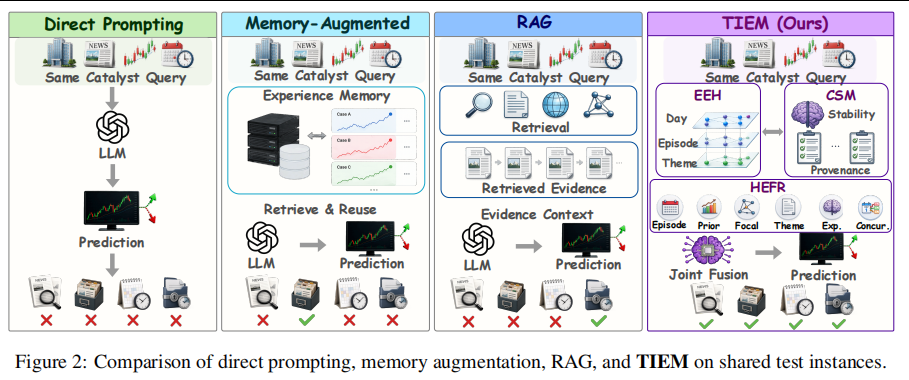
实验结果表明,TIEM在分布内、跨数据集和近期时间段的设置下,均优于当前基线,支持了在明确时间约束下进行时间戳门控证据集成的事件驱动催化剂-结果预测。
相关工作
检索增强生成
除了基础的RAG,相关工作扩展到三个方向:检索控制(如RAPTOR、Self-RAG、CRAG、Adaptive-RAG)、结构化索引(如GraphRAG、LightRAG、HyperGraphRAG)以及处理时间演化知识(如T-GRAG、GenTKG、STAR-RAG)。
记忆增强与技能进化LLM智能体
持久记忆使LLM智能体能够积累经验知识。操作导向的系统(如Mem0、A-MEM、Zep和Graphiti)通过统一的管理原语操作记忆。图结构记忆(如HippoRAG)通过PageRank模拟情景回忆。在领域定制方面,有FinMem、MADAM-RAG。在持续技能进化方面,有AutoSkill、Mem-Skill、MUSE-Autoskill和SkillRL。
任务、基准与协议
任务定义
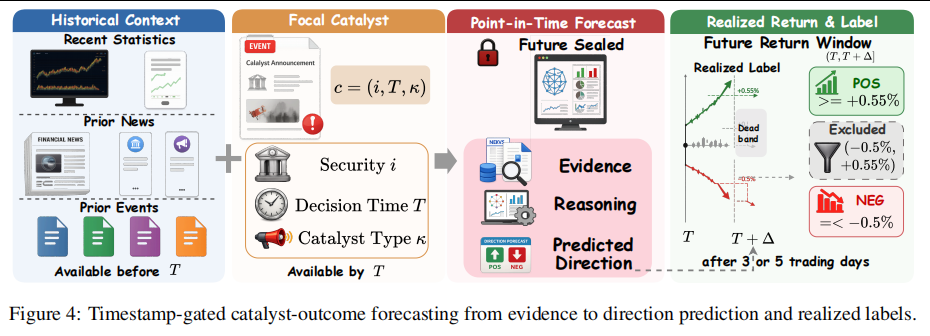
催化剂-目标重定向(CTR)将每次预测定义为 c = (i, T, κ),其中 i, T, κ 分别是证券、决策时间和催化剂类型。标签 y(c),剔除了 (-0.5%, +0.55%) 死区内的回报。预测器 f 在保留数据上生成 MemBase 和 Δcontent。
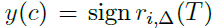
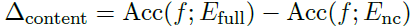
基准构建
FinPURE 是一个仅包含收益、近期A股市场的保留基准,用于测试时间泛化能力。Astock 提供分布内评估,CMIN-US 和 EDT 提供跨市场评估,CSMD 提供跨时间评估。
污染检查协议(CIP)
CIP 通过时间戳门控(决策时间 T)来筛选时间和捷径风险。焦点和并发证据需满足 t_s <= T;先验事件、检索到的片段和主题必须在 T 之前结束。技能要求其所有祖先的解决时间都在 T 之前。提示中不包含 y(c)。
方法
事件-证据超图(EEH)
EEH 将带时间戳的证据组织成时间戳过滤的日、片段和主题三个层级。
日层级:每个事件文档产生原子事实 h = (Sh, ρh, tsh)。对于催化剂 c,Φ(c) 获取决策时间 T 前最新的同股票来源作为焦点文本。先验日检索使用查询 q_c = topic(κ) ⊕ name(i) 对全局候选池进行排序,然后筛选出时间戳在 T 之前的同股票事实。
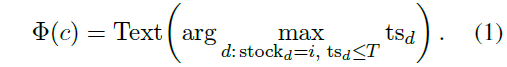
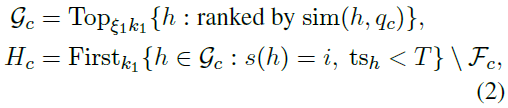
片段层级:EEH 将每只股票的历史事实贪婪地划分为非重叠窗口 H_w,时间跨度 Δ_ep。窗口需满足 n_ep^min 等约束。检测到的片段候选需通过LLM投票(至少 v_ep 票,置信度 >= θ_ep 才能被保留。
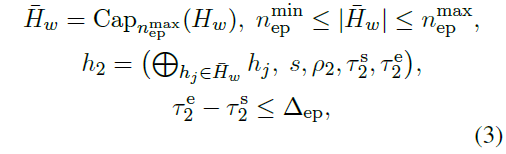
主题层级:长度为 Δ_th、步长为 δ_th 的窗口使用 HDBSCAN(DBSCAN为后备)对片段摘要嵌入进行聚类,生成候选主题。主题构建需满足股票数量、行业数量和规模等约束。
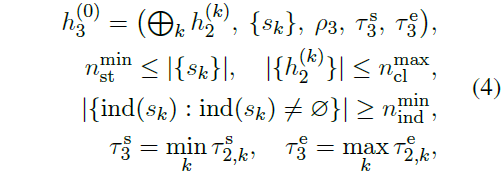
时间戳过滤检索:EEH 为催化剂 c 检索一个包含焦点、并发事实、先验日证据、同股票片段和包含该股票的主题的证据包。所有检索到的片段和主题记录的时间戳都必须早于 T。
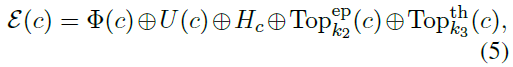
命题1:EEH 可以通过在明确时间约束下的时间戳门控多层级证据检索来改进预测。
基于案例的技能记忆(CSM)
CSM 将每个结果揭示的技能存储为带来源标签的向量记忆 σ = (n, ψ,D, a, Tσ, s, t, p, e,A),包含名称、IF-THEN规则、领域、EMA优势、标签、稳定性、解决时间、来源、嵌入和完整祖先信息。
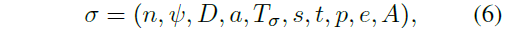
生命周期:当催化剂 c 解决后,LLM 提取新技能 σ_new。对于非空领域,找到最相似的技能 σ^*,如果余弦相似度 >= τ,则执行自动合并(EVOKE),更新优势、合并标签、来源等。否则,直接插入新技能。REVISE 和MERGE操作定义了显式的更新和合并规则。
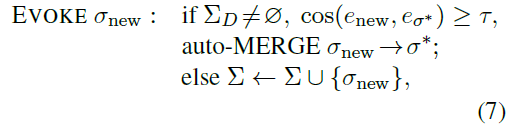
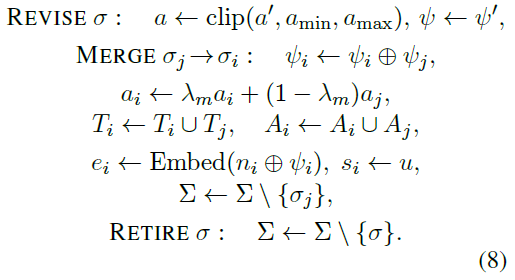
稳定性诊断:从训练催化剂中随机抽样,通过计算技能的应用、误用和跳过次数,评估其稳定性(STABLE, UNSTABLE, MISS, UNEVALUABLE)。MISS 技能会被淘汰。
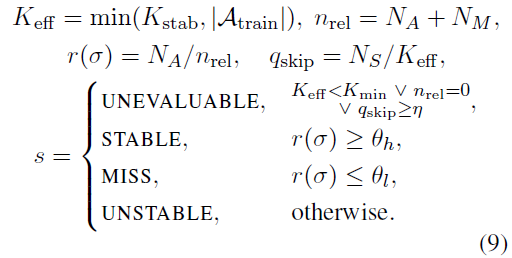
检索与可选的多路径推理(SCMR):对于给定的催化剂,计算其与每个技能在嵌入和领域上的复合得分,并筛选出所有祖先解决时间早于 $T$ 的技能。SCMR 从检索到的技能中选择最多 m_max 个,为每个技能生成一条路径假设(包括谓词、证据类型和方向),然后独立验证,最后根据技能稳定性和路径支持度进行加权聚合。
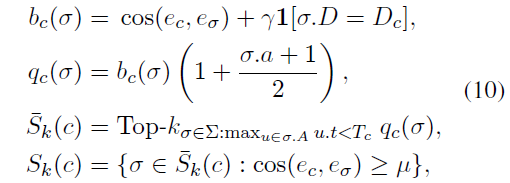
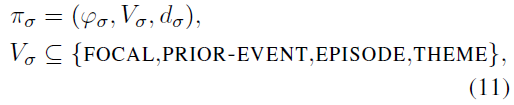
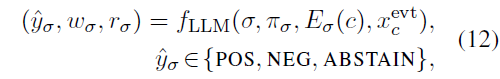
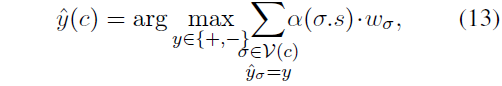
命题2:CSM 可以通过结果驱动的跨案例技能复用来改进预测。
异质证据-经验融合推理(HEFR)
HEFR 将多个证据和技能流打包成一个统一的上下文 C(c),包括焦点、同日并发、同股票片段、跨股票主题、先验日证据以及检索到的技能。
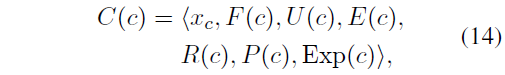
字符分配:在给定的预算 B_char 下,按照优先级顺序 A 和归一化份额 ω 为每个流分配字符预算,并进行截断。同日并发流 U(c) 不占用此预算。
联合推理:模板 Π 将截断后的上下文 C(c) 放入命名段中,进行单次联合LLM调用,得到预测方向 y^(c) 和理由 r(c)。如果 SCMR 成功,则替换此调用。
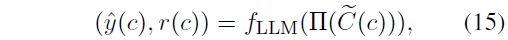
命题3:HEFR 可以通过预算感知的单次调用异质流融合来改进预测。
实验
实验设置
数据集:Astock, FinPURE, CMIN-US, EDT, CSMD。
基线:包括直接提示(LLM Zero-shot, CoT)、记忆增强智能体(MemGPT, Mem0, A-MEM)和检索增强生成(Vanilla RAG, HippoRAG, GraphRAG, LightRAG, HyperGraphRAG)。
评估指标:准确率(Acc)、马修斯相关系数(MCC)、宏F1分数、MemBase、$\Delta_{\text{content}}$、跨数据集平均和最差准确率、鲁棒性比率、平均最终预测令牌数、Acc/ln(Tokens) 和边际增益。
实现细节:在 DeepSeek-V4-Flash 和 GPT-5.4-mini 两个LLM后端上评估。
主要结果(RQ1)
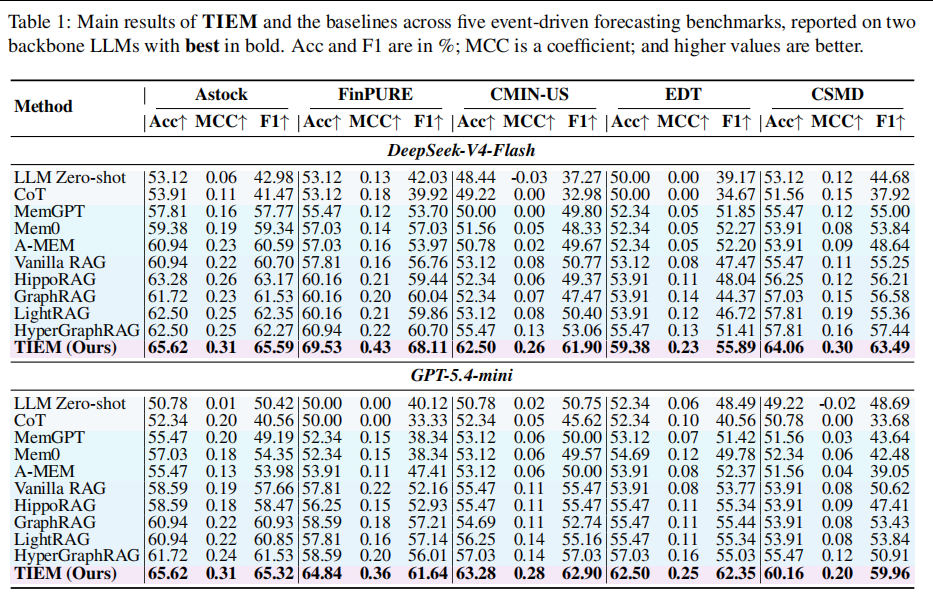
跨后端领先:TIEM在两个后端上均取得了最强的平均性能。
跨基准领先:TIEM在五个基准的每个指标上均领先,证明了时间戳证据和可迁移技能在不同市场和时期上的有效性。
类别平衡改进:TIEM在MCC和宏F1上同时提升,证明其预测质量在正负类别上更加平衡。
名称-日期敏感性探针(RQ2)
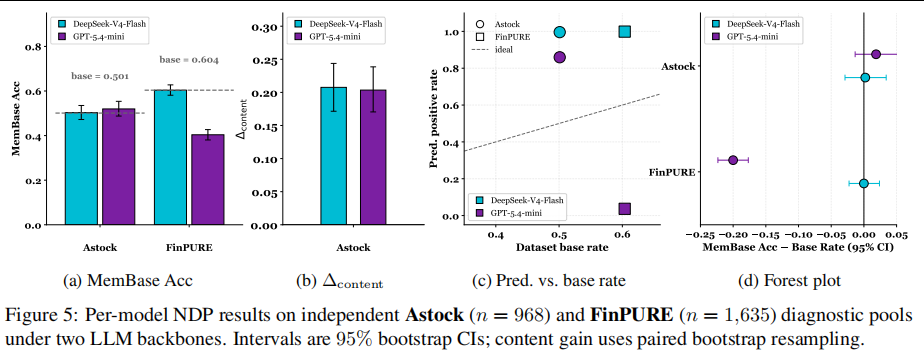
名称-日期抵抗性:MemBase在两个数据集上均未超过基准率,表明名称和日期本身不提供可靠的预测优势。
事件内容贡献:在Astock上,焦点事件文本为两个后端提供了正增益。
内容驱动预测:弱的名称-日期性能与正的内容增益形成对比,表明事件语义提供了超越名称-日期线索的判别信息。
跨数据集转移性能(RQ3)
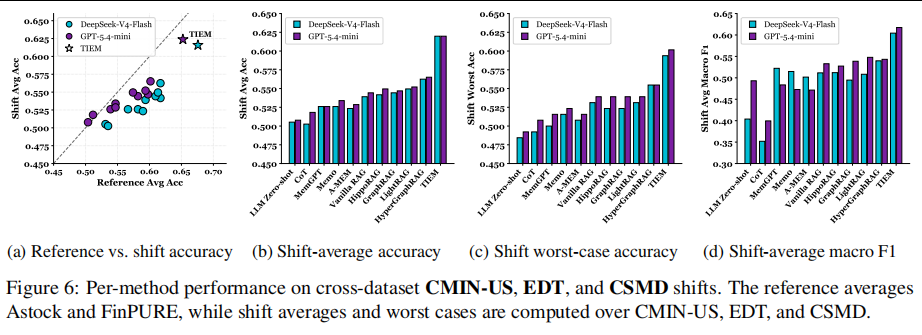
领先的转移性能:TIEM在两个后端上跨市场和跨时间转移的平均准确率均排名第一。
最差情况强度:TIEM在三个转移基准中每个方法的最低准确率上领先,表明其优势不是集中在单一结果上。
类别平衡转移:TIEM在转移平均宏F1上也领先,表明其时间戳证据和可迁移技能在跨市场-时间转移中保持了类别平衡的预测。
消融研究(RQ4)
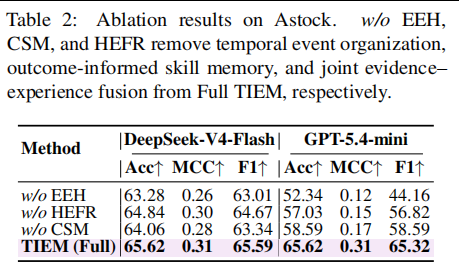
EEH贡献:相比去除EEH,完整TIEM在Astock上,对DeepSeek-V4-Flash,准确率从63.28%提升至65.62%,MCC从0.26提升至0.31;对GPT-5.4-mini,准确率从52.34%提升至65.62%,MCC从0.12提升至0.31。时间组织化的事件证据有助于识别催化剂效应。
CSM贡献:相比去除CSM,完整TIEM在Astock上,对DeepSeek-V4-Flash,准确率从64.06%提升至65.62%,MCC从0.28提升至0.31;对GPT-5.4-mini,准确率从58.59%提升至65.62%,MCC从0.17提升至0.31。结果驱动的技能将当前催化剂与已解决案例的可重用经验联系起来。
HEFR贡献:相比去除HEFR,完整TIEM在Astock上,对DeepSeek-V4-Flash,准确率从64.84%提升至65.62%,MCC从0.30提升至0.31;对GPT-5.4-mini,准确率从57.03%提升至65.62%,MCC从0.15提升至0.31。联合证据-经验融合提高了方向准确性和类别平衡预测。
准确率-令牌权衡(RQ5)
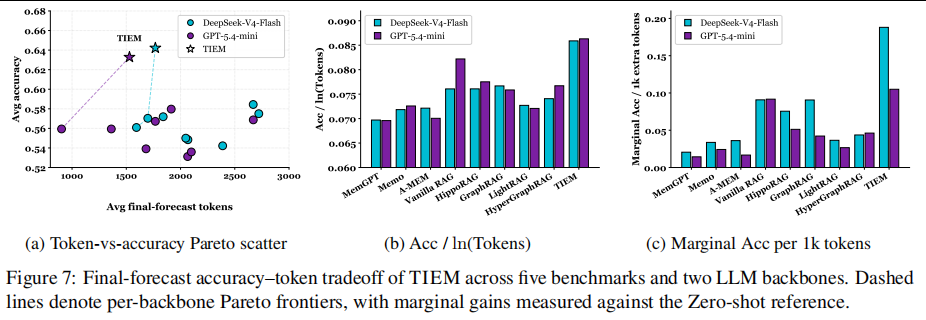
帕累托位置:TIEM位于两个帕累托前沿上,具有最高的平均准确率。
对数调整权衡:TIEM在两个后端上的Acc/ln(Tokens)值均领先(DeepSeek-V4-Flash为0.086,GPT-5.4-mini为0.087)。
边际令牌权衡:相对于Zero-shot,TIEM在两个后端上每增加1k令牌带来的准确率提升最大(DeepSeek-V4-Flash为0.18,GPT-5.4-mini为0.11)。
跨后端一致性(RQ6)
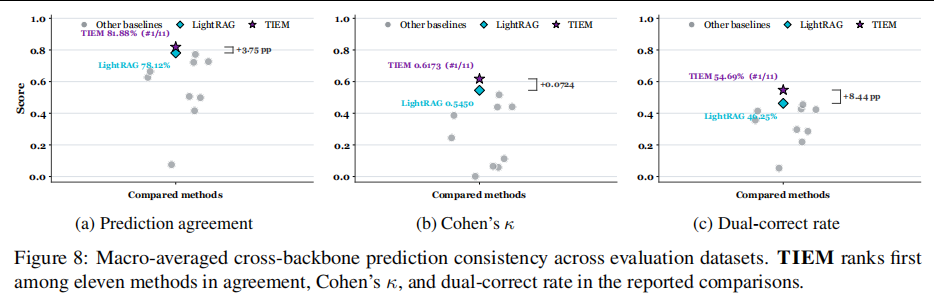
跨后端一致性:TIEM在跨后端一致性、Cohen's κ 和双正确率三个宏观平均指标上均领先。
超出边际的一致性:其在一致性和Cohen's κ 上的联合领先表明其一致性超越了边际预测频率。
联合正确性:其领先的双正确率将一致性与正确结果联系起来,表明其预测质量高。
总结
本文提出TIEM,用于时间戳门控的事件驱动催化剂-结果预测。它统一了时间戳过滤的事件-证据检索、结果驱动的基于案例的技能记忆和异质证据-经验融合。此外,还引入了CIP、FinPURE和名称-日期探针用于污染检查。实验结果表明了其基准性能提升、跨后端一致性以及有利的准确率-令牌权衡。希望TIEM能为时间约束下的事件驱动金融预测提供新的视角。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
