Nature Machine Intelligence|迈向真正的虚拟细胞,破解未知药物单细胞响应预测难题的新框架
8 月 26 日,上海交通大学人工智能学院在《Nature Machine Intelligence》发表最新成果 --《A Knowledge-driven Framework for Predicting Single-cell Responses for Unprofiled Drugs》。论文提出了一种名为 MAP 的知识驱动框架,通过构建大规模生物医学知识图谱(MAP-KG),首次赋予了单细胞基础模型在「零样本(Zero-shot)」条件下预测全新、未表征药物扰动响应的能力,为虚拟筛药打通了关键的技术闭环。张娅教授和谢伟迪副教授为论文通讯作者。
论文链接:https://www.nature.com/articles/s42256-026-01286-w
研究背景:为什么「未知药物预测」才是虚拟细胞的核心?
随着单细胞测序与大规模扰动实验(如 Perturb-seq)的飞速发展,研究者逐渐能够在细胞层面系统性地刻画药物作用引发的转录组变化。这催生了一个激动人心的愿景:构建「虚拟细胞」(Virtual Cell)。理想的虚拟细胞能够在计算机中模拟给定细胞状态在特定药物干预下的全转录组响应,从而彻底改变传统的药物研发流程。 然而,当前虚拟细胞的发展卡在了一个致命的瓶颈上:巨大的化学空间与有限的实验数据之间的鸿沟。
人类已知的化学分子空间极其庞大(估计可达 10^60 种),而即使是最先进的高通量筛选实验,能覆盖的化合物也仅仅是沧海一粟(通常在千百量级)。现有的单细胞扰动预测模型虽然在已观测数据上取得了一定进展,但它们普遍将药物视为「离散的类别 ID」。这意味着,模型的预测能力严重依赖于训练数据中该药物的共现频率。
这就引出了一个核心矛盾:如果我们只能预测那些已经做过昂贵湿实验的「已知药物」,虚拟细胞的意义何在?药物研发的本质是「寻新」,真正的虚拟细胞必须能够对完全没有实验表征数据的「未知药物(Unprofiled Drugs)」进行准确的响应预测。
为了跨越这一鸿沟,MAP 框架摒弃了传统的「ID 驱动」范式,转而采用「机制驱动」。它敏锐地指出:虽然新药的扰动数据是未知的,但构成新药的分子结构、潜在靶点以及相关的生物学先验知识是可获取的。MAP 首次系统性地将这些多源生物学知识整合,让模型学会「举一反三」,真正具备了面向未知药物的零样本泛化能力。
技术突破:MAP 如何打破认知壁垒
为了解决上述挑战,MAP 围绕「机制建模与零样本泛化」做出了以下三大突破性贡献:
构建大规模机制导向的生物医学知识图谱(MAP-KG):整合了 14 个公开数据库,统一了 18.7 万种药物、2.2 万个基因以及近 69.4 万条机制关系。更重要的是,它融合了分子结构(SMILES)、蛋白序列和文本描述(如 MOA)等多模态信息,形成了面向扰动建模的知识底座。
提出知识驱动的多模态对齐预训练:通过对比学习,将结构、序列与文本信息映射到统一的嵌入空间,并在表示中显式编码「药物 — 基因」的机制关系,从而学习到极具迁移性的机制感知表示。
设计基于知识条件的单细胞扰动预测模型:将知识增强的药物与基因表示作为条件,引入到单细胞基础模型中。实现了从「细胞状态 + 药物 ID」到「细胞状态 + 药物机制知识」的范式跃迁,成功解锁了对未表征药物的预测能力。
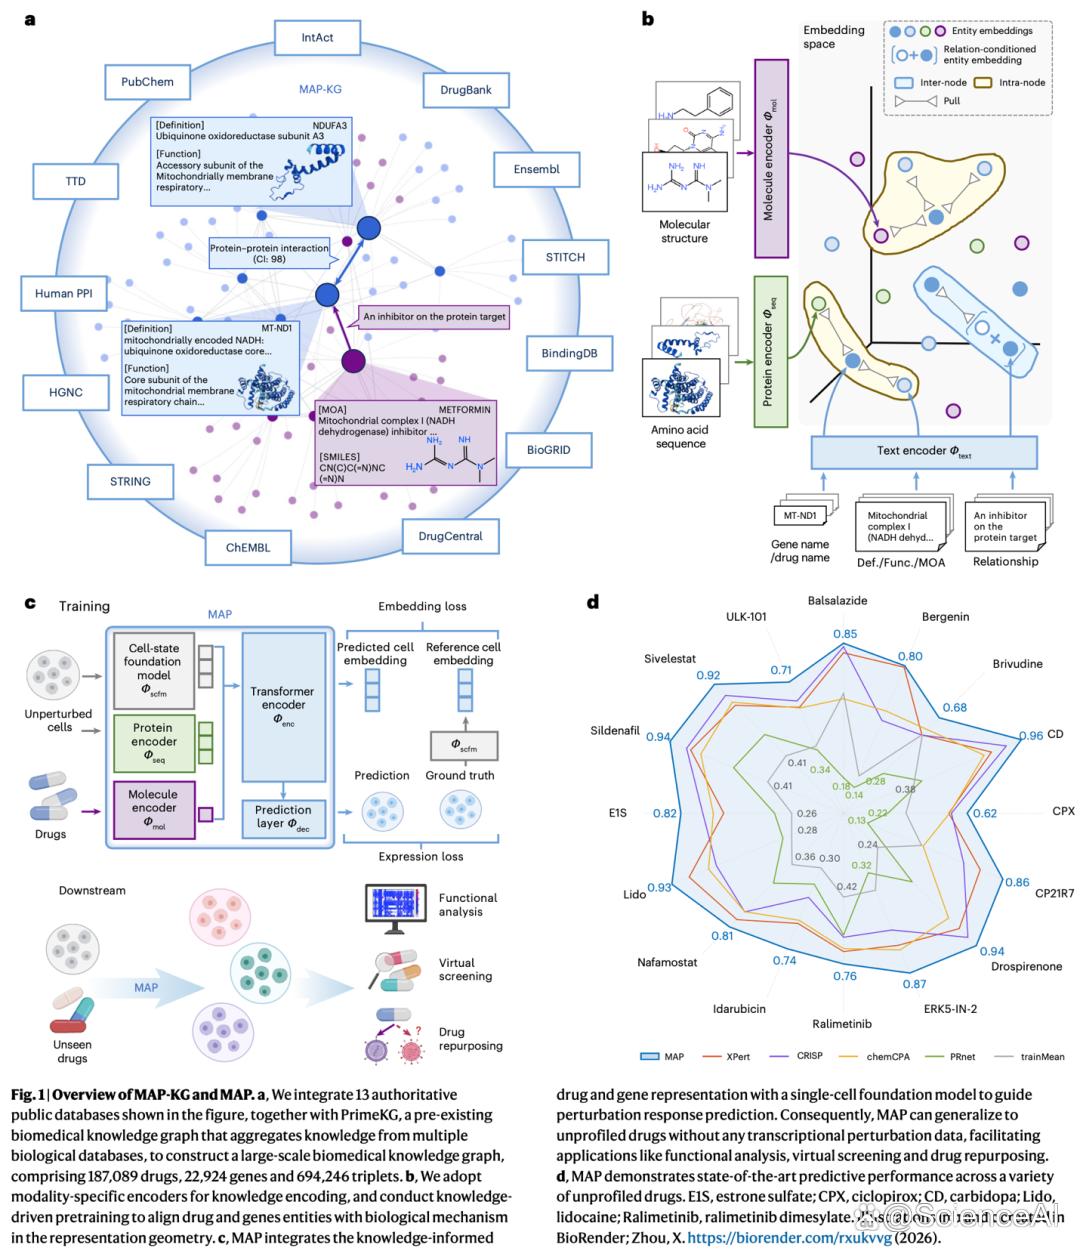
图 1:MAP-KG 的构建,知识编码预训练方法,主要扰动模型架构,以及核心实验结果。
方法解析:让知识在多模态空间中「对齐」
MAP 的核心在于如何将多源生物医学知识系统性地「喂」给单细胞模型。
在图谱构建阶段,MAP-KG 中的实体(药物和基因)不仅有拓扑关系(如「药物抑制某靶点」),还绑定了丰富的多模态属性。文本信息(如作用机制描述)在这里起到了「语义桥梁」的作用,打通了化学结构与生物序列之间的语义鸿沟。
在预训练阶段,作者为不同模态设计了专门的编码器,并通过对比学习(Contrastive Learning)将它们对齐。例如,模型会「拉近」同一个药物的分子结构与其机制文本的距离,「推远」无关实体。同时,引入关系层面的约束,使得图谱中的机制关系在几何空间中得到保留。经过这一步,即使是一个全新的化合物,只要输入其分子结构,模型就能在嵌入空间中找到其对应的机制定位。
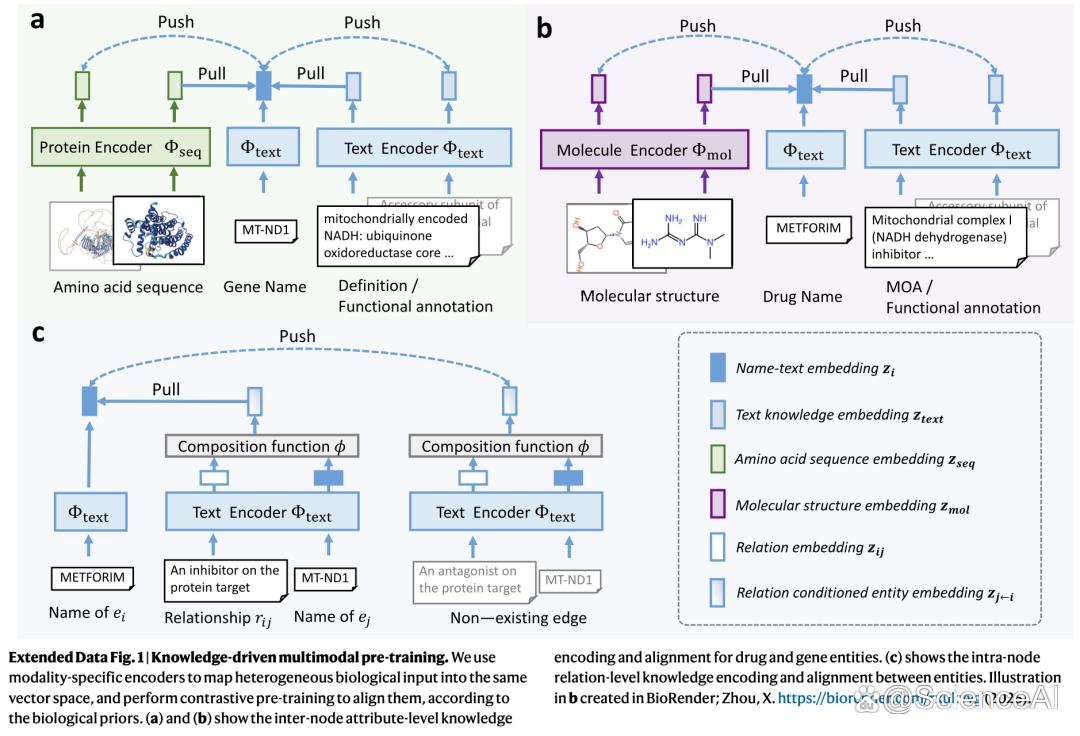
图 2:多模态知识编码对齐预训练
在扰动预测阶段,MAP 建立在一个单细胞基础模型(Single-cell Foundation Model)之上。它以未受扰动的细胞状态(Control State)为输入,将预训练好的「机制感知」药物与基因表示作为条件信息注入。通过多层双向注意力 Transformer 编码器,模型最终解码出扰动后的基因表达向量。
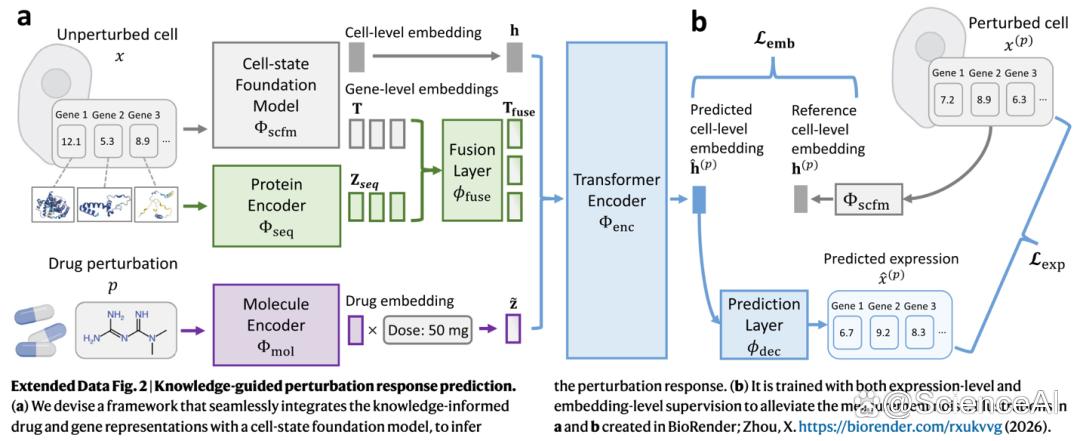
图 3:知识驱动的扰动预测模型
实验结果:零样本场景下的全面超越
为了验证 MAP 是否真正具备了虚拟细胞所需的泛化能力,研究团队在 Tahoe-100M、SciPlex3 和 OP3 等大规模数据集上,设计了两种极为严苛的零样本评测任务。
挑战一:未见细胞类型 - 药物组合(Unseen Cell Type–Drug Combinations)
这类似于药物重定位(Drug Repurposing)。模型在训练时见过某药物在 A 细胞系的作用,需要预测其在 B 细胞系的作用。在 Tahoe-100M 数据集上,MAP 在关键指标(如 Top-50 DEG Pearson delta correlation)上相较于最强基线(CRISP)提升了约 13.3%,不仅更准确地预测了表达变化幅度,还更好地恢复了基因调控方向。
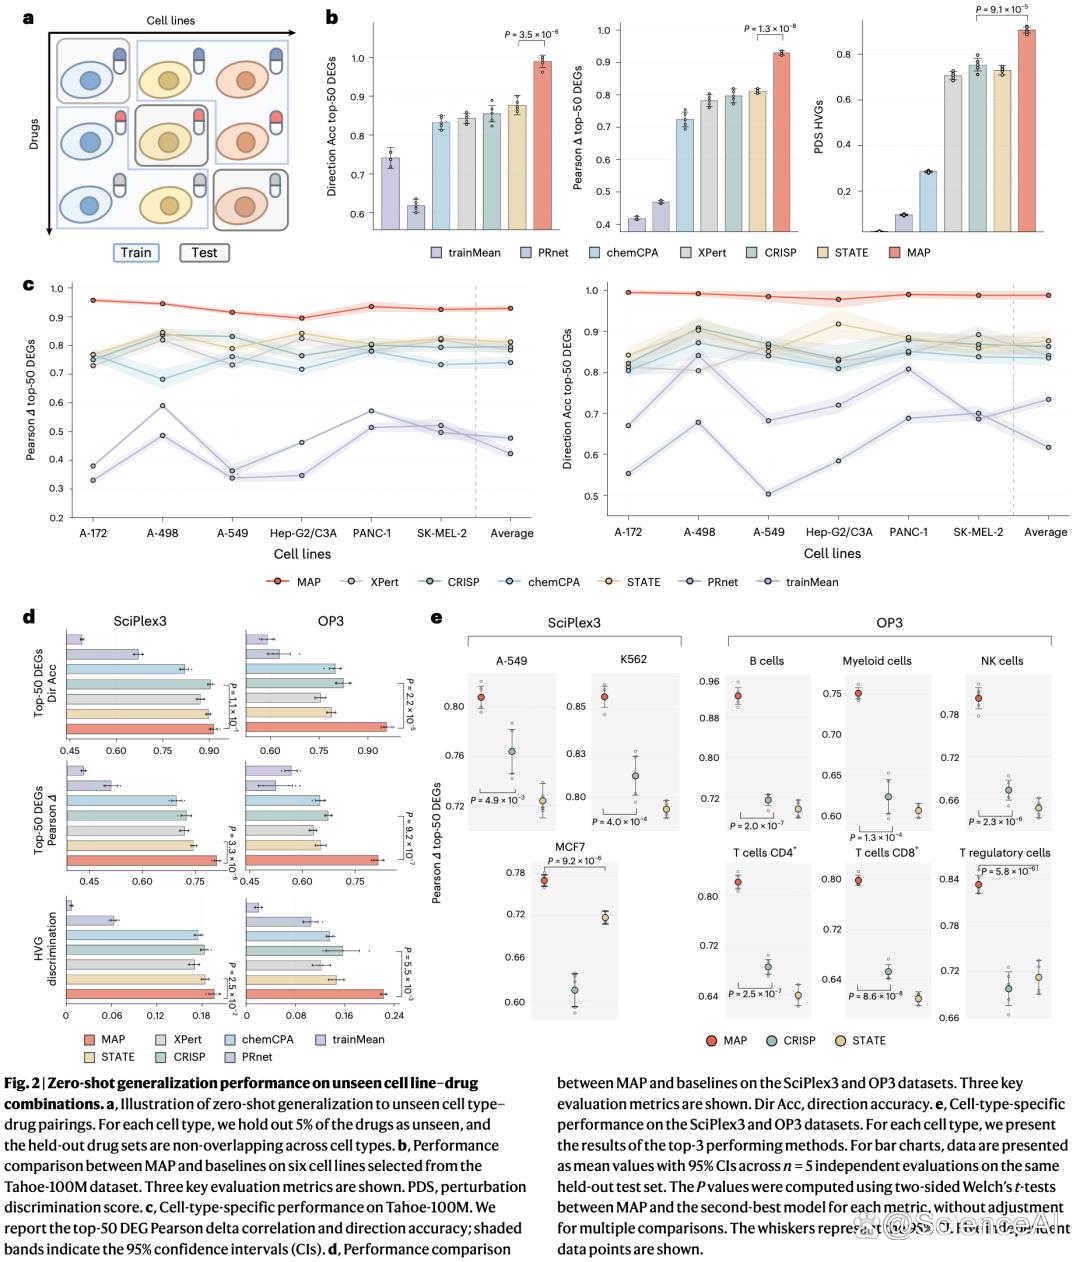
图 4:未见细胞类型 - 药物组合上的实验结果
挑战二:未表征药物的零样本预测(Unprofiled Drugs)—— 真正的「地狱难度」
在这个设置中,测试药物在训练阶段被完全移除(包括其在知识图谱中的相关节点信息)。模型只能依赖新药的分子结构进行「盲猜」。结果显示,MAP 在 Tahoe-100M 上的 Top-50 DEG 预测相关性依然提升了 12.2%,方向准确率提升了 21.0%。这证明 MAP 能够在完全缺乏转录组测量先验的情况下,精准推断药物效应。
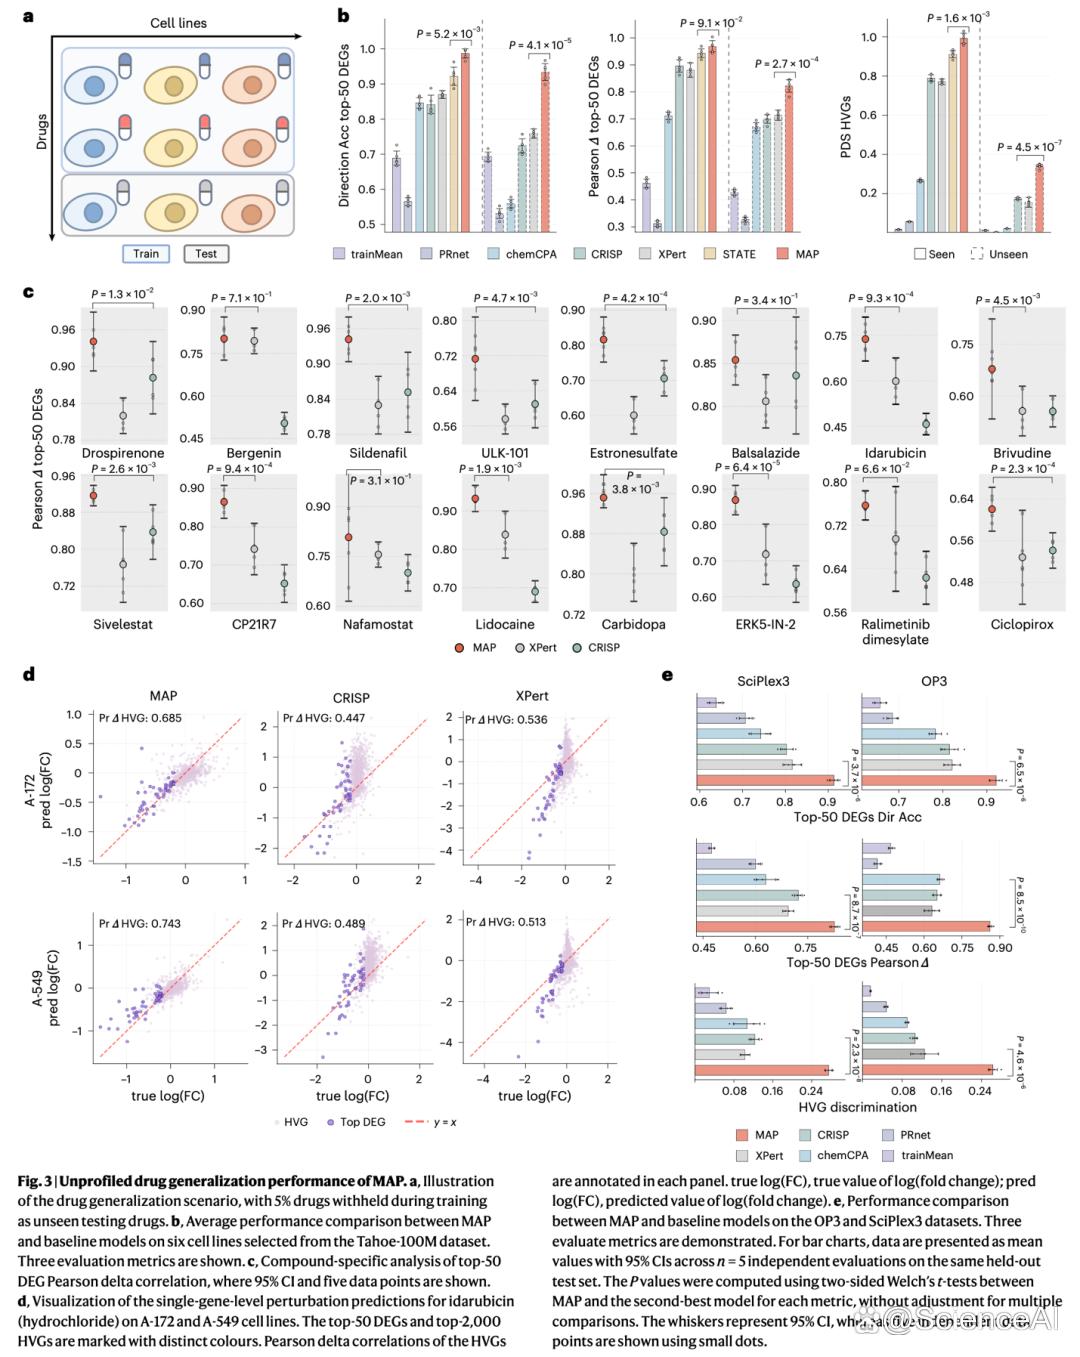
图 5:未见药物上的实验结果
场景测试:虚拟筛药与通路一致性 除了基因层面的定量指标,MAP 预测的表达变化在 GSEA 通路分析中展现出极强的生物学一致性。在针对 A549(非小细胞肺癌)的 58 个候选药物虚拟筛选实验中,MAP 成功在预测排名前 15 的榜单中,命中了 5 个已获批抗癌药物中的 4 个。这直接证明了 MAP 具备作为高通量虚拟筛药引擎的巨大潜力。
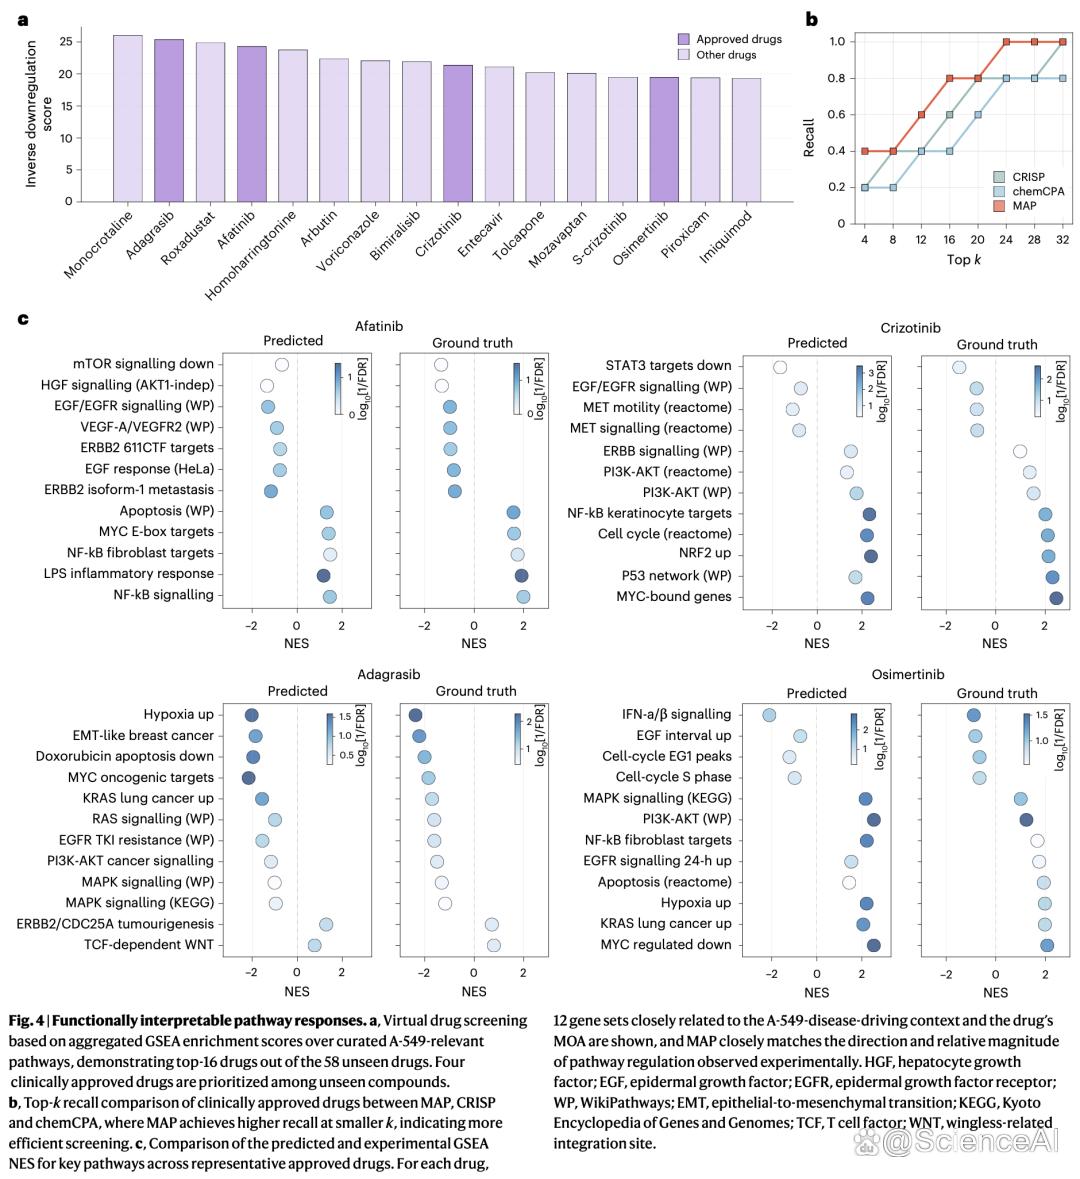
图 6:虚拟药物筛选,通路级别表达预测一致性分析
总结与展望:重塑计算生物学的建模范式
MAP 框架的提出,为构建真正的「虚拟细胞」补齐了最关键的一块拼图。它的核心价值不仅在于指标的提升,更在于指明了未来的发展方向:
突破实验数据依赖: 实现了真正的零样本预测,让计算机从「复读机」变成了能够探索广袤化学空间的「预言家」。
重塑建模范式: 从「ID 驱动」走向「机制驱动」,利用多模态对齐学习,将药物嵌入到具有生物学意义的机制空间中。
验证「知识规模(Knowledge Scaling)」定律: 实验证明,随着注入知识图谱规模与质量的提升,模型性能持续增长。除了「数据规模」和「模型参数」,知识的广度与深度成为了提升虚拟细胞能力的第三大核心维度。MAP 让我们看到,由数据与知识双轮驱动的「虚拟细胞」,正一步步从概念走向现实。