Claude加速蛋白设计与化学分析,让AI连接文献、计算、设计与实验
编辑丨&
过去几年,AI 已经学会了不少关于蛋白质的事情。它可以预测蛋白质结构,可以根据结构生成候选序列,也可以判断某些突变是否可能改变蛋白功能。但真正的蛋白质工程远比生成一条序列复杂。
一个研究人员拿到一个新的药物靶点后,首先需要理解已有文献,判断靶点上哪些区域值得设计;然后选择合适的结构预测、蛋白生成和筛选工具;得到候选之后,还要反复检查结构是否合理、结合界面是否满足要求,再修改设计。
任何一个环节出现问题,都可能让整个流程重新开始。因此,蛋白设计真正昂贵的地方,不只是计算量,也在于被分散在一个又一个工具和实验步骤中的大量专业判断。
Anthropic 这次展示的结果结合了 Mythos 和 Opus 模型。他们决定让 Claude 尝试自己完成一部分真正的蛋白质设计工作。
蛋白质设计
Minibinder,一种小型蛋白质,旨在牢固地与目标蛋白结合。这类结合是很多现代药物发挥作用的基础:药物需要附着在目标蛋白上,才能对它进行抑制、激活或递送。
过去,一个新的 binder 从计算设计、优化到筛选,往往需要蛋白质工程师针对每个靶点投入数月时间。近年来的机器学习模型已经大幅加快了其中一些步骤,但不同模型之间仍然需要计算专家花费数天甚至数周进行编排,而最终的实验验证本身也可能需要数周。
在针对 15 个靶点的多臂蛋白质设计活动中,首次湿实验数据表明 Claude 成功设计出了针对其中 14 个靶点的 binder。
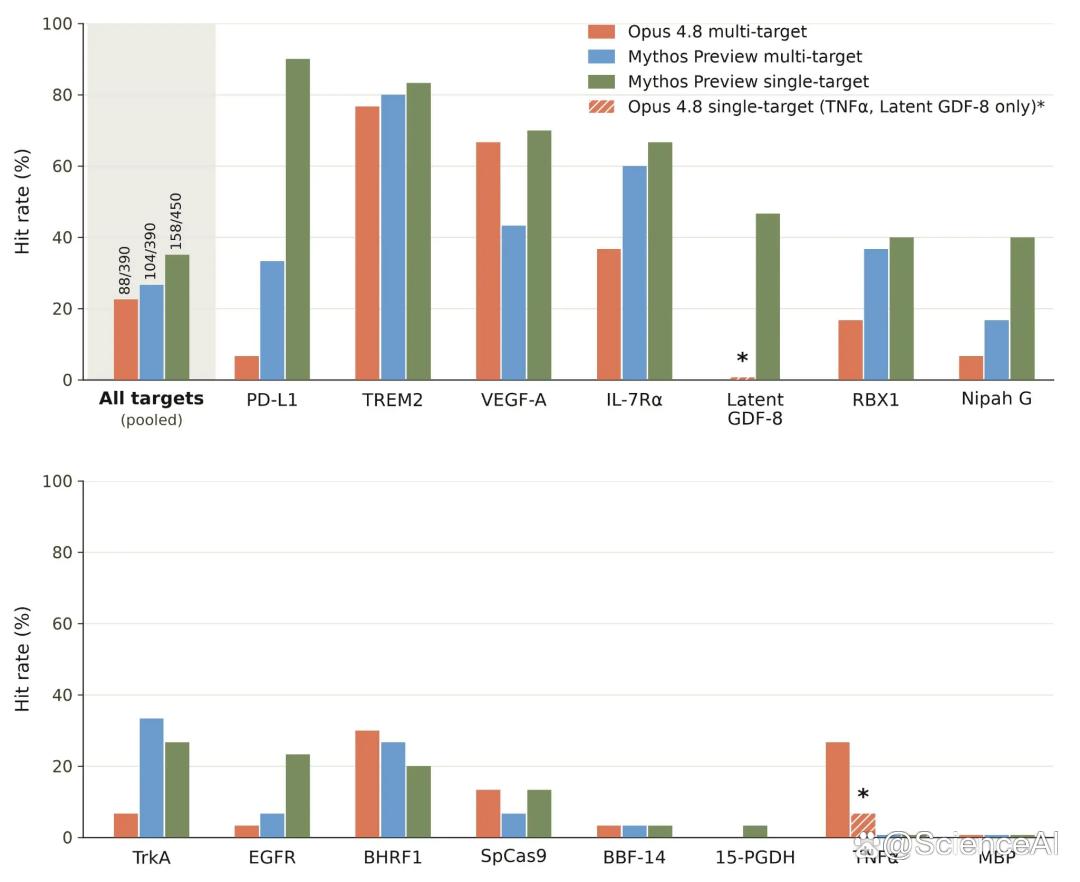
图 1:Mythos Preview 和 Opus 4.8 在 15 个目标中命中率超过 20%,目标级命中率从 90% 到 0 不等。
同时面对全部目标的 48 小时任务中,Mythos Preview 和 Opus 4.8 的整体命中率分别为 26.7% 和 22.6%,而 Anthropic 给出的当今蛋白质设计活动典型水平是 10%–15%。当 Claude 一次只专注一个目标时,Mythos Preview 的整体命中率进一步达到 35.1%。
Anthropic 团队预计,如若经过蛋白专家指导与结果反馈,这种方法将会带来更具成效的结果。
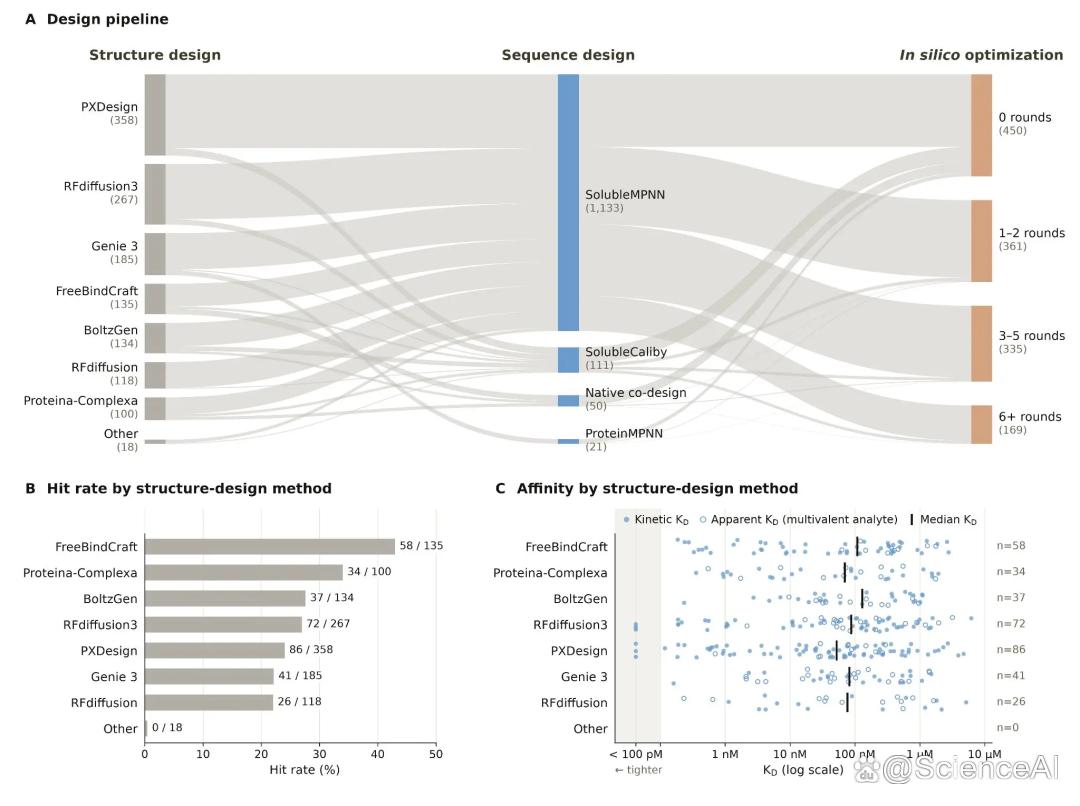
图 2:Claude 成功协调多种开源蛋白质设计模型,生成高成功率和高亲和力的结合剂。
靶标上的表现
在这些靶标中,不妨来关注一种驱动特定调控蛋白靶向破坏的小蛋白——RBX1。
此前,Adaptyv Bio 曾围绕 RBX1 举办过公开蛋白设计竞赛。当时全球参赛者提交了 245 个设计,最终只有 9 个被实验确认能够结合,整体命中率约为 3.7%。
这一次,Claude 针对同一个目标生成了 90 个设计。其中 28 个被验证为成功 binder,命中率达到约 31%,其中排名最高的设计,结合能力还超过了此前竞赛中的最佳公开结果。Anthropic 给出的比较显示,这个设计的结合亲和力约为当时竞赛冠军的 10 倍。
另一个案例则更加接近药物研发中的实际难题。TNFα 是经典的治疗靶点之一,也是多种抗炎药物作用的对象。
它的结构使得从头设计结合蛋白并不容易。在这项实验中,Mythos Preview 没有在 TNFα 上取得成功,Opus 4.8 却找到了多个有效 binder。
最终,Opus 4.8 获得了 12 个经过实验确认的设计。其中部分设计还表现出了非常有意思的跨物种结合能力:它们能够同时结合人、食蟹猴和小鼠的 TNFα。对于后续动物实验来说,这类跨物种结合蛋白具有实际价值,因为候选分子不需要在进入动物实验前再重新设计一个适配动物靶标的版本。
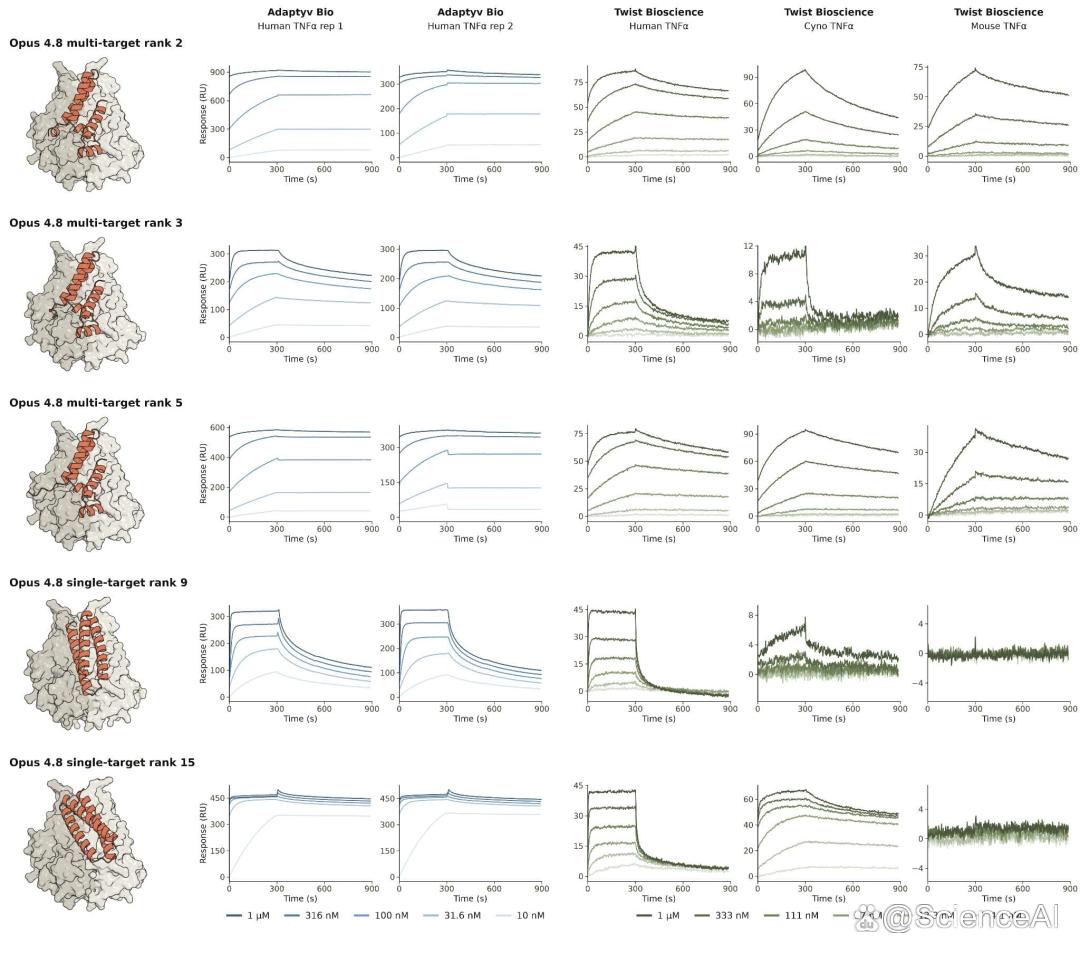
图 3:Opus 4.8 成功设计了针对 TNFα 的新生结合剂,其中一些结合于人类、犬类猴和小鼠 TNFα。
但实验同样留下了失败案例。例如在 MBP 目标上,Claude 测试了 90 个设计,最终没有一个被正式确认具有结合能力。
这组失败结果反而说明,Claude 并没有得到一个对所有蛋白都有效的万能设计器。蛋白质设计依然受到靶标结构、结合界面以及搜索空间复杂程度的限制。
分析化学
Anthropic 没有停在蛋白设计这里。他们紧接着提出了另一个问题,如果 AI 已经能够自己完成蛋白设计,那么面对实验室产生的原始数据,它能不能自己完成分析?于是,第二项实验转向了分析化学。
这次使用的是 Claude Opus 5。研究人员为它提供了实验仪器产生的原始数据。任务只有两句话左右的说明。第一份数据来自 ¹H NMR(质子核磁共振),第二份来自 LC-MS(液相色谱—质谱)。
这两类实验在化学实验室中非常常见,却也相当依赖专业经验。研究人员需要从原始数据中识别峰、进行积分、判断分子量、估计纯度,并最终确认样品是否符合预期。而这一次,Claude 需要自己完成整个分析过程。
Claude 分别在 23 分钟和 19 分钟内并行返回了处理后的结果。
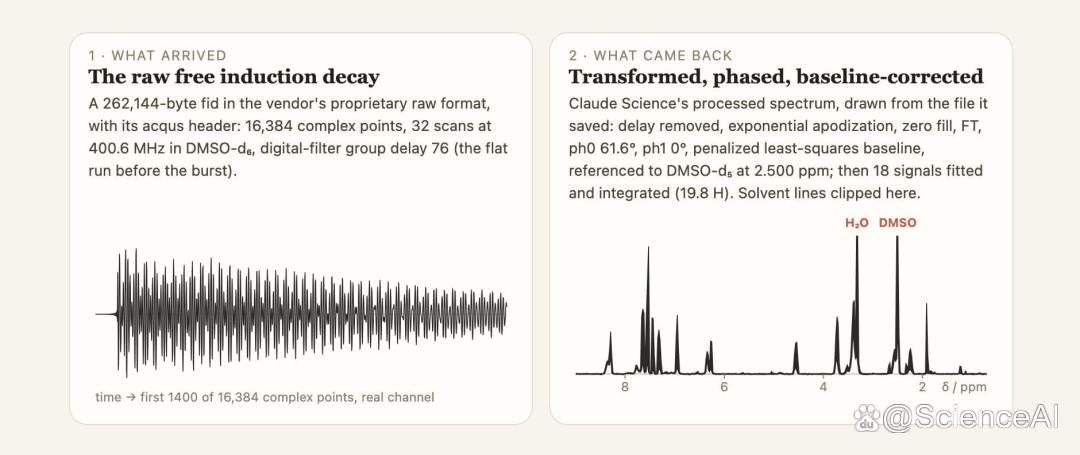
图 4:实验室发来的,以及 Claude 23 分钟后返回的图。
对于核磁共振,Claude 首先自己处理原始信号,把原始数据转换成可以解释的光谱图,再完成峰识别和积分。它给出的主要峰与实验室分析结果高度一致,并提出了可以加入重水替换氢气的标准检查方法。根据原始文件,Claude 量化了数据的变化,发现并纠正了第一次读数中的夸大。
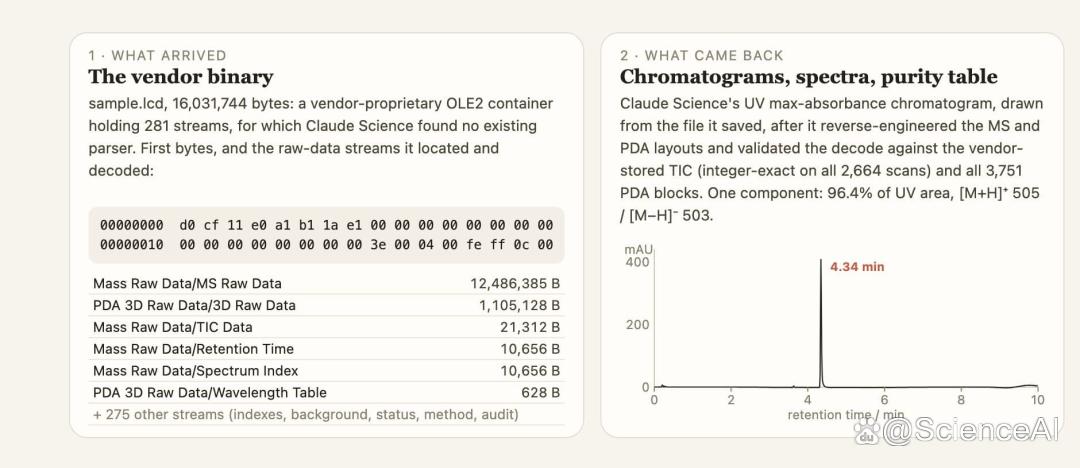
图 5:LC-MS 任务中 Claude 的读取与恢复。
对于 LC-MS,Claude 面对的是供应商专有格式保存的原始数据,而这种文件格式并没有公开完整的解析说明。它很快推断了数据编码方式,然后通过复现仪器自身记录的 2664 次扫描数据,确认文件正确读取,然后再进行分析。
小结
回过头看 Anthropic 设计的两组实验,会发现它们实际上分别覆盖了科研流程的两端。
第一组实验从一个生物学目标出发。Claude 需要自己决定如何设计蛋白、调用哪些模型、筛选哪些候选,最终把计算结果交给实验室。
第二组实验则从实验室产生的原始数据出发。Claude 需要自己解析仪器文件,完成数据处理,发现异常,提出后续验证,并给出最终分析结果。
这些工作本身都不算艰难,但一个科研项目往往正是由数百个这样的步骤连接起来的。AI 正替科学家承担这部分基础性的任务,并逐步扩展自己的能力覆盖范围。