ClinFusion:视觉为核的医疗多模态大模型,与临床对齐的评测新范式
多模态大模型要真正进入临床,本质上是一个「视觉为核」的问题,而这个问题有两个彼此耦合的缺口:架构上,模型要能原生吸收从 X 光、病理切片到 CT、MRI 的高度异构的视觉知识;评测上,判定标准要贴合放射科医师真实的读片方式,而不是停留在文本表层匹配。
为了补上这两个缺口,达摩院联合浙江大学、清华大学等提出 ClinFusion:一个视觉为核的组合式多模态大模型,加一套临床对齐、以事实性为导向的评测框架。
论文地址:https://arxiv.org/abs/2607.24743
代码仓库:https://github.com/alibaba-damo-academy/ClinFusion
模型权重(8B / 32B):https://huggingface.co/collections/Alibaba-DAMO-Academy/clinfusion
在线体验:https://huggingface.co/spaces/Alibaba-DAMO-Academy/clinfusion-medical-vlm
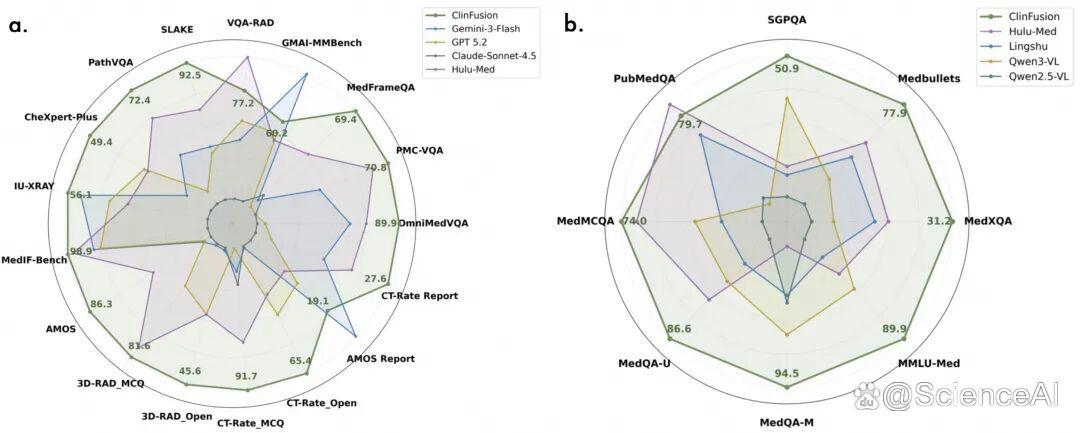
图 1 a,医疗多模态基准性能对比;b,医疗纯文本基准性能对比。
现有方案的局限性
挑战一:单一视觉编码器吸收不了异构的医学影像知识。医学影像的信息谱从病理最看重的高频纹理细节,一直跨到刻画器官解剖的全局结构语义,而主流医疗模型走的是数据驱动路线,底层视觉架构基本不动。已有两条架构路线各有代价:2D 为中心把体数据密集采样成切片,牺牲 3D 结构信息;3D 为中心配专用编码器,却需要庞杂昂贵的对齐流程。
挑战二:评测与临床流程错位。一是既有基准完全忽略指令跟随,而这项能力恰恰最容易在领域微调中被削弱。二是报告生成的评测方式存在根本性错位:现行做法让模型生成「全面」报告再与参考报告比对,但医师从不盲读 —— 申请单指征与既往病史决定了他关注哪些区域、报告如何组织。指标同样如此:BLEU、ROUGE 停在词汇/语义匹配,RadGraph-F1 依赖小模型抽实体、精度有限,GREEN 打一个笼统总分,没有一个能给出「命中/漏诊/幻觉」的精确分解。
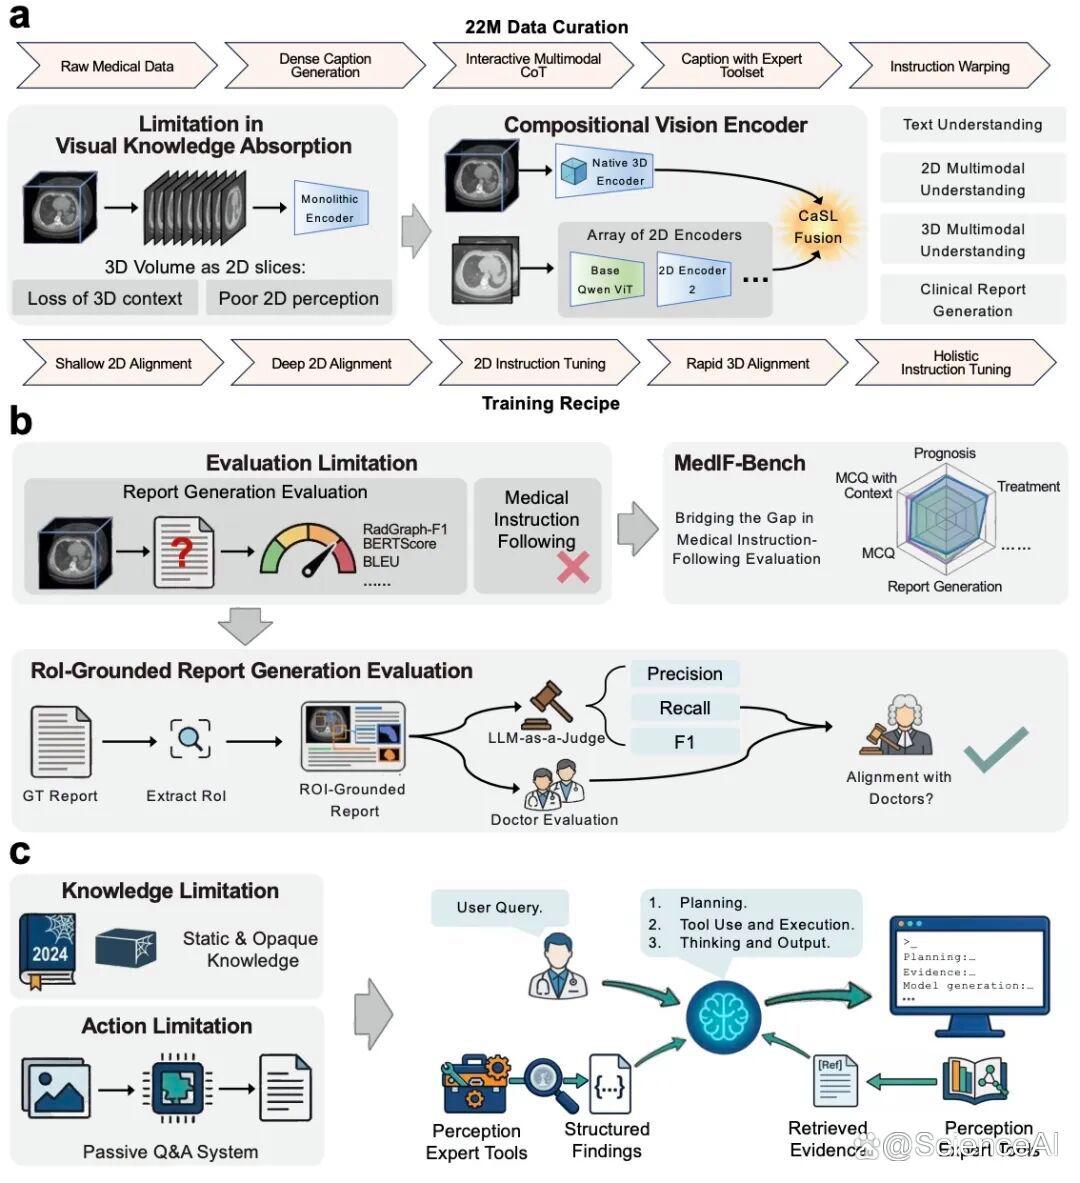
图 2 ClinFusion 贡献总览。a,组合式视觉编码器;b,视觉锚定评测框架;c,agentic 工具调用扩展。
ClinFusion:视觉为核的多模态大模型
组合式 2D 感知与 CaSL Fusion。该研究为 Qwen ViT 配上两个互补的专家编码器:ConvNeXt 提供强空间局部性偏置、擅长高频纹理,DINOv2 学到更鲁棒、更少数据集偏置的高层语义。CaSL Fusion 以 Qwen ViT 的每个 token 为 query,只在第二张特征图上同一空间位置的 k×k 局部邻域内取 key/value 做交叉注意力,再经残差与 FFN 融合回 query—— 不增加送入 LLM 的视觉 token 数,只提升每个 token 的信息密度,并把计算量从二次复杂度降为线性。算子非对称、左结合,多编码器时以级联方式逐级施加,保证已与 LLM 充分对齐的表征始终是主干,被专家编码器渐进增强而非替换。
2D 锚定的 3D 体数据理解。把 3D 体数据当作一串独立切片,会丢掉关键的切片间空间上下文与解剖连续性。ClinFusion 引入专用 3D 编码器 PE-3D(已通过体数据与放射报告的对比学习完成语言预对齐),并提出 2D 锚定的深度感知 CaSL Fusion:从体数据采样 4 张锚定切片,把每个锚定 token 的注意力范围从 k×k 空间邻域扩展为「k×k 邻域 × 完整深度维」。以 2D 特征已有的强语言对齐作锚点,3D 特征无需海量专用对齐数据即可快速收敛,且仍能复用 2D 编码器中丰富的预训练知识。
数据与训练。训练语料共 2220 万样本,并针对具体瓶颈自建四条数据合成链路:Instruction Warping(120 条种子指令扩为 21k 模板,防止领域微调侵蚀指令跟随)、61 万条视觉锚定密集描述、6.7 万条多模态 CoT 轨迹、130 万条 CT Caption。训练采用五阶段渐进课程,从浅层多编码器对齐到 2D/3D 整体指令微调。
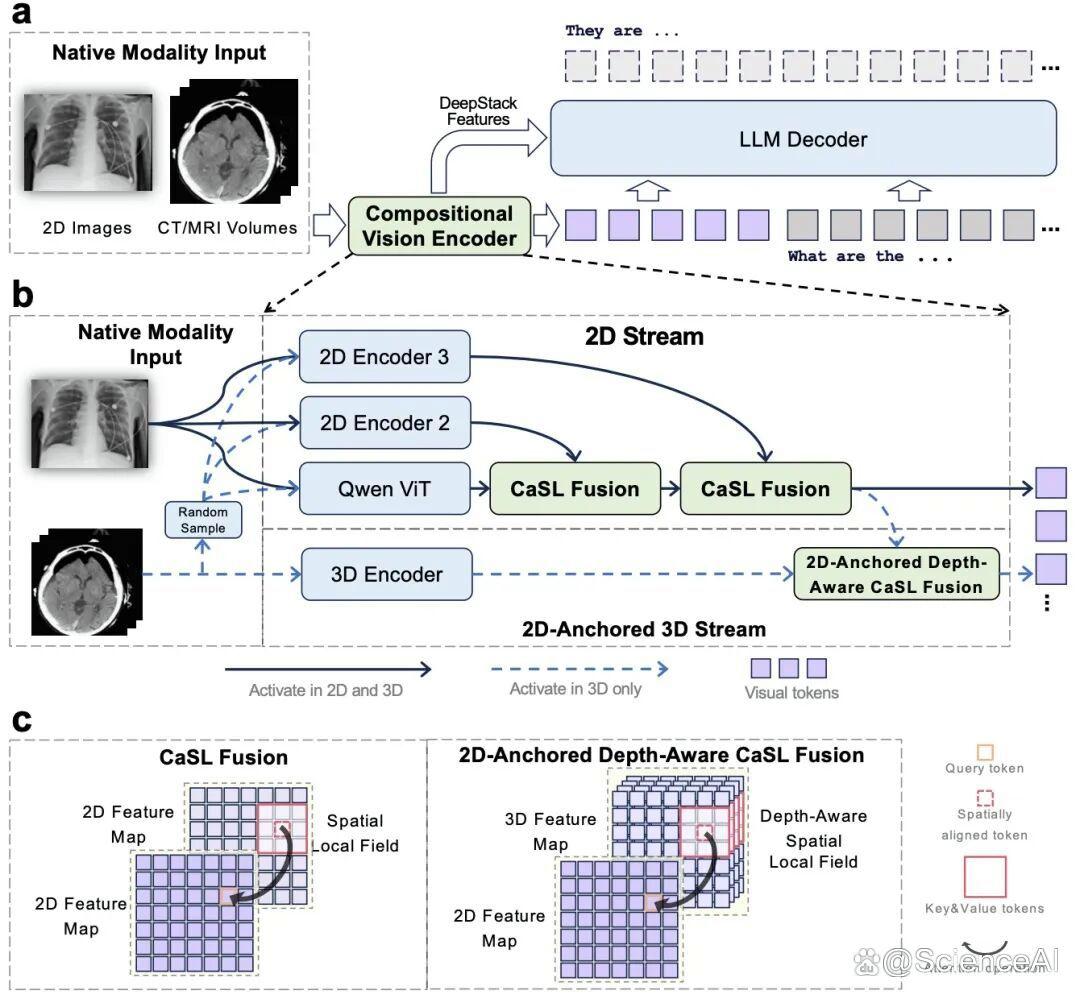
图 3 ClinFusion 架构。a,整体框架;b,组合式编码器与原生 3D 通路;c,CaSL Fusion 的局部交叉注意力。
临床对齐的医疗评测新范式
MedIF-Bench:把指令跟随变成可测量的前置条件。医疗微调常让模型即使医学知识正确也不遵守输出格式,而临床落地往往要求特定结构化输出(对接电子病历的 JSON、带标准段落标题的报告)。该基准含 900 个样本、七个任务类别,部分取自 SEER 癌症登记库的真实患者记录,只评测格式合规性、不评测医学准确性。
RoI-Grounded 报告生成评测。流程分三步:用 LLM 从参考报告中抽取「临床指征」与「关注解剖区域」注入待测模型(严格约束以确保绝不泄露任何具体异常)→ 模型据此生成聚焦的 RoI 锚定报告 → LLM 判官逐条比对论断,输出 [MATCHED]/[MISSED]/[HALLUCINATED] 三个显式列表,直接算出 Precision、Recall 与 F1。
实验结果与分析
对比对象包括通用多模态模型(Qwen2.5-VL/Qwen3-VL/InternVL3)、医疗多模态模型(Lingshu、Hulu-Med、MedGemma、HuatuoGPT-V)与闭源模型(GPT-5.2、Gemini-3-Flash、Claude-Sonnet-4.5),所有有官方权重的开源模型都在统一套件下重新跑分。
2D 与 3D 多模态基准:优势在 3D 上最为明显
2D 影像理解:ClinFusion 在全部八个 2D VQA 基准上稳定第一或第二,8B 在其中七个上取得所有医疗模型最高分,多数基准超越 Gemini-3-Flash;报告生成同样刷新 SOTA。
3D 体数据理解:优势在这里最大 ——8B 在腹部 CT 问答上比同量级最强开源模型高出 14.5 分,甚至超过参数量四倍于它的 32B 基线,领先 Gemini-3-Flash 约 16 分;32B 在 CT 报告生成上取得全部被评模型的最佳 F1。
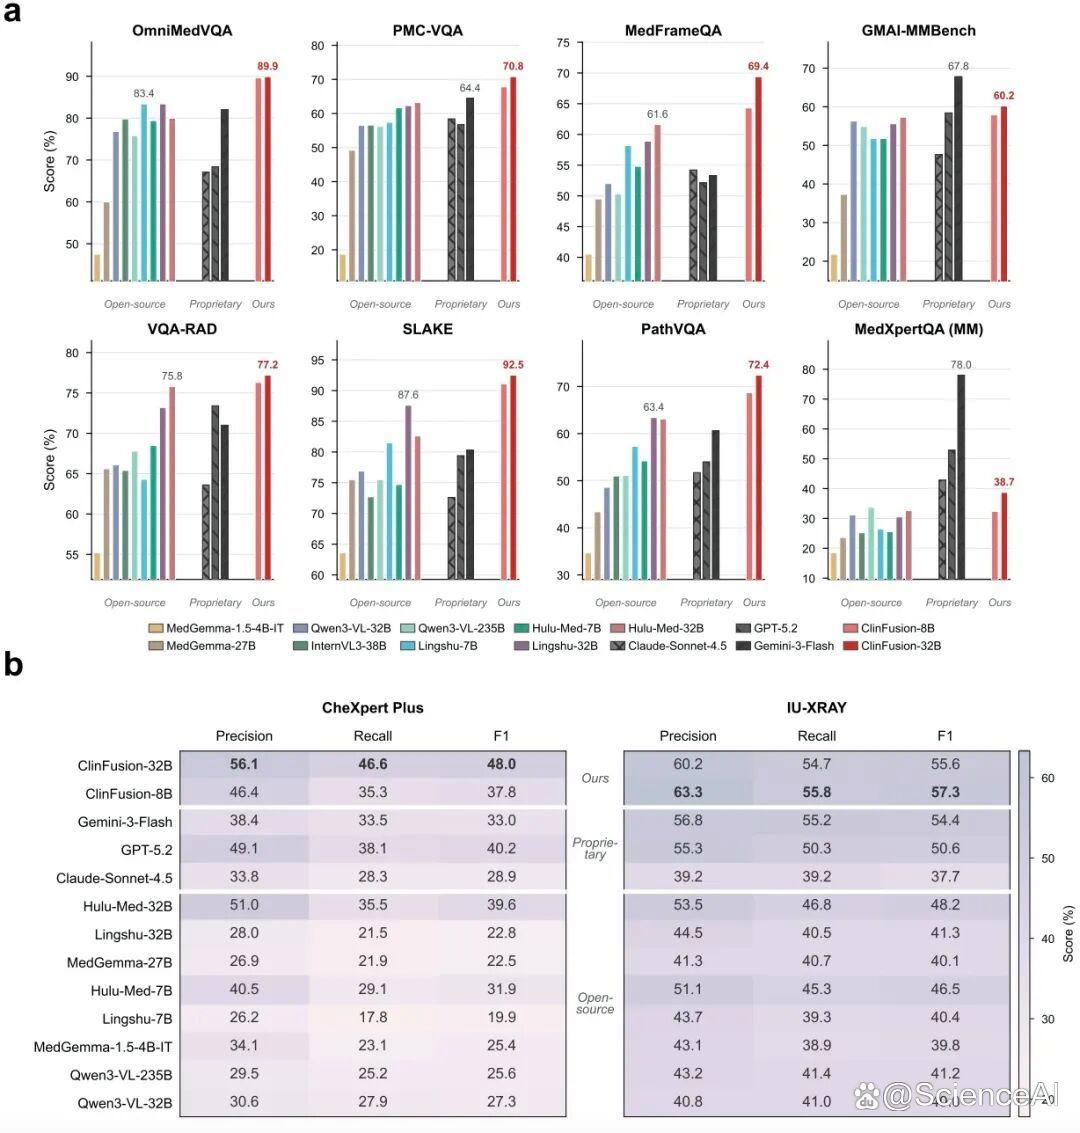
图 4 2D 多模态医学基准结果。a,八个 2D VQA;b,两个 2D 报告生成。
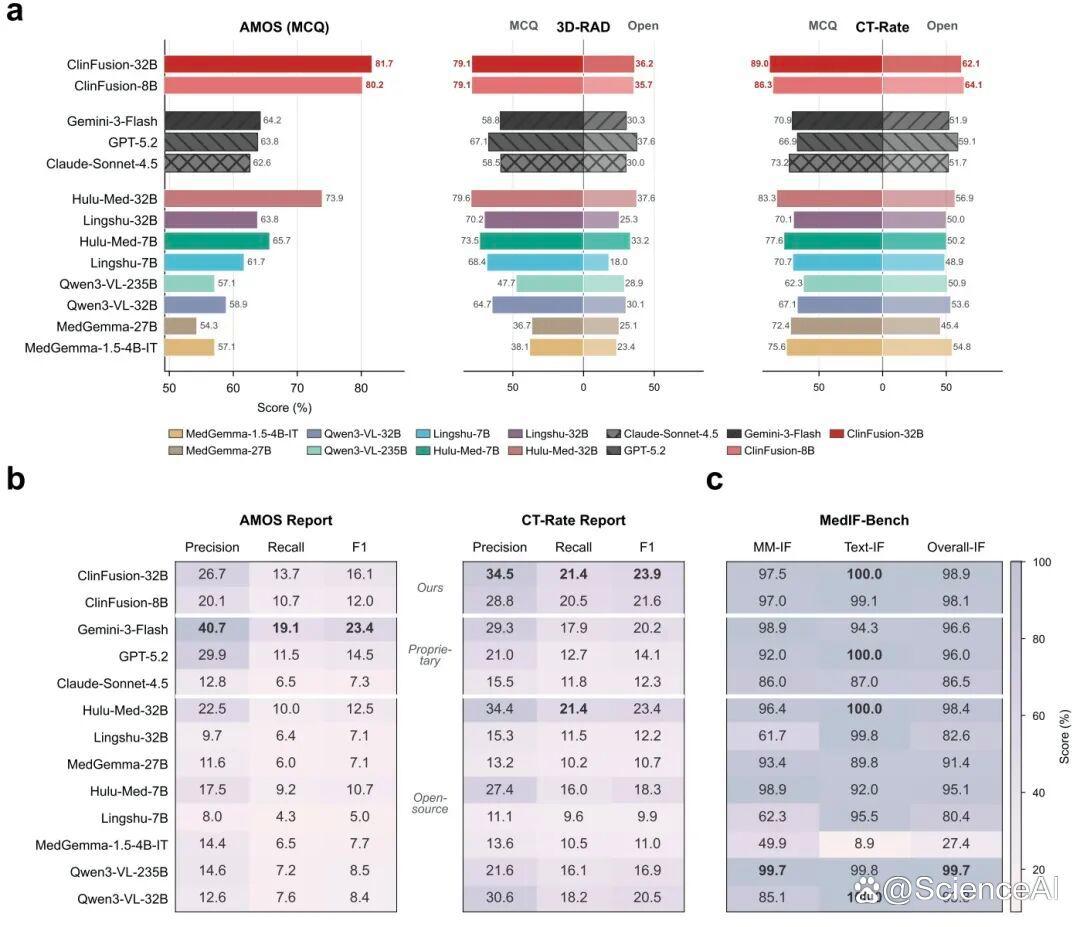
图 5 3D 多模态基准与 MedIF-Bench 结果。a,3D VQA;b,3D 报告生成;c,指令跟随得分。
指令跟随与纯文本:医疗适配没有付出代价
ClinFusion 的 Overall-IF 达 98.1(8B)/98.9(32B),为医疗多模态模型最佳,并超过全部闭源系统(GPT-5.2 96.0、Gemini-3-Flash 96.6、Claude-Sonnet-4.5 86.5)。关键对比在于:基于同一骨干的既有医疗适配版本会大幅退化(Lingshu-7B 80.4、Lingshu-32B 82.6),而 ClinFusion 保留了接近骨干水平的能力。纯文本方面,尽管架构是视觉为核,32B 仍在八个基准中的七个上取得所有医疗模型最佳,说明医疗适配增强而非削弱了文本知识。
更重要的洞察:指令跟随是可靠评测的前置条件。MedGemma-1.5-4B-IT 的 Overall-IF 仅 27.4,人工检查确认它持续无法按规定格式作答,使基于规则与基于 LLM 判官的评测都不再可靠 —— 直接表现为其他基准上人为偏低的分数(PMC-VQA 18.7、SuperGPQA 2.25)。该模型同样是在多样医疗数据上训练的,说明仅靠数据整理不足以保住这项能力。
专家盲评:同时验证模型与评测方法
该研究邀请 6 位持证放射科医师(临床经验均 ≥6 年)开展盲评:从报告生成基准随机抽取 300 个病例(胸部 X 光、胸部 CT、腹部 CT 各 100 例),评估者同时查看原始影像与四份匿名报告(ClinFusion + agentic、ClinFusion 独立、Gemini-3-Flash、Hulu-Med),在事实准确性、完整性、临床可用性三个维度上排序。
模型与评测方法同时得到验证。ClinFusion + agentic 在全部维度排名第一,相对 Hulu-Med 与 Gemini-3-Flash 均有统计显著优势(p < 0.001),且独立版本已同时优于两者。在 11 个自动指标(含 METEOR、BLEU-4、ROUGE-L、RadGraph-F1、BERTScore、GREEN)中,RoI-Grounded 在三项一致性度量上全部第一(Kendall's τ = 0.511、Spearman's ρ = 0.572、Top-1 准确率 55.5%),单病例层面的 τ 分布也均值更高、方差更低。标注者间协和系数 W = 0.665 ± 0.275(n = 300),跨模态一致,说明观察到的差异反映真实质量差距而非标注噪声。
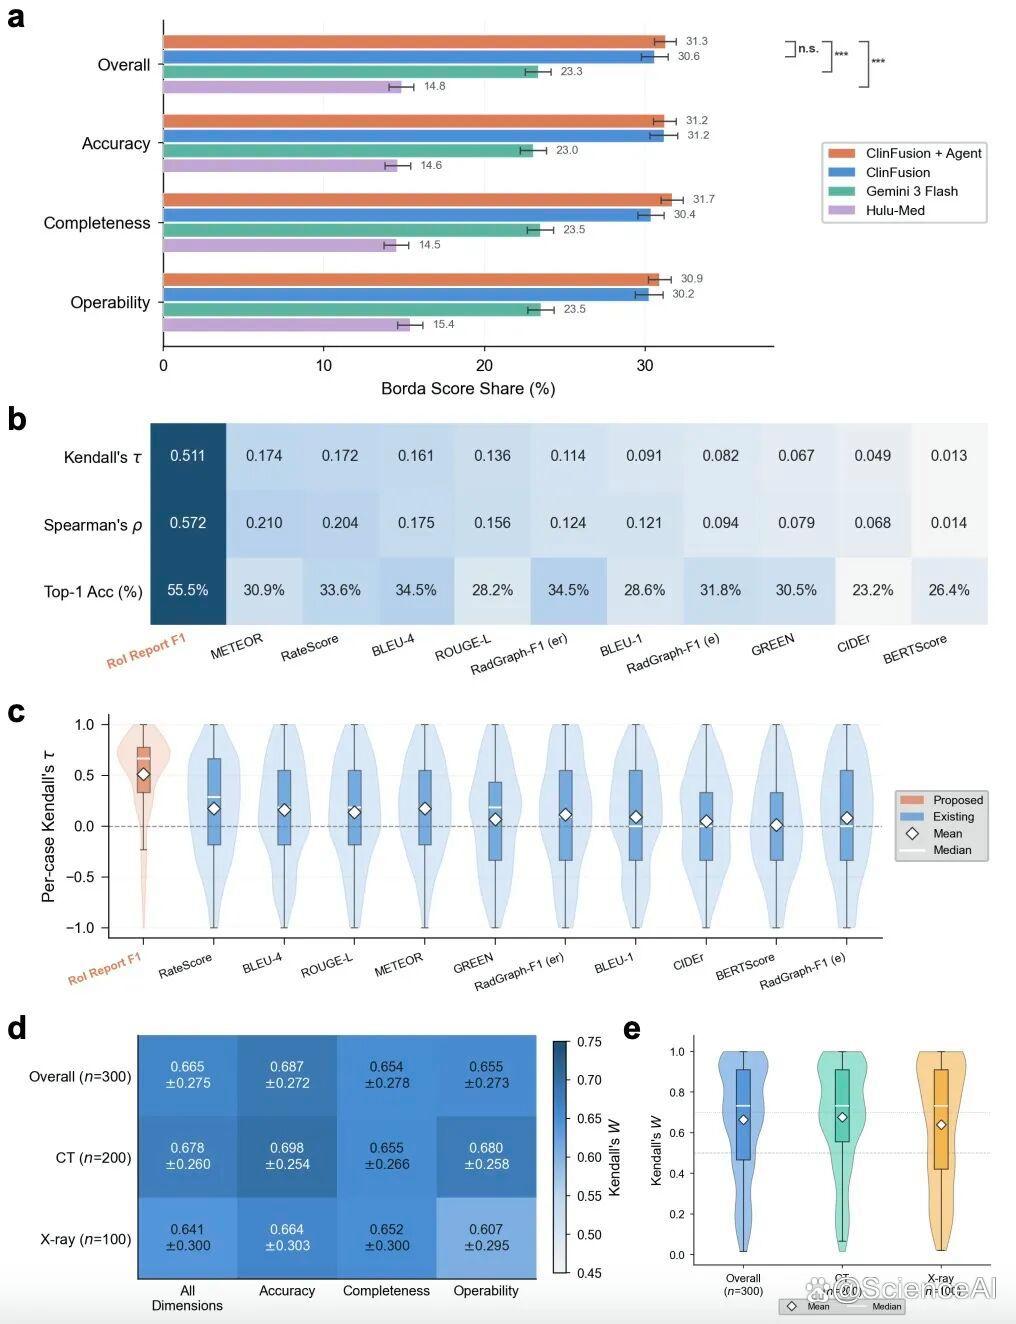
图 6 六位放射科医师盲评结果。a,系统排序;b–c,自动指标与专家判断的相关性;d–e,标注者间一致性。
消融分析:旧评测范式为什么会失效
临床上下文是让报告生成对比有意义的前提。去掉上下文后两件事同时发生:两个模型的指标都大幅下降,模型间差距也被严重压缩 —— 有上下文时 ClinFusion-8B 稳定优于 Lingshu-7B,无上下文时两者几乎相同。根因是医师报告只聚焦与指征相关的区域,缺少上下文时模型会描述参考报告未涉及的区域,这些内容无法判定是幻觉还是医师主动省略,却被一律记为 false positive。
LLM 判官规避了同义不敏感与长度偏置。RadGraph-F1 把报告解析为固定 schema 的实体关系再算 F1,带来两个失效模式:同义不敏感 ——「the liver appears enlarged」与「hepatomegaly is present」临床完全等同,却因映射到不同条目而得零分;长度偏置 —— 输出越长越可能与参考报告重叠。量化证据印证了这两点:RadGraph-F1 在前三个模型上挤在 11.8–21.0 的窄区间、判别力弱,而该研究的判官跨度更宽(16.8–37.8);「Long Output」变体质量更差,却让 RadGraph-F1 虚高(11.8→18.8),判官则正确地惩罚了冗长(16.8→15.1)。
架构消融。四种融合机制中局部交叉注意力平均性能最高;三个候选专家编码器中,DINOv2 是唯一在 VQA 与报告生成上都距最佳不超过 0.3 的;第二个专家编码器收益明显递减;相同编码器对下级联融合在报告生成上明显优于并行(28.8 vs 27.3),说明级联的渐进富化对开放式生成收益更大;推理时停用 3D 编码器后,3D VQA 平均下降 3.0 分、3D 报告 F1 下降 4.0 分,证明体积特征无法被稀疏 2D 切片替代。
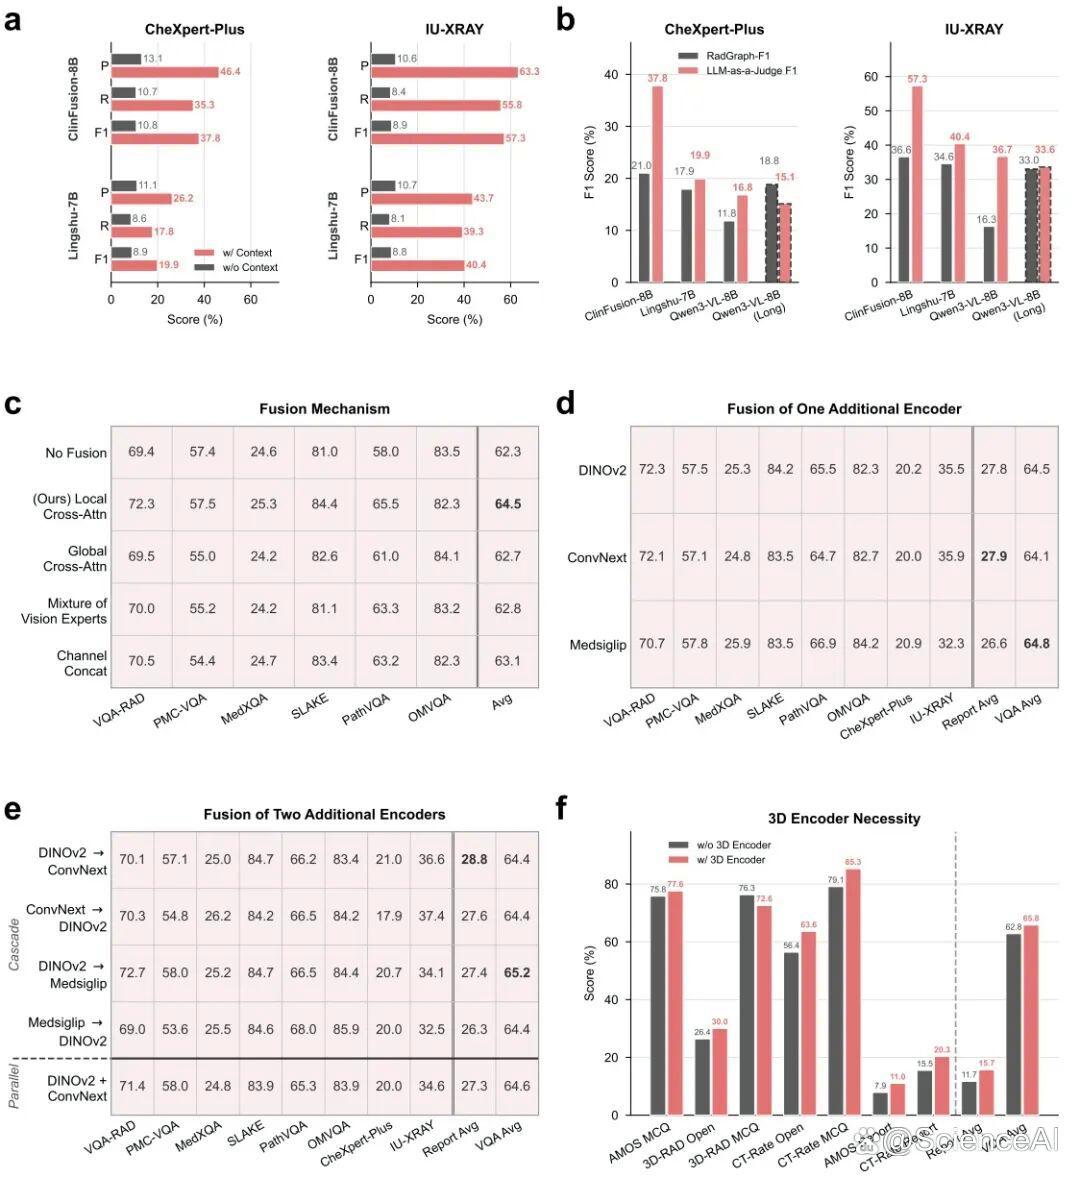
图 7 消融实验。a–b,RoI-Grounded 评测设计;c–f,架构设计(融合机制、专家编码器、级联与并行、原生 3D 编码器)。
Agentic 工具调用:把静态模型变成可追溯的临床助手
该研究为 ClinFusion 配备工具生态与显式 plan–act 工作流:先规划出有序的工具调用计划,再顺序执行并把结构化输出作为可审计的中间证据收集,最后综合为一份临床回复。工具分两类:知识工具是向量检索 + 知识图谱概念召回的混合 RAG,语料含 PubMed、StatPearls、医学教科书以及自建的 1.8 万份中美临床指南与 10 万篇顶级期刊文献;感知专家工具包括多器官病灶分割、脂肪肝评估、腹部淋巴结分割与胸片所见分类。
增益集中在描述性与知识密集型任务。8B 上增幅最大的是需要描述性输出的任务(CheXpert-Plus 报告 +12.4、3D-RAD 开放问答 +8.4),闭式选择题增益较小;纯文本上集中在知识密集型基准(SuperGPQA +12.8、MedQA-USMLE +11.1、MedXpertQA +7.7)。唯一例外是中文考试基准 MedQA-MCMLE 在 8B 上下降 4.8 分,归因于检索语料中文覆盖有限,该赤字在 32B 上不再出现。更重要的是,中间工具输出始终暴露且可审计,使推理链条可核验。
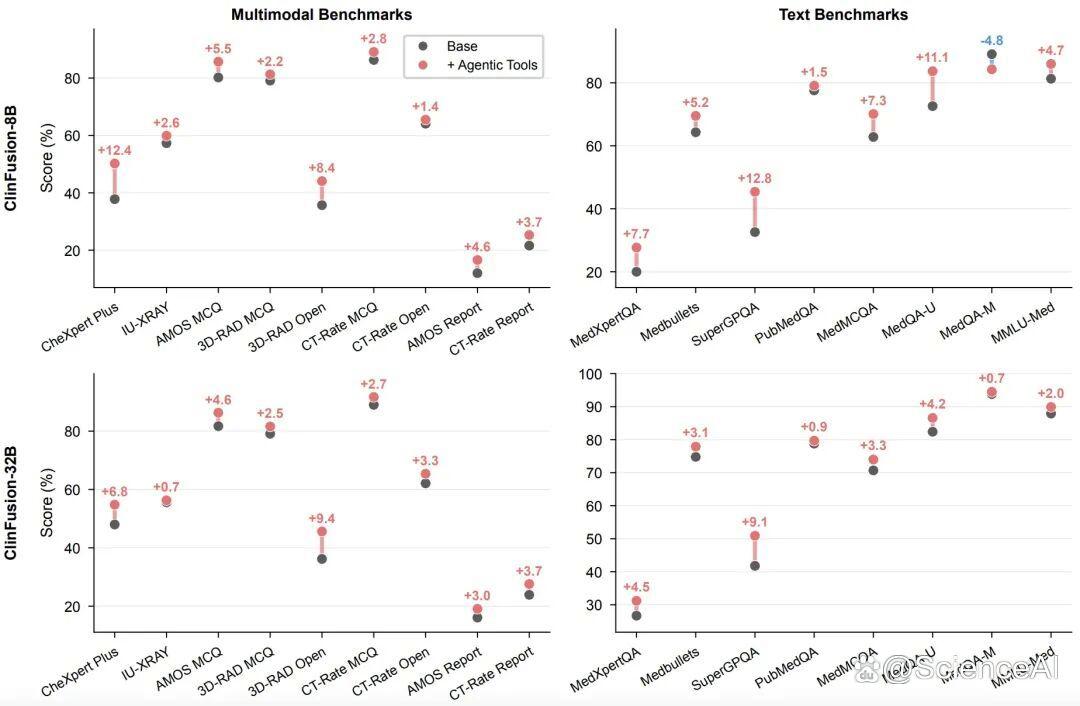
图 8 配备 agentic 工具后的性能增益。上下两行为 8B 与 32B,左右两列为多模态与纯文本基准。
结论
把多模态大模型送进临床,长期受制于三个根本障碍:异构医学数据的处理难题、学术评测与真实临床需求之间的落差,以及模型知识的静态性。ClinFusion 为其提供了系统性解法:架构上跳出单一编码器范式,用带 CaSL Fusion 的组合式、级联式设计统一 2D 与原生 3D 处理;评测上用 MedIF-Bench 守住可靠的指令跟随,用 RoI-Grounded 把评价从粗糙的文本相似度转向临床对齐、事实性导向的判定;落地上以 agentic 工具调用接入动态知识检索与外部专家模型。实验支持了核心假设:整体性医疗感知受益于能原生处理异构 2D/3D 数据的组合式视觉系统,而非单一编码器;而 RoI-Grounded 与专家判断的强相关性,也证实了视觉锚定、事实性导向的指标更能反映真实临床需求。
局限也很明确:当前工具集仍有限,未来应扩展到超声、MRI 等更多模态;在知识密集型文本基准上与最强闭源模型仍存差距,主要源于模型容量与训练数据规模差异;真正走向临床仍需严格的 human-in-the-loop 评估。