顶级基金实盘在跑的冷门模型,和时序大模型的真相:那些很强但很冷门的架构,以及时序大模型到底有没有用
一篇写给量化从业者的深度报告。所有数字都能追到原始出处,凡是我核实不了的地方,我都会明说。
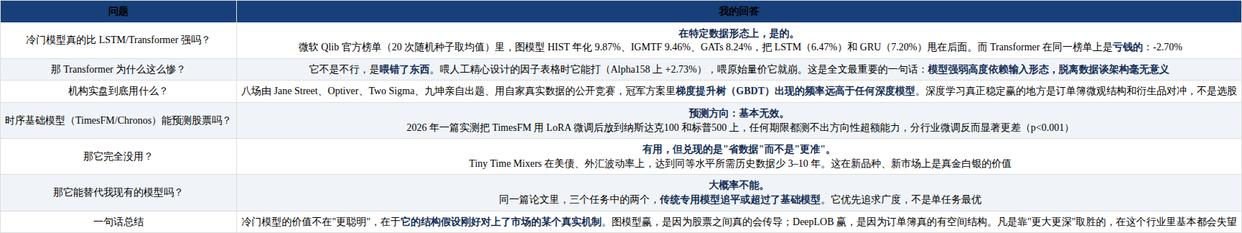
先把结论摆在最前面,你可以只看这张表:
开场:我为什么要写这篇
这个行业有个很有意思的现象。
你去翻 arXiv,每个月都有几十篇"我们用 Mamba/KAN/超图/某个全新架构预测股票,效果超过所有 baseline"的论文。你再去问真正在管钱的人在用什么,答案往往朴素得让人失望:LightGBM,加一堆人肉挖出来的特征。
这两件事之间的鸿沟,就是这篇报告要填的东西。
但我不想写成"深度学习在金融没用"这种廉价的反鸡汤——那也是错的。有些冷门模型确实在实盘里跑着,而且赚钱。关键在于分清楚哪一层用什么。所以这篇报告的骨架是这样的:
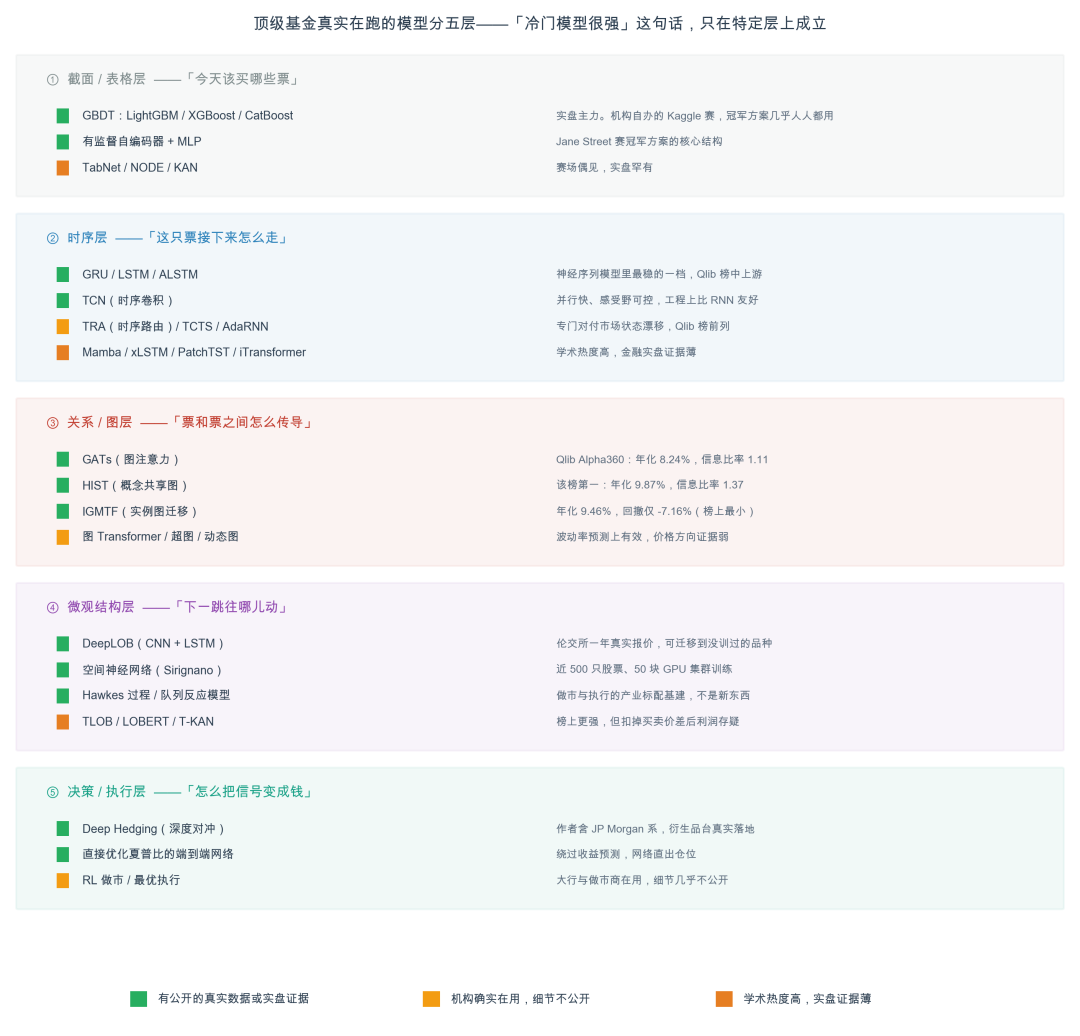
这张图在说什么:把"量化模型"拆成五层,每层的任务完全不同,胜出的架构也完全不同。绿色是有公开真实数据或实盘证据的,橙色是学术热但实盘证据薄的。你会发现绿色最密集的地方是第③层(图模型)和第④层(订单簿),而不是大家最爱讨论的第②层(时序架构)。
我会按这五层一层一层讲。每一层我都尽量给你能追到源头的证据,而不是"据说某某基金在用"。
第一步:先建立一个直觉,不然后面全是废话
在往下走之前,必须先解决一个认知问题。因为如果你不知道"真实的量化预测有多弱",后面所有数字你都会读错。
量化里衡量预测好坏最常用的指标叫 IC(Information Coefficient,信息系数)。说白了就是:你的预测值和真实未来收益之间的相关系数。 完美预测 IC = 1,瞎猜 IC = 0。
那真实世界里,好模型的 IC 是多少?
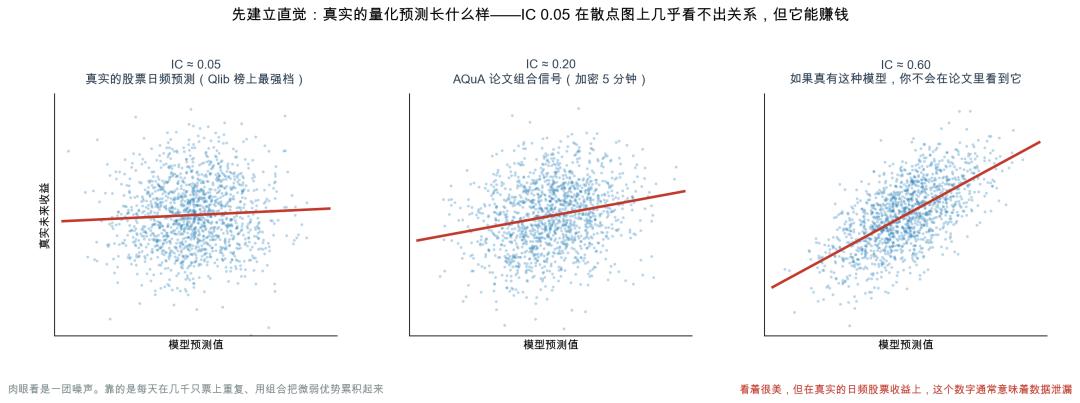
这张图在说什么:三张散点图,横轴是模型预测,纵轴是真实未来收益。左边那张 IC ≈ 0.05,是 Qlib 榜单上最强档模型的真实水平——肉眼几乎看不出任何关系,就是一团噪声。 中间 0.20 是加密货币高频场景。右边 0.60 我画出来只是为了让你有个对比:在日频股票收益上,如果谁跟你说他的 IC 有 0.6,第一反应应该是去查数据泄漏,而不是恭喜他。
这就是这个行业的真实底色。IC 0.05 意味着什么?意味着你每次预测都可能是错的,但你在几千只股票上、每天重复这件事,用组合把这个微弱的偏差累积起来,最后变成了钱。
理解了这一点,你才能读懂后面的数字。当我说"HIST 的 IC 是 0.0522,比 LSTM 的 0.0448 高"时,这不是小数点后的无聊游戏——这个差距在真实资金上是完全不同的两条净值曲线。
好,现在可以开始了。
第③层最硬的证据:图模型确实赢了,而且赢在一个很讲道理的地方
我先讲图模型,因为你问的 GCN、GAT 就在这一层,而且这一层的公开证据是最扎实的。
为什么公开证据扎实?
因为微软开源了一个叫 Qlib 的量化研究平台,并且在仓库里维护了一份基准榜单:同样的数据、同样的回测流程、同样的组合构建规则,把二十多个模型全部跑一遍。而且——这点很关键——每个数字都是 20 次不同随机种子的均值加标准差。
这在金融机器学习里几乎是奢侈的诚实。太多论文的"我们更好"其实是"我们运气好",跑一次拿个漂亮种子就发了。20 次取均值意味着你看到的差距是真的。
榜单长这样:
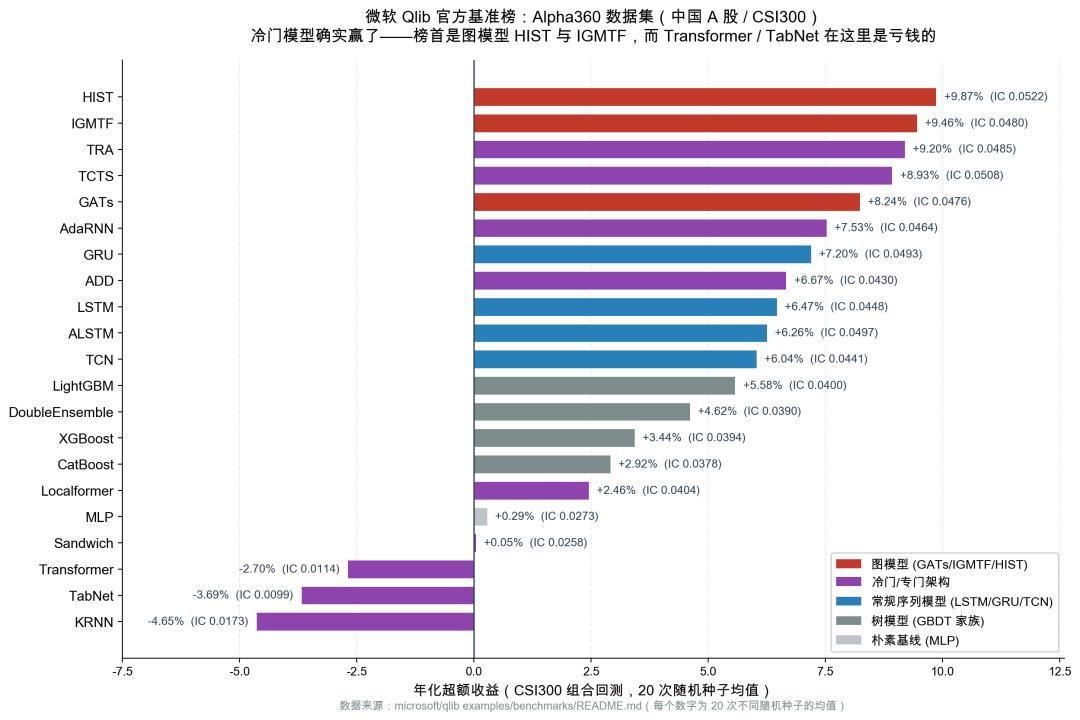
这张图在说什么:Alpha360 数据集(中国 A 股,CSI300 成分,输入是纯原始量价数据)上,按年化超额收益排序的完整榜单。红色是图模型,紫色是各种冷门专门架构,蓝色是常规序列模型,灰色是树模型。
看排名前四:HIST(9.87%)、IGMTF(9.46%)、TRA(9.20%)、TCTS(8.93%),然后是 GATs(8.24%)。前五里有三个是图模型。
再看倒数几名:KRNN(-4.65%)、TabNet(-3.69%)、Transformer(-2.70%)——是的,Transformer 在这个榜单上是亏钱的。
这三个图模型分别在干什么
GATs(图注意力网络),就是你提到的那个,2017 年 Veličković 等人提出的通用架构。它的核心思想极其简单:一个节点在更新自己的表示时,不该平等对待所有邻居,而应该学会"该多听谁的"。
放到股票上:预测宁德时代的时候,比亚迪的信息应该比某只银行股重要得多。GAT 就是让网络自己学出这个权重。榜单上它拿到年化 8.24%、信息比率 1.11、最大回撤 -8.94%。
HIST(微软亚洲研究院,2021)在 GAT 之上想得更深一层。它注意到一个问题:大家用的股票关系图,基本都是静态的。 你按行业分类建个图,然后一年都不变。但现实里,一只票和"新能源"这个概念的相关程度是天天在变的——今天有政策它就强相关,过一个月热度散了就弱相关。
更妙的是它还去挖**"隐概念"**:除了人工定义的行业、主题这些标签,股票之间还有一些说不清但确实存在的共性。HIST 让模型自己把这部分学出来。结果是榜单第一:年化 9.87%,信息比率 1.37,最大回撤 -6.81%。
IGMTF(同一批作者)走的是另一条路——不是建"股票与股票"的图,而是建**"当前这个样本和历史上哪些样本像"的图。有点像在说:今天这个市场状态,跟历史上哪几天最像?把那几天的模式借过来用。它拿到 9.46% 年化,而且最大回撤只有 -7.16%,是全榜最小的。**
这个"回撤最小"值得多说一句。在真实资金上,回撤比收益更能决定你能不能活到策略生效的那天。 一个年化 9% 回撤 7% 的策略,和一个年化 11% 回撤 25% 的策略,前者可能才是能上规模的那个。
但这里有个关键的坑,必须讲
如果我到此为止,你会得出"图模型天下第一"的结论。那就错了。看这张图:
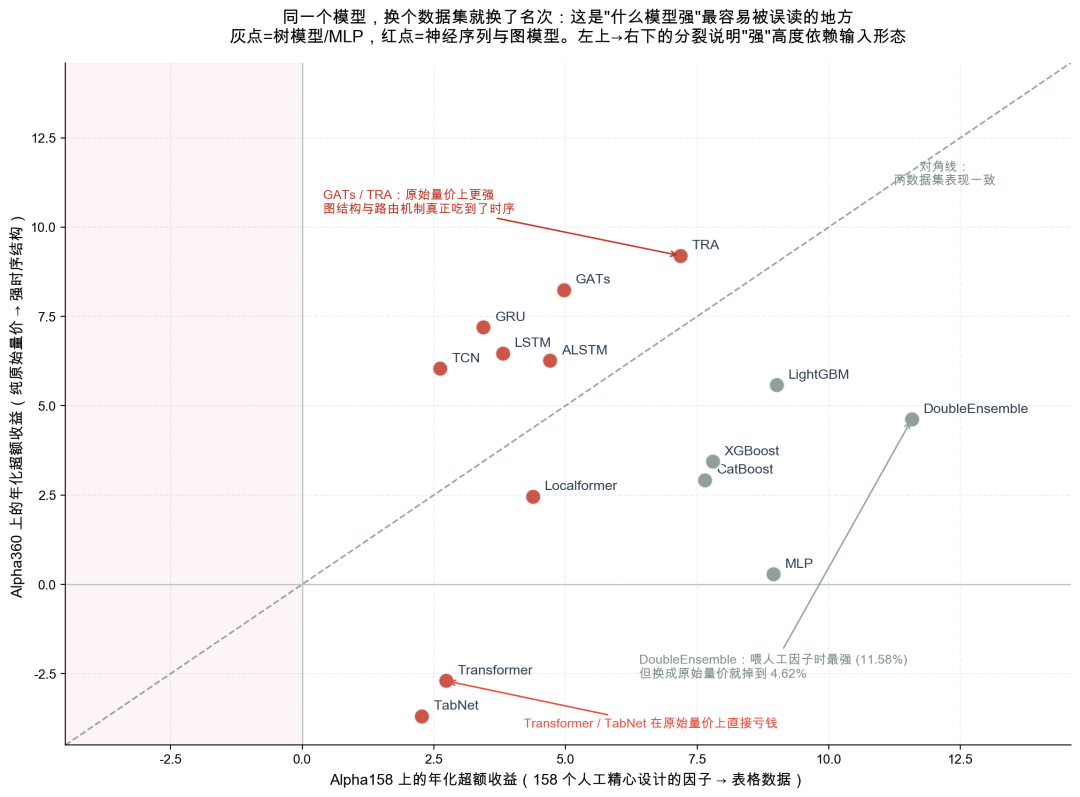
这张图在说什么:横轴是同一个模型在 Alpha158(158 个人工精心设计好的因子,本质是表格数据)上的表现,纵轴是在 Alpha360(纯原始量价,有强时序结构)上的表现。
看 DoubleEnsemble:喂人工因子时它是全场最强,年化 11.58%;换成原始量价,掉到 4.62%。
看 Transformer:人工因子上 +2.73%,原始量价上 -2.70%。
看 MLP——就是最朴素的多层感知机:人工因子上 8.95%,居然打赢了一堆花哨架构;原始量价上 0.29%,几乎归零。
这就是全文我最想让你记住的一件事:
问"哪个模型强"是个错误的问题。正确的问题是"在什么形态的输入上,哪个模型强"。
人工因子已经把时序信息压缩进去了,剩下的是一张扁平的表——这时候树模型和 MLP 就是最优解,注意力机制没有东西可以注意。而原始量价保留了完整的时间和截面结构——这时候能显式建模结构的模型(图、路由、卷积)才能吃到东西。
我见过太多人拿着一篇论文的 SOTA 结论直接往自己的数据上套,然后困惑于为什么复现不出来。大概率不是你实现错了,是你的输入形态根本不是那篇论文的形态。
关于 Qlib 榜单,我必须给的免责声明
Qlib 官方 README 里自己写了一句很实在的话,大意是:我们实现和调参的资源很有限,尽力做到公平比较,但某些模型的潜力可能比表上看起来更大。
我把这句话原样传给你。这意味着:
- 榜单反映的是"在统一流程下,开箱即用能跑出什么",不是"这个架构的理论上限"
- 单一市场(A 股)、单一频率(日频)、单一股票池(CSI300),换个市场结论可能就变
- 这是回测,不是实盘。没有真实的成交冲击、没有容量约束、没有借券成本
- 但反过来说——正是因为它统一、可复现、跑了 20 个种子,它比 99% 的论文声明都可信。
第④层:订单簿。深度学习在这里赢得最干净
如果你要我指出一个"深度学习在金融里赢得最没有争议"的地方,我会指向订单簿(Limit Order Book, LOB)。
原因很朴素:这一层数据量极大、结构极清晰、信噪比相对高。 一天几十亿条报价和成交,而且订单簿天然是个二维结构(价格档位 × 时间),这正是卷积网络最擅长的东西。
2016:Sirignano 的"空间神经网络"
Justin Sirignano 做了一件在当时很奢侈的事:用 50 块 GPU 组成的集群,在近 500 只股票上训练。
他的洞察在于设计了一个专门利用订单簿空间结构的架构。传统做法只看买一卖一(最优报价),但订单簿深处那些档位其实包含大量信息。他的"空间神经网络"能有效利用深层档位的信息,而且论文里特别提到:在分布尾部的表现尤其比标准神经网络好——这对风险管理很重要。
这个"尾部"的点很专业。大多数人只关心平均预测准不准,但做风控的人关心的是极端情况下你的模型会不会瞎。
2018:Sirignano 与 Rama Cont 的"普适性"发现
这篇我认为是这个领域最重要的论文之一。他们用数十亿条美股电子报价和成交记录做了一件事:训练一个所有股票共用的模型,然后去测那些根本没在训练集里出现过的股票。
结果是:这个"普适模型"的表现,超过了为每只股票单独训练的模型。
这个结论在当时是反直觉的。行业惯例是给每只票或每个行业做专门的模型。这篇论文说:别这么干,把所有股票的数据汇总起来训一个模型更好,因为价格形成机制本身是普适的。
更有意思的是他们报告的几个负面发现:按波动率、价格水平、平均价差做标准化,或者按行业、大小盘分组训练,都没能改善结果。 反而是把更长的历史订单流信息喂进去改善了预测——说明价格动态是有路径依赖的。
这几句"我们试了但没用"的坦白,比论文里的正面结果更有价值。
2018:DeepLOB —— 牛津那批人
Zhang、Zohren、Roberts 三个人(牛津 Oxford-Man 研究院,这个机构和 Man Group 有深度关联)做的 DeepLOB,是这个领域引用最多的工作之一。
架构说白了就是:卷积层抓订单簿的空间结构(哪些档位在变),LSTM 抓时间上的长程依赖(这个变化持续多久了)。
它的验证方式比大多数论文靠谱得多:
- 在公开基准 FI-2010 上打赢所有当时的 SOTA
- 然后用伦交所整整一年的真实市场报价重新测,得到"跨多个品种都非常稳定的样本外预测精度"
- 最狠的一步:测那些不在训练集里的品种,模型依然有效——和 Sirignano-Cont 的"普适性"结论互相印证
- 做了敏感度分析,指出订单簿里哪些部分最重要,不让它停留在黑箱
这才叫像样的实证工作。 公开基准 → 真实一年数据 → 跨品种迁移 → 可解释性,一步都没省。
2021:同一批人的诚实续作
Zhang 和 Zohren 后来做了多期限预测(不只预测下一跳,而是生成一条预测路径)。这篇有个很产业化的细节:他们用了 Graphcore 的 IPU 芯片来加速训练,因为编解码器结构依赖循环层,训练太慢。
为什么我要提这个硬件细节? 因为它暴露了一个学术论文很少讨论但实盘极度关心的问题:训练和推理的延迟。 一个理论上很强但推理要 50 毫秒的模型,在高频场景里等于不存在。这也是为什么 TCN(时序卷积)在产业里比 RNN 受欢迎——它能并行,RNN 不能。
2025–2026:坏消息来了
上面全是好消息。现在讲坏消息,这部分比好消息重要。
TLOB(2025)这篇论文做了两个让人不太舒服的发现:
第一个:他们把一个简单的 MLP 架构适配到订单簿数据上,就超过了当时的 SOTA。作者自己在摘要里写:这挑战了复杂架构的必要性。
第二个,更扎心:他们实证发现股价可预测性随时间在衰减,F1 分数下降了 6.68。也就是说——市场在变得更有效,这些模型的饭碗在缩小。
第三个,最扎心:他们试着用平均买卖价差来定义"趋势"(也就是说,只有涨幅超过交易成本才算真的趋势)。结果性能显著恶化。作者的原话大意是:这凸显了把趋势分类转化为可盈利策略的复杂性。
这句话应该被印出来贴在每一个做量化的人的显示器上。
分类准确率 65% 听起来很不错。但如果你赚的那部分平均只有 0.8 个基点,而买卖价差是 1.5 个基点——你准确率再高都是在给交易所和做市商送钱。
同样的信号也出现在另一篇(2026)研究 Kolmogorov-Arnold 网络的论文里,标题直接就带着 "Alpha Decay"(阿尔法衰减):传统模型如 DeepLOB,随着预测期限拉长,预测能力就流失。
这一层还有个"不冷门但被低估"的东西:Hawkes 过程
聊深度学习聊多了,容易忘掉一件事:做市和执行这两个业务,产业里真正的基建不是神经网络,是点过程模型。
Hawkes 过程(自激过程)的核心思想一句话能说清:一个事件发生后,会提高短期内同类事件再次发生的概率。 放到市场里就是——一笔大买单出现后,紧跟着更多买单的概率会上升。 这就是订单流的聚集性(clustering),是市场微观结构里最真实、最稳定的经验规律之一。
还有 队列反应模型(Queue-Reactive Model)(Huang、Lehalle、Rosenbaum,2013)——把订单簿建模成一组队列,订单到达率取决于当前队列状态。这类模型在做市和最优执行里是标配,因为它们能模拟,能用来做反事实分析:如果我这笔单子这样切,市场会怎么反应?
为什么这些"老东西"在产业里活得比新架构好?
因为它们可解释、可校准、能生成模拟环境。你没法拿一个 Transformer 去回答"如果我把这笔 500 万的单子拆成 20 份,冲击成本是多少"——但你能用 Hawkes + 队列模型算出来。
产业里最值钱的模型,往往不是预测最准的那个,而是能让你做决策的那个。
第①层最有说服力的证据:八场机构自己出题的比赛
前面讲的都是学术论文。现在讲一类我认为说服力更强的证据。
为什么更强?因为这些比赛的数据是机构生产系统里出来的,题目是他们自己出的,而且冠军方案全部公开可查。这比"某基金内部人士透露"靠谱一万倍。
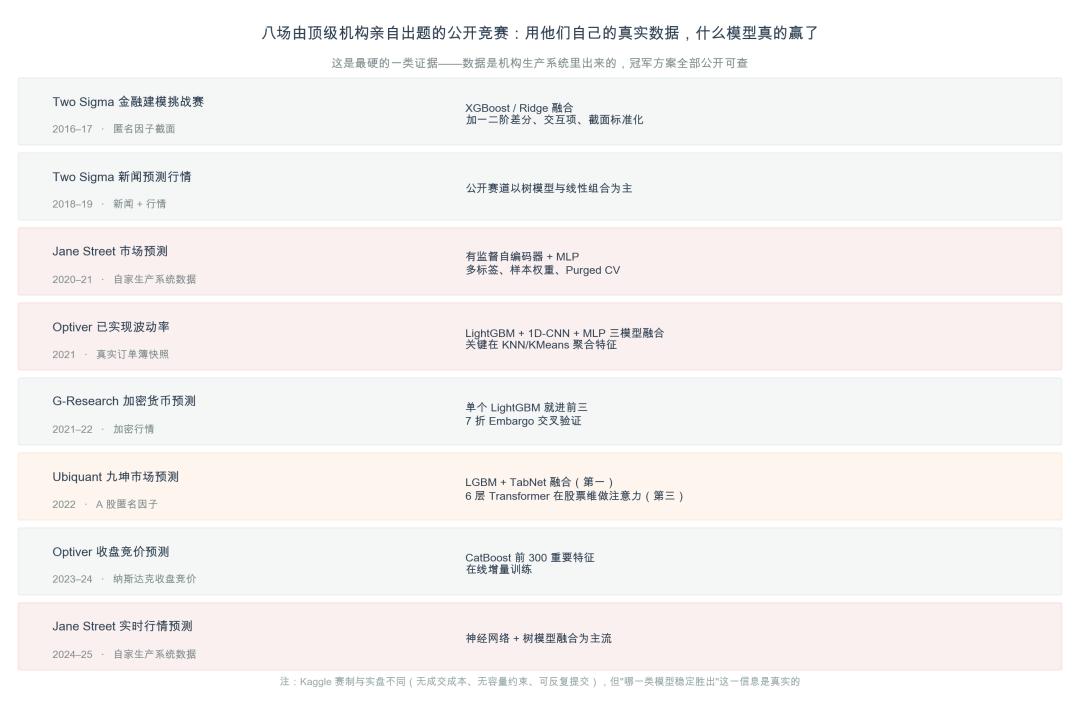
这张图在说什么:从 2016 年到 2025 年,Two Sigma、Jane Street、Optiver、九坤(Ubiquant)、G-Research 这些机构亲自出题的八场公开竞赛,各自的数据类型和冠军方案。
我把最值得说的几场展开讲。
Jane Street 市场预测(2020–21):冠军是"有监督自编码器 + MLP"
Jane Street 拿出了来自自家生产系统的数据——匿名化的特征,加上几个不同期限的收益标签(resp、resp_1 到 resp_4)。
冠军方案的几个关键动作,每一个都很有讲究:
动作一:把多个期限的收益标签全部转成分类目标,做多标签学习。 为什么?因为单看一个期限的收益噪声太大。同时预测多个期限,相当于强迫模型学"这笔机会到底好不好"这个更本质的东西,而不是去拟合某一个期限上的噪声。
动作二:用所有收益标签绝对值的均值做样本权重。 翻译成人话:让模型多关注那些"要么赚大要么亏大"的样本,别在鸡毛蒜皮的样本上浪费容量。 这是非常实战的思路——在真实的交易里,你的盈亏也是被少数大机会决定的。
动作三,也是最核心的:用自编码器造新特征,和原始特征拼在一起喂给下游 MLP。而且——把目标信息也加进自编码器,强迫它生成的特征和预测目标相关(这就是"有监督"自编码器的意思)。再在编码器前加高斯噪声层做数据增强、防过拟合。
动作四:三个不同随机种子训练取平均,降低预测方差。
动作五:5 折、31 天间隔的 purged group time-series 交叉验证。
最后这一条我要单独强调。"purged"(净化)和 "gap"(间隔)是金融机器学习和普通机器学习最本质的区别之一。
普通 K 折交叉验证会随机打乱数据。在金融时序上这么干,你就死了——因为今天的标签用到了未来几天的收益,如果训练集里有第 10 天、验证集里有第 11 天,那么第 10 天的标签已经包含了第 11 天的信息。你的验证分数会好得离谱,然后实盘一上就崩。
所以要做两件事:purging(把和验证集有时间重叠的训练样本删掉)和 embargo/gap(在训练集和验证集之间强行留一段空白)。这套方法论出自 Marcos López de Prado 的《Advances in Financial Machine Learning》。
你会发现这八场比赛的冠军,几乎人人都在用这套交叉验证。 这比他们用什么模型更值得学。
Optiver 已实现波动率(2021):赢家是三个"土"模型的融合
Optiver 是全球顶级的期权做市商,波动率预测就是他们的命。他们放出了真实的订单簿快照数据。
冠军方案的模型部分朴素得让人意外:LightGBM + 一维 CNN + MLP,三个模型简单融合。 没有 Transformer,没有图网络。
真正的功夫全在特征上:
- 通过 t-SNE 把 time_id × stock_id 的价格矩阵压到一维,反推出了被打乱的时间顺序(这是个很漂亮的逆向工程,恢复出时间顺序后就能做真正的时序交叉验证)
- 基于 time_id 做 KNN:找到相似的时间窗口,把重要特征在这些邻居上重新聚合一遍——捕捉"当前市场状态"
- 基于 stock_id 做相关性 + KMeans:找到相似的股票,同样重新聚合——捕捉"行业效应"
注意最后两条在做什么。 它没有用图神经网络,但它在做和图神经网络一样的事情:把相关个体的信息聚合过来。只不过它用的是 KNN 和 KMeans 这种最朴素的工具。
这是一个非常重要的启示:图模型的价值在于"聚合相关个体的信息"这个思想,而不在于 GNN 这个实现。 很多时候一个精心构造的 KNN 特征,比一个调不好的 GAT 更管用,而且快一百倍、可解释得多。
九坤 Ubiquant(2022):中国最大量化私募之一的真实 A 股因子
第一名:LightGBM + TabNet 融合(各 5 折取平均)。
它的特征工程有个很精妙的动作。原始数据是 300 个匿名因子。它做了这么一件事:先算出 300 个因子和目标的相关系数,取排名靠前的 100 个,然后计算这 100 个因子在每个 time_id(每个时间截面)上的均值,作为 100 个新特征加进去。
这 100 个新特征在表达什么?当天整个市场的状态。
这是一个在实战中极其常用但论文里很少提的技巧:把截面均值作为特征喂回去,等价于告诉模型"今天大盘环境是什么样"。 同样的因子值,在牛市和熊市里含义完全不同——加了这层信息,模型才能区分。
第三名的方案完全不一样,也很值得看:6 层 Transformer,最大序列长度 3500 只股票,在股票维度上做注意力,每一天当成一个样本。 直接用皮尔逊相关系数当损失函数。数据增强用了随机置零(特征级)+ 随机掩码(序列级),思路借鉴 BERT。不做任何特征工程,不搞花哨的折划分,就取最后 200 天当验证集。
这个方案很重要,因为它证明了 Transformer 在选股上不是不能用——关键是你要在"股票维度"上做注意力,而不是在"时间维度"上。
想想为什么。在时间维度上做注意力,你是在问"过去哪一天对今天最重要";在股票维度上做注意力,你是在问"今天哪些票之间在互相影响"。后者才是截面选股的本质,而这恰恰就是图模型在做的事。
所以你看,第一名用树模型 + 截面均值特征,第三名用股票维度的 Transformer,Qlib 榜单上 HIST 用动态概念图——三条不同的路,都在解决同一个问题:如何利用股票之间的横截面关系。
第七名的一个细节,我觉得最值得说
第七名用的是简单的 LightGBM(把 extra_trees 参数打开)。他自己写道:模型吃进 900 多个特征,是从一个更大的特征池里筛出来的,"这算是我的秘密"。
然后他讲了一件事——作为对照,他的第二个提交用了同样的模型,但只用原始的 300 个特征,得分 0.112,连奖牌区都进不了。
同一个模型,同样的参数,特征不同,一个进前十,一个连奖牌都没有。
这就是这个行业的真相。模型架构的贡献,通常远小于特征工程的贡献。 这不是说架构不重要,而是说——如果你的特征不行,换任何架构都救不了你。
归纳一下这八场比赛告诉我们什么
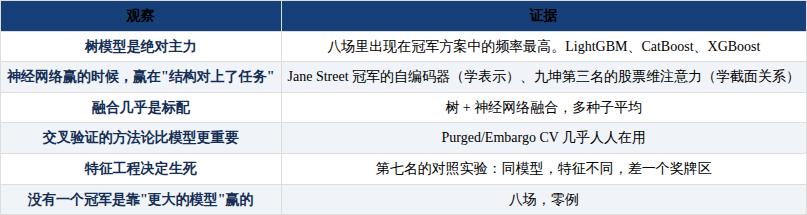
最后必须给的免责声明:Kaggle 和实盘有本质区别。 没有成交成本、没有市场冲击、没有容量约束、可以反复提交去试探测试集。所以不能说"冠军方案就是实盘方案"。但"哪一类模型在机构自己的真实数据上稳定胜出"这个信息,是真实且有价值的。
现在回答你的第二个问题:时序基础模型,在实盘到底有没有用?
这是全篇我最想认真回答的部分,因为这里的市场噪音最大。
先把背景说清楚。2023 年之后出现了一批"时序基础模型"(Time Series Foundation Model, TSFM)——思路是复制大语言模型的成功路径:在海量、多领域的时间序列上预训练一个大模型,然后不用训练,直接零样本拿来预测任何新序列。
主要玩家:
- TimesFM(Google,2023):解码器结构,在大规模时序语料上预训练
- Chronos(Amazon,2024):思路最有趣——把时序数值缩放、量化成一个固定词表,然后直接拿语言模型架构用交叉熵训练。等于说"把时间序列当语言来学"
- Moirai(Salesforce,2024):在 LOTSA 语料上训练,超过 270 亿个观测点,横跨九个领域
- Tiny Time Mixers(TTM)(IBM,2024):走小模型路线
- Chronos-2(2025):关键升级——支持多变量和协变量的零样本预测
宣传口径都很漂亮。那么放到金融上呢?
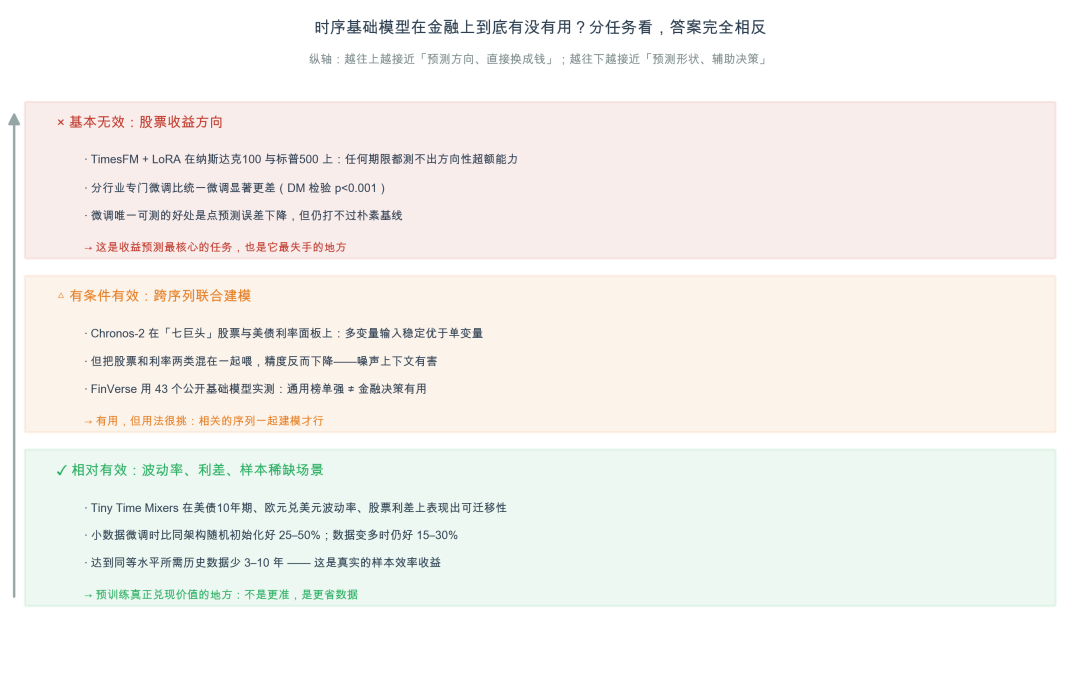
这张图在说什么:按任务分层的结论。越往上越接近"预测方向、直接换钱",越往下越接近"预测形状、辅助决策"。红色是基本无效,橙色是有条件有效,绿色是相对有效。结论完全取决于你让它干什么活。
一个一个说。
结论一:预测股票收益方向 —— 基本无效,而且有个陷阱
2026 年 7 月有篇论文,我认为是这个话题上方法论最诚实的一篇。作者把 TimesFM 用 LoRA 微调后,放到股票上做方向预测。
故事是这么开始的:早期版本看起来达到了约 80% 的方向准确率。
80%!如果是真的,这就是印钞机。但作者做了一件绝大多数人不会做的事——他去查这个数字是怎么来的。
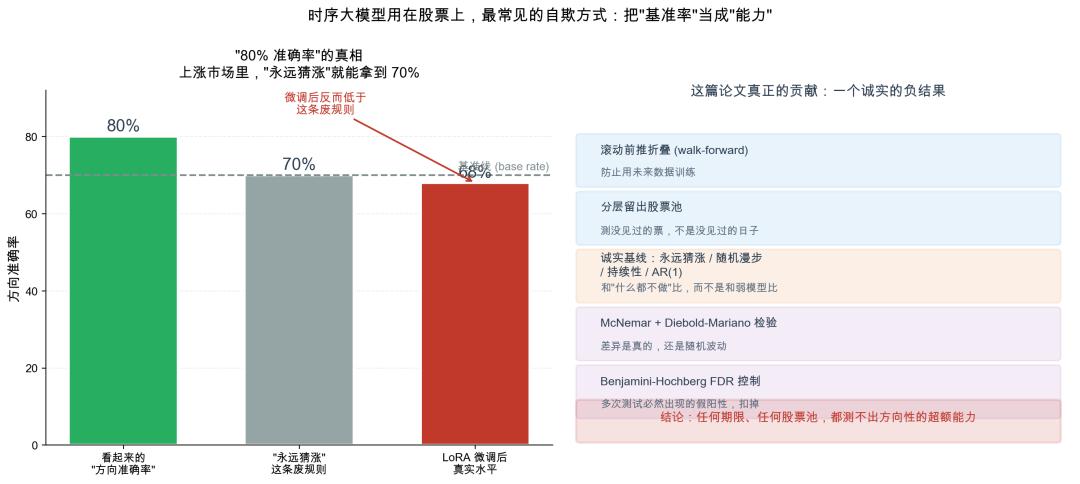
这张图在说什么:左边三根柱子。第一根是"看起来的 80%"。第二根是**"永远猜涨"这条废规则能拿到的 70%——在一个长期上涨的市场里,你什么都不看,闭着眼睛说"涨",就能对 70%。第三根是微调后模型的真实水平:68%,比那条废规则还低。**
这就是基准率陷阱(base rate trap)。你的模型看起来很准,但它连"什么都不做"都打不过。
作者后来搭了一套非常严谨的评估框架,右边那张图列了它的组成:滚动前推验证、分层留出股票池(测没见过的票,而不是没见过的日子——这是两个完全不同难度的任务)、四条诚实基线(永远猜涨、随机漫步、持续性、AR(1))、McNemar 和 Diebold-Mariano 配对检验,再套上 Benjamini-Hochberg 的假阳性率控制。
在这套框架下测出来的三个结论,在两个股票池(纳斯达克100、标普500)上都复现了:
- 重建那个"80%"的条件后,那个高数字就是个 70% 的基准率,而微调后的模型得分低于它
- 统一微调的 LoRA,在任何期限上都测不出超越基准率的方向性能力(六个月期限上甚至是负的)
- 分行业专门微调,显著比统一微调更差(Diebold-Mariano 检验 p<0.001)
微调唯一可测的好处是:点预测误差比零样本 TimesFM 显著下降。但它仍然打不过朴素基线,也不带来任何可交易的方向性优势。
作者自己把这篇的贡献定义为"方法论的"——一个防止基准率陷阱的、完全可复现的评估协议,以及它产出的那个可复现的负结果。
我非常尊重这篇论文。 在这个满地都是"我们 SOTA 了"的领域里,愿意认真做一个负结果并且把它讲清楚,比十篇刷榜论文有价值。
结论二:通用榜单上强,不代表金融上有用
2026 年 8 月刚出的 FinVerse 基准,把这件事量化了。
它做的事情是:构建一个金融领域专用的时序预测基准。数据规模是 116,897 条金融时间序列、1.711 亿个观测点,其中挑出 60,232 条序列(1740 万观测) 作为评测目标——挑选标准是"这条序列对金融决策有没有经济意义"。
它最关键的设计思想是这个:别用统一的误差指标去评价性质完全不同的序列。 它定义了 11 个指标族、78 个评估指标,然后根据每条序列的经济含义,给它分配最合适的指标。
为什么必须这么做?论文自己举了例子:在股票预测里,正确预测涨还是跌,比最小化点预测误差更直接地关系到你的实际收益。
这句话说的是一个很多人栽过的坑。MSE 低不等于赚钱。 你可以有一个 MSE 极低的模型——它把每个预测都压到接近均值,误差自然小——但它对方向毫无判断力,交易价值为零。
它测了 43 个公开的时序预测基础模型,结论是:在通用预测标准下表现强,不必然转化为有用的金融预测。
43 个模型的实测。这是目前这个问题上最大规模的公开证据。
结论三:它真正有用的地方,是"省数据"而不是"更准"
现在讲好消息,而且这个好消息是真实的、可用的。
2025 年有篇论文测了 TTM 和 Chronos 在三个金融任务上的表现:美国十年期国债收益率变动、欧元兑美元波动率、股票利差预测。
TTM 展现出了扎实的可迁移性,具体数字是:
- 拿预训练的 TTM 和同样架构但随机初始化的模型对比,在数据有限时微调,预训练版本好 25–50%
- 即使在较长的数据集上微调,预训练版本仍然好 15–30%
- 零样本情况下,TTM 在波动率预测和股票利差预测上超过了朴素基线(后者说明它不微调就能打赢传统基准)
- 达到同等水平,预训练模型需要的历史数据少 3 到 10 年
最后这条是全部结论里商业价值最高的一条。
想想什么场景下这值钱:
- 一个新上市的品种,你只有三个月数据
- 一个新兴市场,历史数据又短又脏
- 一个新推出的衍生品,没有历史
- 你要快速评估一个新市场值不值得投入研究资源
在这些场景下,"少要 3–10 年数据"不是学术指标,是能不能做这笔业务的区别。
但这篇论文还有一句话,我认为比上面所有正面结果都重要,必须原样端出来:
虽然 TTM 打赢了朴素基线,但在三个任务里的两个,传统的专用模型追平或超过了它的表现。作者的解释是:时序基础模型优先追求的是广度,不是特定任务上的最优化。
这句话基本定义了这类模型在实盘里的正确位置。
翻译成人话:如果你已经有一个针对这个任务精心调过的传统模型,基础模型大概率打不过它。 基础模型的价值不在"更强",在于它让你在还没有专用模型的时候就能有个不错的起点。
作者自己给的结论也很克制:这类模型**"虽然仍处于早期",在噪声大、数据受限的任务上有实质前景,但要达到有竞争力的水平,很可能需要针对金融时序特性做领域专门的预训练和架构改造。**
这就是一个成年人的结论:不是"没用",也不是"颠覆",而是**"在特定生态位上有用,而且现成的通用版本还不够,需要为金融重做。"**
结论四:多变量确实有用,但"喂什么"极度挑食
2026 年有篇用 Chronos-2 做的研究,在两个面板上做了 2000–2025 年的滚动月度评估:"七巨头"科技股和美国国债利率。
结论有两层,两层都重要:
第一层(好消息):多变量输入稳定优于单变量。 在所有数据集上都成立,利率上的提升尤其明显,股票上也有实质改善。而且多变量输入下误差的离散度更低——不只是平均更准,是更稳定。
第二层(关键的坏消息):把股票和利率两个市场的序列混在一起喂,预测精度反而下降。 论文的原话是:加入噪声上下文会损害模型表现。
这一层比第一层重要得多。
因为它直接否掉了一个很多人的直觉:既然多变量有用,那我把能拿到的所有数据都塞进去总没错吧?错。 无关的序列不是"多一点信息",它是噪声,会主动伤害你。
这个发现和 Sirignano-Cont 那篇(2018)遥相呼应。那篇说"把所有股票汇总训练更好",这篇说"把股票和利率混着训练更差"。两者不矛盾——前者混的是同质的东西(都是股票的订单簿),后者混的是异质的东西(股票和利率)。
汇总数据的收益,取决于你汇总的东西是不是同一个数据生成过程。 这是个很深的点,也是实践中最容易搞错的地方。
还有个更根本的问题:语言模型架构本身有没有用?
2024 年有篇论文,标题就是暴击:《语言模型对时间序列预测真的有用吗?》
他们对三个当时流行的"基于 LLM 的时序预测方法"做了消融实验(就是把某个部件拿掉,看结果会不会变差)。发现是:
把 LLM 部件整个删掉,或者换成一个最基础的注意力层,预测效果不会变差——大多数情况下甚至更好。
而且:尽管计算成本高昂,预训练的 LLM 表现并不比从头训练的模型好,它们并不能表示时序数据里的顺序依赖关系,在小样本场景下也帮不上忙。
他们进一步发现:patching(把时序切成片段)和注意力结构,本身就能达到和那些 LLM 预测器差不多的效果。
翻译成人话:真正起作用的是"把序列切片"这个朴素的技术动作,不是那个大模型。
我把这篇放在这里,是想说明一个更普遍的现象:在时序预测这个领域,"看起来是大模型带来的提升",经常追查下去是某个不起眼的预处理技巧带来的。 而在金融数据这种信噪比极低的场景里,这种张冠李戴会更严重。
时序大模型这一节,我的最终判断
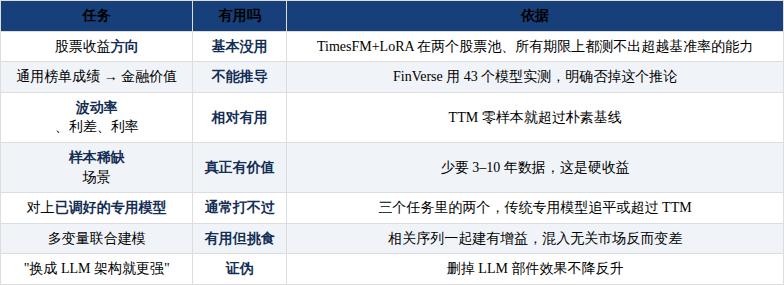
一句话:把它当成一个"省数据的预训练特征提取器",它是有价值的工具;把它当成"能预测股价的黑箱",你会亏钱。
第②层和第⑤层:几个真正被低估的东西
前面把图模型和订单簿讲透了,也把基础模型的账算清了。这一节我补几个很少被讨论但实盘价值很高的模型族。
直接优化夏普比:绕过预测这一步
这是我个人认为最被低估的一类思路。
正常流程是两步走:先预测收益 → 再根据预测构建组合。 问题在于这两步的目标不一致。你的模型在优化预测误差,但你的钱在乎的是夏普比。 这两个目标经常打架。
牛津那批人(Zhang、Zohren、Roberts)2020 年做的 Deep Learning for Portfolio Optimization 干脆把预测这一步删了:网络直接输出组合权重,损失函数就是夏普比的负数。
他们的做法很务实——不选个股,直接交易各大类资产的 ETF。 论文里给的理由是:不同资产类别的指数之间相关性稳健,交易它们大幅缩小了可选资产的范围。
测试期是 2011 年到 2020 年 4 月底,包含了 2020 年一季度的市场动荡。而且他们做了敏感度分析,并且在不同成本率和不同风险水平下测了表现。
这个思路为什么重要? 因为它在结构上消除了一个巨大的失配。当你的损失函数就是你真正关心的目标时,你就不需要祈祷"预测更准会带来更高夏普"这件事成立——而它经常不成立。
深度动量:一个把成本写进训练的漂亮例子
同一批人 2019 年的 Deep Momentum Networks。
背景:时序动量(trend following)是 CTA 行业的立身之本,但传统做法要人工指定两样东西——用什么估计趋势,以及仓位怎么定。
他们的做法是让网络同时学这两件事,并且直接以夏普比为优化目标。
结果:在 88 个连续期货合约上回测,不计交易成本时,夏普优化的 LSTM 把传统方法提升了两倍以上;计入 2–3 个基点的成本后仍然占优。
注意这个"2–3 个基点"。 这才是负责任的报告方式——不是给一个无成本的漂亮数字了事,而是明确告诉你优势在多大的成本下会消失。
更值得学的是他们的下一个动作:为了适应流动性更差的资产,他们加了一个换手率正则项,让网络在训练时就把成本考虑进去。
这就是产业级和学术级思维的分界线。 学术做法是先训模型再抱怨成本太高;产业做法是把成本作为约束写进训练目标,让模型自己学会"这个信号虽然对,但不值得为它付这么多手续费"。
他们后来的 Momentum Transformer(2021)在这条线上又走了一步:注意力机制让模型能直接连到所有历史时刻,在计入交易成本后表现更好,而且能自然适应新的市场状态(论文特别提到 2020 年疫情期间)。多头注意力可以捕捉不同时间尺度上并发的市场状态。而且它本身是可解释的——你能看出哪些因子在什么时候重要。
时空动量:一个"简单打败复杂"的案例
2023 年 Spatio-Temporal Momentum 这篇的结论特别值得放进来。
他们把时序动量和截面动量统一起来(前者是"这个资产自己在涨吗",后者是"这个资产比别人涨得多吗"),然后用不同复杂度的神经网络去建模。
结论是:一个只有单个全连接层的简单网络,就能同时为组合里所有资产生成交易信号。
在 46 只活跃美股和 12 个股指期货上回测,在高达 5–10 个基点的交易成本下仍然保持对基准的优势。 而且他们发现:配上 LASSO(绝对值收缩)和换手率正则化后,在各种成本情景下表现最好。
一个单层网络,加上正确的正则化,在 10 个基点的成本下还能打。 这个结果比任何"我们用了 XX 层 Transformer"都更有说服力。
Deep Hedging:深度学习在金融里最扎实的落地
2018 年 Bühler、Gonon、Teichmann、Wood 的 Deep Hedging。作者里 Ben Wood 是 JP Morgan 系的,这不是纯学术玩具。
它解决的问题非常具体:在有交易成本、市场冲击、流动性约束、风险限额的真实环境下,怎么对冲一个衍生品组合。
传统的 Black-Scholes delta 对冲假设无摩擦、连续交易。真实世界里这些假设全都不成立。Deep Hedging 的做法是把对冲当成一个序列决策问题,用强化学习去解,而且能处理凸风险度量这类非线性的目标函数。
为什么这一类工作最容易落地? 因为它的成功标准是明确的、可测的——对冲误差降低了多少。 不像收益预测那样,你永远搞不清是模型有本事还是运气好。
后续这条线一直在往产业方向走:把市场冲击建进去、用二阶优化加速训练、加不确定性量化(这篇的动机写得很实在:深度对冲给出的对冲比率没有任何置信度度量,这是落地的重大障碍)。
"我不知道我什么时候不知道",这是所有黑箱模型在实盘里最危险的地方。
那些学术很热、金融证据很薄的
我把这些放在一起说,是为了给你一个坐标:
- Mamba / 状态空间模型:2024 年后一堆 FinMamba、Graph-Mamba、MaGNet 之类的工作。理论上很吸引人(线性复杂度处理长序列),但我没有找到任何顶级机构实盘使用的公开证据。而且金融序列本来就不长——你要几千步的上下文干什么?
- KAN(Kolmogorov-Arnold 网络):2024 年火过一阵,有做 VIX 预测、做股票预测的。有意思的一点是有篇 2024 年的工作把 KAN 和 gMLP 混起来做大规模金融表格数据,标题叫 Beyond Tree Models——这个标题本身就说明了树模型在这个领域是那座要翻的山。
- PatchTST / iTransformer / N-BEATS:在通用时序基准上都很强。但注意 2022 年那篇《Transformer 对时序预测真的有效吗?》——它用一个简单的线性模型打败了一堆 Transformer。这篇论文在通用时序领域引发的反思,在金融领域应该加倍适用,因为金融的信噪比更低。
- TabNet:Qlib 榜单上 Alpha360 亏 3.69%,Alpha158 上 2.27%(倒数)。但九坤赛第一名的方案里它是融合成分之一。说明它作为集成的多样性来源有价值,单独用不行。
一条时间线:产业到底按什么顺序采纳这些东西
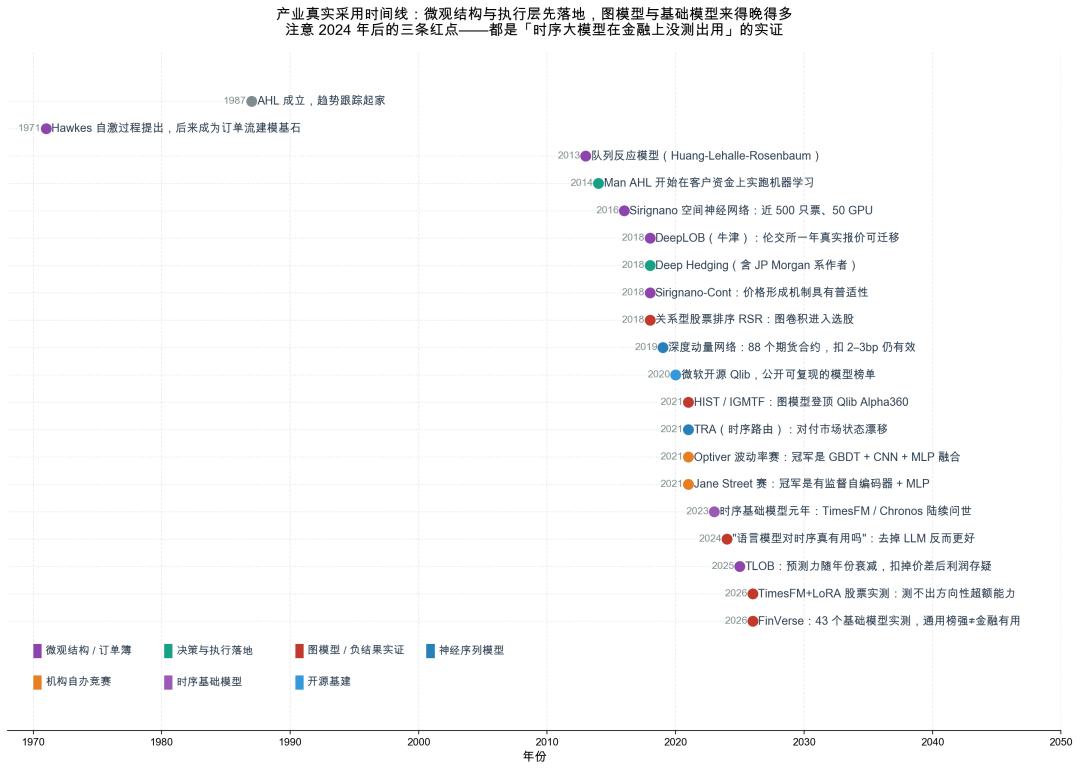
这张图在说什么:把前面所有证据按年份排开。你会看到一个很清楚的模式——
紫色(微观结构)和青绿(决策执行)出现得最早、最密集。 Hawkes 过程、队列反应模型、Sirignano 的空间网络、DeepLOB、Deep Hedging——这些都是 2013–2018 年间的事,而且都有真实数据支撑。
红色(图模型)来得晚,2018 年 RSR 才把图卷积引入选股,2021 年 HIST/IGMTF 登顶 Qlib。
紫红色(时序基础模型)最晚,2023 年才开始。 而紧跟着它的三个红点全是负结果:2024 年"删掉 LLM 效果更好"、2026 年"TimesFM 测不出方向性能力"、2026 年"43 个模型实测,通用榜强≠金融有用"。
这个时间顺序本身就是答案。 一项技术从提出到在实盘站住脚,通常要五到十年,而且必须在这期间通过"扣掉成本还赚钱"的检验。时序基础模型现在才三年,它还没走完这段路,而目前的中间结果并不乐观。
顺便说一句:2020 年微软开源 Qlib 这件事,长期价值可能被低估了。它给这个高度封闭的行业提供了一个统一、可复现的公开评测基准。在此之前,各说各话是常态。
机构真实在做什么:能查到的和查不到的
这一节我要特别小心,因为这是全篇最容易编故事的地方。 我只写有公开出处的,查不到的我就说查不到。
Man AHL:有明确时间点的机器学习实盘
Man AHL 是 1987 年成立的系统化交易公司(趋势跟踪起家),是 Man Group 旗下的量化引擎。有一份 Pure Storage 的客户案例研究里,有几个很具体的事实:
- "机器学习技术是量化投资策略中一个不断演进的领域,Man AHL 自 2014 年起就在客户项目中积极应用这些技术。" —— 这是一个有明确年份的、机构自己承认的实盘时间点
- 团队构成:约 50 名量化研究员,加上 60 多名技术人员,后者既开发量化研究平台,也负责把量化想法转成能被计算机执行的交易策略
- 案例研究里 Man Group Alpha Technology 的 CTO 说:"在开发交易模型时,我们需要看大量数据来做实验,筛选各种可能赚钱的想法。只有那些我们有足够信心的模型,才会被放到生产交易环境里。"
- 换存储后的收益是研究迭代速度:某位研究员的 Spark 工作负载吞吐提升了 10 到 20 倍
我为什么要引用一份存储厂商的案例研究? 因为这类文档有个特点:它是为了卖硬件写的,所以里面关于业务流程的描述往往比公关稿更实在。 那个"50 个 quant 配 60 多个技术人员"的比例,比任何"我们重视技术"的表态都有信息量——在顶级量化机构里,工程人员比研究员还多。
这也间接回答了一个常见困惑:为什么学术论文里的好模型很难在机构复现价值? 因为机构的瓶颈从来不是"想不出模型",而是数据基建、回测保真度、迭代速度、上线流程。一个研究员一天能试 5 个想法还是 50 个想法,这个差距比模型架构的差距大得多。
Two Sigma:公开的是"状态识别",不是阿尔法
Two Sigma 在自己官网上公开发表过一篇用**高斯混合模型(GMM)**做市场状态建模的研究,套在他们的 Two Sigma Factor Lens(一套 18 个系统性因子的框架)上,识别出四种不同的市场状态。
注意他们公开的是什么:风险分析和状态识别工具,面向资产配置者。
注意他们没公开什么:任何一条真实在跑的阿尔法信号。
这个取舍是整个行业的通例,也是你阅读所有机构公开材料时应该带着的默认假设:机构公开的都是"能公开的那一层"——通常是风险模型、状态识别、基础设施、开源工具。真正赚钱的信号,一条都不会公开。
所以当你看到某个基金发论文说"我们这个方法很好",合理的推断不是"他们在用这个",而是**"这个已经不是他们最好的东西了"**。
Oxford-Man 研究院:一条有意思的通道
前面反复出现的 Zohren、Roberts、Zhang、Lim、Wood(Kieran)这批人,主要挂靠牛津大学 Oxford-Man 量化金融研究院——这个机构和 Man Group 有深度关联。
这解释了为什么他们的论文比一般学术论文更"产业味":会算 2–3 个基点的成本、会加换手率正则、会关心 IPU 硬件加速、会明确说"在 5–10 个基点成本下仍然有效"。
这批论文是我在全文里引用最多的,因为它们是"学术严谨性"和"产业现实感"结合得最好的一批公开材料。 如果你只想读一批人的工作,我推荐从这里开始。
我查不到的部分,我直接说查不到
- Jane Street、Citadel Securities、HRT、XTX、Tower、Optiver 内部到底用什么架构:查不到。这些机构不发这类论文。他们办 Kaggle 比赛(这是我们能拿到的最好的间接证据),但那是他们愿意公开的那部分问题
- 国内头部私募(幻方、九坤、明汯等)的具体模型:查不到。九坤办过 Kaggle 赛,这是难得的窗口,但同理,那是他们愿意公开的部分
- 任何"某基金用 GAT 实盘赚了多少"的具体数字:查不到,而且如果你在网上看到有人给出这种数字,大概率是编的
这一节的诚实程度,是我判断一篇量化文章可信度的主要标准。 凡是能把各家基金内部模型讲得头头是道的文章,基本可以直接关掉。
八个我认为必须想清楚的问题
这一节是我个人的判断,不是论文结论。我会明确标出来。
一、为什么图模型在这个行业里"讲得通"?
因为它的结构假设对上了一个真实机制。股票之间真的会传导 —— 上游涨了下游会跟,同概念的票会共振,指数成分会被一起买卖。这不是模型的想象,是市场的事实。
对比一下那些讲不通的:Mamba 的卖点是高效处理超长序列,但日频股票你要几千步上下文干什么?架构优势和问题特性没对上,自然就没有超额收益。
我的判断:一个模型能不能在实盘活下来,取决于它的归纳偏置(inductive bias)是否对应了市场的某个真实结构,而不取决于它在通用基准上排第几。
二、为什么 Transformer 在 Alpha360 上会亏钱?
这个我给一个解释框架,但要注意这是我的推断,不是论文结论:
注意力机制的本质是"从长序列里找到最该关注的部分"。这在语言里极其有效,因为语言的长程依赖是真实且强的(一个代词可能指向三段之前的名词)。
但日频股票的量价序列里,长程依赖非常弱,而噪声极强。给一个高容量的注意力模型一堆噪声去自由地"找关联",它一定能找到——找出来的全是过拟合。
而九坤赛第三名的 Transformer 就成功了,因为他把注意力放在股票维度而不是时间维度——那个维度上的关联是真实存在的。同一个架构,用在对的维度上就活,用在错的维度上就死。
三、扣掉成本,还剩多少?
这是我最想让读者带走的一个习惯。TLOB 那篇的实验值得反复看:用平均买卖价差来定义趋势之后,性能显著恶化。
任何不报告成本敏感性的收益数字,我建议默认按无效处理。
反过来,那些明确说了"在 2–3 个基点下仍有效"、"在 5–10 个基点下仍有效"的工作,可信度立刻高一个档次——因为作者显然知道这个数字是会被这么审的。
四、市场在变得更有效,这件事怎么办?
TLOB 实证了可预测性随时间衰减,F1 掉了 6.68。另有 2026 年的工作在讨论"alpha decay"。
我的判断:这不是可以靠换模型解决的问题,这是这个行业的结构性现实。所以真正可持续的竞争优势不在"我有一个更好的模型",而在:
- 数据优势(别人没有的数据)
- 速度优势(同样的信号你先执行)
- 成本优势(同样的信号你的成本更低所以你还有利润)
- 迭代速度优势(别人的信号衰减了要三个月找新的,你三周)
注意最后一条正好对应 Man AHL 那个"50 quant + 60 技术"的配置,以及"Spark 吞吐提升 10–20 倍"的收益。这不是巧合。
五、"模型强"和"能上规模"是两件事
学术论文追求 IC 和夏普,但真实资金还要问:容量多大? 一个在小盘股上 IC 0.08 的信号,可能只能承载两个亿。规模上去后你自己的交易就把阿尔法冲掉了。
Optiver 冠军方案用 KNN 聚合特征而不是 GNN,除了简单,还有一个实战理由:可解释、可监控、出问题能定位。 一个跑在几十亿资金上的模型,"出问题时我能不能三分钟内知道为什么"是硬需求。
六、交叉验证做错了,后面全是白干
八场比赛的冠军几乎人人在用 purged/embargo 交叉验证。这不是学术洁癖,这是血泪教训。
我给个具体的判断标准:如果一个模型的验证集表现明显好于合理预期(比如日频股票 IC 突然到 0.15),第一反应必须是查泄漏,而不是庆祝。 在这个行业里,好得不真实的结果,基本上就是不真实的。
七、集成不是懒惰,是对不确定性的正确态度
八场比赛的冠军几乎全在做融合,还要多种子取平均。为什么?
因为在信噪比这么低的场景里,单个模型的表现里有相当大一部分是随机性。 多种子平均降的是方差,多模型融合降的是模型选择风险。
这也是为什么 Qlib 榜单坚持跑 20 个种子的意义。 你去看它的标准差列,很多模型的年化收益标准差有 2–3 个百分点——这意味着单次跑出来的结果,可以差出一个"这模型很棒"和"这模型不行"的距离。
八、时序基础模型这件事,我的最终立场
我不认为它是骗局,也不认为它会颠覆量化。我认为它会在一个特定生态位上稳定存在:作为样本稀缺场景下的预训练特征提取器。
理由是那个"少要 3–10 年数据"的结果是真实的、可复现的、有明确商业价值的。而"零样本预测股价方向"这条路,目前的公开证据是清晰的否定。
如果你现在要在机构内部立项,我会建议这么定位:不要立"用大模型预测收益"的项目,要立"用预训练模型解决新品种冷启动"的项目。 后者能交付,前者大概率交付不了。
而且要提前跟老板说清楚一件事:它不会替换掉你现有那些已经调好的专用模型——那篇 TTM 论文里三个任务有两个是传统专用模型追平或胜出。它是给你"还没有专用模型的那些地方"用的。
如果你要动手:一份我自己会用的检查清单
这一节完全是操作性的。如果你要在真实资金上跑这些模型,我建议按这个顺序检查。
第一步:先看你的输入形态,再选模型
- 输入是人工设计好的因子表(每行一个股票-日期,列是特征)?→ 先跑 LightGBM。 这是基线,也可能就是终点。Qlib 榜单上 Alpha158 的前三名是 DoubleEnsemble(树)、LightGBM、MLP
- 输入是原始量价序列?→ 这时候序列结构模型才有意义。GRU 起步,然后试 GATs / HIST 这类能建模截面关系的
- 输入是订单簿快照?→ DeepLOB 系的 CNN+LSTM 是经过真实数据验证的起点
- 别跳过基线。 我见过太多项目直接上最花哨的架构,跑了三个月才发现打不过 LightGBM
第二步:把交叉验证做对,这一步做错后面全废
- 必须用 purged + embargo 的时序交叉验证
- 间隔(gap)要大于你标签的预测期限。标签是未来 5 天收益,间隔至少 5 天,Jane Street 冠军用的是 31 天
- 绝对不要用随机 K 折
- 验证集表现好得离谱时,先查泄漏
第三步:建立诚实的基线,尤其是"什么都不做"
这条是从那篇 TimesFM 论文学来的,我认为极其重要:
- 永远猜涨(在上涨市场里这条能到 70%)
- 随机漫步、持续性(用上一期值当预测)、AR(1)
- 你的模型必须打赢这些,打赢一个弱神经网络不算什么
第四步:把成本写进目标函数,不是事后再算
- 训练时就加换手率正则(深度动量那篇的做法)
- 报告结果时给成本敏感性曲线:0bp / 2bp / 5bp / 10bp 各是什么表现
- 用买卖价差来定义你的标签阈值(TLOB 的做法)——涨幅小于价差的,根本不该算成信号
第五步:多种子,多模型
- 至少 5–10 个随机种子,报告均值和标准差
- 单次结果不要当结论看
- 融合树模型和神经网络,它们的错误模式不一样
第六步:问容量问题
- 这个信号在多大资金上还成立?
- 换手率多少?年化换手 20 倍的信号,成本会吃掉一切
- 集中在小盘股上的阿尔法,通常上不了规模
第七步:问"我什么时候会不知道"
- 模型给出预测时,有置信度吗?(这正是"不确定性感知深度对冲"那篇要解决的问题)
- 市场状态切换时,模型会怎么表现?
- 出问题时,你能在多久内定位到原因?
冷静清单:这篇报告的边界
我把自己的局限也列出来,这是我认为一篇负责任的报告必须做的。
关于证据强度的分级,我在文中尽量做了区分,这里明确一下:
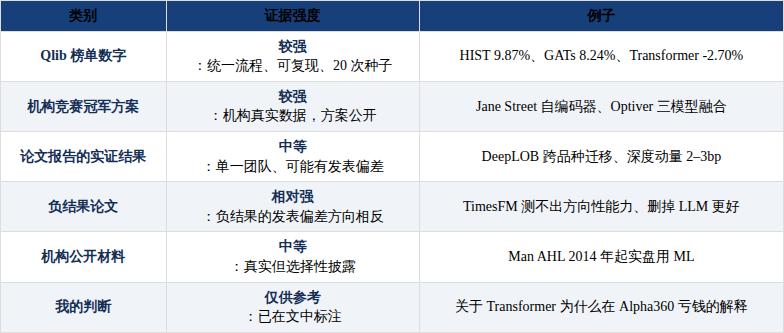
具体的局限:
- Qlib 榜单是回测,不是实盘。 没有真实成交冲击、没有容量约束、没有借券成本。官方自己声明了实现和调参资源有限
- Qlib 榜单只覆盖单一市场(A 股)、单一频率(日频)、主要是 CSI300 池。 CSI500 的结果不完整。换市场结论可能变
- Kaggle 竞赛和实盘有本质区别:可反复提交试探测试集、无成本、无容量约束
- 我无法获取任何机构的内部模型信息。 全文所有关于机构的陈述,都限于公开可查的材料
- 本文没有做任何独立的实证复现。 所有数字都来自引用源,我没有自己跑过这些模型
- 图表说明:本文八张图全部是我根据引用源的数据自绘。Qlib 那两张的每个数字都来自官方 README;时间线和分层图是我对证据的归纳与整理,其中的分类和判断包含我的主观取舍
- 时序基础模型这个领域进展极快。 本文引用的最新证据到 2026 年 8 月,半年后结论可能需要更新
一个必须说明的口径问题:本文出现的 IC 数字来自不同场景,互相之间不可直接比较。Qlib 榜单是 A 股日频截面 IC,AQuA 论文的 0.19 是加密货币 5 分钟组合信号 IC。把它们放在一起排名是错的,我在文中只把它们用于建立数量级直觉。
结尾:我真正想说的一件事
写到这里,我想把这篇报告压缩成一句话。
这个行业里,模型的价值不来自它有多复杂,而来自它的结构假设是否对上了市场的某个真实机制。
- 图模型赢,因为股票之间真的会传导
- DeepLOB 赢,因为订单簿真的有空间结构
- Hawkes 过程能活四十年,因为订单流真的会聚集
- 直接优化夏普比的网络有价值,因为你真正在乎的确实是夏普比而不是 MSE
- Deep Hedging 能落地,因为对冲误差真的可以被清晰地衡量
而那些主要靠"更大、更深、更新"的东西,在这个信噪比极低、成本极高、且竞争对手都在同时变聪明的市场里,通常撑不过成本这道关。
时序基础模型现在正站在这道关前面。它在"省数据"这件事上已经交出了真实的成绩;在"预测股价方向"这件事上,目前的公开证据是清楚的否定。这两件事都可能变,但今天要下注,我知道该往哪边下。
最后留一个我自己常用的自省问题,送给正在做这件事的你:
如果我的模型明天失效了,我能不能在一周内说清它为什么失效?
如果答案是不能,那么它今天赚钱,很可能只是运气好而已。
参考文献与出处
基准与榜单
- Qlib 官方基准榜单 — 本文所有 Alpha158/Alpha360 数字的唯一来源,每个数字为 20 次不同随机种子的均值±标准差:https://github.com/microsoft/qlib/blob/main/examples/benchmarks/README.md
- Qlib 主仓库:https://github.com/microsoft/qlib
- GIFT-Eval:通用时序预测基准,23 个数据集、14.4 万条序列、1.77 亿数据点,分析了 17 个基线 — https://arxiv.org/abs/2410.10393
- fev-bench:强调多变量与协变量场景的时序基准 — https://arxiv.org/abs/2509.26468
- FinVerse:金融领域时序基准,11.69 万条序列、1.711 亿观测,11 个指标族 78 个指标,实测 43 个基础模型 — https://arxiv.org/abs/2608.03259
图模型 / 截面关系
- GAT(图注意力网络),Veličković 等,2017 — Qlib 榜单中 GATs 的原始架构:https://arxiv.org/abs/1710.10903
- HIST:概念导向共享信息的图框架,Qlib Alpha360 榜首 — https://arxiv.org/abs/2110.13716
- RSR / 时序关系排序(Feng 等,2018):把图卷积引入股票排序,提出 Temporal Graph Convolution — https://arxiv.org/abs/1809.09441
- 图 Transformer 做多元已实现波动率预测(约 500 只标普成分股)— https://arxiv.org/abs/2112.09015
- 前后领先关系检测与网络聚类(美股市场)— https://arxiv.org/abs/2201.08283
- 跨资产类别的网络动量 — https://arxiv.org/abs/2308.11294
订单簿 / 微观结构
- Deep Learning for Limit Order Books(Sirignano,2016):空间神经网络,近 500 只股票,50 GPU 集群 — https://arxiv.org/abs/1601.01987
- Universal features of price formation(Sirignano & Cont,2018):数十亿条报价,普适模型超过个股专用模型 — https://arxiv.org/abs/1803.06917
- DeepLOB(Zhang、Zohren、Roberts,2018):CNN+LSTM,伦交所一年真实报价,跨品种可迁移 — https://arxiv.org/abs/1808.03668
- 多期限订单簿预测 + IPU 硬件加速(Zhang & Zohren,2021)— https://arxiv.org/abs/2105.10430
- TLOB(2025):简单 MLP 即超 SOTA;可预测性随时间衰减 F1 -6.68;用价差定义趋势后性能显著恶化 — https://arxiv.org/abs/2502.15757
- 队列反应模型(Huang、Lehalle、Rosenbaum,2013)— https://arxiv.org/abs/1312.0563
- 订单流的队列反应 Hawkes 模型 — https://arxiv.org/abs/1901.08938
- Transformers for Limit Order Books — https://arxiv.org/abs/2003.00130
时序基础模型(含关键负结果)
- TimesFM(Google):解码器结构时序基础模型 — https://arxiv.org/abs/2310.10688
- Chronos(Amazon):把时序量化成词表,用语言模型架构训练 — https://arxiv.org/abs/2403.07815
- Chronos-2:支持多变量与协变量的零样本预测 — https://arxiv.org/abs/2510.15821
- Moirai(Salesforce):LOTSA 语料,超 270 亿观测点,横跨九个领域 — https://arxiv.org/abs/2402.02592
- Tiny Time Mixers (TTM)(IBM)— https://arxiv.org/abs/2401.03955
- Toto 2.0:时序基础模型的规模化研究 — https://arxiv.org/abs/2605.20119
- ⚠️ 关键负结果:TimesFM + LoRA 股票实测(2026):基准率陷阱、任何期限测不出方向性超额能力、分行业微调显著更差(DM 检验 p<0.001)— https://arxiv.org/abs/2607.12248
- ⚠️ 关键负结果:语言模型对时序预测真的有用吗?(2024):删掉 LLM 部件效果不降反升 — https://arxiv.org/abs/2406.16964
- TSFM 在多元金融时序上的评估(2025):TTM 少要 3–10 年数据,零样本超朴素基线 — https://arxiv.org/abs/2507.07296
- 用 Chronos-2 做多元金融预测(2026):多变量优于单变量,但混入无关市场反而变差 — https://arxiv.org/abs/2605.21504
- FinCast:金融领域专用基础模型 — https://arxiv.org/abs/2508.19609
- ⚠️ 通用时序架构的反思:Transformer 对时序预测真的有效吗?(2022):简单线性模型打败一堆 Transformer — https://arxiv.org/abs/2205.13504
端到端决策 / 成本感知
- Deep Hedging(Bühler、Gonon、Teichmann、Wood,2018)— https://arxiv.org/abs/1802.03042
- 不确定性感知的深度对冲(2026):明确指出缺少置信度是落地的重大障碍 — https://arxiv.org/abs/2603.10137
- 深度对冲 + 市场冲击 — https://arxiv.org/abs/2402.13326
- Deep Momentum Networks(2019):88 个期货合约,无成本时提升两倍以上,2–3bp 下仍占优,换手率正则 — https://arxiv.org/abs/1904.04912
- Momentum Transformer(2021):计入成本后表现更好,自然适应新市场状态,本身可解释 — https://arxiv.org/abs/2112.08534
- Spatio-Temporal Momentum(2023):单层网络在 5–10bp 成本下仍占优 — https://arxiv.org/abs/2302.10175
- Deep Learning for Portfolio Optimization(2020):直接优化夏普比,测试期含 2020 年一季度 — https://arxiv.org/abs/2005.13665
- Deep Reinforcement Learning for Trading(2019):50 个最活跃期货合约,2011–2019 — https://arxiv.org/abs/1911.10107
表格数据上的树模型 vs 深度学习
- Neural Oblivious Decision Ensembles (NODE):明确指出没有充分证据表明深度学习能超过 GBDT — https://arxiv.org/abs/1909.06312
- Tabular Data: Is Deep Learning all you need? — https://arxiv.org/abs/2402.03970
- 跨多样表格数据集的机器与深度学习综合基准 — https://arxiv.org/abs/2408.14817
- Beyond Tree Models:KAN + gMLP 用于大规模金融表格数据 — https://arxiv.org/abs/2412.02097
机构自办竞赛(冠军方案)
- Kaggle 金融竞赛方案汇总(本文竞赛部分细节的主要来源):https://zizouhe.github.io/reading-notes/notes/kaggle-fin.html
- Jane Street Market Prediction:https://www.kaggle.com/competitions/jane-street-market-prediction
- Jane Street Real-Time Market Data Forecasting:https://www.kaggle.com/competitions/jane-street-real-time-market-data-forecasting
- Optiver Realized Volatility Prediction:https://www.kaggle.com/competitions/optiver-realized-volatility-prediction
- Optiver Trading at the Close:https://www.kaggle.com/competitions/optiver-trading-at-the-close
- Ubiquant(九坤)Market Prediction:https://www.kaggle.com/competitions/ubiquant-market-prediction
- G-Research Crypto Forecasting:https://www.kaggle.com/competitions/g-research-crypto-forecasting
机构公开材料
- Man AHL 案例研究(含"自 2014 年起在客户项目中应用机器学习"、约 50 名 quant + 60 余名技术人员、Spark 吞吐提升 10–20 倍):https://www.everpuredata.com/content/dam/pdf/en/case-studies/cs-man-ahl.pdf
- Man AHL 官方介绍:https://www.man.com/ahl
- Man Group 机器学习入门:https://www.man.com/insights/intro-machine-learning
- Two Sigma:用机器学习做市场状态建模(高斯混合模型 + 因子框架):https://www.twosigma.com/articles/a-machine-learning-approach-to-regime-modeling/
方法论必读
- Marcos López de Prado,《Advances in Financial Machine Learning》 — Purged / Embargo 交叉验证、组合净化交叉验证的出处。本文提到的八场竞赛冠军几乎人人在用这套方法
- Time Series Forecasting With Deep Learning: A Survey(Lim & Zohren,2020)— https://arxiv.org/abs/2004.13408
- Temporal Fusion Transformers(Lim 等,Qlib 榜单中 TFT 的原始架构)— https://arxiv.org/abs/1912.09363
本文所有数字均来自上述公开来源,未做任何独立复现。文中标注"我的判断"的部分为作者观点,不构成投资建议。