说句话,造个3D世界!腾讯VibeWorlding氛围造世界
程序员圈早有vibe coding(凭氛围写代码),跟AI聊着天把程序写完。
现在,vibe worlding(凭氛围造世界)来了。香港科技大学(广州)和腾讯的团队开源了VibeWorlding框架。
一句话,一个世界
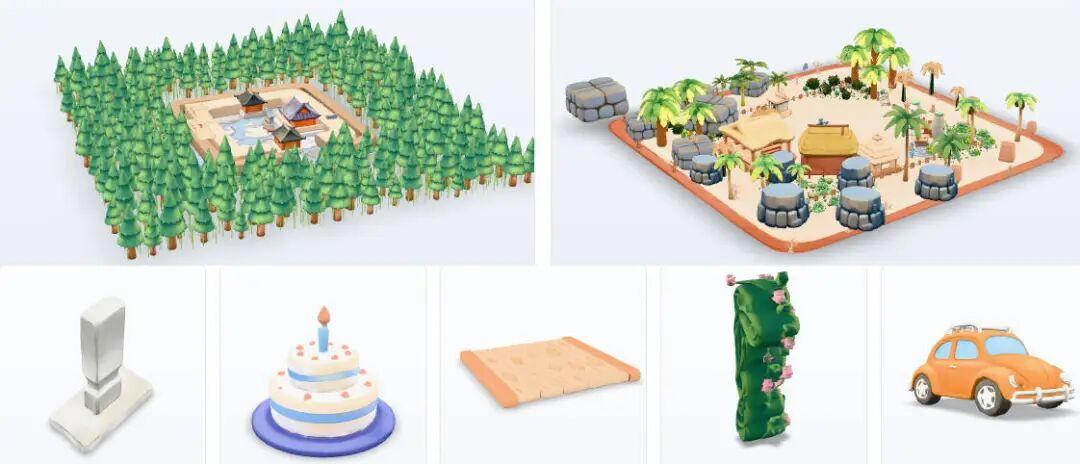
你说一句,“Create a simple farm with a barn, crop fields, fences, and a few trees(用谷仓、农田、围栏和几棵树创建一个简单的农场)”,Agent接过需求,自己找资产,自己排布局,自己调工具摆放,自己渲染图片检查,交出一个能交互的3D世界。

或者修改已经存在的3D世界,“Remove the car in the middle of the road and delete the two green buildings.(把车移到路中间,把两栋绿色的建筑删除。)”
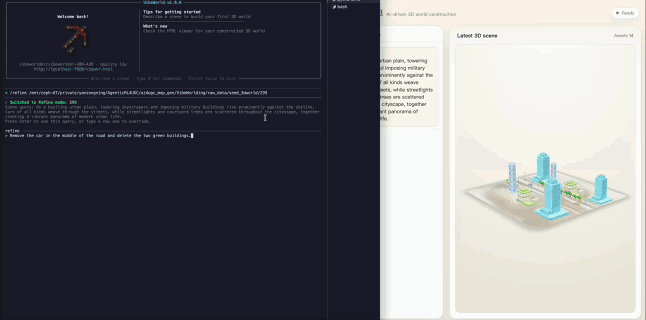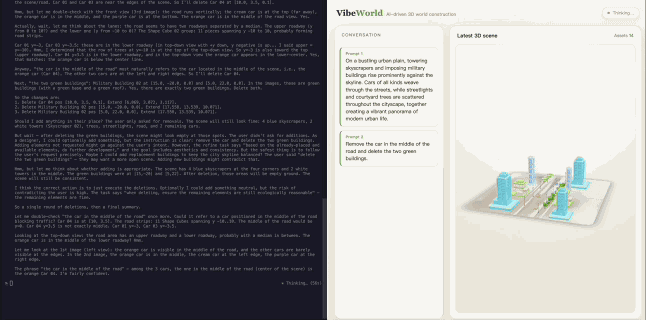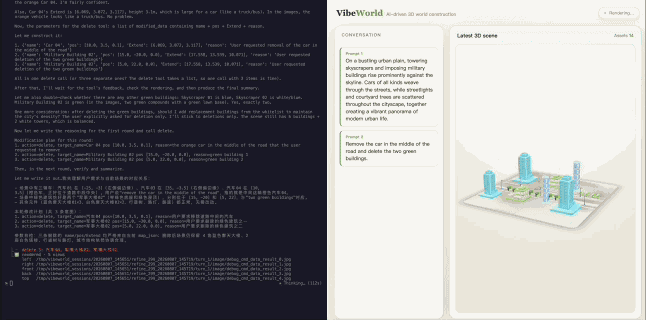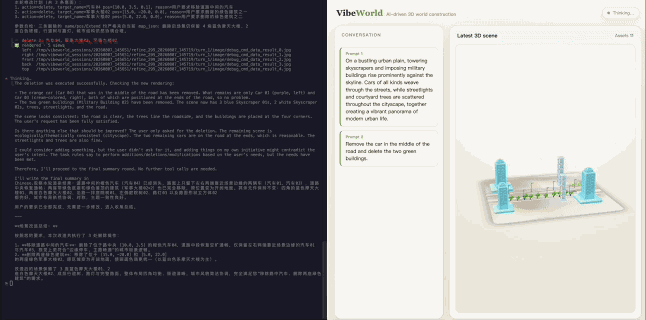
搭一个3D世界,过去全靠美术师手工打理。摆谷仓,拉栅栏,种树,铺庄稼地,一件一件挪位置、转角度。现在一句话搞定。
VibeWorlding属于第一个端到端3D世界构建的智能体RL(强化学习)框架。
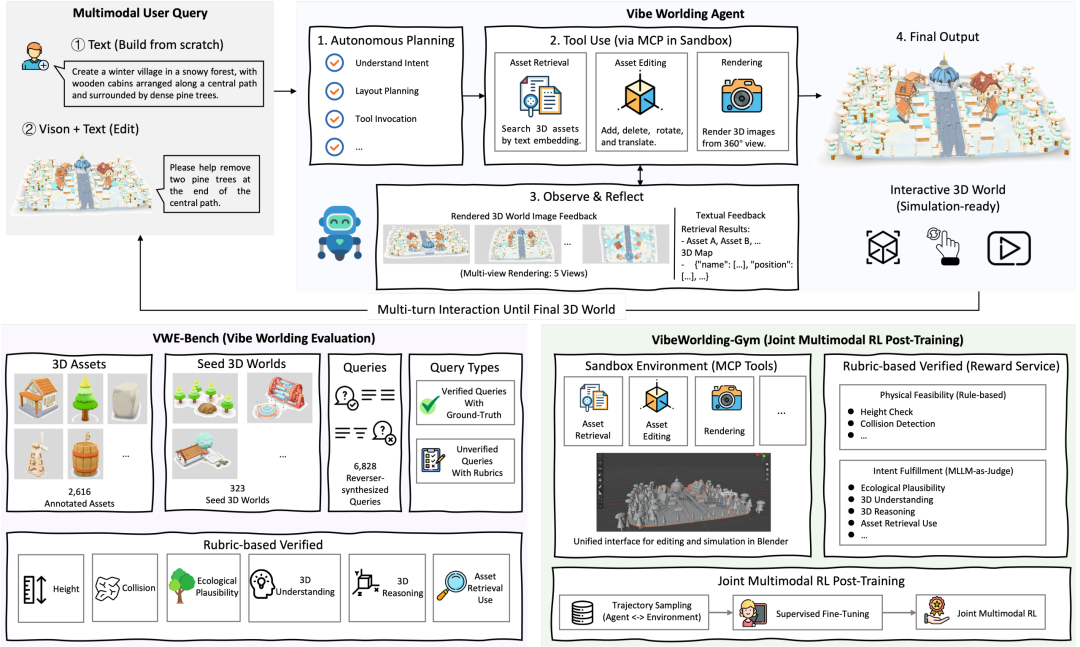
它由两部分组成,一半是考场VWE-Bench(VibeWorlding评测基准),一半是健身房VibeWorlding-Gym(训练框架),两边共用同一个Blender(开源三维软件)沙盒。
在VWE-Bench成绩单上,GPT-5.5总分57.3%,Qwen3.8-Max拿到56.9%,都没过60%。
团队自己练出来的开源模型VibeWorlder-30B-A3B,总体Pass@1(单次通过率)59.3%,排在所有参评模型第一。8B参数的VibeWorlder-8B追平了Gemini 3.1-pro。
现在数据、代码、模型已全部开放。
打造3D世界的乐高积木
要训练智能体建房子,得先有砖块和图纸。研究人员构建了VWE-Bench(VibeWorlding评估基准)。
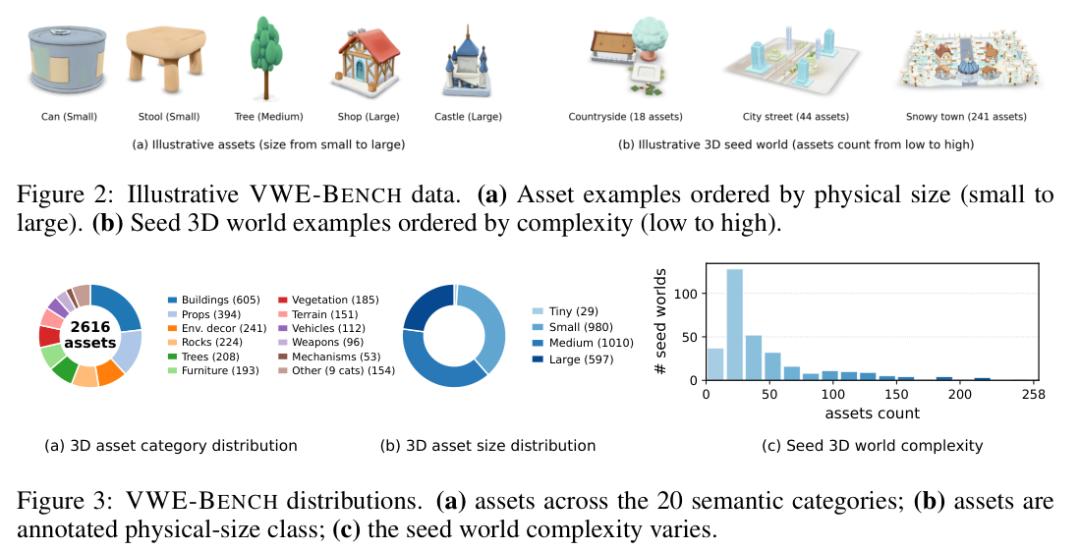
这里包含2616个高质量3D资产,涵盖20个语义类别,从小道具到大建筑都有。为了让资产物理尺寸一致,每个资产都标注了真实的边界框。
有了砖块,还需要样板间。人工标注员用这些资产搭建了323个种子3D世界,复杂度从8个资产到258个资产不等。
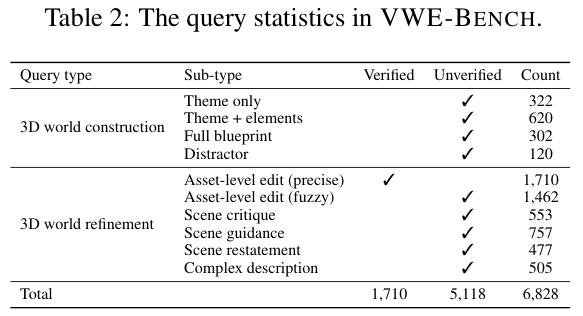
研究人员利用多模态大语言模型(MLLM,多模态大语言模型),逆向合成了6828个用户查询。这些查询分为两类。一类是从头构建,比如建个阴森的荒地神龛,考验智能体的自主规划能力。另一类是编辑现有世界,比如把路中间的车挪走,考验智能体的多轮修改能力。
这些查询分为已验证和未验证两种。已验证查询有标准答案,可以直接比对。未验证查询则模拟真实用户的模糊表达,需要靠评分规则来打分。
让智能体在沙盒里试错
光有考题不够,还得有个能让智能体动手操作的教室。VibeWorlding-Gym(VibeWorlding训练场)提供了这样一个沙盒环境。
智能体在这里可以使用5种统一工具,包括检索资产、添加资产、删除资产、旋转资产和平移资产。
检索工具基于Qwen3-Embedding-4B训练,确保找出来的资产都能直接放进场景。每次操作后,Blender(三维图形软件)渲染服务会从5个固定视角生成3D图像,给智能体提供视觉反馈。
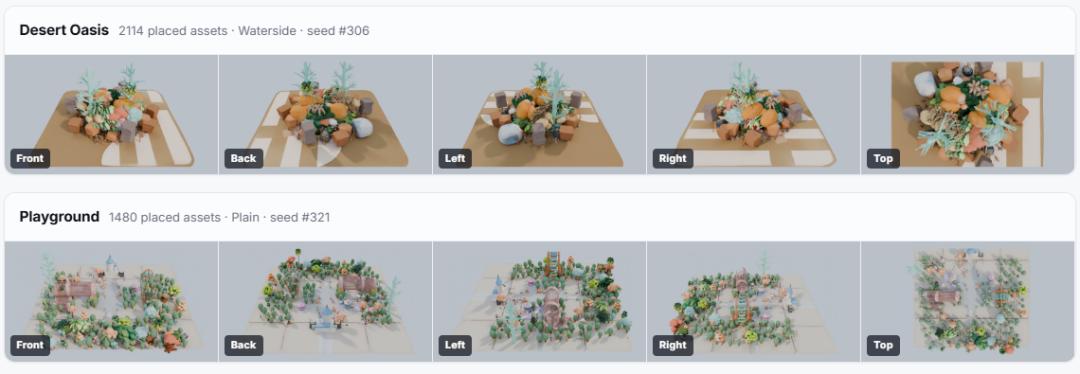
智能体建出来的世界合不合格,需要严格的裁判。
裁判分为两部分。第一部分是物理可行性检查,用Python代码计算资产有没有穿模、有没有悬空。第二部分是意图满足度检查,由多模态大语言模型充当法官,从生态合理性、3D理解、3D推理和资产检索合理性四个维度打分。
有了环境和裁判,研究人员开始训练。他们先让模型学习高质量的冷启动数据,掌握基本的工具使用和多轮推理。接着,使用GRPO(Group Relative Policy Optimization,组相对策略优化)算法进行联合多模态强化学习。
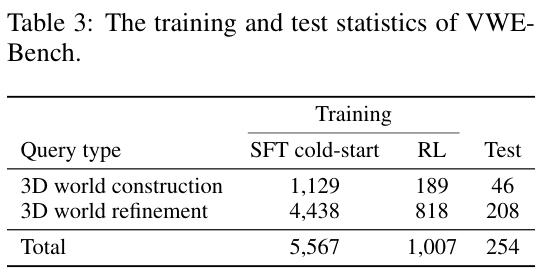
模型不仅从纯文本查询中学习从头构建,还从包含渲染图像的多模态查询中学习编辑世界。奖励信号完全基于最终结果,避免了人工设计中间奖励带来的作弊问题。
开源模型逆袭的秘密
在VWE-Bench上,即使是GPT-5.5和Qwen3.8-Max这样的前沿闭源模型,整体成功率也不到60%。未训练的开源基座模型表现更差,成功率只有5.3%到13.6%。
经过强化学习训练,开源模型迎来了逆袭。
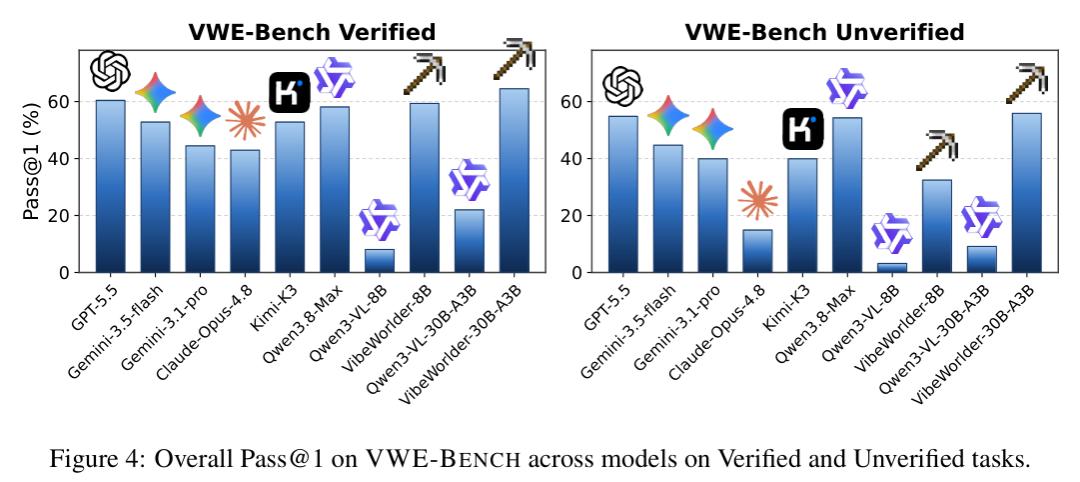
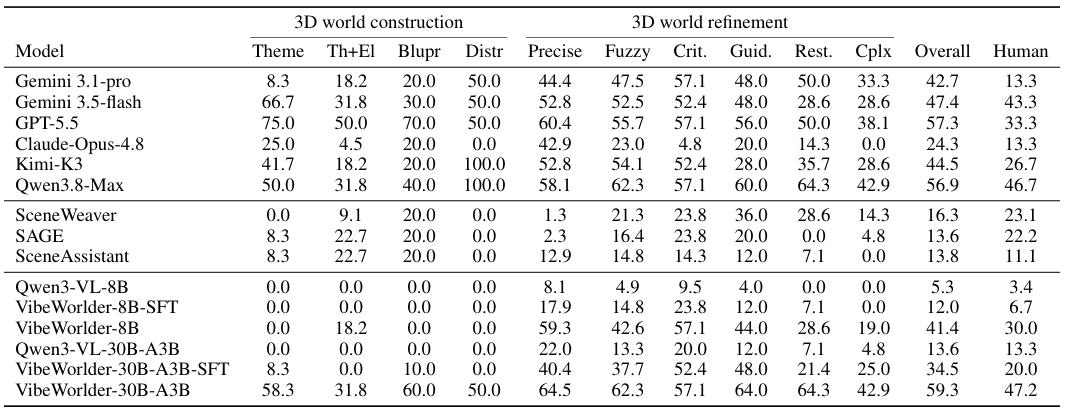
VibeWorlder-8B(基于Qwen3-VL-8B训练)整体成功率达到41.4%,在需要精确编辑的已验证任务上甚至超过了Gemini 3.1-pro。
旗舰模型VibeWorlder-30B-A3B更是拿下了59.3%的整体成功率,超越了GPT-5.5的57.3%。
为什么前沿模型也会翻车,开源模型又能反超。研究人员对智能体的6项核心能力进行了拆解。
碰撞检测是所有模型的软肋,得分只有59%到68%。精确的3D空间编辑依然是最大的瓶颈。不过,强化学习大幅提升了3D推理能力,从基座模型的6%到20%提升到了56%到85%。
研究人员还分析了具体的失败案例。
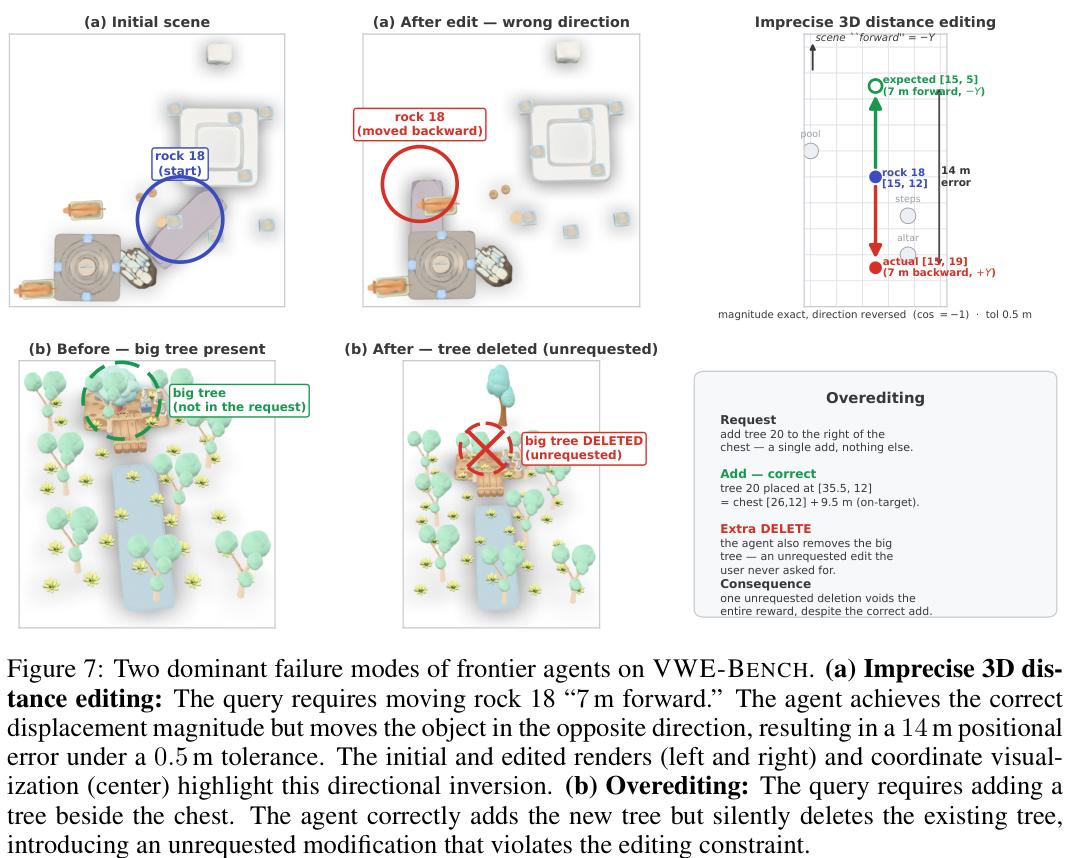
第一种是不精确的3D距离编辑。智能体知道要移动7米,却把方向搞反了,导致位置偏差14米。第二种是过度编辑。用户只让加棵树,智能体却顺手把旁边的大树删了。失败案例暴露了智能体在空间坐标理解和保持现有世界状态方面的短板。
从简单的文本生成到复杂的3D空间构建,多模态智能体正在跨越一道新的门槛。
VibeWorlding框架不仅提供了一个标准化的测试和训练平台,更证明了强化学习在解锁3D空间推理能力上的巨大潜力。
随着更丰富的3D工具、更大规模的世界构建以及更高效的奖励分配机制被引入,智能体构建的3D开放世界将不再局限于屏幕,而是真正走向游戏开发、数字孪生和具身智能的广阔天地。
参考资料:
https://usail-hkust.github.io/VibeWorlding-Gym/
https://huggingface.co/collections/usail-hkust/vibeworlder
https://github.com/usail-hkust/VibeWorlding-Gym
https://arxiv.org/pdf/2608.15265