一文讲透人形机器人 8 个关键能力:感知、抓取、全身控制、平衡、VLA、世界模型、数据、仿真
【从零走向AGI】旨在深入了解通用人工智能(AGI)的发展路径,从最基础的概念起,逐步构建完整的知识体系。
项目地址🔗:https://ai-mzq.github.io/From-Zero-to-AGI/[1]
欢迎关注【魔方AI空间】👇
AIGC技术交流社区(涵盖AI绘画、AI视频、大模型、AI多模态、数字人、具身智能等AIGC干货资源及教程)欢迎大家加入:
「具身智能」交流群 ->>
- 一文讲透2026年具身智能技术栈:VLM、VLA、VLN、世界模型
- 一文梳理 RT-2 到 π0.7:通用机器人策略的技术演进
- 一文通俗讲解具身智能 7 个核心概念:VLM、VLN、VA、VLA、WM、WAM、VLX
- 一文通俗理解机器人数据 8 个核心概念:遥操作、示范学习、动作块、仿真、合成数据、Sim-to-Real、数据飞轮、失败回放
- 一文详解具身智能:从大模型到世界模型
本文聚焦于人形机器人的 8 个关键能力:感知、抓取、全身控制、平衡、VLA、世界模型、数据、仿真,旨在建立一张直观的人形机器人技术能力地图:它如何感知环境、抓取物体、控制全身、保持平衡、理解任务、预测后果,并依靠数据和仿真持续进化。
让一台人形机器人把桌上的红色杯子放进水槽。
它得先看清杯子在哪、杯口朝哪;再判断手指该怎样贴合、要用多大力;弯腰拿杯时还要防止重心前冲;走到水槽前,如果有人经过,它得停下来避让,再重新完成动作。
一段视频 Demo 往往只展示几秒钟的流畅动作。难的是,让机器人把理解转化为连续、稳定、可恢复的物理行动。
在人形机器人身上,感知让它看懂环境,抓取让它接触物体,全身控制与平衡让它稳住身体,VLA 把任务翻译成动作,世界模型预测后果,数据与仿真让系统不断积累经验。
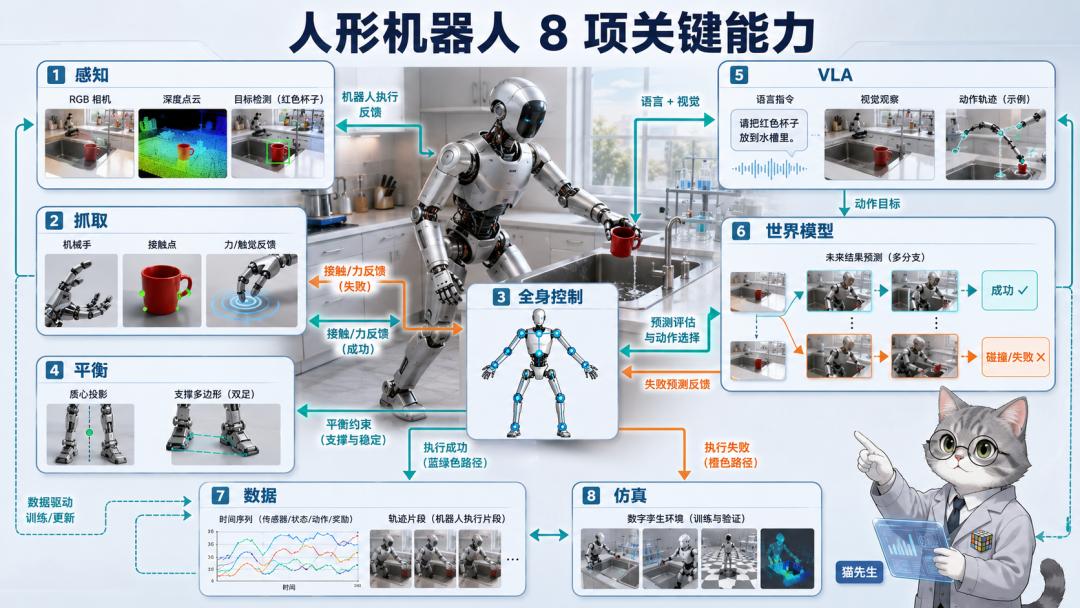
图 1:人形机器人要完成一次真实任务,背后需要感知、抓取、全身控制、平衡、VLA、世界模型、数据和仿真共同工作。
——注:本文部分配图由AI制作,仅供参考
读完这篇文章,你会知道每项能力究竟解决什么问题、为什么它们总是一起出现,以及 VLA、世界模型、数据和仿真为什么正在成为决定机器人进化速度的关键环节。
八大关键能力概览
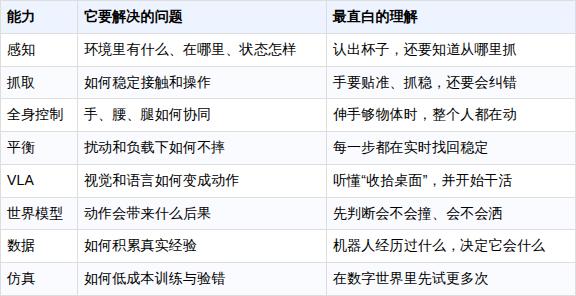
基础能力:感知、抓取、全身控制、平衡。
智能中枢:VLM、VLA、世界模型、任务规划。
工程底座:数据、仿真、后训练、安全约束。
代表工作与系统示例:RT-2、Open X-Embodiment / RT-X、OpenVLA、Octo、π0 / π0.5 / π*0.6 / π0.7、Gemini Robotics、NVIDIA GR00T、Figure Helix、Tesla Optimus、Unitree G1 / H1 / H2、智元远征 A2 / 灵犀 X2 等。
1. 感知:看懂世界,才知道怎样动手
普通视觉模型可以回答“画面里有没有杯子”。机器人还得知道它距离多远、杯里有没有液体、杯壁是否光滑、哪一侧能抓,以及手臂伸过去会不会撞到旁边的盘子。
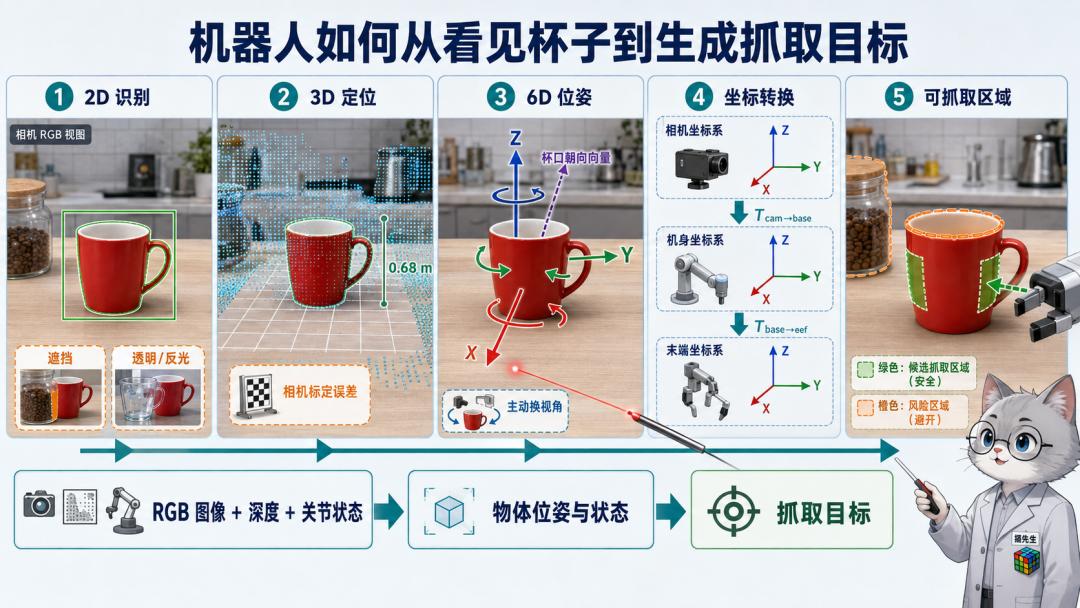
图 2:机器人感知不是只识别杯子,还要把画面中的目标转换成机械手可执行的三维位置、姿态和可抓取区域。
面向行动的感知通常融合 RGB 图像、深度、相机位姿、关节状态和惯性信息。它关注的是三维位置、姿态、可接触区域、遮挡关系,以及门、抽屉、容器这类物体的状态。
机器人也不能只被动接收画面。看不清标签时,它应靠近一点;抓取点不确定时,它应换个视角。主动感知的核心,是让身体移动也服务于信息获取。Gemini Robotics[2] 的公开介绍展示了将多模态理解、空间推理与执行结合的一条路线。
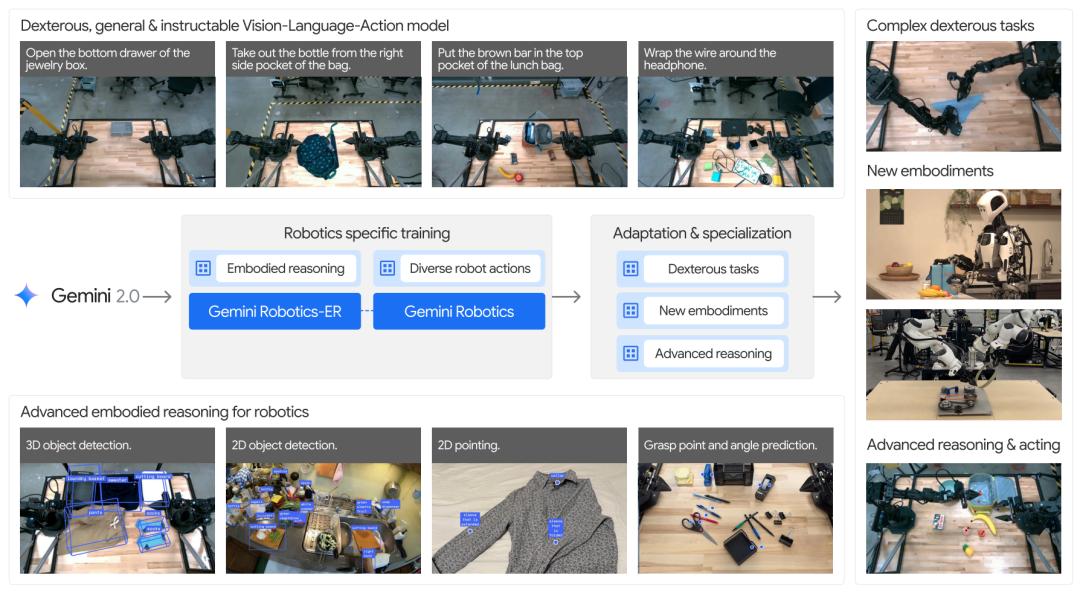
图 3:Gemini Robotics 展示了多模态理解、空间推理和机器人动作之间的连接。图源:Google DeepMind。
一旦感知判断出现错误,那么后面的抓取与规划都会建立在错误前提上:把反光金属罐当成空杯,或误判抽屉的开合状态,都足以让任务失败。
2. 抓取:让手抓稳,而不只是碰到物体
“拿起一个杯子”并不等于机械手闭合。完整过程包含接近、姿态对齐、初次接触、调整接触点、施加合适的力、抬起、搬运和放置;任一步出错,都要能修正。
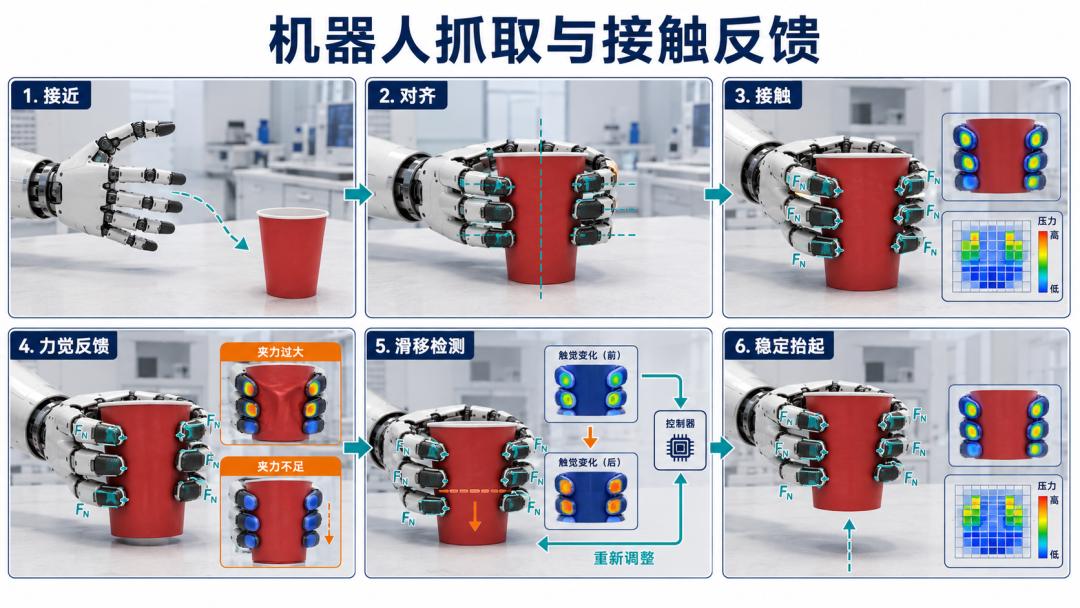
图 4:抓取不是简单合上手指,而是接近、对齐、接触、力觉反馈、滑移检测和重新调整的连续过程。
难点来自真实物体的长尾:透明杯边缘难看清,软包装会变形,湿毛巾形状多变,易碎物又不能大力夹紧。视觉能在接触前缩小不确定性,却很难独自判断是否打滑、夹力是否过大。
触觉和力觉因此越来越重要。它们像机器人手上的第二套眼睛:接触后告诉系统有没有碰到、有没有滑、要不要回退一点。抓取的过程,就是“看见—接触—感受—修正”。
RT-2[3] 将机器人动作表示成 token,并与视觉语言数据共同训练,让大规模预训练中的语义知识帮助机器人理解新对象和新指令。它说明了“看懂任务”如何进入控制,但离散动作 token 不能自动解决灵巧手的连续接触控制。
π0[4] 更强调连续动作:用预训练视觉语言表征理解任务,再由 action expert 通过 flow matching 生成控制动作。前者把语言知识带进机器人,后者试图让手上的动作更平滑。
3. 全身控制:一只手在动,整个人都要配合
桌面机械臂拿杯子时,底座固定。人形机器人去够远处物体,手臂的加速会带动躯干;躯干前倾会改变重心;脚可能还得补半步。手够得到、身体不碰撞、关节不超限、脚又站得稳,这些目标经常同时发生,甚至彼此冲突。
全身控制要做的,就是让手、躯干、双腿和脚底接触围绕同一个任务协作。它涉及逆运动学、轨迹优化、模型预测控制(MPC)、动力学约束与实时反馈;这些传统控制方法仍是人形机器人能够稳定工作的基础。
语言任务 + 视觉上下文
        ↓
VLA / 规划:决定子目标、顺序和动作意图
        ↓
全身控制:协调手臂、躯干、腿部、步态与约束
        ↓
关节级控制:高频跟踪、力控、碰撞保护
高层模型决定“拿哪个、从哪边绕”,全身控制决定“身体怎样做到”,关节级控制器处理毫秒尺度的电机响应。
Figure Helix、NVIDIA GR00T、Gemini Robotics 等公开系统都在探索这种高层智能与低层执行的协同;仅凭 Demo 仍无法推断其完整控制架构。
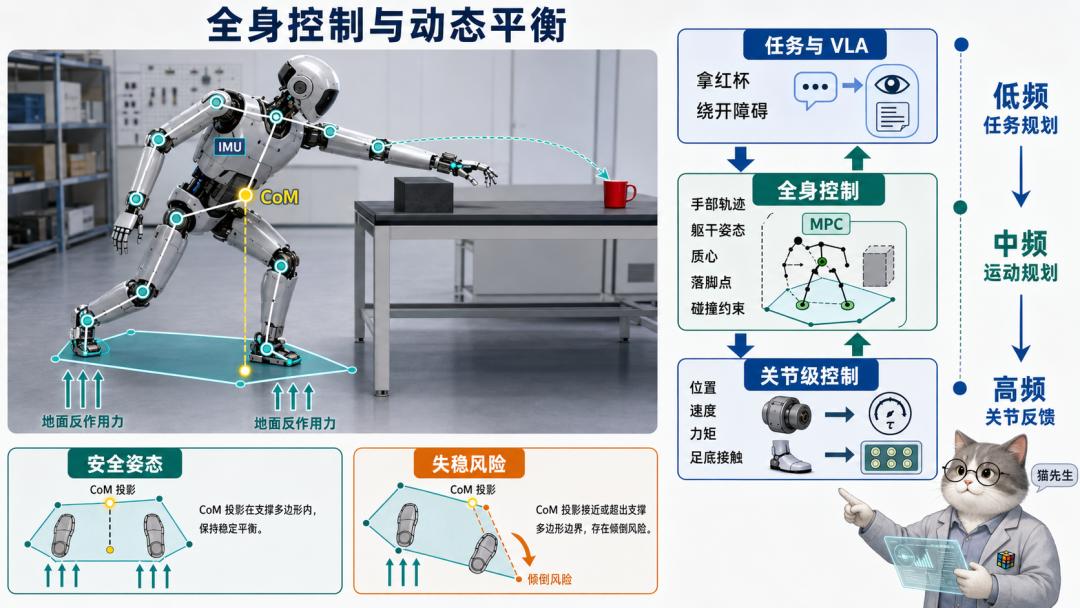
图 5:手臂伸向目标时,躯干、双腿、足底接触和质心都需要同步调整。
4. 平衡:先别摔,才能把活干完
人走路看似自然,本质上却是在持续失衡、持续恢复。人形机器人同样要应对站立、起步、转身、跨障、上下坡和负载变化。脚底一次微小的接触误差,都会传导到整具身体。
平衡依赖 IMU、关节编码器、足底力/力矩传感器和实时控制。视觉可以提前识别台阶、坡度和障碍,却替代不了接触瞬间的快速反应;在毫秒级扰动面前,机器人不能等云端模型慢慢推理。
搬运时问题更突出。箱子前移会改变整体质心;一只手提起重物,躯干可能需要反向补偿;地面摩擦低于预期,步态也必须立刻调整。
评价人形机器人时,更应看它能否在负载、狭窄空间和偶发扰动下持续完成工作,而不只是跑得多快、跳得多高。
5. VLA:把听懂话变成做成事
VLA 把机器人眼前看到的和人说的话,翻译成下一步身体动作。
LLM 主要处理文本,VLM 能关联图像与文本,VLA 再向前一步:输入视觉、语言与机器人状态,输出动作或动作序列。
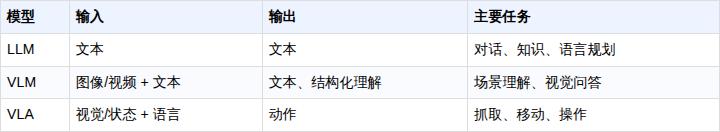
RT-2 是这条路线的经典工作:它把动作离散成 token,使视觉语言模型能在统一形式下学习文本和机器人轨迹。它将网络知识的语义泛化带入控制,同时也受到离散表示的精度与控制频率限制。
近年的 VLA 已不满足于“看一帧图、给一个动作”。长任务中,它需要形成子目标;信息不足时,需要主动换视角;接触物体后,还要利用力觉修正。面对复杂轨迹,扩散或 flow matching 一类方法也在承担连续动作生成。
Open X-Embodiment / RT-X[5] 从数据侧推进这件事。该协作项目汇集 22 种机器人、21 家机构的数据,覆盖 527 项技能,探索不同机器人之间的经验迁移。跨本体迁移仍需校准和适配,但可共享的数据格式与训练基线是通用策略的前提。
Octo[6] 与 OpenVLA[7] 则提供了更可复现的开源通用策略路线,方便研究者比较数据、动作表示和新硬件的影响。
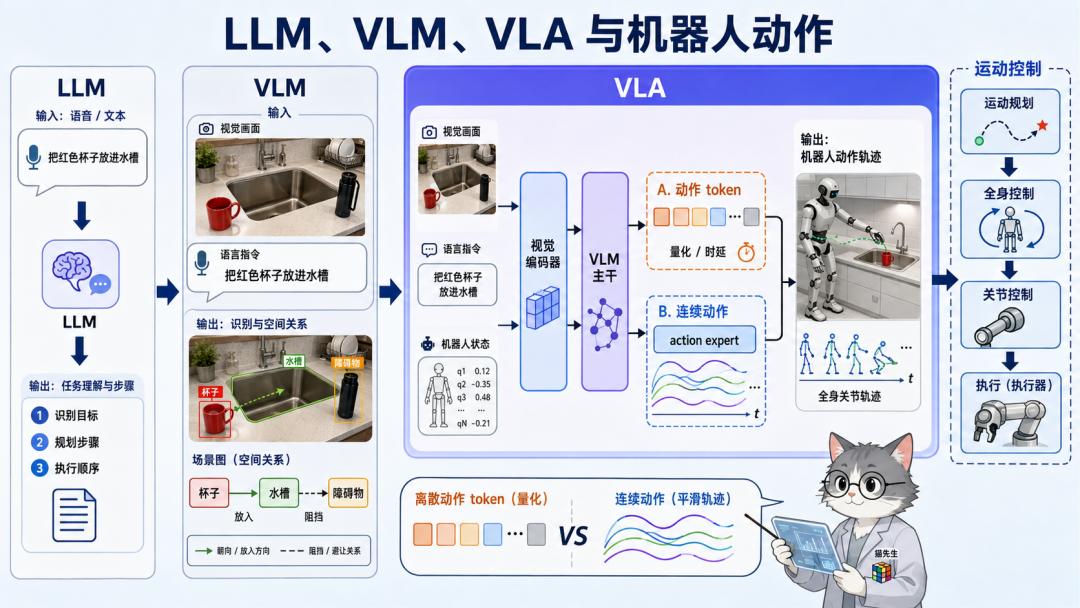
图 6:VLA 将视觉、语言和机器人状态合在一起,再输出可交给运动规划、全身控制和关节控制的动作。
6. 世界模型:行动前先在脑中试一遍
世界模型像一次行动前的预演——先估计后果,再决定要不要这么做。
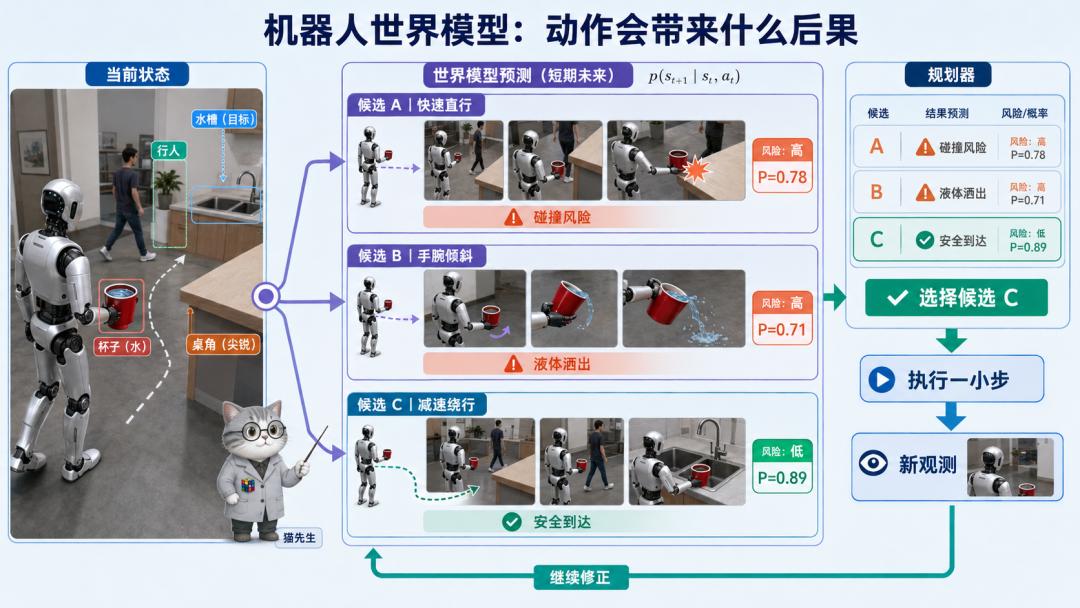
图 7:世界模型会比较不同候选动作的未来结果,规划器再选择风险更低的一步。
机器人倒水时,需要预判杯子倾斜后液体的变化;推箱子时,要判断摩擦、碰撞和路径;绕过人时,要估计对方下一步可能出现的位置。
世界模型要解决的是:给定当前状态和候选动作,预测未来会出现什么状态。对机器人而言,它不一定要生成一段逼真的视频,更关键的是回答:会不会撞、物体会不会移动、抓取会不会滑落、哪个路径风险更低。
当前观测 + 机器人状态
        ↓
提出候选动作
        ↓
预测未来状态、风险与成功概率
        ↓
选择动作 → 执行 → 用新观测纠偏
“World Action Model”强调的正是动作如何改变世界,而不只是未来画面长什么样。它可以用于规划、失败恢复、合成数据和安全筛查。
柔性物体、罕见接触、传感器误差和人的突然介入,都会让预测偏离现实。世界模型更适合放在预测环节:它负责预判,实时观测负责纠偏,硬安全约束负责兜底。
7. 数据:机器人学会什么,取决于它真正经历过什么
文本模型靠读网页成长,机器人要靠一次次亲手做、做错、再改进成长。
机器人数据往往同时记录视觉、关节状态、动作、力觉和执行结果。采集需要硬件、场地、操作员、维护和安全保护;不同机器人的手、相机、坐标系与控制频率也并不相同。
长尾是另一道难题。固定位置抓方块,可以积累很多轨迹;家庭和工厂里却会遇到不同材质、光照、遮挡、负载和人类干扰。有价值的数据应包含失败和恢复,因为它们告诉系统哪些做法会出错、出了错又该怎样恢复。
DROID[8] 这样的真实世界操作数据集,以及 Open X-Embodiment 的跨平台联合,都说明参数规模之外,数据的质量、可复用性和对边界场景的覆盖,同样会影响机器人能学到什么。
数据也并非越多越好。大量重复动作可能只会让模型更擅长一个狭窄场景;动作质量、时间同步、安全标签和任务多样性,往往比单纯堆轨迹数量更重要。
8. 仿真:把昂贵的现实试错,搬进可控的数字训练场
仿真是机器人的练习场和安全沙盒——先在虚拟世界里多摔几万次。
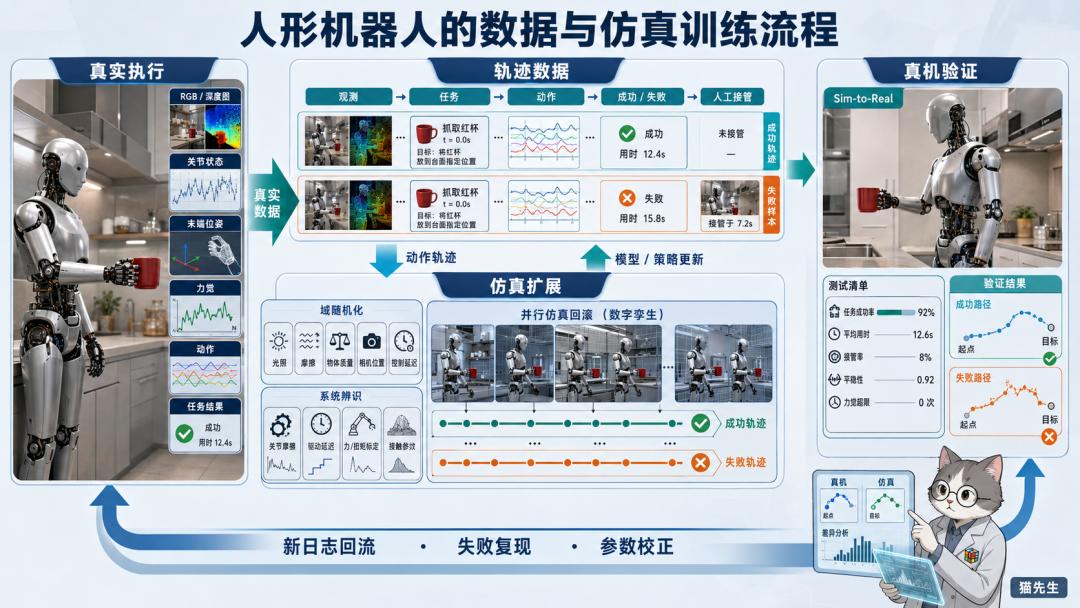
图 8:真实执行产生数据,仿真扩展场景和失败样本,候选策略再回到真机验证。
让真实人形机器人反复摔倒、撞桌子、抓碎物品,成本高,也有安全风险。仿真可批量改变场景、物体、光照、摩擦、传感器噪声和突发扰动,用于训练策略、生成合成数据、回放故障和验证安全边界。
Isaac Sim / Isaac Lab[9]、RoboCasa[10] 与 Habitat[11] 分别覆盖物理仿真、日常操作任务、空间感知与导航等不同环节。
仿真最大的难题是 Sim2Real:虚拟世界里学会,不等于真实世界里也能完成。真实相机有噪声,电机会延迟,地面和物体也不完全符合模型。
更现实的做法,是让真实与虚拟反复互相校正:真实部署找出失败,仿真复刻并扩展失败场景,候选策略回到受控真实环境验证,新日志再带回训练。
结尾:人形机器人要经得起怎样的检验
回到最开始的问题:一台机器人把红色杯子放进水槽,到底难在哪里?
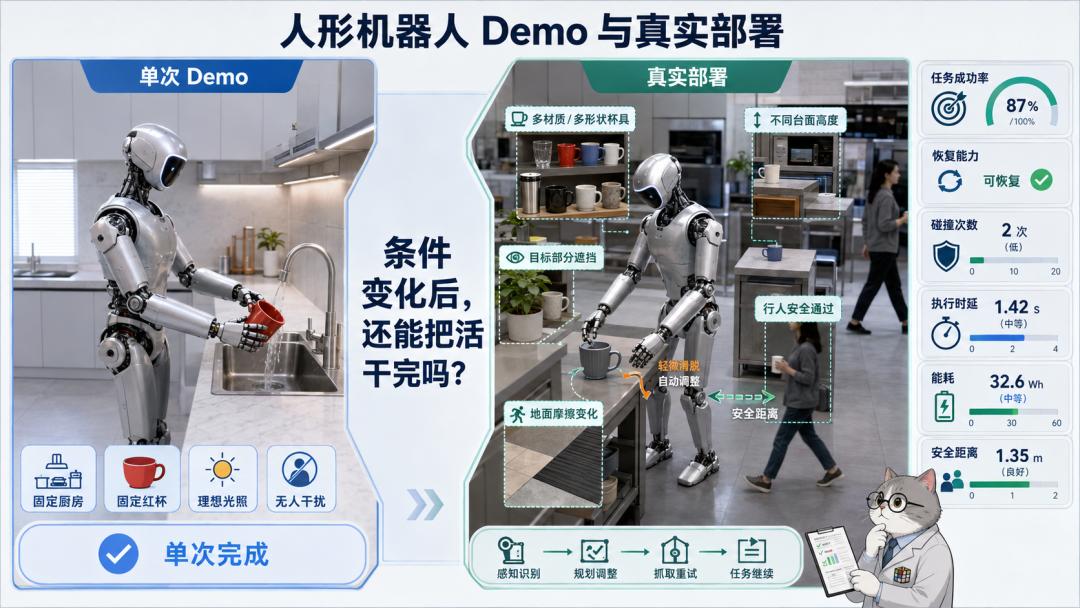
图 9:Demo 只能说明一次任务成功,真实部署还要看环境变化后的成功率、恢复能力、碰撞次数、延迟、能耗和安全距离。
难的不只是拿起和放下。它得看清环境,判断抓取位置,控制身体姿态,处理地面和负载变化;出了偏差,还要知道怎么停下来、怎么调整。每一步看上去都很普通,少了其中任何一步,任务都可能在真实环境里失败。
评估时可以直接看:换一批物体、换一个场地、加一点干扰后,它还能不能把任务做完;出了问题,能不能自己恢复;和人一起工作时,是否足够安全。
工厂、仓库和家庭不会因为机器人会说话、会跳舞就接纳它。它们只关心一件事:这台机器能不能稳定地把活干完。
参考链接
1. https://ai-mzq.github.io/From-Zero-to-AGI/:https://ai-mzq.github.io/From-Zero-to-AGI/
2. Gemini Robotics:https://deepmind.google/blog/gemini-robotics-brings-ai-into-the-physical-world/
3. RT-2:https://arxiv.org/abs/2307.15818
4. π0:https://www.pi.website/research/pi0
5. Open X-Embodiment / RT-X:https://arxiv.org/abs/2310.08864
6. Octo:https://arxiv.org/abs/2405.12213
7. OpenVLA:https://arxiv.org/abs/2406.09246
8. DROID:https://droid-dataset.github.io/
9. Isaac Sim / Isaac Lab:https://developer.nvidia.com/isaac/sim
10. RoboCasa:https://robocasa.ai/
11. Habitat:https://aihabitat.org/