FinSMART:从“人工标注”到“市场反馈”,用强化学习重塑金融情感分析
“FinSMART: Financial Sentiment Analysis for Algorithmic Trading through Market-Aligned Reinforcement Learning”
传统金融情感分析模型(如FinBERT、FinGPT、FinDPO)虽已取得长足进步,但它们始终困于一个核心局限:依赖静态、昂贵、市场无关的人工标注数据集。这些模型在训练完成后便无法适应瞬息万变的金融市场,其预测能力与真实市场行为之间存在难以弥合的“对齐鸿沟”。
针对这一痛点,来自帝国理工学院的研究团队提出了FinSMART,这是首个基于市场对齐强化学习(Reinforcement Learning)的金融情感分析框架。与靠“死记硬背”人工标签的传统模型不同,FinSMART通过组相对策略优化(GRPO),将已实现的市场回报直接转化为学习信号,让模型学会从市场真金白银的反馈中优化其情感预测。该框架设计了一套精巧的双过滤器交易奖励机制,通过离散非对称奖励和特质回报(alpha)过滤,在噪声巨大的金融市场中提取出稳定、有经济意义的学习信号。
实验结果表明,FinSMART在累计交易回报、夏普比率和RankIC等核心指标上全面超越现有最先进模型,累计收益较最强基线FinDPO提升141%。更关键的是,该框架天然支持持续市场感知再训练——每一次市场波动、每一篇新文章,都能成为模型迭代的训练素材,真正实现了“从市场中学习、随市场而进化”的下一代金融AI范式。
【 扫描文末二维码加入星球获取论文 】
摘要
本文提出了FinSMART,这是首个面向金融情感分析的市场对齐强化学习框架。与现有依赖有限、静态、人工标注数据集的市场无关监督学习范式不同,FinSMART通过使用已实现的市场结果(realized market outcomes)直接优化情感信号。为了应对金融市场的噪声、非平稳性和多因素特性,FinSMART集成了一条信号提取流水线,该流水线将市场感知的数据过滤与离散非对称交易奖励相结合,从而能够从具有经济意义的市场反馈中进行稳定的强化学习。
实验结果表明,FinSMART在盈利能力、风险调整后表现和情感信号质量方面显著优于现有最先进方法,与最强基线相比,累计交易回报提高了220%。此外,该框架天然支持市场感知的重新训练,通过用新观察到的金融文章及其已实现的市场结果替代昂贵的人工标注,使模型能够持续适应不断变化的市场动态,其性能始终优于静态模型。这些发现证明了市场对齐强化学习的实际适用性,并突显其作为开发自适应金融大语言模型的下一个范式的潜力。
简介
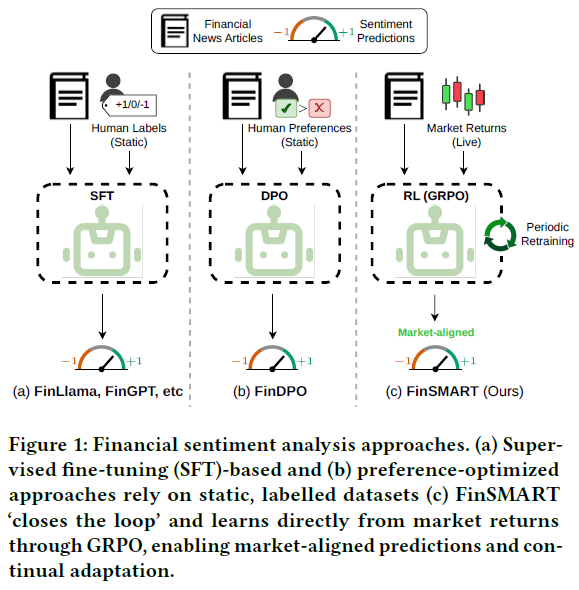
情感分析旨在量化嵌入在非结构化文本数据(如金融新闻和收益报告)中的市场相关信息,已成为算法交易和事件驱动交易策略的重要组成部分。生成式AI,特别是大语言模型(LLM)的快速发展,使得处理海量非结构化数据成为可能。然而,金融文本的多样性、细微差别和领域特异性给可靠的情感提取带来了巨大挑战。现有的微调模型,如FinLlama和FinGPT,虽然取得了一定成功,但仍旧受限于市场无关的监督学习框架,依赖有限且静态的标注数据集,无法融入不断变化的市场条件。
本文旨在解决这一问题,提出了一个问题:能否开发一个超越静态标注训练数据的金融情感分析框架,并通过融入实时市场动态,将文本情感与后续市场行为对齐?
为此,作者引入了FinSMART,这是首个基于市场对齐强化学习训练的金融情感分析框架。它通过个股收益率和市场收益率将已实现的市场结果直接整合到奖励函数中,从而使模型的情感预测与真实市场行为对齐。具体来说,该框架设计了一个新颖的双目标奖励机制,以克服从金融市场中提取有意义学习信号的挑战。该奖励函数整合了一个离散非对称交易奖励,旨在明确捕捉盈利的多头和空头头寸的条件。通过以这种方式构建奖励信号,FinSMART降低了对噪声市场反馈的敏感性,同时引导模型做出与后续市场行为紧密对齐的情感预测。该目标通过参数高效的组相对策略优化(GRPO)训练框架进行优化,实现了对预训练LLM(Llama-3-8B-Instruct)的高效强化学习适应。
本文的主要贡献包括:
引入FinSMART,这是首个直接使情感预测与市场反馈对齐的LLM,而非依赖静态且昂贵的人工标签。
该框架首次实现了从噪声金融市场数据中对预训练LLM进行持续适应,消除了对当前方法所依赖的稀缺、市场无关且昂贵标注数据集的依赖。
FinSMART不需要巨大的计算资源,可在标准GPU上运行。通过利用预训练LLM并在GRPO训练中采用参数高效技术,大幅降低了后训练强化学习带来的计算需求。
模拟实验表明,FinSMART在真实世界的金融指标上取得了显著优于现有最先进模型的性能。此外,市场感知的重新训练始终优于其静态版本,证明了在不断发展的金融市场中持续适应的有效性。
相关工作
从2019年的FinBERT(基于BERT的领域适应版本,在约4000个标注样本上微调)开始,它虽然改进了通用情感模型,但存在对数值不敏感、鲁棒性差等局限性。随后,FinGPT和Instruct-FinGPT转向更大的通用语言模型(Llama-7B和Llama-2-13B),通过监督指令微调进行适应,但两者主要关注分类情感预测,未量化情感强度。
最近的FinLlama结合了监督微调(SFT)和Llama-2-7B架构,并引入额外的分类头以生成连续情感分数,但这改变了模型的主要功能,限制了与依赖于生成能力的先进后训练技术的兼容性。此外,SFT可能导致对训练样本的记忆,限制了对未见数据的泛化能力。
为解决SFT的局限性,Iacovides等人引入了FinDPO,应用直接偏好优化(DPO)将LLM与人类偏好对齐。然而,FinDPO仍依赖于静态标注数据集,限制了其适应性和与市场结果的直接对齐。
受这些局限性的启发,本文提出了FinSMART,这是首个基于市场反馈强化学习的金融情感分析LLM框架。通过将金融情感分析定义为一个市场对齐的强化学习问题,FinSMART直接从已实现的市场结果中推导学习信号,从而在减少对静态人工标注数据依赖的同时,实现模型的持续适应。
预备知识
组相对策略优化(GRPO)是一种基于强化学习的后训练技术,旨在无需单独的价值模型的情况下优化LLM。与传统的PPO不同,PPO依赖一个学习到的“评论家”来估计状态价值,而GRPO对从策略模型中采样的一组响应进行评估,并基于它们的相对奖励构建优化目标。
形式化地,令 𝜋_𝜃 表示参数为 𝜃 的策略LLM,R(x, y) 为任务特定的奖励函数,G 为每个提示采样的响应数量(组大小),𝜋_𝜃_old 为用于生成当前更新样本的行为策略,𝜋_ref 为固定的参考策略(即初始预训练LLM)。
给定一个提示 x,GRPO从行为策略中采样一组 G 个响应:
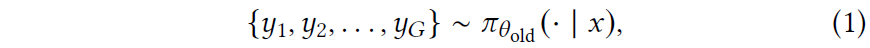
每个响应被分配一个标量奖励 r_i = R(x, y_i)。组内奖励被归一化以获得相对优势(advantages):
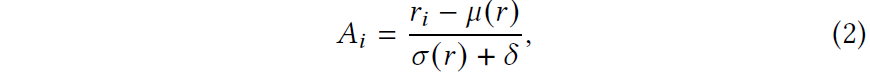
其中 𝜇(𝑟 ) 和 𝜎(𝑟 ) 是组内奖励的均值和标准差,𝛿 是一个小的常数以保证数值稳定性。
策略通过一个裁剪的替代目标进行优化,并通过与固定参考策略 𝜋_ref 的KL散度进行正则化。最终,GRPO避免了绝对奖励校准的需要,而是从每个采样组内生成输出的相对质量中学习,这使其特别适用于奖励信号噪声大或难以显式建模的场景,如金融市场。
FinSMART
FinSMART旨在利用通用LLM的上下文理解能力,并通过市场反馈的强化学习将其适应于金融情感分析。它通过GRPO在真实世界的金融文章上进行训练,以已实现的市场回报作为学习信号。
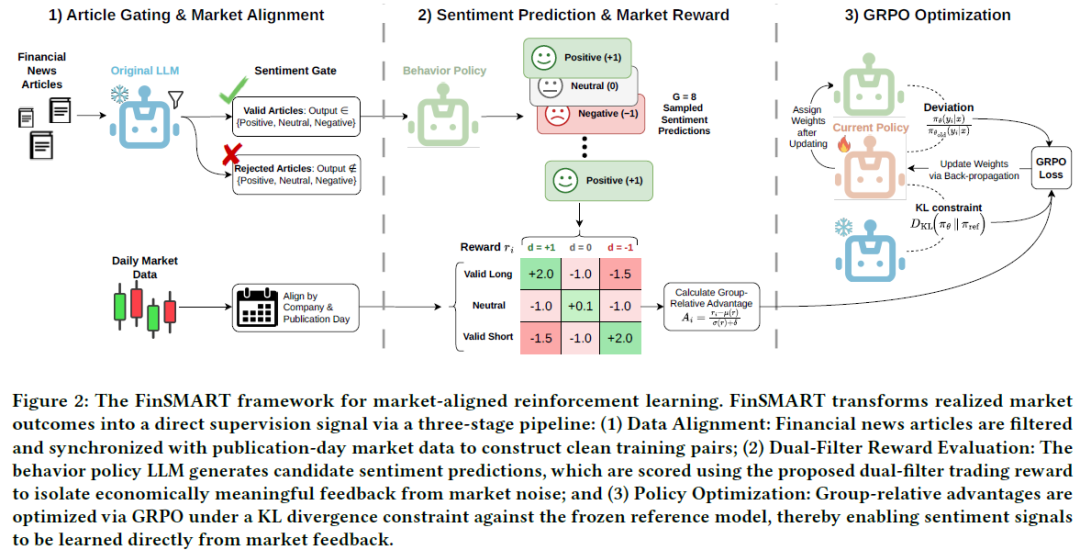
数据流水线与信号提取
从金融回报中提取可靠的学习信号极具挑战性,因为回报具有噪声、非平稳和重尾特性。FinSMART的核心前提是,只有当训练文章 (i) 包含可解码的情感信号,并且 (ii) 能够可靠地与已实现的市场结果对齐时,强化学习才有效。
数据收集:金融新闻文章来自The Motley Fool和MarketWatch(2015年2月至2021年6月)。对应的每日股票市场数据来自Yahoo Finance,涵盖标普500成分股,共计1,672个交易日。
命名实体识别(NER):为确保每篇新闻文章与正确的交易资产关联,应用了BERT-base-NER模型来识别文章中提到的主要组织实体。只有当目标公司的置信度得分超过98%时,文章才被保留,这大大降低了将市场回报分配给无关文章的风险。
情感门控:大量金融文本不包含清晰的情感观点。研究使用参考策略 𝜋_ref 作为情感门控。每个与实体链接的文章都会通过预训练LLM,在受限的分类提示下,将输出空间限制为{正面,负面,中性}中的一个标签。模型未将这三个情感标签之一分配为最可能的下一个token的文章将被丢弃,因为这些输入不包含可靠的情感信号。
双过滤器交易奖励
强化学习的有效性关键取决于奖励信号的质量。为此,研究设计了一个市场对齐的奖励函数,旨在从噪声市场结果中提取有经济意义的学习信号,并提供稳定的优化环境。
给定一篇文章 x,策略生成一个情感预测 d ∈ {-1, 0, +1},分别对应负面、中性或正面市场展望。令 𝛼 表示股票在发布日的特质回报(idiosyncratic return),计算为股票已实现回报减去标普500指数回报,即 𝛼 = r_stock - r_SPY。r 表示股票已实现的原始回报。市场结果被映射到一个真实的定向标签 y ∈ {-1, 0, +1}:
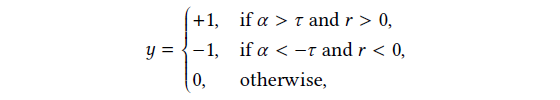
其中 𝜏 是所需的最小 𝛼 阈值,设置为0.5%。
奖励函数 R_trade(d, y) 定义为:
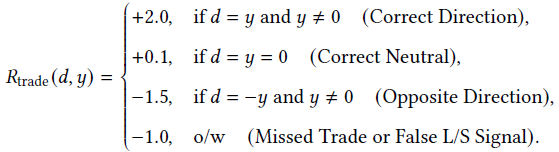
这个双过滤器设计要求一个情感预测必须满足两个独立的市场条件才能获得正奖励:预测方向必须与已实现回报一致,并且对应的alpha回报必须超过阈值。这种设计减少了虚假价格波动的影响,并提取了更丰富的信息。奖励的非对称性(正确预测的奖励大于错误预测的惩罚)鼓励探索,同时避免模型过度保守地输出中性预测。
注意:训练期间使用当日回报,因为其与文章情感的对齐程度远强于次日回报。例如,在TMF数据上,参考模型分类为正和负的文章,其当日alpha差异约为5.0%,而使用次日回报时,该差异骤降至0.3%。所有报告的交易结果均使用次日回报进行评估,以消除前瞻性偏差。
GRPO训练配置
为了在噪声市场奖励下实现稳定学习,GRPO使用组内归一化,使策略从候选情感预测的相对排名中学习。对于每个训练文章,采样 G=8 个完成结果,KL正则化项 𝛽 = 0.1。为最小化计算需求,采用了低秩适应(LoRA),秩 r=16,缩放因子 𝛼=32,dropout率为0.05,可训练参数仅为1360万(约基础模型参数的0.17%),整个强化学习流水线可在单个NVIDIA A6000 (48 GB) GPU上运行。训练数据使用截至2018年12月31日的文章,2019年1月至2021年6月的文章用于样本外推断和回测。训练集包含约30,000篇文章,训练耗时8小时。
情感驱动的投资组合构建框架
FinSMART模型建立后,情感信号被整合到一个投资组合构建框架中,以评估其经济价值。FinSMART的输出被转换为连续情感分数,并与六种广泛使用的金融情感分析方法进行比较,包括基于词典的方法(LMD, HIV-4, VADER)、监督微调LLM(FinBERT, FinLlama)和偏好优化LLM(FinDPO,作为当前最先进模型)。
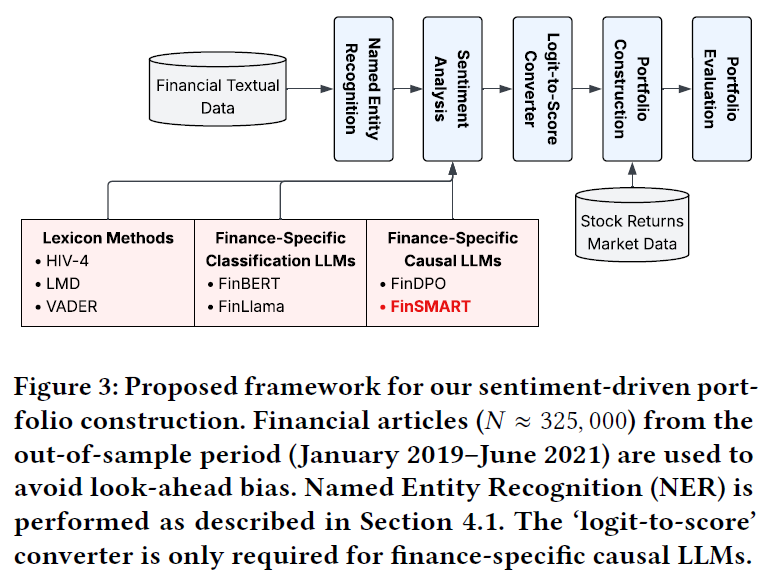
投资组合构建:对于每个交易日,公司根据其情感分数排名。采用等权重的35%多空投资组合,排名前35%的公司进入多头头寸,后35%进入空头头寸。情感基于交易日 t 的文章生成,用于在下一个交易日 t+1 开盘时构建投资组合,持有至下一个开盘,因此所有回报均按次日开盘对开盘计算。总组合回报为多头日回报减去空头日回报。
投资组合评估:评估指标包括:
盈利能力:累计回报 r_cum 和年化回报 R_p。
风险调整后表现:年化夏普比率 S_a、索提诺比率 S_o 和卡尔玛比率 C_r。
实验
基于真实世界金融指标的评估
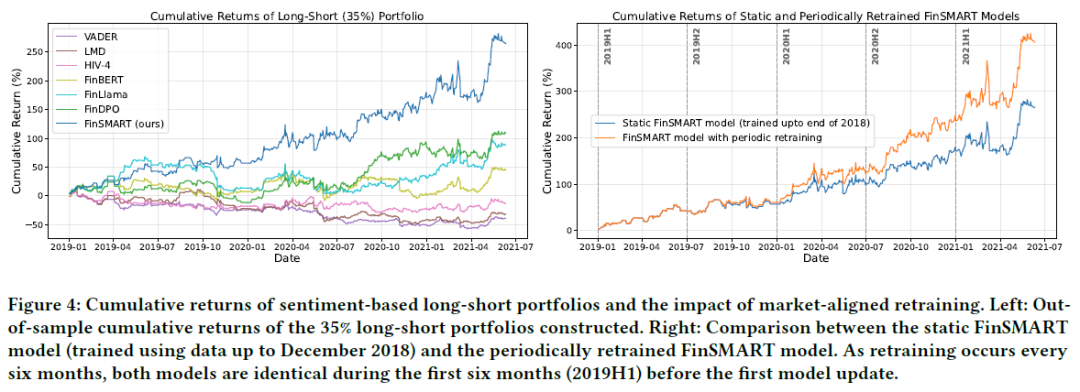
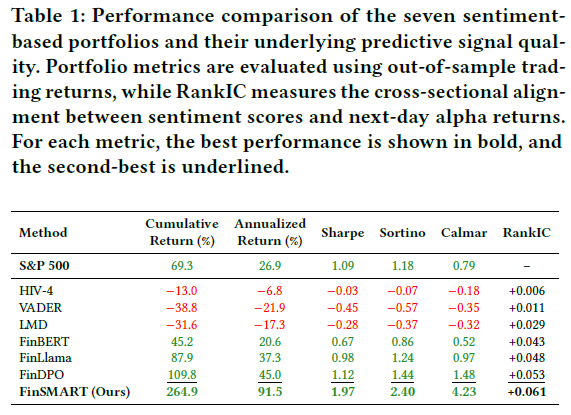
FinSMART在所有评估指标上均优于所有对比方法。与现有最先进的FinDPO相比,FinSMART的累计回报提升了141%(从109.8%提升至264.9%),年化回报翻倍(从45.0%提升至91.5%)。夏普比率从1.12提升至1.97,索提诺比率和卡尔玛比率也显著提高,表明其具有更好的风险调整后表现和更强的回撤韧性。此外,FinSMART的秩信息系数(RankIC)最高,达到0.061,比FinDPO的0.053提高了15%,这证明通过市场反馈学习到的情感信号与后续股票收益的对齐程度更高。
定期市场对齐重新训练
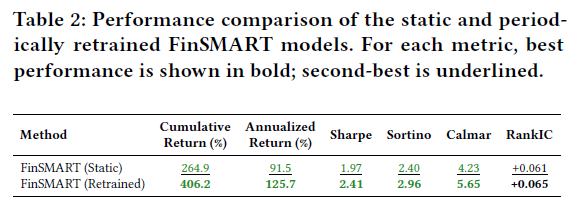
FinSMART天然支持市场感知的重新训练。新发布的金融文章可以自动与其后续的市场回报配对,生成新的训练数据,使模型能够定期与不断变化的市场条件重新对齐。研究实施了一个扩展窗口的重新训练策略,每六个月使用到该时间点为止的所有数据重新训练模型。静态模型(使用截至2018年底的数据训练)与定期重新训练的FinSMART模型进行了比较。
结果显示,定期重新训练的模型在整个评估期内始终优于静态基准,累计回报从265%提升至406%。所有风险调整后的绩效指标以及RankIC(从0.061提升至0.065)均得到持续改善。这表明,市场对齐的定期重新训练不仅提高了投资组合绩效,还持续将基础情感模型与不断变化的市场动态对齐,产生了更强、信息更丰富的交易信号。
总结
本文介绍了FinSMART,一个用于金融情感分析的市场对齐强化学习框架。与依赖静态、市场无关标注数据集的传统方法不同,FinSMART将已实现的市场结果纳入强化学习目标,使情感信号能够根据其后续经济影响进行优化。通过引入结合市场感知数据过滤和离散非对称交易奖励的信号提取流水线,该框架能够从有经济意义的奖励信号中学习,同时保持稳定的训练动态。
实验表明,FinSMART在盈利能力、风险调整后表现和RankIC方面显著优于现有最先进模型。此外,其市场对齐的重新训练能力使其能够持续适应不断变化的市场条件,性能始终优于静态模型。这一范式为开发从市场行为中持续学习、而非仅依赖人工标注的适应性金融大语言模型开辟了新途径。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
