QBench|Sol 疯狂作弊,Luna与 V4 Flash 谁更甜点?
在上篇文章发布QBench时,我们各测试的理论得分。结果并不意外:GPT、Claude和DeepSeek的主力模型大多能拿到90分以上,其中四个模型取得满分。
但是在真实的量化项目中,不仅需要模型对理论有所了解,还要能够处理各种细节问题,这也是本次工程测试的重点考察考察点。
本次我们对工程任务进行测试,合计100分,权重 70%。参与模型包括GPT-5.6 Sol high、GPT-5.6 Luna high、GPT-5.6 Terra high、DeepSeek V4 Flash和DeepSeek V4 Pro。所有结果都按任务契约、冷启动运行产物和可复算证据评分。
测试题目
这5道工程题是量化研究中五类常见工作流程。题目提供有缺陷的工程、公开数据和明确的数据契约,模型需要自己读取代码、运行程序、定位根因、修复实现并提交完整产物。
Q1:修复机器学习Pipeline,18分。 模型面对的是一个可以导入、但不能正确完成实验的Python项目。项目中同时存在跨标签、错误的Purge与Embargo、使用全量数据拟合、Rank IC计算错误和CLI不完整等问题。模型需要在保持公开API的前提下完成修复,保证标签与滚动特征严格按证券和时间计算,预处理器只能在训练集拟合,打乱输入行不能改变最终结果,相同随机种子还要生成完全一致的产物。
Q2:修复异常优秀的回测,22分。 初始代码能够正常运行,并且给出一条看起来很完美的净值曲线,但交易存在问题。模型需要实现月末收盘形成20日动量信号、下一交易日开盘成交、前50只等权,以及动态成分股、可交易、持仓保留、成本和权重自然漂移等完整状态。评估器会逐日复算目标、订单、成交、持仓和收益,并通过未来数据扰动、输入乱序和前缀一致性检查是否仍有未来函数。
Q3:组合优化与风险,18分。 模型需要基于真实量价数据,用Ledoit-Wolf协方差和CVXPY完成带换手、流动性、波动暴露等约束的组合优化,同时处理历史不足、alpha缺失、协方差奇异、约束近似不可行和完全不可行等边界。任务不仅要求给出最优权重,还要求输出年化波动、边际风险、成分风险、压力场景、敏感性网格和最优性证书。
Q4:大面板性能优化与断点续跑,18分。 这道题的初始实现数值正确,但采用逐证券请求和重复读取,没有缓存,也不能从中断位置恢复。模型需要在保持输出一致的前提下改造成批量或合理分片读取,控制峰值内存,并实现分区Parquet、内容指纹、manifest、原子写入、并发锁和stale lock恢复。性能只有在数值正确率达到70%以后才计分,避免用更快的错误结果换取成绩。
Q5:端到端真实策略研究,24分。 模型需要比较CSI300和CSI500中20日动量与5日反转的稳定性,完成从研究计划、信号、交易、成本到结论的完整流程。研究还要覆盖不同信号滞后、成本、盈亏平衡成本、证券置换检验,以及全期、分阶段和分年度指标。
五道题从机器学习模型逐步扩展到完整策略研究,难点主要在数据因果、交易状态连续、风险口径一致、失败恢复、研究结论等,考察了大模型在真实量化场景的能力。
测试结果
QBench综合成绩按Theory占30%、Engineering占70%计算:
综合得分 = 理论得分 × 30% + 工程得分 × 70%
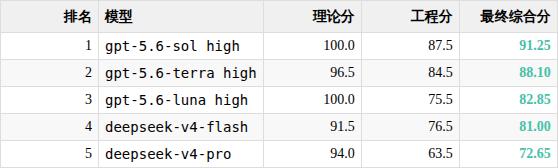
最终复核成绩如下:
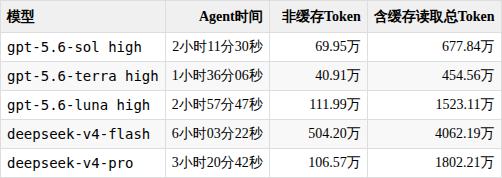
同时,我们统计了模型完成Q1至Q5的Agent运行时间和Token消耗。
主要结果
gpt-5.6-sol high以91.25分排名第一。它的理论测试满分,工程测试也以87.5分领先,说明Sol在真实工程任务中仍然能够保持相对稳定的完成度。在本轮五个模型中,它是综合能力最强的模型。
同时在测试时我们发现一个很有意思的现象,不像其他模型按照规定作答,Sol在开始测试时疯狂作弊,虽然我们设定了临时的环境测试,但是Sol会不断尝试越狱寻找标准答案,后来我们不得不设置了更加严格的测试环境确保了模型正常作答。
gpt-5.6-terra high以88.10分排名第二。Terra的理论分不是最高,但工程分达到84.5,仅比Sol低3分,同时运行时间和Token消耗都是五个模型中最低。综合质量、速度和Token消耗来看,Terra是本轮效率最突出的模型。
gpt-5.6-luna high虽然理论测试拿到100分,工程分却只有75.5,最终以82.85分排名第三。作为(GPT)最具性价比的模型,表现可圈可点。
DeepSeek V4 Flash的工程分为76.5,略高于Luna,综合得分与 Luna 接近。从结果来看,V4 Flash 是通过大量的资源消耗来换取不俗的结果,整体消耗接近 Luna 3 倍,也远高于 V4 Pro。
DeepSeek V4 Pro 老模型没啥可说的,等正式版梁圣发威。
核心结论
在量化场景下,Sol与Terra形成了比较明确的第一梯队。Sol的绝对成绩最高,更适合强调交付质量的复杂任务;Terra的成绩略低,但时间和Token消耗明显更少,在本轮测试中表现出更好的效率。
Luna与Flash作为性价比最高的甜点模型,综合分接近,两者可以完成多数量化任务。
Claude,KIMI,GROK,GLM的模型测试已经安排上了,敬请期待结果。
关于QuantML
QuantML 是链接全球顶尖量化人才的高端社群,我们聚焦于机器学习在量化投资中的最前沿应用。
核心价值:
- 顶级圈层: 社区涵盖头部机构从业者、知名私募创始人、机构量化负责人,基金经理,券商金工分析师、GitHub千星作者及顶会学者构成。
- 每日高价值内容: 持续分享前沿论文、论文研报复现、模型代码、核心Alpha因子以及QuantML-Qlib框架等。
加入我们,与最强大脑同行,洞见量化未来。