用千万级 MPRA 数据训练深度模型,首次系统性解码人类启动子的调控语法
编辑丨&
人类基因表达调控研究中,启动子(promoter)一直处在一个微妙的位置:它们在功能上至关重要,但在方法上却长期被「简化处理」。传统模型往往依赖表观组信号(如染色质开放性、组蛋白修饰)来推断启动子活性,本质上捕捉的是相关性而非序列层面的因果规则。
这导致一个根本问题始终悬而未决:如果只给 DNA 序列本身,研究者是否真的能预测启动子的转录驱动能力?
来自荷兰 Oncode 研究所等的研究者们提出了一种名为 PARM(Promoter Activity Regression Model) 的深度学习框架。该模型在实验和计算上都很轻量,因此可以生成针对细胞类型和条件的模型,仅凭DNA序列就能可靠预测基因组中的自主启动子活性。
相关研究内容以「Regulatory grammar in human promoters uncovered by MPRA-based deep learning」为题,于 2026 年 2 月 4 日刊登在《Nature》。
论文链接:https://www.nature.com/articles/s41586-025-10093-z
MPRA × 深度学习
,在统一实验条件下测量其转录活性。
这些数据的关键价值在于两点:第一,MPRA 将序列与表达输出直接绑定,天然具有因果属性;第二,规模足够大,允许模型学习到超越单一 motif 的高阶调控模式。
在模型设计上,PARM 采用的是结构相对简洁的一维卷积神经网络(CNN),参数量控制在 约 72 万,远低于当前主流的基因调控大模型。研究团队明确强调,他们的目标并非「参数规模竞赛」,而是验证:高质量因果数据是否足以支撑高精度启动子建模。
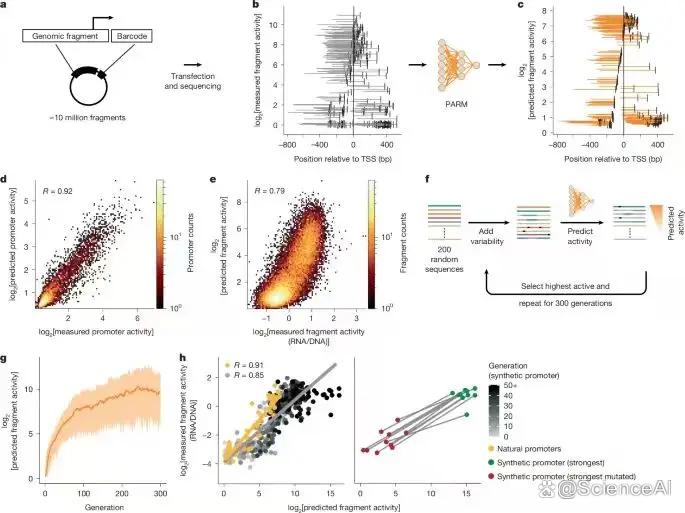
图 1:PARM 原理及验证。
通过该平台,数据生成和计算建模的成本都有所降低,这一进展使研究团队能够构建十种不同细胞类型中所有人类启动子的序列到活性模型,并在细胞暴露于多种刺激后进行。
功能与验证
在多个独立测试集上,PARM 对启动子活性的预测与实验测量结果之间的相关系数最高可达 R ≈ 0.9。这一性能并非是训练集的功劳,而是建立在未见过的天然人类启动子序列、合成启动子、含有系统性突变的序列库之上,该模型在多种场景验证下,均保持了相当不错的稳定性。
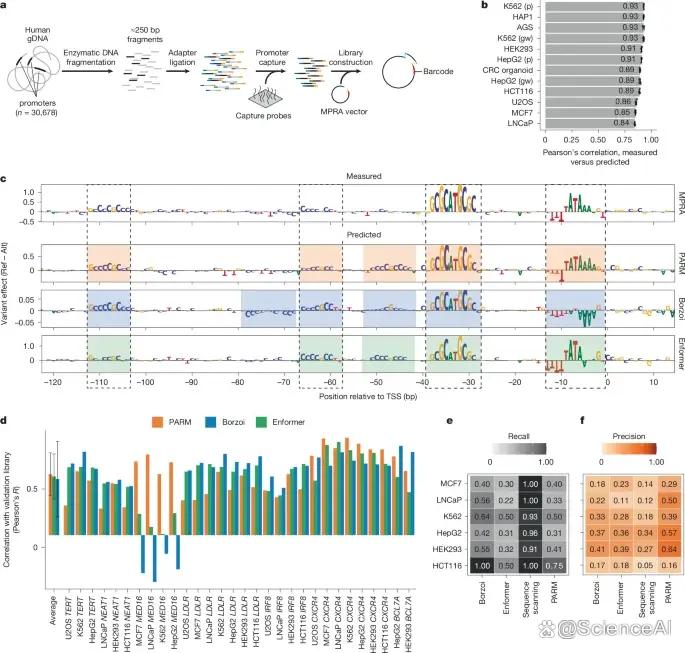
图 2:PARM 的单核苷酸功能预测。
团队主要采用的是基于捕获的策略,创建了对人类基因组文库中启动子重叠片段高度富集(90%)的新 MPRA 文库。这一思考建立在团队仅使用启动子重叠片段的数据来训练 PARM 的推论之上。
一个文库包含 400 万个足够代表的独特片段,约比全基因组文库少 600 倍。后续的所有实验均采用该文库作为实验来源。当应用于 K562 和 HepG2 细胞时,PARM 的启动子活性和整体预测力均与全基因组 MPRA 数据相当。
当研究者将 PARM 与依赖 ATAC-seq、ChIP-seq 等表观组输入的模型进行比较时发现:在启动子层面,纯序列模型已经可以达到相当、甚至更稳定的预测能力。
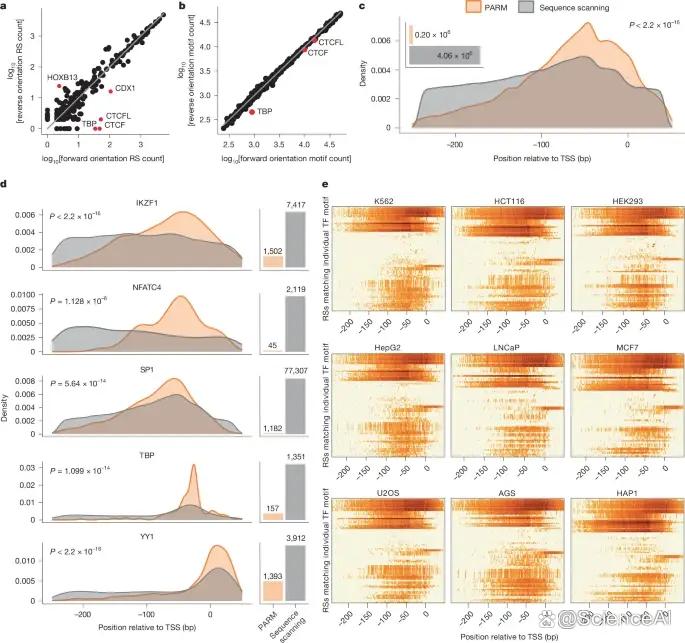
图 3:RS的明显优先定位。
此外,模型还揭示了激活型与抑制型调控元件在空间分布上的系统性差异,这些规律并未完整记录在现有注释数据库中。在此基础上,研究团队进一步测试了 PARM 的生成能力。他们利用模型进行序列优化,生成了一批并不存在于人类基因组中的合成启动子。
去表观组依赖
PARM 补充了其他深度学习方法,可用于建模增强子元素的语法或设计人工启动子。它证明了在小型功能基因组数据集上训练的轻量级模型,是大规模建模工作的可行且强大的替代方案。
未来的优化中,进一步优化聚焦的MPRA库和深度学习方法论,可能会提升性能。团队强调,PARM应被视为一种还原主义模型,能够洞察启动子的基本特性。这为后续研究留下了一个明确方向——不是一味扩大模型规模,而是思考:哪些生物学层级,真的需要多模态;哪些层级,序列本身已经包含足够信息?