AlphaGo十周年|从「第37手」到通向AGI,Demis Hassabis发文总结DeepMind十年科学征程
编辑丨coisini
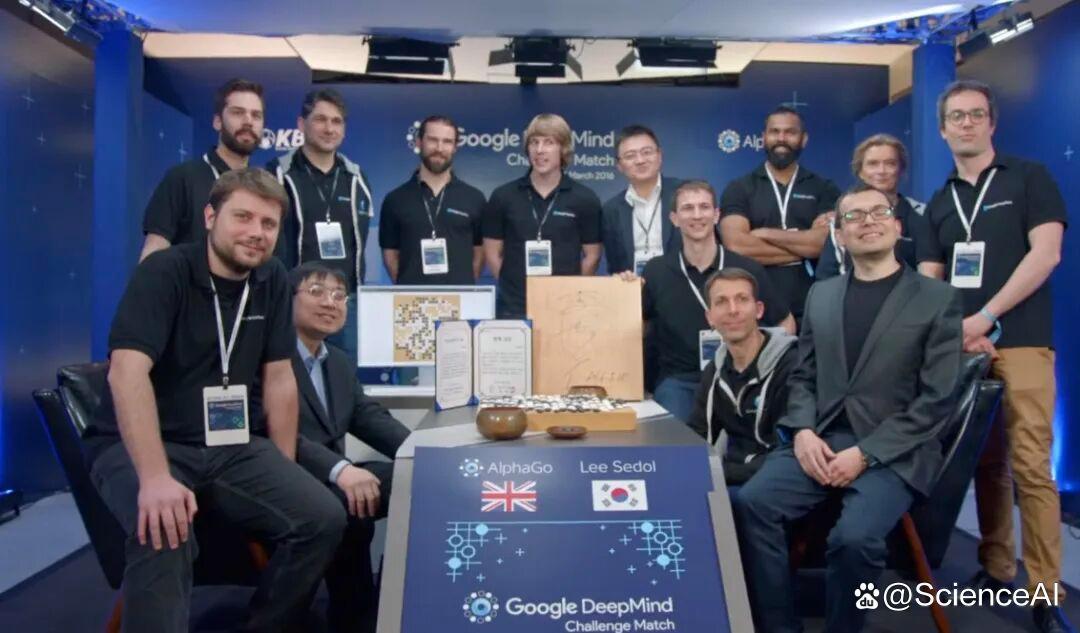
十年前,Google DeepMind 的 AI 系统 AlphaGo 首次在复杂的围棋比赛中击败世界冠军 —— 这一里程碑式的成就,比许多专家预测的时间提前了整整十年。
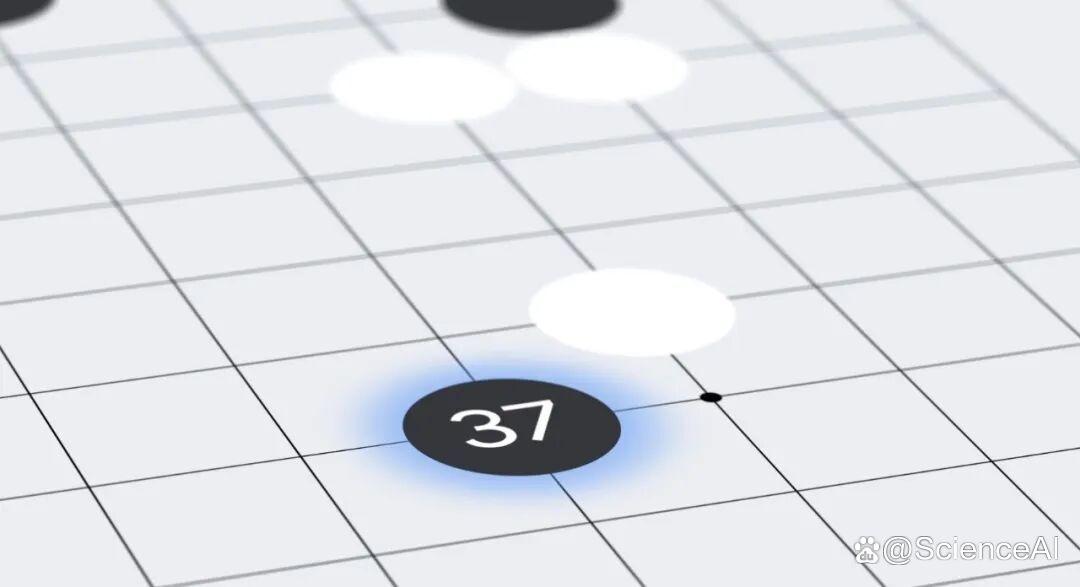
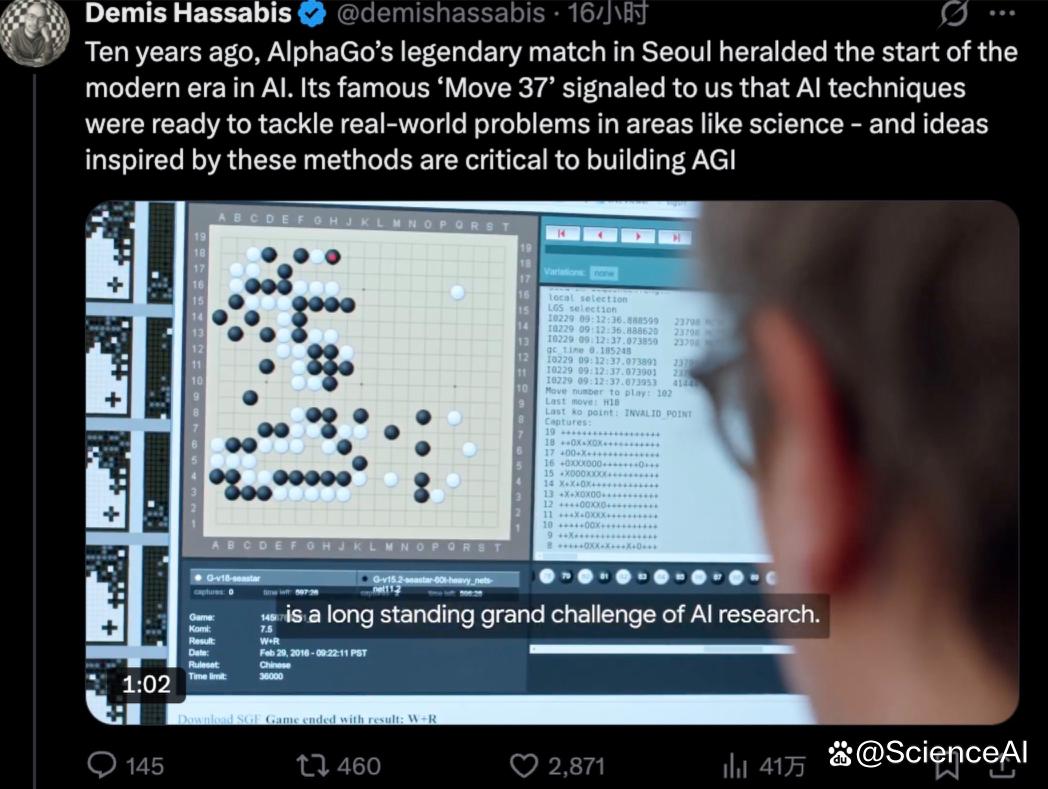
这一突破标志着人工智能现代纪元的开启。凭借一招惊世骇俗的「第 37 手」,AlphaGo 展现了人工智能的潜力,预示着 Google DeepMind 已经掌握了攻克现实世界科学难题的技术,并持续指引着他们构建通往通用人工智能(AGI)系统的道路。
在 AlphaGo 获胜十周年之际,Google DeepMind 首席执行官兼创始人 Demis Hassabis 发表长文,总结了 DeepMind 在过去十年间取得的进展,并展望了 AGI 的未来。
「我们相信,AGI 将成为人类历史上最具有深远意义的技术发明,更是推动科学、医学和生产力进步的终极工具」,Demis Hassabis 说道。
ScienceAI 对文章主要内容进行了不改变原意的编译、整理,内容如下。
创意的火花
2016 年,逾两亿观众见证了 AlphaGo 与围棋世界冠军李世石在首尔的巅峰对决。第二局中 AlphaGo 那步载入史册的「第 37 手」,因其反常规的落子方式,让专业解说员最初都误以为是程序出错。但这步棋最终成为胜负手 —— 经过约百回合的博弈,这枚棋子恰恰落在决胜位置,助 AlphaGo 锁定胜局。这不仅展现了惊人的前瞻性,更彰显了 AI 系统突破人类专家模仿的局限、开创全新策略格局的能力。
围棋因其极高的复杂度,一直是人工智能研究的试金石。棋盘上的可能局面多达 10 的 170 次方种 —— 远超可观测宇宙中的原子总数。
为了攻克这一难题,AlphaGo 结合使用了深度神经网络与先进的搜索和强化学习技术 —— 这是 DeepMind 开创的人工智能方法。
AlphaGo 通过学习人类专家的棋局来构建围棋走法模型,随后通过数百万次自我对弈持续强化致胜策略,不断提升水平。该系统会筛选出最具潜力的行棋路径,并从这些经过精简的走法中选出最有可能引导它走向胜利的一手。
继 AlphaGo 之后,我们开发了 AlphaGo Zero,它从完全随机的对弈开始学习,最终成为有史以来最强的围棋选手之一。随后,我们进一步将其通用化,打造了 AlphaZero,该系统从零开始自学,掌握了包括围棋、国际象棋和将棋在内的所有双人完全信息博弈。除了游戏规则,AlphaZero 没有任何先验知识,它能在数小时内自学精通国际象棋,不仅击败了顶尖人类棋手,还战胜了当时最专业的国际象棋程序如 Stockfish。即便国际象棋在这些程序的辅助下已被深入剖析,但就像在围棋中一样,AlphaZero 仍然能够构想出新颖有趣的策略。
这进一步印证了我在首尔获胜那一刻就笃信的想法 —— 这项技术已经准备好应用于我们真正的目标:加速科学突破。
我认为 AlphaGo 带来的最大启示,就是它精准地预演了人工智能时代 —— 证明这并非遥远模糊的未来,而是已然叩响现实大门的变革。它就像一张「来自未来的路线图」,向人类清晰地昭示着世界即将发生怎样的变迁。
催化科学突破
通过证明其能够驾驭围棋棋盘上巨大的搜索空间,AlphaGo 展示了人工智能帮助我们更好地理解物理世界巨大复杂性的潜力。我们首先着手尝试解决蛋白质折叠问题,这是一个预测蛋白质三维结构的 50 年重大挑战,对于理解疾病和开发新药至关重要。
2020 年,我们最终凭借 AlphaFold 2 系统攻克了这一长期存在的科学难题。以此为基础,我们解析了科学界已知的所有 2 亿多种蛋白质的结构,并将它们免费开放给科学家,存储在一个开源数据库中。
如今,全球超过 300 万研究人员正在使用 AlphaFold 数据库来加速他们从疟疾疫苗到塑料降解酶等众多重要领域的研究工作。而在 2024 年,能够代表整个 AlphaFold 团队,与 John Jumper 共同获得诺贝尔化学奖,是我毕生的荣幸。
自 AlphaGo 获胜以来,我们已将其开创性方法应用于许多科学领域,包括:
数学推理:作为 AlphaGo 架构最直接的后继者,AlphaProof 结合使用语言模型与 AlphaZero 的强化学习和搜索算法,学会了证明形式化的数学命题,与 AlphaGeometry 2 一起,成为了首个在国际数学奥林匹克竞赛中达到奖牌标准(银牌)的系统,证明了 AlphaGo 的方法能够解锁高级数学推理能力,并为我们最强大的通用模型奠定了基础。
算法发现:就像 AlphaGo 在游戏中搜索最佳走法一样,我们的编码智能体 AlphaEvolve 在计算机代码的空间中探索,以发现更高效的算法。它也有自己的「第 37 手」时刻:它发现了一种新颖的矩阵乘法方式(支撑几乎所有现代神经网络的基础数学运算)。如今,AlphaEvolve 正被应用于从数据中心优化到量子计算等一系列问题的测试。
科学合作:我们正将 AlphaGo 开创的搜索和推理原则整合到一个「AI co-scientist」中。通过让多个智能体对科学观点和假设进行「辩论」,该系统能够进行识别数据模式和解决复杂问题所需的严谨思考。在帝国理工学院进行的验证研究中,它分析了数十年的文献,并独立得出了关于抗菌素耐药性的假设,而这一假设是研究人员花费多年时间进行实验开发和验证才得出的。
我们还利用人工智能更好地理解基因组、推进聚变能源研究、改进天气预报等等。
尽管我们的科学模型令人印象深刻,但它们高度专业化。要实现创造无限清洁能源或攻克当前尚无法理解的疾病等根本性突破,我们需要通用人工智能系统,去发现不同学科领域之间的底层结构和联系,并像最顶尖的科学家那样,帮助我们提出新的假设。
智能的未来
要实现真正通用的人工智能,它需要理解物理世界。我们从一开始就构建了多模态的 Gemini,使其不仅能理解语言,还能理解音频、视频、图像和代码,从而建立起一个世界模型。
为了在这些不同模态之间进行思考和推理,最新的 Gemini 模型运用了我们在 AlphaGo 和 AlphaZero 上开创的一些技术。
下一代人工智能系统还需要能够调用专门的工具。例如,如果一个模型需要了解某种蛋白质的结构,它可以使用 AlphaFold 来完成。
我们认为,Gemini 的世界模型、AlphaGo 的搜索和规划技术,以及专用 AI 工具的使用这三者的结合,将被证明对实现 AGI 至关重要。
真正的创造力是一个通用人工智能系统需要展现的关键能力。「第 37 手」让我们得以一窥人工智能跳出固有思维模式的潜力,但真正原创性的发明需要更多的东西。它不仅需要像 AlphaGo 那样出色地构想出新颖的围棋策略,更需要实际创造出一种像围棋一样深邃、优美、值得钻研的博弈。
在 AlphaGo 传奇性胜利十年后的今天,我们的终极目标已近在眼前。最初在「第 37 手」中闪现的创意火花,催化了一系列突破,这些突破如今正汇聚在一起,铺平通向 AGI 的道路,并开启一个科学发现的新黄金时代