FinTrace:金融领域任务LLM工具调用能力评估
“FinTrace: Holistic Trajectory-Level Evaluation of LLM Tool Calling for Long-Horizon Financial Tasks”
【 扫描文末二维码加入星球获取论文 】
摘要
现有金融工具调用基准场景有限、评估指标不足,本文提出 FinTrace 基准,含 800 条专家标注轨迹,覆盖 34 类金融任务,采用基于评分规则的评估协议,含 9 个指标。对 13 个大语言模型评估发现,前沿模型工具选择强,但信息利用和最终答案质量差。构建首个金融工具调用轨迹级偏好数据集 FinTrace-Training,含 8196 条轨迹。用监督微调及直接偏好优化(DPO)微调 Qwen-3.5-9B,DPO 更有效抑制失败模式,但最终答案质量仍待提升。
简介
大语言模型已从被动文本生成器发展为能调用外部工具完成复杂多步工作流的自主代理,金融领域对工具调用的准确性、逻辑性和效率要求极高,理解LLM工具调用在金融场景的不足并解决很关键。
近期研究考察了LLM在通用任务的工具调用能力,发现长流程中性能会下降,但未体现金融服务独特挑战;FinMCP-Bench和FinToolBench开始评估金融场景的工具调用性能,后者还考察工具与用户意图的一致性。
现有工作多数数据集由反向合成构建,用户查询易,与真实从业者查询差异大。评估多为调用级,未考量完整多步轨迹质量。金融工具调用基准侧重任务级评估和事后诊断,难评估大风险金融工作中模型的实际可用性。
本文提出FinTrace基准,从现实金融查询出发,用多维准则评估完整工具使用轨迹。构建FinTrace-Training,含8196条金融工具使用轨迹的偏好数据集,用于训练大语言模型。
FinTrace
评价查询集与金标构建
任务查询来源:为反映金融工具使用的多样性和复杂性,从四个既定基准数据集、公开学术论文等收集的用户查询、针对未覆盖工具定制的额外查询三方面获取任务查询,共15,095条,涵盖34个任务类别。
评估查询集选择:用GPT-5.4、ClaudeOpus-4.6、Gemini-3.1-Pro为15,095条查询生成轨迹,按轨迹结果、长度、工具多样性、查询复杂度计算难度得分,分易、中、难三层,每层按55%成功、45%失败抽样,得800条评估查询。
真实标签轨迹:用三个高级大语言模型为800条评估查询重新生成候选轨迹,用LLM-as-Judge Prompt选最佳,经金融专家验证(Cohen’s kappa κ = 0.89)后,专家全面审查,迭代修正,获800条真实标签轨迹,其余轨迹用于构建训练数据。
评估方案
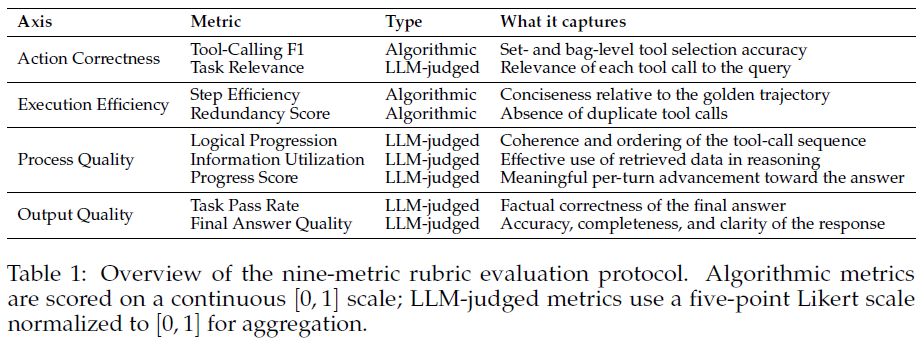
现有金融工具调用基准多以单一端到端指标(如工具调用成功率)评估大语言模型(LLMs)表现,忽略关键中间步骤。为解决此局限,引入含九个指标、沿四个互补轴的多维评分评估协议。三个算法指标在[0, 1]区间确定性计算,所有由LLM评判的指标用特定提示和评分标准独立评估,按五级李克特量表打分后归一化至[0, 1]以便跨轴比较,各模型总分是九个归一化指标的均值。
实验
实验设置
评估 13 种大语言模型(涵盖 GPT、Claude、Gemini-3 等 proprietary 模型及 Qwen3、LLaMA-3 等开源模型)工具调用轨迹质量,用统一提示确保公平比较。
搭建基于 Financial Modeling Prep 平台的统一工具调用接口作为测试平台,模型通过 Model Context Protocol 与平台端点交互。
结果
对13个大语言模型在FinTrace上用九指标体系评估,结果见表格2。前沿模型领先,但无模型在所有指标占优。Claude-Opus-4.6总分最高(0.788),其次是Claude-Sonnet-4.6(0.750)和GPT-5.4(0.737),显示前沿专有模型在复杂金融工具调用任务有优势。如GPT-5.4通过率最高但逻辑推进和进度得分落后,Gemini-3.1Pro工具调用F1第二但整体排名第四。开源权重模型KiMi-2.5(0.643)和Qwen3.5-397B(0.639)有竞争力,但落后前沿模型,尤其在轨迹级推理指标。这表明仅工具选择强不够,全轨迹稳定表现才区分顶级系统。
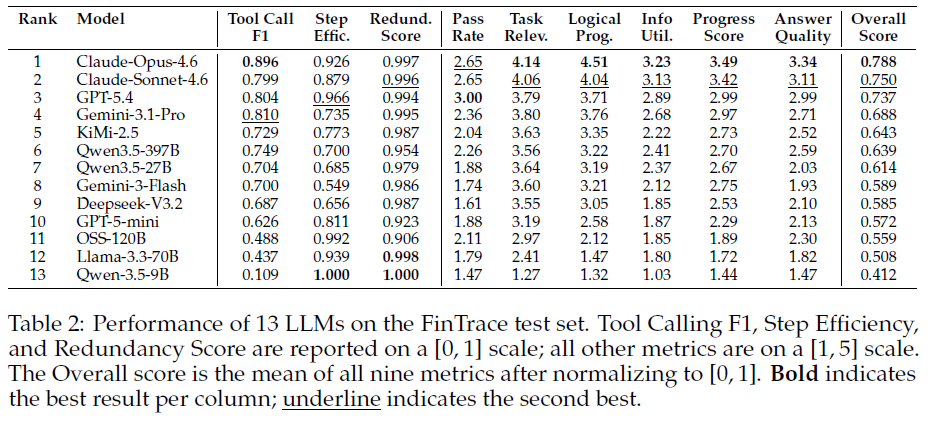
过程质量和输出质量是主要瓶颈。各模型算法与大语言模型评判指标差异明显,多数模型冗余得分高、工具调用 F1 值合理,但过程和输出质量指标表现差。即便排名靠前的 Claude-Opus-4.6,通过率和最终答案质量得分也不高。信息利用率普遍低,表明大语言模型虽会选工具,但在金融任务多步骤、高数值要求情境下难有效利用结果推理。
小模型存在退化的工具调用行为。如 Qwen-3.5-9B 和 Llama-3.3-70B 效率指标近乎完美,但工具调用 F1 等其他指标低,它们少用或用错工具,推理浅且轨迹不完整。这凸显多维度评估协议的重要性,单指标评估会使这些模型排名虚高。
分析
图2展示13个模型的分类热力图和查询小提琴图。推理QA是通用瓶颈,各模型在此表现不佳,因其需多跳推理和持续逻辑思考,当前大语言模型尚未掌握。
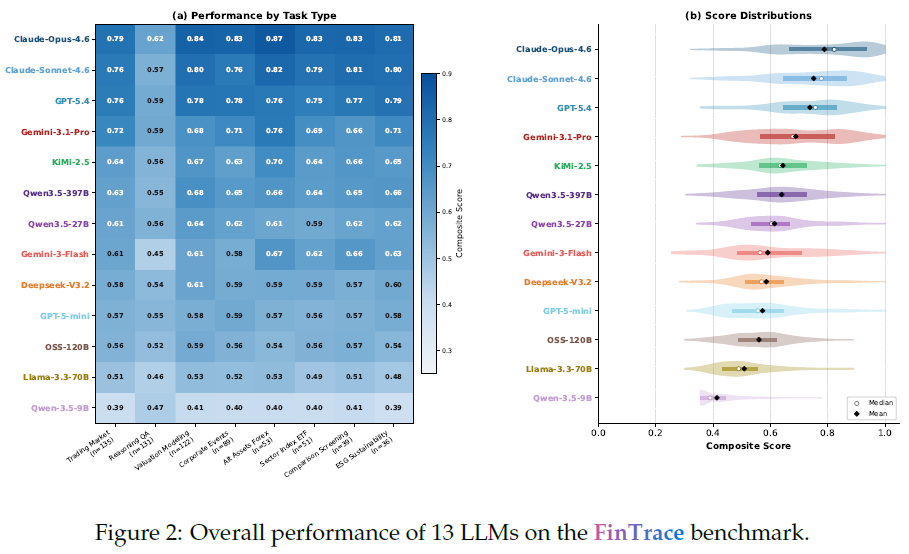
前沿模型跨任务表现稳定,中层模型则不然,如Gemini-3-Flash在不同任务得分差异大。
高平均表现不保证可靠性,小提琴图显示Claude-Opus-4.6有低得分情况,GPT-5.4表现更稳定,Qwen-3.5-9B和Llama-3.3-70B多集中在低分区,说明总分会掩盖可靠性差异。
Trajectory-Level后训练
FinTrace-Training数据集
评估显示前沿模型在轨迹级推理上有困难,现有基准无训练资源。为弥补此差距,构建了首个用于金融工具调用后训练的轨迹级数据集FinTrace-Training,通过多阶段流程完成,包括收集清理原始轨迹、添加工具选择上下文、构建监督微调与偏好优化数据。源数据及清理方面,从10912个金融问答会话开始,涉及34类任务,对完整多轮交互记录进行清理转换。
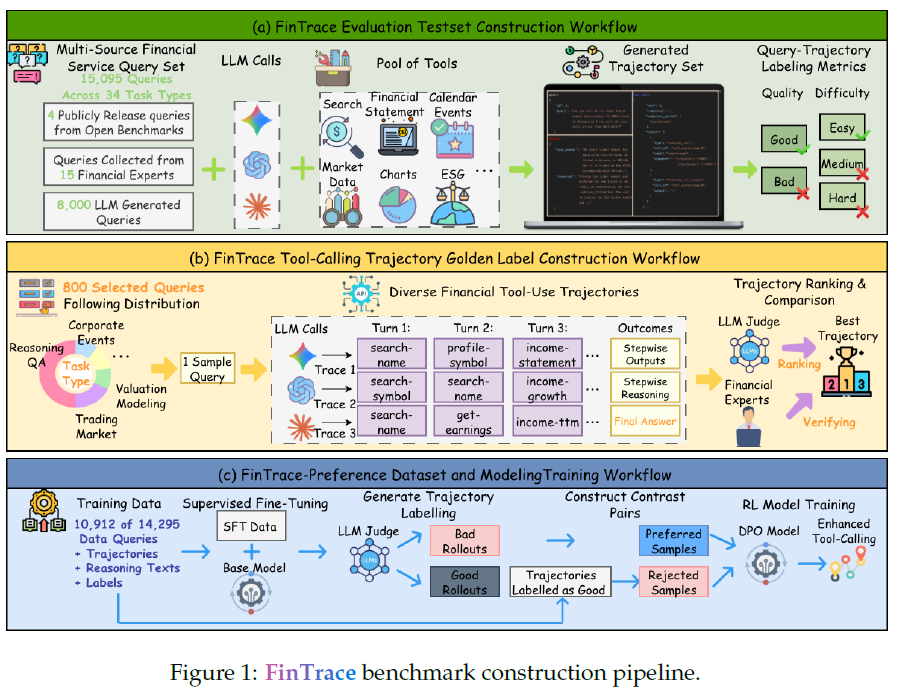
清洗后保留 8196 个至少有一次成功工具调用的示例。现实部署中,智能体需从大量工具中选合适工具,金融领域因工具语义相近挑战大。为让模型适应,给每个示例提供 30 个候选工具池,包含实际调用工具。剩余插槽 50% 用金融领域嵌入模型选语义相似工具填充,其余随机填充,以此增强模型工具选择的鲁棒性。
数据清洗后分为监督微调(SFT)和偏好优化两个无重叠部分。SFT 部分提供参考轨迹,让模型学习工具调用交互格式,为偏好优化打基础。构建偏好数据集时,先在 SFT 部分训练模型,在保留的偏好部分生成轨迹,用大语言模型(LLM)判断,保留参考轨迹更优的对,为偏好优化提供训练信号,使模型学会选择合适工具、减少冗余调用并高效得出准确答案。
两阶段训练
为验证FinTrace-Training有效性,用SFT后接DPO微调Qwen3.5-9B。
工具响应掩码:因工具响应是环境返回非模型行为,将其从训练损失中掩码,定义掩码(z_j),两阶段一致应用。
监督微调(SFT):让模型内化多轮工具调用格式、适应不同工具池,有掩码SFT目标。
直接偏好优化(DPO):SFT不能让模型区分有效和无效轨迹,对偏好对应用DPO,有掩码DPO目标,模型从自身拒绝的滚动中学习以抑制SFT后出现的失败模式。
实验结果
图3展示Qwen3.5-9B的Base、SFT和DPO变体四个大模型评判指标的分数分布。
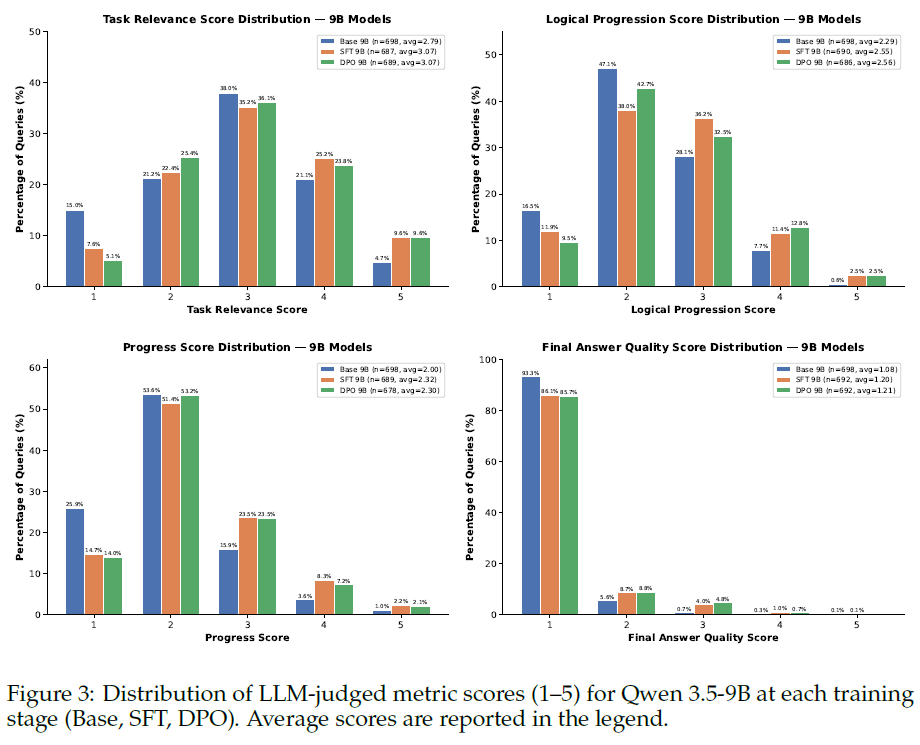
训练提升中间推理能力但未改善最终答案:SFT和DPO减少得分1的比例,向得分≥3偏移,平均得分提升,但最终答案质量仍是瓶颈,中间推理提升未转化为端到端答案的显著改善。
DPO在减少失败模式上持续优于SFT:DPO在各指标上得分1的比例最低,最终答案质量得分≥3的比例最高,因其对比信号能直接惩罚不良行为。
总结
本文提出FinTrace基准,含800条专家标注轨迹、34个金融任务类别和九指标评分体系。评估13个大语言模型,发现均在轨迹级推理有困难,尤其信息利用和最终答案质量。并构建FinTrace-Training首个金融工具调用轨迹级偏好数据集,SFT后接DPO能提升中间推理,DPO更有效抑制失败模式,但后训练后最终答案质量仍是瓶颈。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
