FinSTaR:首个金融时序推理模型,准确率达 78.9%,大幅超越现存SOTA
“FinSTaR: Towards Financial Reasoning with Time Series Reasoning Models”
本文介绍首个金融推理模型 FinSTaR,将金融时间序列(TS)推理分为评估和预测,分别应用 Compute-in-CoT 和 Scenario-Aware CoT。2×2 能力分类法对应十个金融推理任务,四类互补互促,场景推理在预测任务上优于标准 CoT。FinSTaR 准确率达 78.9%,大幅超越 15 个以上基线模型。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
时间序列(TS)推理模型(TSRMs)在一般领域表现出良好的能力,但在金融领域却表现出其独特的特征。本文提出了一种通用的2 × 2 TSRMs能力分类法,将单实体与多实体分析、当前状态评估与未来行为预测相结合。本文提出了FinSTaR(金融时间序列思维和推理),在FinTSR-Bench上训练。对于确定性的评估(即可从可观察数据中计算),我们使用了计算成本,这是一种可编程成本,使模型能够直接从原始价格中得出答案。对于具有随机性(即受不可观察因素影响)的预测,我们采用了场景感知型预测模型(Scenario-Aware CoT),它在做出判断之前会生成多种场景,反映了金融分析师在不确定性下的推理方式。该方法在FinTSR-Bench上的平均准确率达到78.9%,大大优于LLM和tsrm基线。
简介
时间序列推理模型(TSRMs)在金融时间序列(TS)上表现不佳,因金融TS特性与一般领域不同,且金融推理有评估和预测两种模式,现有TSRMs未区分。
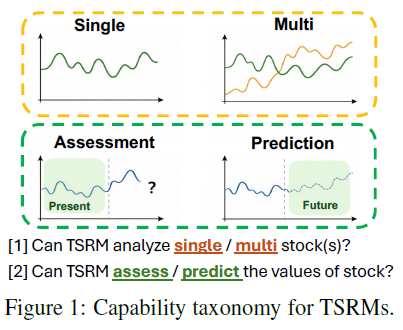
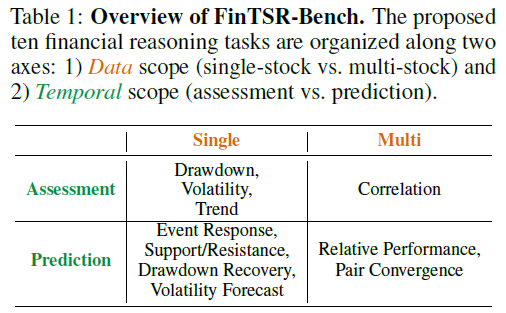
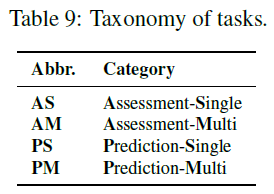
本文提出TSRMs的2×2能力分类法,在金融领域实例化为十个推理任务。构建FinTSR-Bench,含250只标普500股票(2010-2025),35K训练样本和三个各含10K样本的OOD测试集。
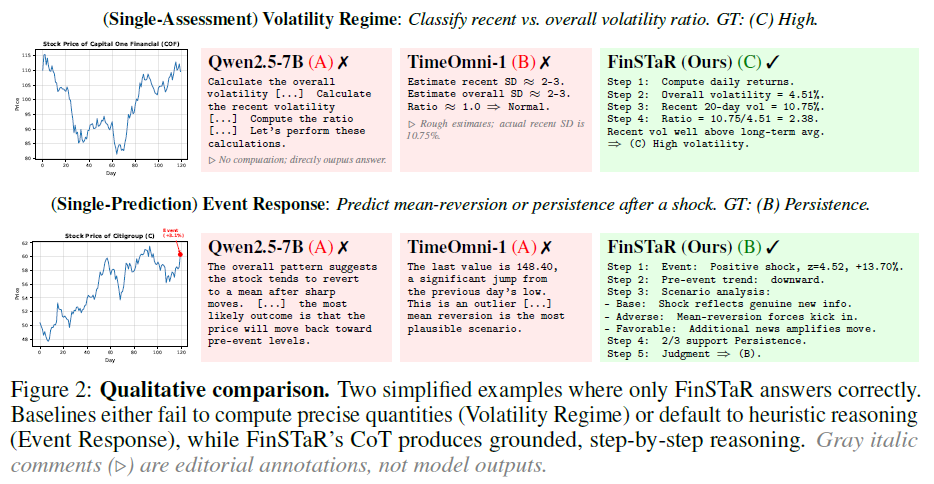
同时提出金融领域FinSTaR,针对评估和预测采用不同思维链(CoT)策略,评估用Compute-in-CoT,预测用Scenario-Aware CoT。FinSTaR整体准确率达78.9%,优于15 + 基线模型,联合训练下四类能力互补。
相关工作
时间序列推理模型(TSRMs)
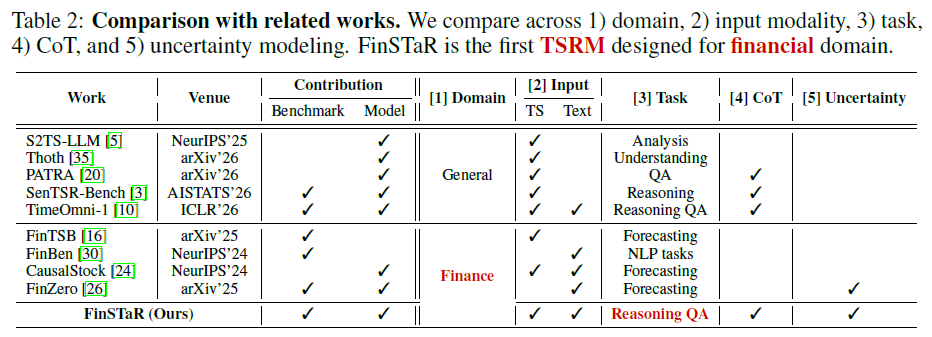
近期工作将大语言模型(LLMs)拓展至时间序列(TS)推理,如 TimeOmni - 1、Thoth 等,但现有 TSRMs 均针对通用领域,未涉及金融 TS。
金融领域LLMs
FinTSB 仅进行股票预测基准测试,FinBen 评估文本任务,News - to - Forecast 和 CausalStock 需文本输入,尚无工作结合原始金融 TS 与推理问答及思维链(CoT)监督,FinSTaR 填补此空白。
CoT 用于结构化数据
CoT 提升 LLM 在数学和科学任务中的推理能力,现有 TS 推理的 CoT 方法难扩展。Compute - in - CoT 确保算术正确性,Scenario - Aware CoT 拓展至随机预测,为新方向。
FinTSR-Bench
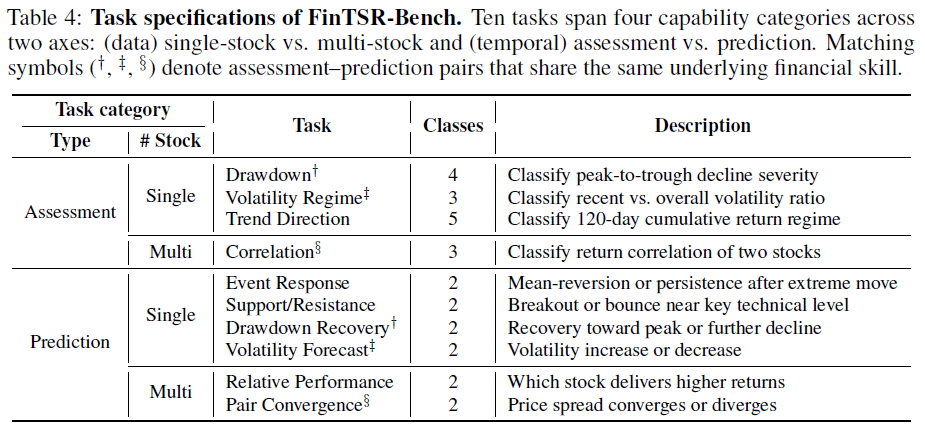
本文提出金融领域 2×2 分类法实例 FinTSR-Bench,包含训练数据集和评估基准,10 个任务覆盖分类法 4 个能力类别。
选取截至 2024 年 1 月市值前 250 的标普 500 股票,2010-2025 年日收盘价数据,200 只用于域内(ID)训练,50 只用于域外(OOD)评估。
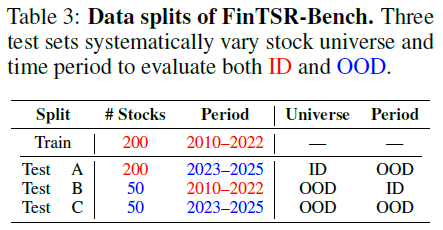
按股票范围和时间轴划分,得到 3 个测试集,各任务每拆分有约 3500 个训练样本和约 1000 个测试样本,训练共约 35000 个,每个测试集约 10000 个。
FinSTaR
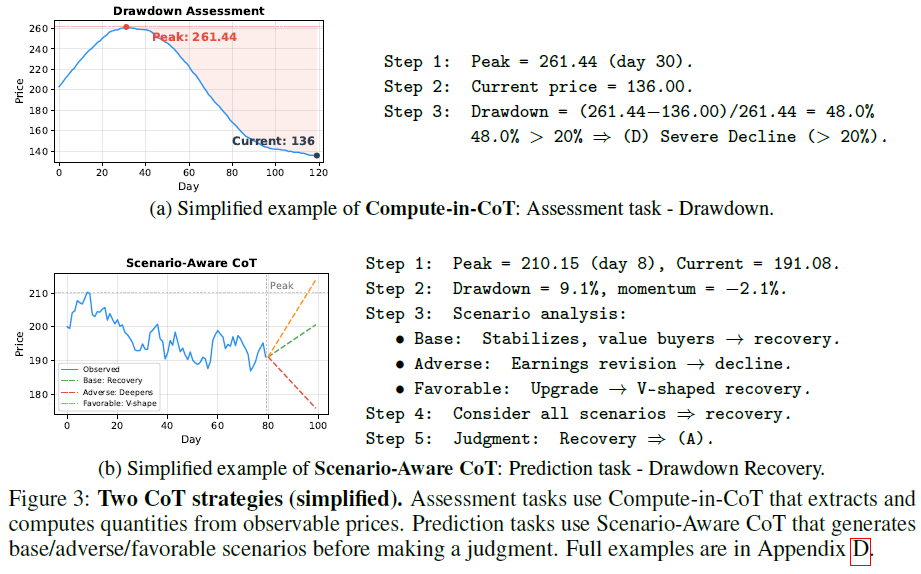
FinSTaR通过在FinTSR-Bench数据上进行监督微调(SFT)训练,针对评估和预测任务采用不同的思维链(CoT)监督策略。评估和预测任务认识论属性不同,评估任务答案由可观测价格数据决定,模型只需计算;预测任务答案受未来不可观测因素影响,即使完美模型预测准确率也无法达100%。因此设计两种互补CoT策略:评估用Compute-in-CoT,预测用Scenario-Aware CoT。
Compute-in-CoT
评估任务答案可从可观测价格确定计算得出。通过执行模型应学习的相同计算来编程生成思维链(CoT),链分三阶段:
1)提取:从输入价格中识别相关量;
2)计算:进行计算;
3)分类:根据问题阈值将计算结果映射到答案。
此方法保证 100% 正确性和无限可扩展性,推理时不参考不可观测信息。
Scenario-Aware CoT
预测任务中,确定性思维链有问题,提出情景感知思维链(Scenario-Aware CoT),其包含五阶段结构:提取相关量、计算价格特征、进行情景分析(含基础、不利、有利情景)、评估情景、做出判断。
定义60个特定领域情景模板,训练时模型学习模式,推理时生成适配输入的情景推理。
训练设置:通过LoRA微调两个骨干模型(TimeOmni-1-7B和Qwen2.5-7B-Instruct),给出LoRA参数、学习率、训练轮数、批次大小等,FinSTaR指用思维链策略微调的TimeOmni-1-7B。
实验
基线
将FinSTaR与四类推理/语言模型基线对比:
1)语言模型;
2)TS语言模型;
3)TS推理模型,其中TimeOmni-1-7B是FinSTaR微调前的基础模型;
4)SFT基线,对Qwen2.5 - 7B在FinTSR - Bench上进行微调。还会在预测任务上与基于预测的方法对比。
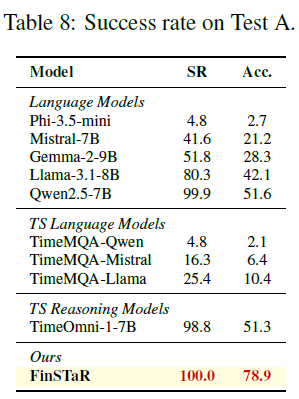
所有1-3的大语言模型基线零样本评估,测试固有推理能力,表格8显示高成功率但低准确率表明输出格式不是主要瓶颈。
结果
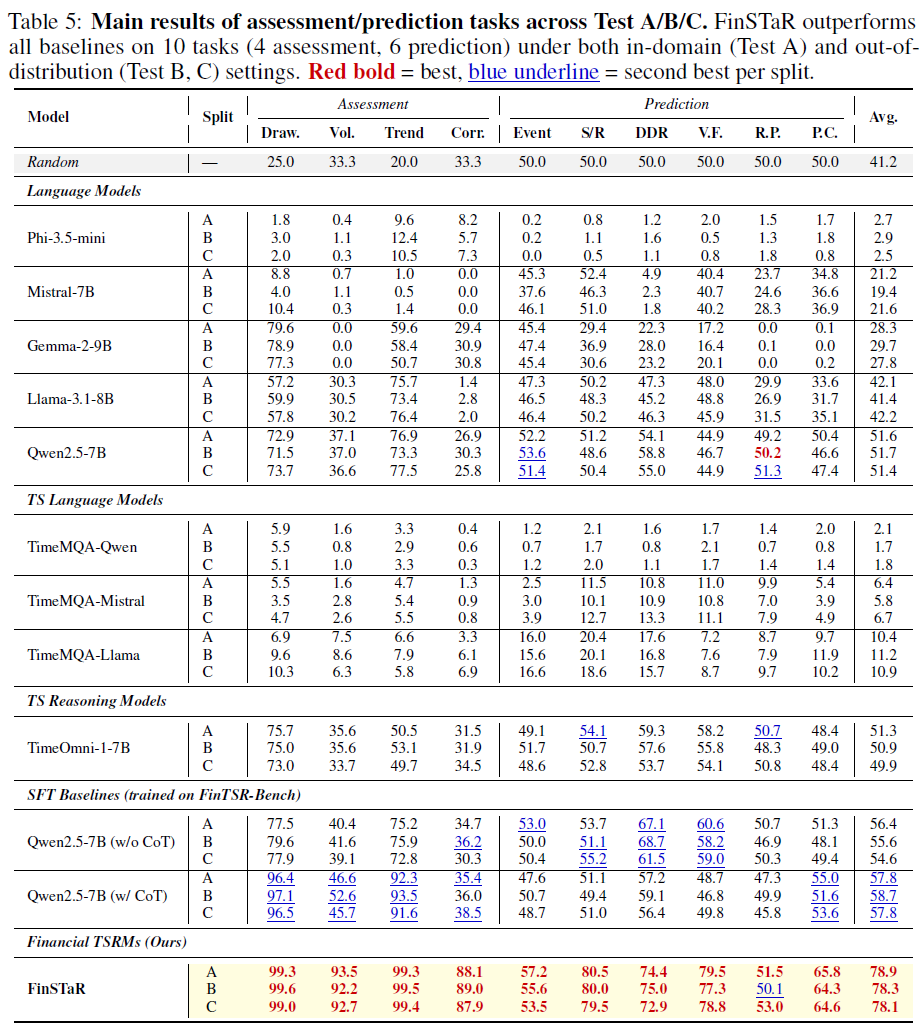
表5对比三个测试集,FinSTaR在Test A准确率78.9%,超最佳零样本LLM、SFT基线、TSRM,在Test B和C表现也佳。
观察发现:
1)评估任务因Compute - inCoT达近完美准确率。
2)预测任务中FinSTaR超所有基线,在波动率预测和支撑/阻力任务提升最大。
3)TimeMQA模型表现不如通用LLM,非金融时序训练难用于金融推理。
4)许多模型在基准测试成功率低,输出格式无效。
5)三个测试集有输入分布偏移,FinSTaR表现稳定,是自然鲁棒性测试。
消融分析
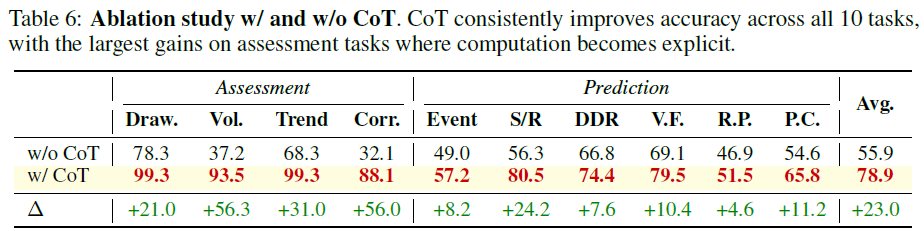
表6对比TimeOmni-1-7B无思维链(仅答案)与有思维链(FinSTaR)情况,思维链在计算明确的评估任务(相关性+56.0、波动性+56.3、趋势+31.0)增益最大,在预测任务(支撑/阻力+24.2等)有适度且一致增益,相对表现增益最小(+4.6)。
Scenario-Aware CoT效果
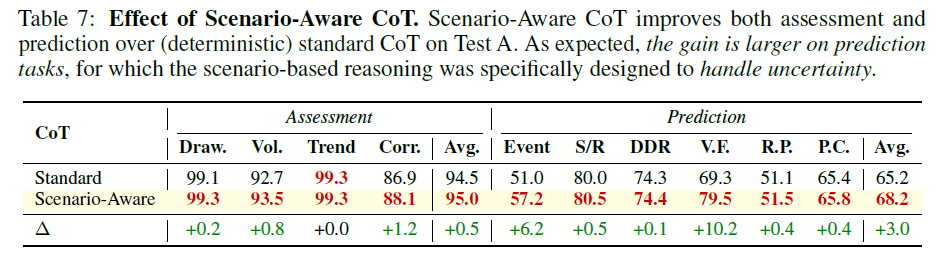
为分离情景感知思维链的影响,对比预测任务的两种思维链配置(确定性标准思维链与概率性情景感知思维链),评估准确性相近,情景感知思维链在预测任务平均提升2.9%(波动率预测+10.2、事件响应+6.2),整体平均提升2.0%,证实情景推理能提升不确定结果的表现。
分析
能力依赖分析
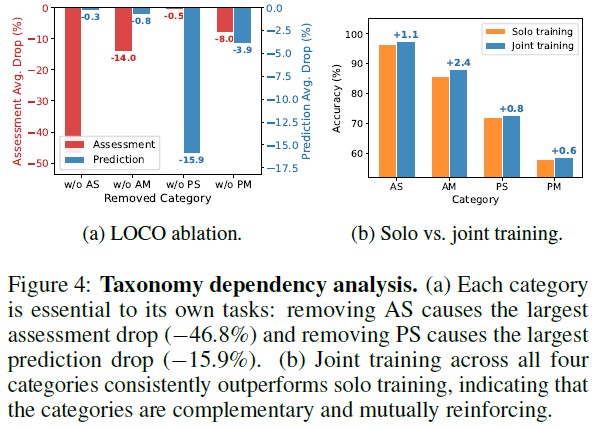
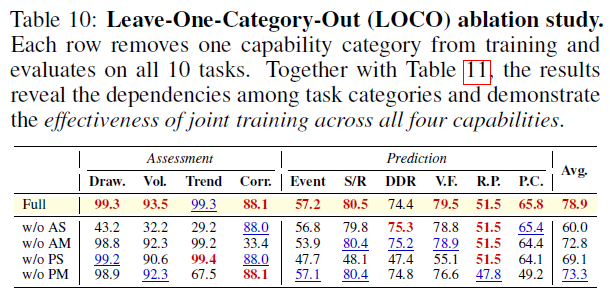
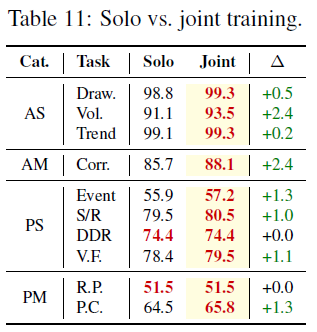
对TimeOmni - 1 - 7B在Test A上进行LOCO消融分析,各能力类别对自身任务至关重要,移除不致其他轴灾难性下降;联合训练比单独训练效果好,四类能力互补互促。
成功率
多数基线模型输出格式不合格,FinSTaR成功率达100%,表明结构化CoT监督可教可靠输出格式。
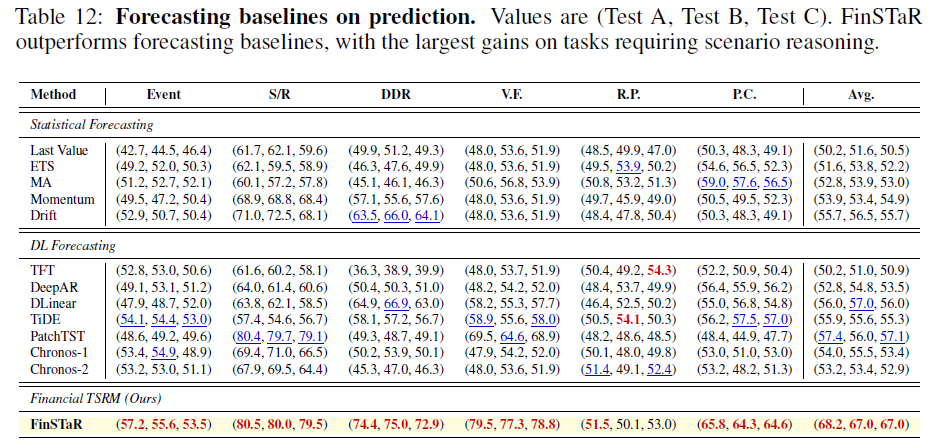
预测任务对比
TSRM可通过推理处理评估和预测,传统TS预测模型通过先预测后分类解决预测任务,FinSTaR在预测任务上优于这些模型。
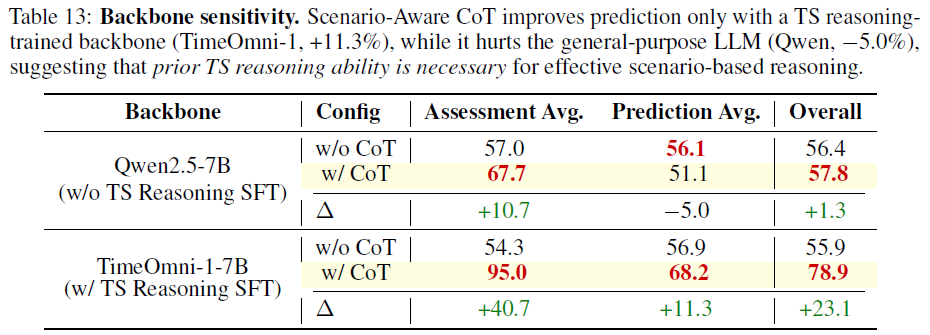
骨干模型敏感性
CoT 提升了 TimeOmni - 1 - 7B 和 Qwen2.5 - 7B 的评估准确率,但在预测任务中,CoT 使 TimeOmni - 1 提升 11.3%,却使 Qwen 降低 5.0%,因情景感知 CoT 需要时间序列推理能力。
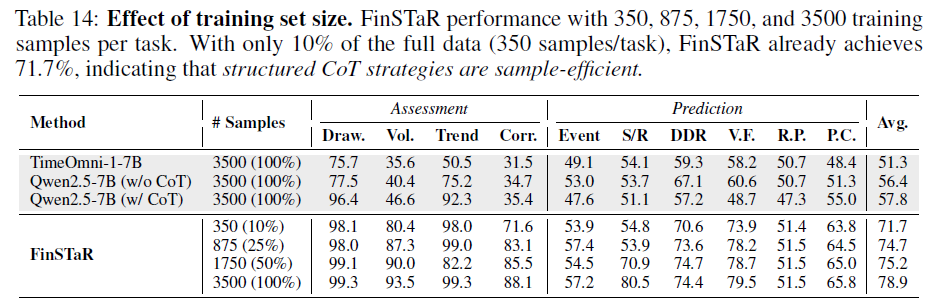
训练集大小影响
FinSTaR 用 350 样本/任务(全量 10%)时准确率达 71.7%,875 个时到 74.7%,1750 个时到 75.2%,之后收益递减,表明策略数据高效。
CoT 质量验证
从四维度验证 FinSTaR 生成有意义推理而非模板复制,包括格式合规(超 99%含有效结构)、算术忠实(准确率超 93%)、情景多样(100 个预测输出中每任务超 85 个独特情景描述)、输出长度(预测 CoT 约为评估 CoT 的 2.4 倍)。
总结
本文介绍首个金融 TSRM FinSTaR,将金融时间序列(TS)推理分为评估和预测,分别应用 Compute-in-CoT 和 Scenario-Aware CoT。2×2 能力分类法对应十个金融推理任务,四类互补互促,场景推理在预测任务上优于标准 CoT。FinSTaR 准确率达 78.9%,大幅超越 15 个以上基线模型。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
