拆解 Agent Loop 的核心逻辑与 Harness 工程架构演进|从玩具 Demo 到工业级 Agent 的必经之路!
大家有没有发现一个诡异的现象:
我们天天聊的 AI Agent,底层依赖的 LLM(大模型),本质上是个“阅后即焚”的一次性工具——每一次推理都是单纯的文本补全,输入 Prompt、输出结果,生命周期瞬间结束,连上次聊了什么都记不住。
但现实里,Claude Code、Cursor 这些顶尖 Agent,却能在沙箱里连续工作几小时,操作几十个工具、修改上百个文件,活脱脱一个“自主打工仔”。
这种“无状态模型”与“高自主性 Agent”的矛盾,恰恰是 Agent 工程的核心密码——Agent 从来不是模型本身,而是模型+外围脚手架的组合体。
而这个脚手架的核心,就是 Agent Loop;整个脚手架体系,就是 Harness 工程。
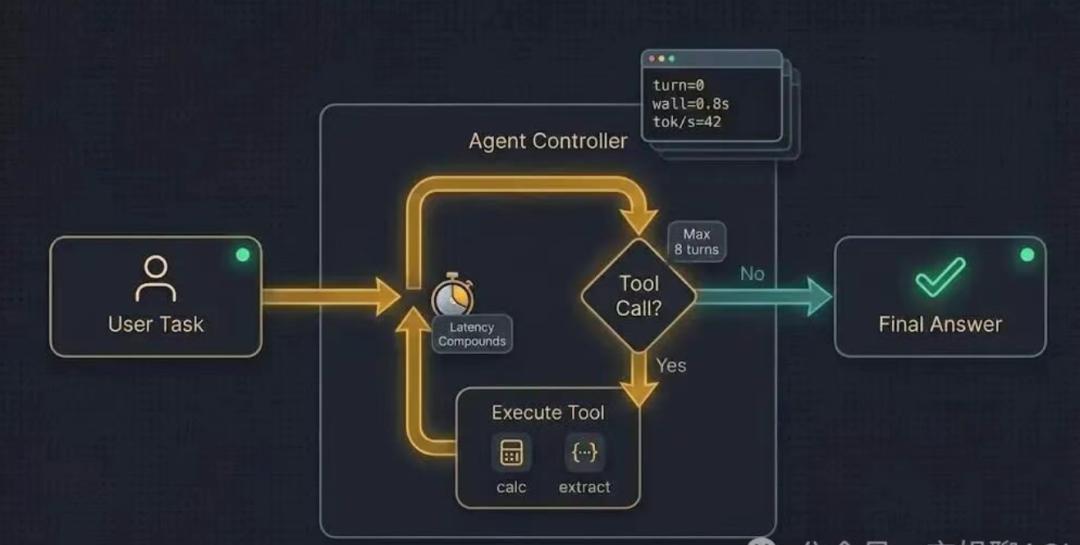
今天这篇,我们不聊虚的,从架构底层拆解 Agent Loop 的核心逻辑、Harness 的关键工程决策,以及从 Demo 到工业级的完整演进路径,帮你吃透 Agent 落地的底层逻辑(附开源实战项目,新手也能上手)。
一、破局反直觉:无状态模型,如何长出“自主性”?
先澄清一个关键认知:LLM 本身是绝对无状态的(Stateless)。
从工程调用层面看,今天的 GPT-4、Claude 3,和 2020 年的 GPT-3 没有本质区别——都是“输入→输出”的一次性函数,单次调用结束后,所有上下文全部清零。
那 Agent 的“自主性”从哪来?答案藏在模型外部的一个简单循环里。
这就是 Agent 工程的第一定律,记死它:
Agent ≠ Model
Agent = Model + Loop + Tools + Context Management
模型的能力,被锁死在“单次推理”上;而让大模型从“文本补全工具”蜕变为“智能体”的,是包裹在它外围的系统层——也就是 Harness(工程脚手架)。
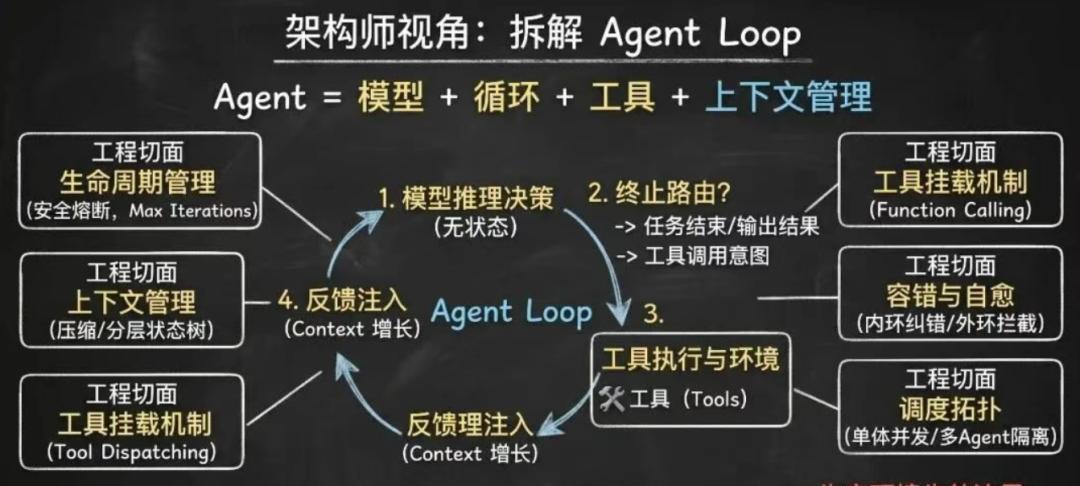
而 Harness 中最核心的调度引擎,就是 Agent Loop。它就像 Agent 的“心脏”,源源不断地给模型输送“上下文养分”,让模型能“记住过去、判断现在、规划未来”。
二、架构原点:20 行伪代码,看懂最小可运行 Agent Loop
剥离所有复杂的多 Agent 协同、记忆机制、多模态特性,一个 Agent Loop 的底层状态机,用 20 行伪代码就能精准概括(新手也能看懂):
messages = [{"role": "user", "content": user_input}]while True: # 1. 模型推理:基于当前上下文生成决策 response = llm(messages, tools=available_tools) messages.append(response) # 2. 终止路由:若无工具调用意图,则视为任务终结 if response.stop_reason != "tool_use": return response.text # 3. 工具执行:与真实环境交互,产生状态变更 for tool_call in response.tool_calls: result = execute(tool_call) # 在沙箱/系统中安全执行 # 4. 状态回灌:将环境反馈注入上下文,形成闭环 messages.append({ "role": "tool", "content": result }) # 进入下一轮循环,模型基于最新上下文重新决策
这段代码,揭示了 Agent “自主性”的全部本质:
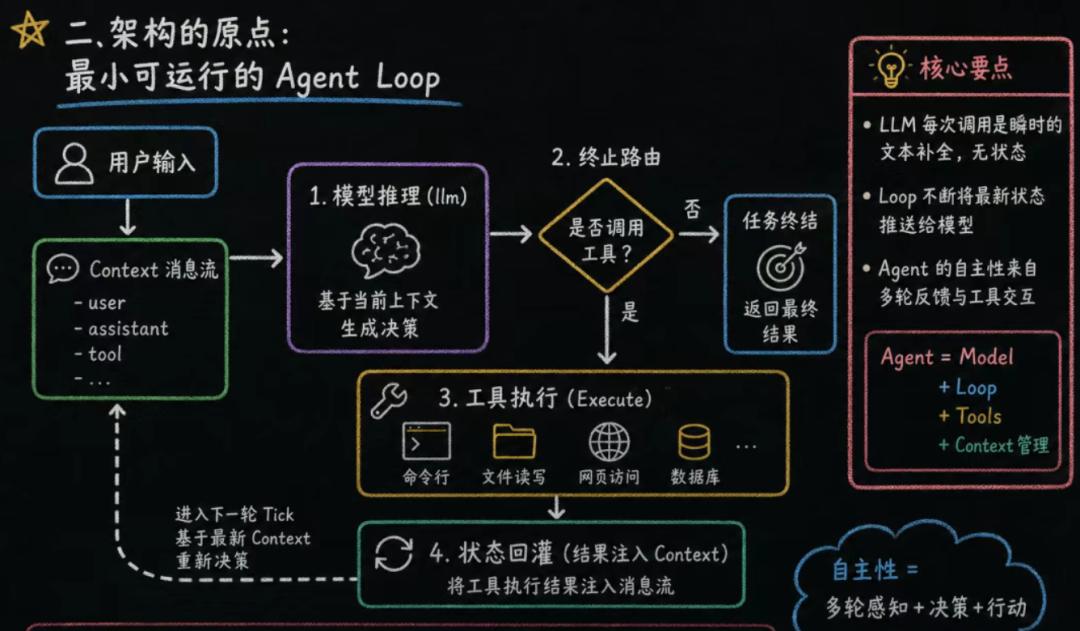
模型从来没有“长线规划”的能力,它的思考永远只发生在 llm() 被调用的那一瞬间。而 Loop 的作用,就是作为“系统节拍器”,不断地将更新后的世界状态(Context)推送到模型面前,让模型“重新补全”决策。
简单说:Agent 的自主性,是架构赋予的,不是模型天生的。
理解了这个极简 Loop,后续所有的多 Agent 协同、记忆压缩、防幻觉设计,本质上都是这个最小循环在不同维度的变体与增强——没有 Loop,就没有真正的 Agent。
三、核心工程决策:Harness 的 5 个关键切面(决定 Agent 能否落地)
刚才的极简 Loop,在 Demo 里能完美运行,但一旦接入真实业务系统(比如修改百个文件、调用多个API),就会立刻暴露问题:算力超标、上下文失控、工具调用失败……
构建企业级 Agent 框架,必须在以下 5 个维度做出工程取舍,每一个都直接决定 Agent 的稳定性和落地能力。
1. 生命周期管理:给 Loop 装“刹车”,防止失控
仅仅依靠模型输出的 stop 信号,在生产环境中极度危险——模型可能陷入死循环,疯狂消耗 Token 或系统资源。必须构建多重防护网:
自然终止:模型主动停止工具调用,任务正常结束;
安全熔断(Max Iterations):设置硬性步数上限(如 50 步),防止死循环;
状态僵死检测:识别“连续调用相同工具+相同参数”的非收敛行为,强制打断;
资源配额:基于 Token 消耗量或执行时间,设置全局超时控制。
2. 上下文生命周期:解决“记不住”的核心痛点
长程任务中,最致命的问题是 Context 线性膨胀——改动 50 个文件,可能积累几十万 Token,不仅推高成本,还会导致模型“注意力稀释”(Lost in the Middle),忘记核心目标。
目前主流的 4 种 Context 管理策略,各有优劣,按需选择:
全量回灌:最粗暴,仅适用于极短任务(如单文件修改);
滑动窗口:保留最近 N 轮上下文,简单但易丢失早期关键约束;
摘要压缩:触发 Token 阈值后,调用模型将历史上下文压缩为高密度知识节点;
分层状态树:目前最稳健的方案(参考 Claude Code 的 /compact 机制),保留“最近操作流水+历史摘要+关键状态表”,既控长又不丢关键信息。
3. 工具挂载机制:打通模型与物理世界的“桥梁”
Agent 要和真实世界交互,必须通过工具——文件读写、Shell 执行、API 调用、浏览器控制等,而工具挂载的方式,直接影响交互效率和稳定性:
原生 Function Calling:结构化约束高,Schema 直接传递给模型引擎,是目前主流且稳定的基座方案;
Prompt 约定解析(如 ReAct 的 XML 标签):适配无原生 FC 能力的本地小模型,或需要极细粒度输出格式控制时,灵活性更强。
4. 容错与自愈:Agent 也要“抗造”
工具执行必然会出异常——文件不存在、API 超时、权限不足……架构的差异,在于“谁来处理异常”:
内环自愈(Trust the Model):将报错信息(如 File Not Found)无损塞回 Context,依赖模型的逻辑推演能力纠错(如反推需要先执行 ls 查看文件);
外环拦截(Trust the Harness):在脚手架层捕获致命错误,执行预设的重试策略、降级方案或抛出报警;
混合范式(推荐):业务逻辑异常交由模型自愈,系统级异常(API 超时、越权)由 Harness 强行接管。
5. 调度拓扑:单 Agent 高效跑,多 Agent 不混乱
当任务复杂度提升(如同时处理日志分析、代码修改、测试验证),单 Agent 会出现上下文污染、决策迟缓的问题,此时需要考虑调度拓扑:
单 Agent 并发:利用模型单次输出多个 Tool Call 的能力,在 Harness 中并行处理,降低系统耗时;
多 Agent 协同(Sub-agents):主 Agent 作为 Planner(规划者),子 Agent 作为 Executor(执行者),每个子 Agent 拥有独立 Loop 和 Context,用状态隔离换取主节点决策的清晰度(参考 learn-claude-code 的 s04 章节)。
四、从原型到工业级:Harness 架构的演进路径(附开源实战)
理论讲再多,不如看一个真实的演进案例——开源教学项目 learn-claude-code(Github 地址:https://github.com/shareAI-lab/learn-claude-code),它精妙地展示了 Harness 从 50 行玩具 Demo,生长为 1000 行工业级脚手架的全过程。
新手建议从 agents/s01_agent_loop.py 开始读,一步步跟着演进,就能吃透 Harness 工程的核心逻辑:
1. 基础连通期(s01-s02):打通“模型→工具”的管道
s01:实现最极简的 while 循环,打通模型与 Bash 工具的调用,完成“输入指令→执行命令→返回结果”的基础闭环——这是所有 Agent 的起点,核心是“能跑起来”。
s02:扩展多工具挂载,引入“调度映射表”(dispatch map),实现“新增工具=新增一个处理函数”,不改动核心 Loop——这是工程可扩展性的基础。
2. 稳定性提升期(s03-s06):解决“跑不远”的问题
s03:引入 TodoWrite 工具,解决“目标漂移”——让 Agent 维护外部 Todo List,将隐性的上下文目标,固化为显性的全局状态板,防止模型执行数十步后忘记核心任务。
s04:引入 Subagent(子智能体),实现状态隔离——主 Agent 负责规划,子 Agent 负责具体执行,每个子 Agent 拥有独立的上下文,避免主节点被无关信息污染。
s06:引入 Context Compact(上下文压缩),解决“上下文膨胀”——触发 Token 阈值后,自动执行三层压缩策略,保留关键信息、压缩冗余内容,这是支撑长程任务的“生命线”。
3. 工业化成熟期(s07-s12):实现“可协同、可管控”
从 s07 开始,逐步引入任务持久化、后台任务、多 Agent 团队协同、工作目录隔离等机制,最终形成完整的工业级 Harness 架构——核心是“不仅能跑,还能稳定、安全地跑”。
整个演进过程,完美印证了 Harness 架构学的核心法则:
The model is the agent. The code is the harness.
模型即 Agent 本体,代码皆为脚手架。我们写下的几千行 Harness 代码,从来没有提升模型的“智商”,只是在为它打造一个容错、可控、高效的运行环境——模型本身已具备 Agent 潜力,Harness 的唯一职责,就是“搭好舞台,防它出错”。
甚至可以说:Harness 越薄,反而证明底座模型的内生能力越强。
五、避坑指南:生产环境中,Agent Loop 最容易失效的 4 种情况
很多人把 Agent Loop 当成“银弹”,但在企业级落地中,它常常在以下 4 个边界触礁,提前规避能少走很多弯路:
1. 上下文雪崩(Context Degradation)
不只是上下文长度爆炸,更可怕的是信息信噪比急剧下降——即使有压缩机制,多次压缩带来的信息损耗,最终会导致模型决策变形(比如忘记核心约束,修改错误文件)。
解决方案:分层状态树 + 定期自省(Reflection),每执行 N 步,让模型复盘当前状态与核心目标,修正偏差。
2. 工具幻觉(Tool Hallucination)
模型虚构未注册的工具,或编造不存在的参数(尤其常见于百亿参数级小模型),导致工具调用失败。
解决方案:在 Harness 层建立严格的 Schema 校验机制,所有工具调用必须匹配预设的参数格式,无效调用直接拦截并反馈给模型。
3. 状态机死锁(Infinite Loops)
比如“修改代码→跑测试失败→撤销修改→跑测试失败”的死循环,模型无法自行跳出局部最优解。
解决方案:引入“动态轨迹评估”(LLM-as-a-Judge),每执行 N 步,让另一个模型评估当前轨迹是否偏离目标,若陷入死循环则强制终止并重新规划。
4. 目标发散(Goal Drift)
执行数十步后,Agent 偏离核心业务诉求(比如原本要修改代码 Bug,最后变成优化文档格式)。
解决方案:上下文压缩 + 工具白名单 + 步数预算 + 定期显式自省,多管齐下,锁定核心目标。
六、终局思考:Harness 会被模型“吞噬”吗?
最后聊一个值得深思的问题:我们今天花大量精力搭建的 Harness 脚手架,未来会被模型本身替代吗?
目前所有的 Agent 架构(Claude Code、LangGraph、OpenClaw 等),本质上都是在给模型“打补丁”:
因为模型记不住,所以我们做上下文压缩;因为模型易跑偏,所以我们做 Todo 列表;因为模型不会协同,所以我们做多 Agent 调度。
而基座模型正在以可怕的速度进化——未来,当具备超长内部推理链、稳定原生 Tool Use、自主规划能力的模型成为标配,一次单纯的 API 调用,或许就能在模型内部跑完整个 Agent 闭环。
到那时,外面这层厚重的 while 循环,可能会被彻底吸收进大模型黑盒,我们今天争论的 Loop 控制策略,也会成为历史。
但也有一种可能:Harness 作为系统边界,会永远存在。
因为企业级应用永远需要确定性——真实世界的数据库、私有文件系统、沙箱环境,永远需要一个桥梁来做权限管控、操作审计、安全隔离。无论模型多强大,它都无法直接对接混乱的物理世界,这就是 Harness 不可替代的价值。
但无论 Agent 的终局形态如何演变,一切复杂业务的起点,依然是那个最朴素、最优雅的 while True 循环。
与其纠结终局,不如从那个极简 Loop 开始,亲手搭建一个属于自己的 Harness——毕竟,Agent 落地的核心,从来不是模型多强,而是你能把脚手架搭得多稳。
最后提醒:Agent 工程的核心是“平衡”——平衡模型能力与 Harness 复杂度,平衡灵活性与稳定性。没有最好的架构,只有最适配业务的架构。
如果觉得这篇干货对你有帮助,欢迎点赞、在看、转发,一起深耕 Agent 工程,把技术落地到实处 ✨