比肩Z-Image!手机上实时图像生成、编辑模型!字节开源
真没想到,图像生成进化到这种程度了!
参数仅有 0.39B,不需要云,不需要电脑 GPU,手机上就能实时生成的顶级图像生成、编辑模型来了。
,时长00:09
这么好的效果,0.39B,时时生成,还能编辑,你敢相信吗?
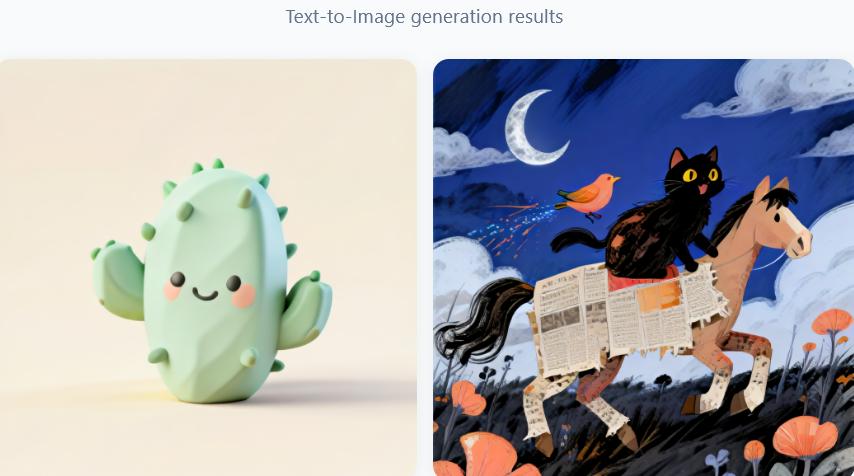
文本到图像直接生成:
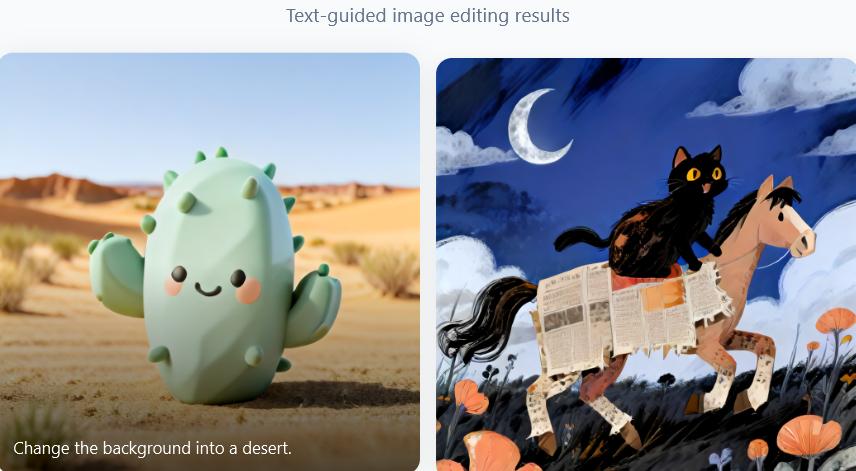
动动嘴(文本)直接编辑:
这就是字节刚刚开源的 DreamLite。
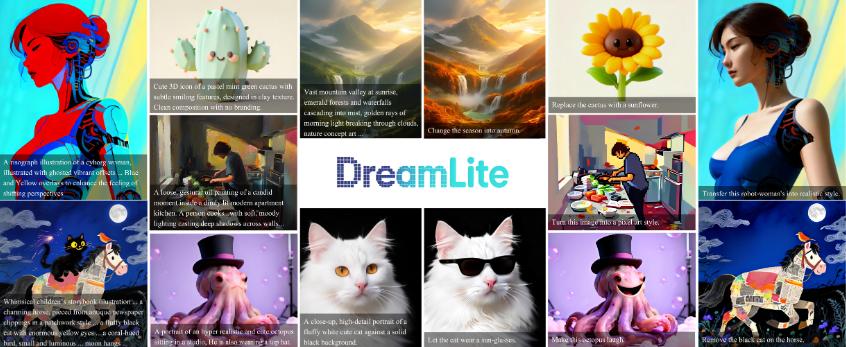
它是一个紧凑的统一设备扩散模型(0.39B),一个模型支持生成和文本引导的图像编辑。
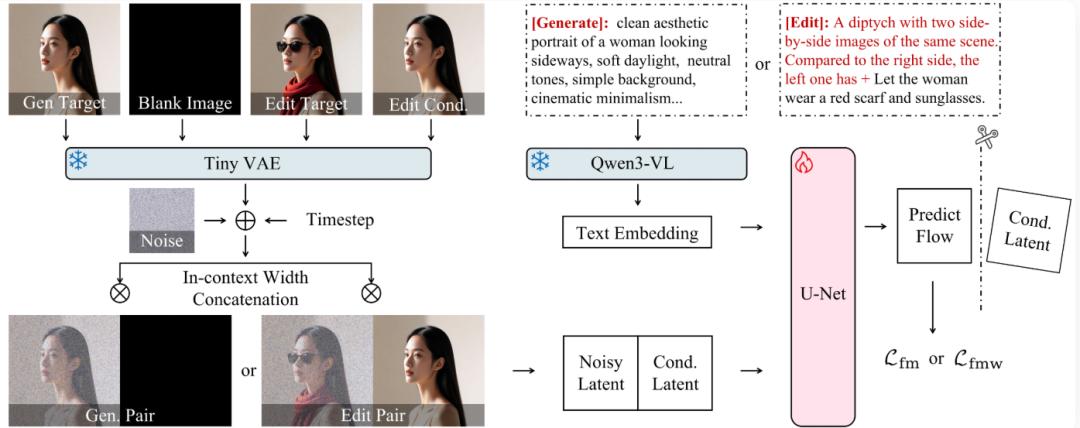
DreamLite 基于修剪的移动 U-Net 骨干上 ,并通过上下文空间连接在潜空间中统一条件。
为稳定该紧凑模型的训练,团队引入了任务渐进式联合预训练策略,依次针对 T2I、编辑和联合任务。
使用 Qwen3-VL 作为文本嵌入模型。继 SFT 和 RL 之后,通过步进蒸馏(step distillation),实现了四步推理。
在 iPhone17 pro 上,4 位 Qwen VL,fp16 的 Tiny VAE 加上 UNet 主干,能在约 3 秒内生成或编辑 1024 × 1024 图像。
这是世界首个统一的设备端模型,支持文本到图像生成和基于文本的图像编辑,消除了部署两个独立模型的麻烦。
引入了 UNet 的上下文条件机制以统一生成和编辑,并提出了任务渐进联合预训练方案(即 T2I→编辑→统一联合训练)以稳定训练模型。
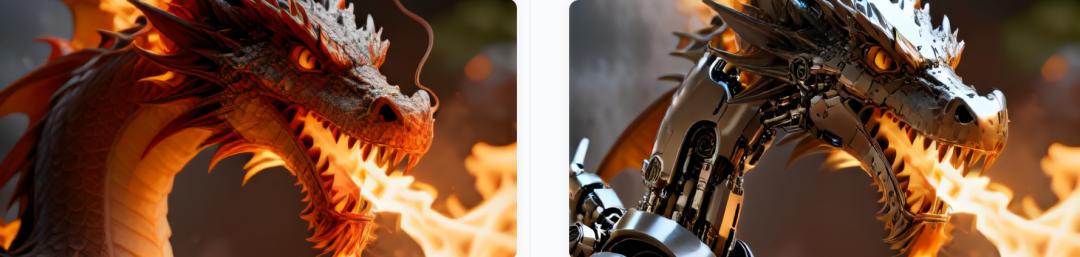
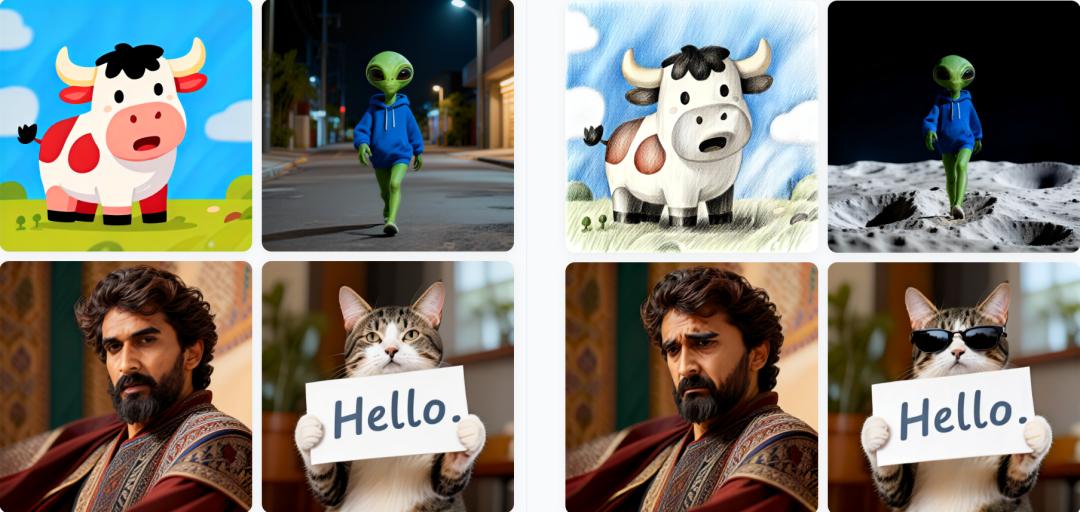
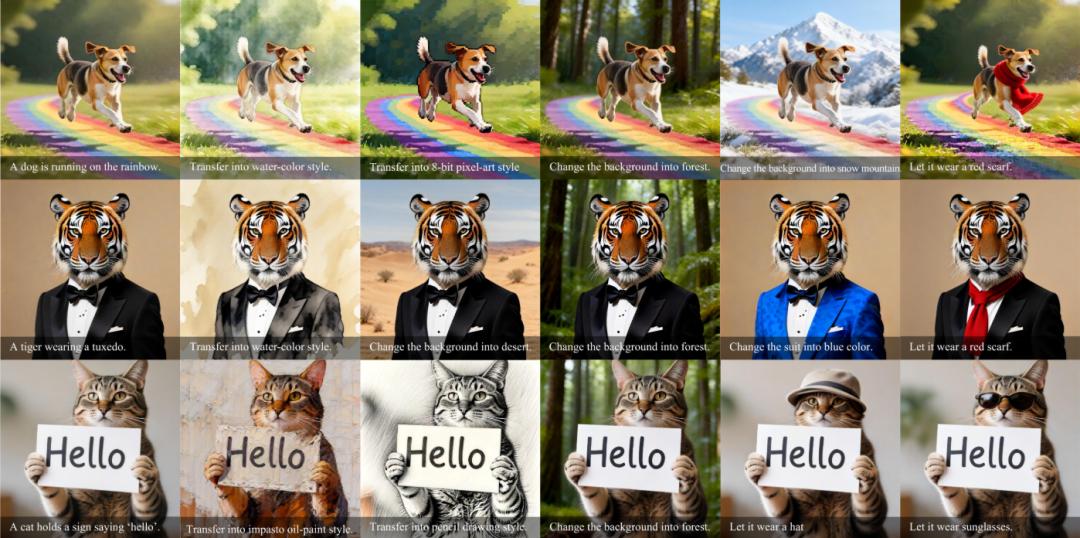
在手机上,各种风格转换,各种局部编辑,统统拿下:
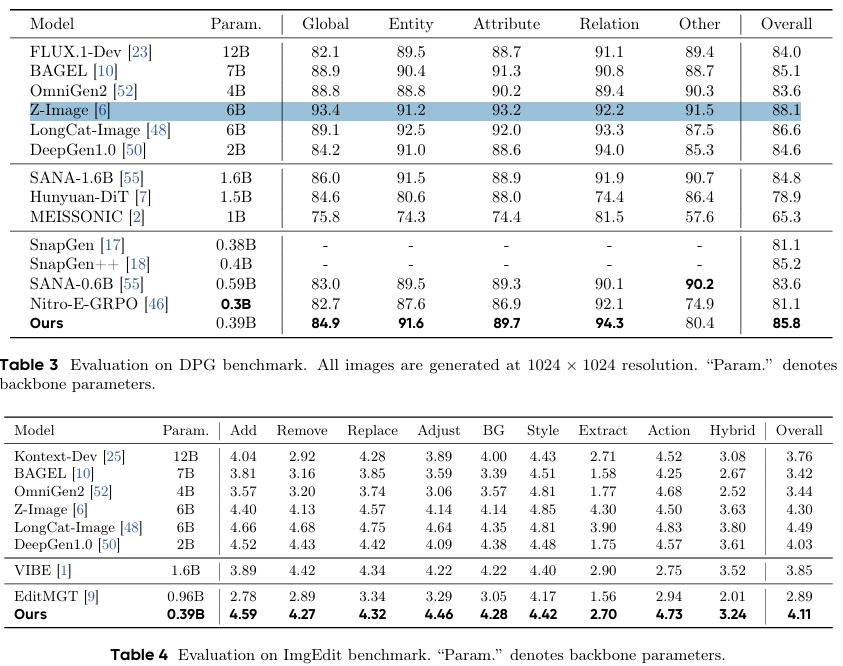
各项测评基准上,比肩 Flux,Z-Image,LongCat-Image 等开源模型。
团队提供了两种不同变体的 DreamLite 模型,以在视觉真实度与设备内推断延迟之间实现最佳平衡。
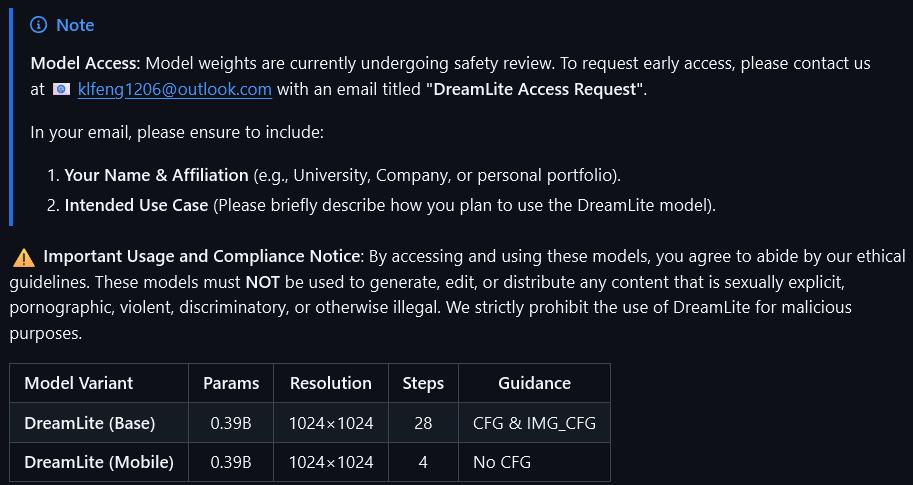
模型权重目前正在进行安全审查。
申请抢先体验,通过电子邮件联系 klfeng1206@outlook.com,邮件抬头写 “DreamLite Access Request”。
请在邮件中确保包含:您的姓名及所属关系(例如,大学、公司或个人作品集);预期使用场景 (请简要描述您计划如何使用 DreamLite 模型)。
可能是模型太强了,太容易传播,团队给了重要警示:“访问和使用这些模型即表示您同意遵守我们的道德准则。这些模型不得用于生成、编辑或传播任何性露骨、色情、暴力、歧视或其他非法内容。我们严格禁止将 DreamLite 用于恶意目的。”
感兴趣的开发者们,赶紧申请来试试。
试玩地址:
https://huggingface.co/spaces/carlofkl/DreamLite
参考资料:
https://carlofkl.github.io/dreamlite/
https://arxiv.org/pdf/2603.28713
https://github.com/ByteVisionLab/DreamLite