GLM-5V-Turbo技术报告解读|如何打败Claude Opus 4.6的秘密都在这里了
为什么你的多模态模型在真实场景中总是“睁眼瞎”?——能看懂图片,却无法理解界面布局;能识别物体,却在GUI操作中频频失误。99%的研究者都忽略了:多模态Agent的瓶颈不在语言推理,而在感知能力的深度缺失。读完本文,你将掌握一种从视觉编码到多任务强化学习的全链路解决方案,以及它如何在11个基准测试中全面超越Claude Opus 4.6。
❓ 核心痛点:为什么你的多模态模型“看不见”?
当前多模态模型面临一个尴尬的现实:它们在标准VQA基准上表现优异,但在真实Agent任务中却频频翻车。当你让模型“点击购物车中的第3件商品”时,它可能无法准确定位;当要求“复现这个网页”时,它可能完全忽略布局细节。问题根源在于——感知能力被严重低估了。
从数据上看,当前最强视觉语言模型在细粒度感知上仍存在系统性错误。例如在空间定位任务中,即使经过大量训练,模型在RefCOCO上的平均准确率仍难以突破90%大关。更致命的是,这些感知错误会向下游传播:一个错误的边界框会导致错误的规划,进而引发错误的执行。感知不是早期可以解决就搁置的Low-Level模块,它持续塑造着更高级多模态能力的上限。
但为什么99%的优化尝试都失败了?关键就在于架构设计上——大多数模型仍然将视觉编码器视为独立的“预处理模块”,而非与语言模型深度融合的“原生组件”。
🚀 原理拆解:硬核但易懂
💡 CogViT视觉编码器
传统视觉编码器面临着“通用感知”与“细粒度理解”之间的根本矛盾。CogViT通过两阶段预训练方案巧妙化解了这一矛盾。
第一阶段采用基于蒸馏的Mask图像建模。具体来说,训练学生ViT模型在两个教师模型的特征空间中重建被Mask的区域(Mask比例35%,分辨率224×224):SigLIP2负责语义表征,DINOv3负责纹理特征。这就像让一个学生同时向两位大师学习——一位教他“这是什么”,另一位教他“这东西长什么样”。
为了验证CogViT的效果,作者在三个基准数据集上进行了对比测试:
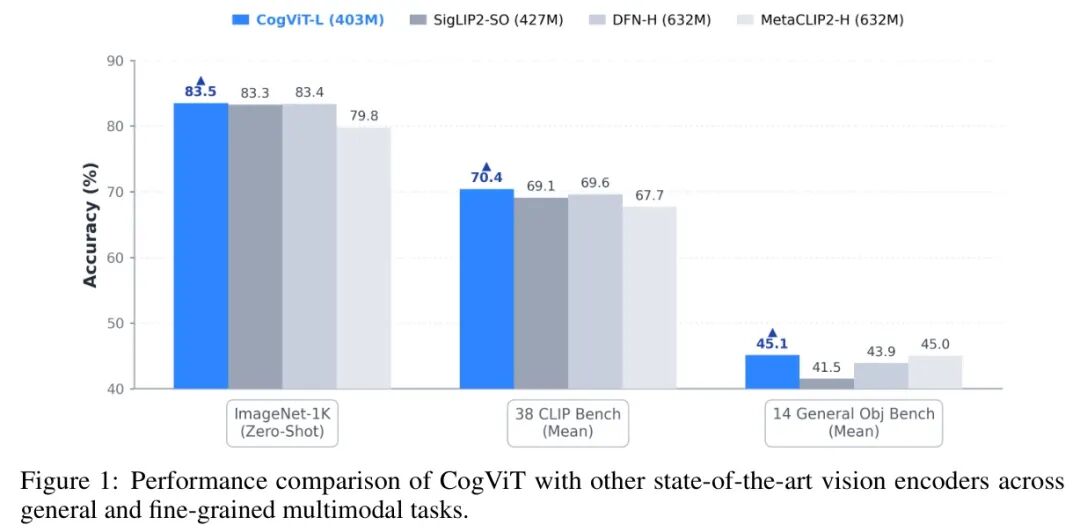
在第二阶段,作者转向对比式图像-文本预训练。关键升级包括:采用NaFlex方案处理可变尺寸输入(保持原始宽高比)、使用基于sigmoid的SigLIP损失将全局batch size扩展至64K、利用80亿条双语图文对增强跨语言理解能力。训练数据遵循质量感知混合策略:80%高质量自然图像、10%指令遵循数据、10%科学图像。
💡 多模态多Token预测
多Token预测(MTP)在纯文本领域已被验证有效,但扩展到多模态时面临一个核心问题:图像Token如何传递到MTP Head?
作者系统比较了三种方案:直接传递视觉嵌入、完全Mask视觉Token、使用共享可学习特殊Token <|image|> 替代所有视觉Token。
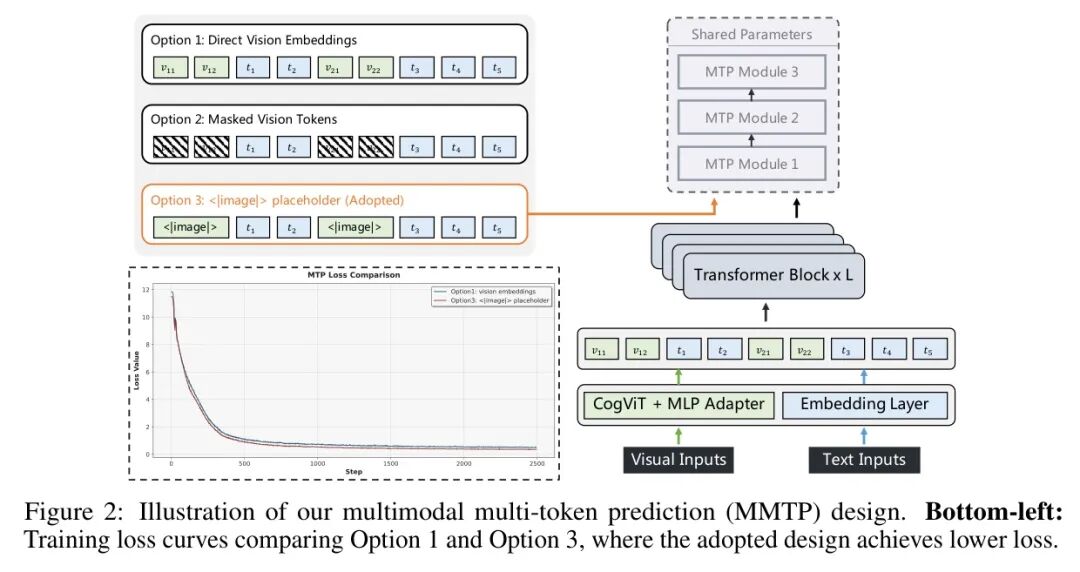
最终采用的第三种方案(Option 3)在优化行为和系统效率之间取得了最佳平衡。使用<|image|> Token消除了在流水线并行阶段间传播视觉嵌入的需求,显著降低了通信复杂度。基于0.5B模型的消融实验显示,该方案相比直接使用视觉嵌入实现了更低的训练损失和更稳定的收敛性。
作者推测原因在于:MTP Head通常较为轻量,可能不具备足够的建模能力来有效吸收分布与文本嵌入差异较大的视觉表示;而<|image|> Token以更统一的形式呈现输入,从而缓解了这一优化难题。
💡 感知、推理与Agent的联合优化
多模态Agent的实际性能取决于感知、推理、规划与执行能力的协同发展。作者从预训练阶段开始就深度融合视觉与语言,多模态数据集涵盖世界知识、交错图文、OCR、代码、GUI、视频、多模态工具使用、空间感知、基础定位以及学术问题求解等广泛类别。
GLM-5V-Turbo进一步在超过30个任务类别上进行了联合强化学习优化。这种广泛训练带来了多层次的提升:
- • 感知方面:2D图像定位在RefCOCO-avg提升4.8%,视频理解在MVBench提升5.6%,3D定位在SUNRGBD提升7.7%,OCR在OCRBench提升4.2%,图表理解在CharXiv提升7.7%
- • 推理方面:STEM任务在MMMU_Val、MMMU_Pro、MathVista和LogicVista上平均提升1.8%
- • Agent方面:GUI Agent在OSWorld提升4.9%,通用工具使用在MMSearch提升3.5%
💡 实战思考:与监督微调中常见的跨领域权衡相比,强化学习表现出更弱的跨领域干扰,允许多个领域共同提升并实现稳定增益。这意味着多任务强化学习的价值不仅在于覆盖更广泛的任务范围,还在于在策略模式层面诱导更深层次的共享。
💡 大规模多模态强化学习
在Agent时代,训练基础设施面临效率与稳定性的双重挑战。作者沿着四个维度系统性地重新设计了训练栈:
- 统一任务与Reward抽象:构建统一的VLM RL Gym,为单步和多步任务提供一致的环境接口
- 全流程解耦与异步化:将rollout推理、Reward评估、批次构建和权重传输解耦,最大化阶段重叠
- 细粒度运行时内存管理:为ViT和投影模块设计独立的内存管理策略,将定向重计算与CPU卸载相结合
- 拓扑感知分区与动态负载均衡:将CP和TP分区操作上移至数据加载阶段,消除跨节点图像块聚合需求
这些设计使得GLM-5V-Turbo能够在处理长视频等序列长度差异显著的视觉输入时,显著降低运行时内存压力,同时保持整体计算效率。
💡 多模态工具链扩展
GLM-5V-Turbo进一步扩展了多模态工具链,使模型能在更真实的环境中支持完整的感知-规划-执行循环。模型展现出维持长程任务参与度的复杂能力,能够频繁在多模态搜索、标注、截图以及多模态网页阅读工具之间切换。
作者还提出了ImageMining基准测试——一个自收集的以视觉为中心的深度搜索基准。与传统VQA不同,ImageMining要求模型通过Agent行为主动挖掘视觉输入,包含217个经过筛选的测试案例,涵盖7个领域和5个推理类别。
💡 多模态深度研究与内容创作
凭借Agent能力,GLM-5V-Turbo实现了完整的多模态深度研究流程,涵盖从异构来源进行迭代信息收集、证据整合到长篇内容合成的全过程。
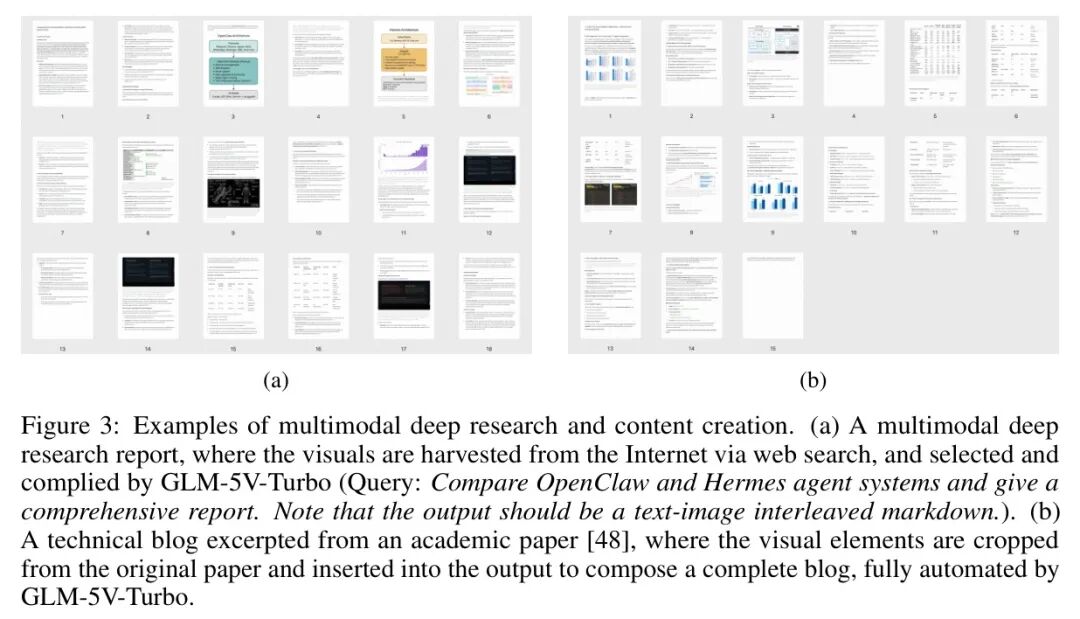
系统核心特征在于其集成的多模态推理能力——GLM-5V-Turbo并非将图像视为外围数据,而是协同提取文本和视觉证据。这对于现实的研究环境至关重要,因为关键见解往往分布在文档布局和视觉元素中,而非孤立地存在于文本段落内。
📊 实验验证:数据说话
🏆 SOTA对比
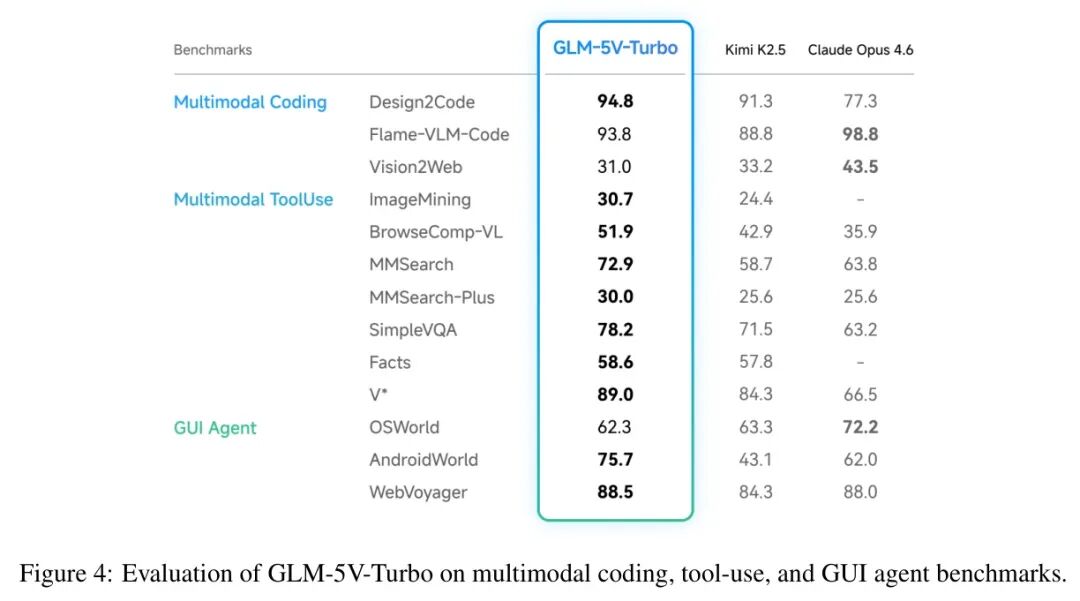
GLM-5V-Turbo在多模态Agent基准测试中取得了优异成绩:
- • 多模态工具使用:ImageMining 30.7分,BrowseComp-VL 51.9分,MMSearch 72.9分,SimpleVQA 78.2分
- • GUI Agent任务:AndroidWorld 75.7分,OSWorld 62.3分
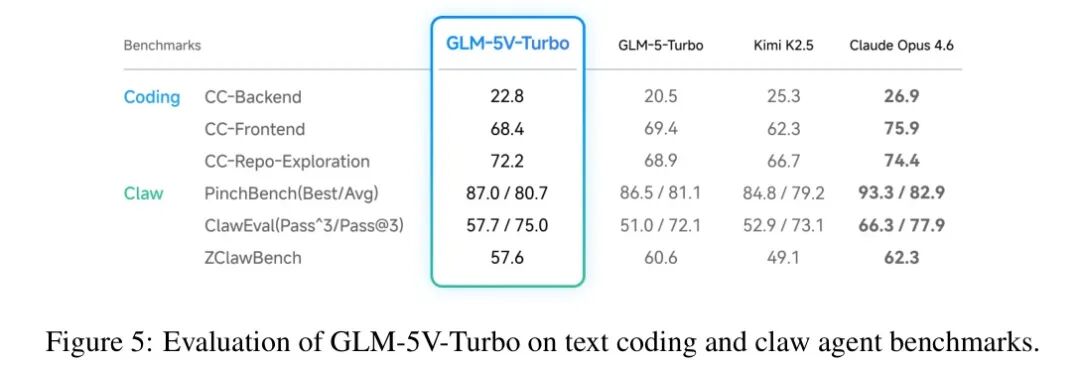
- • 基于Claw的评估:PinchBench 87.0/80.7分,ClawEval 57.7/75.0分,ZClawBench 57.6分
在多模态编码方面,GLM-5V-Turbo在Design2Code上取得了94.8分,超越了Claude Opus 4.6。在纯文本设置下,它保留了基础模型GLM-5-Turbo的编码能力,甚至在CC-Backend(22.8分)、CC-Frontend(68.4分)和CC-RepoExploration(72.2分)上超越了它。
🔬 消融实验
在感知能力方面,强化学习阶段相比监督微调带来了显著提升:RefCOCO-avg提升4.8%,PointBench提升3.2%,MVBench提升5.6%,SUNRGBD提升7.7%,OCRBench提升4.2%,CharXiv提升7.7%。这些数据表明,感知能力并非早期可以解决就搁置的低级模块,它持续塑造着更高级多模态能力的上限。
⚖️ 客观评价
局限性:作者诚实地指出,在强化学习过程中未被覆盖的能力有时会在后训练阶段出现下降,尤其是那些与训练任务分布更正交的能力。一个合理的解释是,随着强化学习的进行,模型容量和习得的思维模式都越来越集中于采样的任务分布周围,从而削弱了模型在代表性不足的领域中保持性能的能力。
计算开销:虽然具体训练成本未公开,但多任务强化学习基础设施的优化(如拓扑感知分区、异步化处理)表明,大规模多模态训练的效率问题正在被系统性解决。
未来展望:最棘手的开放性问题已从单一能力的提升转向Agent策略的涌现、长时程多模态上下文管理,以及模型能力与系统设计之间日益紧密的相互交织。让模型能够自主发现更好的推理和Agent策略,而不是局限于人类提供的初始模式的变体,是下一阶段的核心目标。
🌟 价值升华 + 行动号召
核心收获:
- 感知是第一性原理:多模态Agent的瓶颈不在推理,而在感知——CogViT通过两阶段预训练实现了通用与细粒度感知的统一
- 分层优化优于端到端:在相同的资源约束下,低层级任务比长期任务更容易构建、标注和验证,分层优化是实现稳定Agent训练的有效路径
- 多任务强化学习的涌现效应:超过30个任务的联合优化不仅覆盖更广泛的任务范围,更在策略模式层面诱导深层次的共享与迁移
🤔 深度思考:你认为GLM-5V-Turbo的“感知优先”设计理念最可能颠覆哪个AI应用场景?是自动驾驶中的环境理解、医疗影像中的细粒度分析,还是GUI自动化中的界面操作?欢迎在评论区留下你的观点!
💝 支持原创:如果本文帮到你,点赞+在看就是最好的支持!分享给你的技术伙伴,让更多人看到多模态Agent的前沿进展!
🔔 关注提醒:设为星标,第一时间获取深度技术解读!
#AI技术 #多模态模型 #Agent #模型优化 #技术干货 #论文解读
参考
GLM-5V-Turbo: Toward a Native Foundation Model for Multimodal Agents