LLM因子挖掘:公式搜索还是代码生成?
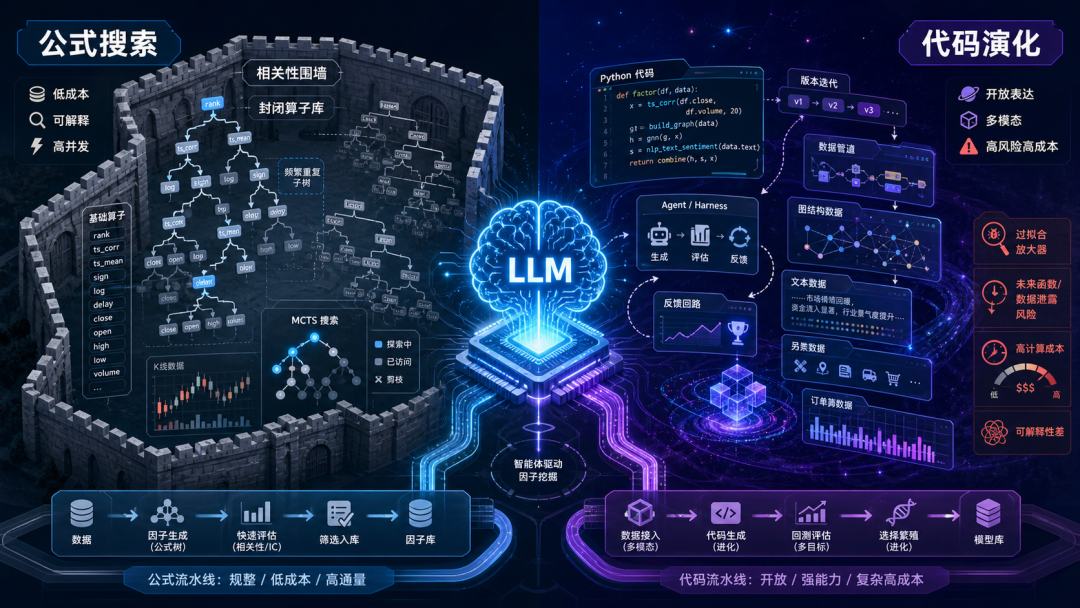
关于 LLM 因子挖掘,之前我们已经介绍过数十篇研究成果,从技术路径来看,基本上分为两种:公式搜索和代码演化。 今天主要想跟大家讨论一下他们适合什么场景,各自的边界在哪里?
一、公式搜索的困境:相关性围墙
2015年WorldQuant发表Alpha101之后,国内量化圈有过一段"集体抄作业"的时期。你去看当时各家的因子库,不管是私募还是券商金工组,底层算子来来去去就是那几十个:rank、ts_corr、ts_mean、sign、log、delay,加上close、open、high、low、volume五个基础字段。排列组合一下,确实能搞出不少花样。
所有人都用同一套字母表,写出来的东西就像GP生成的因子一样,彼此的因子相关性过高。
AlphaAgent那篇KDD 2025的论文里有个数据挺扎心:传统GP和纯LLM公式搜索生成的因子,在AST子树同构检测下重复率高得惊人。你以为LLM"原创"出来的新因子,和另一个团队用同样的LLM、同样的算子库跑出来的,本质上可能是同一棵树的不同枝条。
2024年之后,这种同质化变本加厉。LLM加算子库几乎成了行业标配,新因子出的速度越来越快,死的速度也越来越快。
在这个背景下, 以AlphaJungle为代表的论文提出了一种思路——在公式空间里把搜索做到极致。清华交叉信息院Yu Shi团队的核心创新是LLM加MCTS做公式树上的多步优化:把公式空间建模成搜索树,LLM给节点打分,MCTS负责做多步lookahead。相比CoT的单步生成、ToT的简单树搜索,MCTS会评估每个分支的长期潜力。
论文的效果很好:CSI300和CSI1000,训练期2011-2020,测试期拉到2024年11月。结果确实是SOTA级别。而且作者引入了一个频繁子树规避机制(FSA)——做过公式搜索的人都知道,生成因子越多,后面越容易出重复的变形,有效产出率越来越低,FSA能维持较高的有效因子产出率。
其中有个现象很有意思:MCTS搜索预算B=3时效果最好,B太大反而浪费算力。这说明公式空间的"好因子密度"确实是有限的。你可以用更聪明的搜索算法榨取剩余价值,但改变不了搜索空间本身有边界的事实。
这个边界是什么?根据我自己的经验,大概有三层。
第一层是算子库的闭包。 AlphaJungle用的算子库大概五六十个基础算子,AST深度限制在5-7层。这个空间是封闭的——所有因子都是已有算子的排列组合。好比一个厨子只能用盐、糖、酱油、醋、料酒,他能做很多菜,但永远做不出需要松露或分子料理的菜。2024年初我想做一个"产业链上下游传导"的因子——需要PageRank或图中心性计算。传统算子库里没有"中心性"这个概念,ts_corr能做的只是线性相关,和图结构上的信息传导完全不是一回事。最后只能手写代码跳出公式框架。
第二层是非数值规律的盲区。 公式本质上是数值运算。但CEO在财报电话会上的语气变化、供应链中断的传导路径、订单簿里冰山订单的检测——这些都不是数值关系。你再怎么组合close和volume,也组合不出"CEO语气被动化"这个信号。
第三层最隐蔽——同质化的加速器。 我做过一个测试:用同样的prompt、同样的算子库、三个不同的API key让GPT生成100个因子,AST子树同构检测显示超过40%在结构上高度相似。当市场上80%的量化团队都在用同一套配置时,搜索空间的重叠度是惊人的。AlphaAgent论文提出的"原创性强制"和"复杂度控制"机制,本质上是在给公式搜索打补丁——用正则化延缓同质化。但补丁再好,也改变不了搜索空间本身封闭的事实。
AlphaJungle把公式搜索推到了工程极限。但它突破不了根本限制:你只能在定义的字母表里造词,无法发明新的语言。
二、代码演化:Agent 打破因子挖掘天花板
CogALPHA和QuantaAlpha等工作走了完全不同的路——它们不再试图优化公式搜索,而是直接跳出公式空间,让LLM写Python代码,在图灵完备的程序空间里做进化。
表达方式的本质发生了变化。你描述市场的语言变了,你能描述的市场规律也就变了。
CogALPHA的论文里有一句话很直接:"Most existing LLM-based alpha mining methods remain constrained to formulaic searches, exploring only shallow regions of the factor space."
这里说的LLM生成因子代码,并不是几十行简单的代码计算,而是一个完整的Harness模块——包含代码检查、改进和反馈回路。只有做到这一步,才能真正实现自动化的因子挖掘与迭代。
为什么这很重要?我自己测试中发现,单一LLM最容易陷入的幻觉就是"IC高=好因子"。有一个因子IC 0.04,看着不错,但turnover高达80%,日均换手接近全仓进出,实盘根本执行不了。多Agent独立评估至少能从不同角度发现问题。从结果上看,这个架构比我以前做的单Agent因子生成靠谱得多——单一LLM很容易陷入自我确认偏误,自己生成、自己评估、给自己打高分。
QuantaAlpha走的不是多Agent协作路线,而是单条进化轨迹的深度自我改进。它的核心概念叫"轨迹级自进化"——把整个挖矿过程看成一条轨迹,LLM不仅生成代码,还会反思之前哪一步做错了,然后只修改局部,而不是推翻重来。这个思路和人类调试代码的行为很像:不会因为一个bug就全部重写,而是定位到具体行修改。
两者还有一个更深层的区别:公式搜索的底层假设是写在算子设计里的,而代码演化没有这种预设。当市场的数据生成过程发生变化时,前者需要人工去调整假设,后者可以自行适配。
三、但代码演化不是银弹
当然凡事有利肯定有弊,代码演化同样存在一定的风险。
过拟合放大器
公式搜索有一个隐性的自我保护机制:预定义算子库是因果的。ts_corr(close, volume, 20)天然不会泄露未来信息。但代码呢?LLM写的Python代码没有任何结构性的因果保护。
举一个很隐蔽的例子,大家通常在做行业分类时为了方便只用某一截面的分类,但其实已经用到了未来信息。 这只是冰山一角。更隐蔽的情况:LLM可能在groupby的层级上搞错,可能在shift的方向上正负号写反,可能在rolling窗口的边界处理上出问题。这些代码能跑通、能回测、能产生漂亮的结果——但结果是假的。CogALPHA和QuantaAlpha都提到有质量检查机制,但都没有公开详细说明如何检测代码级未来函数。据我所知,行业内也没有成熟的自动化工具来做这件事。这是代码演化从论文走向实盘的最大拦路虎。
可解释性的噩梦
rank(ts_corr(close, volume, 20)),一行公式人类可以秒懂——"量价相关性在过去20天的横截面排名"。你拿着它去跟老板讲,三句话说明白。
但代码演化出来的精英因子呢?CogALPHA论文附录里有一个因子IC高达0.0507,逻辑涉及低价相对30天EMA、log收益率和log成交量的soft-sign斜率、EMA12与EMA48的余弦相位组合。说实话,我自己都要看三遍才能勉强解释清楚,更别提跟别人去解释。
计算成本
公式搜索的成本结构:生成一条公式(几百token)→ 解析(秒级)→ 回测(秒级)。候选因子的全生命周期成本极低,可以并发跑几千个。代码演化的成本结构完全不同:生成一段代码(上千token)→ 执行(可能包含复杂计算)→ 回测。如果代码里有PageRank或复杂的pandas groupby,单次执行时间可能比公式长10到100倍。以GPT/Claude的API定价来算,大规模代码演化一天烧掉几百美元是很容易的事。进化搜索的核心是大量候选的生成-评估-淘汰,单个候选成本高10倍,整个搜索过程的成本就是10倍。
因子幻觉
公式搜索里的幻觉容易被捕获:LLM生成一个不存在的算子,解析器直接报错。代码演化里的幻觉根本不会被捕获——代码能跑通、能回测,只是逻辑不是你想要的那样。
四、技术路径如何选
以下是我关于技术路径选择个人的一些建议:
需要快速原型验证的时候,公式搜索的成本优势太明显——成本低、迭代快、调试简单。传统数值因子扩展、合规要求极强的机构产品,公式搜索的算子库够用且可解释性是硬约束。
但当你需要处理非数值数据(文本、图结构、另类数据),或者做跨模态融合(量价+产业链网络+财报文本),公式根本表达不了,代码演化几乎是唯一选择。探索全新数据源的原创Alpha,同样需要代码级别的灵活性。
高并发大规模批量搜索的场景下,公式搜索的执行效率更高、成本可控。代码演化更适合在特定domain上做深度钻探,而不是全面铺开。
我目前的做法是两条pipeline并行:公式层每天跑几百个候选做高通量筛选,代码层只在产业链文本和订单簿微观结构这两个domain上做深度探索。
五、一点个人判断
2015年Alpha101开源时,它定义了一个时代的因子挖掘语法。十年后,我们发现在这个语法里能写出的好句子越来越少了。
AlphaJungle代表了公式搜索的工程极限——MCTS多步优化把符号空间的搜索效率推到了极致,但它无法突破符号空间本身的边界。CogALPHA和QuantaAlpha代表了另一种可能——跳出符号牢笼,在图灵完备的程序空间里做开放演化。
我在过去一年里同时跑过两条线,公式搜索在80%的日常场景里更高效、更可控,代码演化在涉及文本、图结构、另类数据的场景里展现出了公式无法企及的能力。
2026年还不会是代码演化大规模替代公式搜索的年份。真正的拐点取决Harness for Alpha 的成熟。
市场从来不同情只会一种工具的人。但它也不会因为你会用更多工具,就对你更仁慈。
参考文献
[1] Shi, Y., Duan, Y., & Li, J. (2025). Navigating the Alpha Jungle: An LLM-Powered MCTS Framework for Formulaic Factor Mining. arXiv:2505.11122.
[2] Liu, F. et al. (2026). CogALPHA: Cognitive Alpha Mining via LLM-Driven Code-Based Evolution. ACL 2026. arXiv:2511.18850v2.
[3] Han, J. et al. (2026). QuantaAlpha: An Evolutionary Framework for LLM-Driven Alpha Mining. ICLR 2026 Under Review. arXiv:2602.07085.
[4] Tang, J. et al. (2025). AlphaAgent: LLM-Driven Alpha Mining with Regularized Exploration. KDD 2025. arXiv:2502.16789.
[5] Kakushadze, Z. (2015). 101 Formulaic Alphas. Wilmott Magazine.
关于QuantML
QuantML 是链接全球顶尖量化人才的高端社群,我们聚焦于机器学习在量化投资中的最前沿应用。
核心价值:
- 顶级圈层: 社区涵盖头部机构从业者、知名私募创始人、机构量化负责人,基金经理,券商金工分析师、GitHub千星作者及顶会学者构成。
- 每日高价值内容: 持续分享前沿论文、论文研报复现、模型代码、核心Alpha因子以及QuantML-Qlib框架等。
加入我们,与最强大脑同行,洞见量化未来。