智能体世界模型综述晓读:3级能力×4种世界,我们还只是在第1级
“世界模型”这个词最近很烫。2026年初,腾讯和阿里在同一天各自发布了世界模型产品;李飞飞的World Labs拿到10亿美元融资;智源研究院把世界模型列为2026年AI十大趋势之首,称之为“通用人工智能(AGI)的共识方向”。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
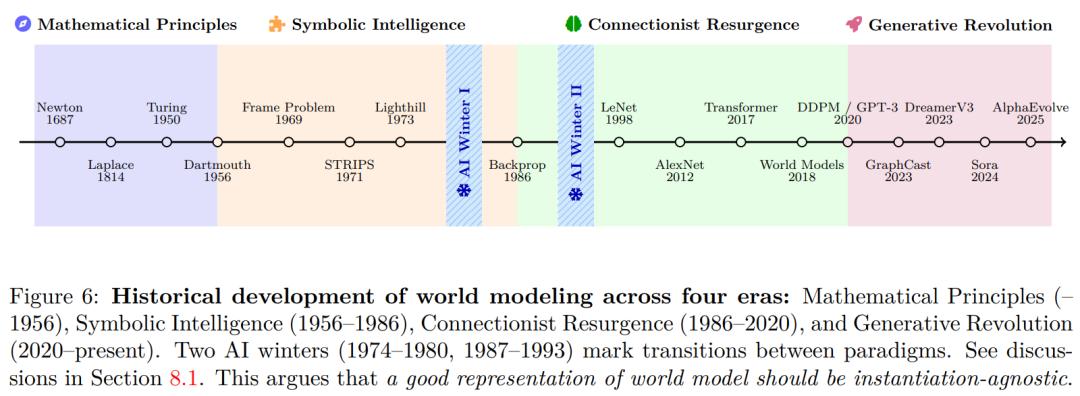
但当所有人都在聊“世界模型”时,一个尴尬的问题浮出来:大家说的“世界模型”,根本不是一回事。视觉领域的世界模型是能生成连贯视频的;强化学习训练的世界模型是用来“脑补”未来状态的;语言智能体把文本模拟当成世界模型。
那到底什么是世界模型?能不能有一套统一的语言,让搞视觉的、搞规划的、搞社交模拟的人坐下来聊聊?
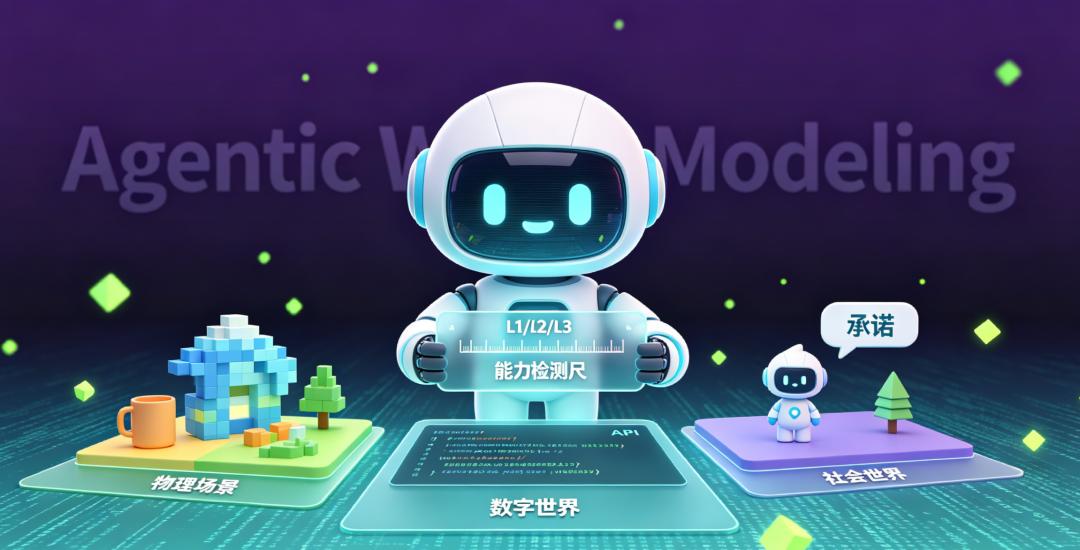
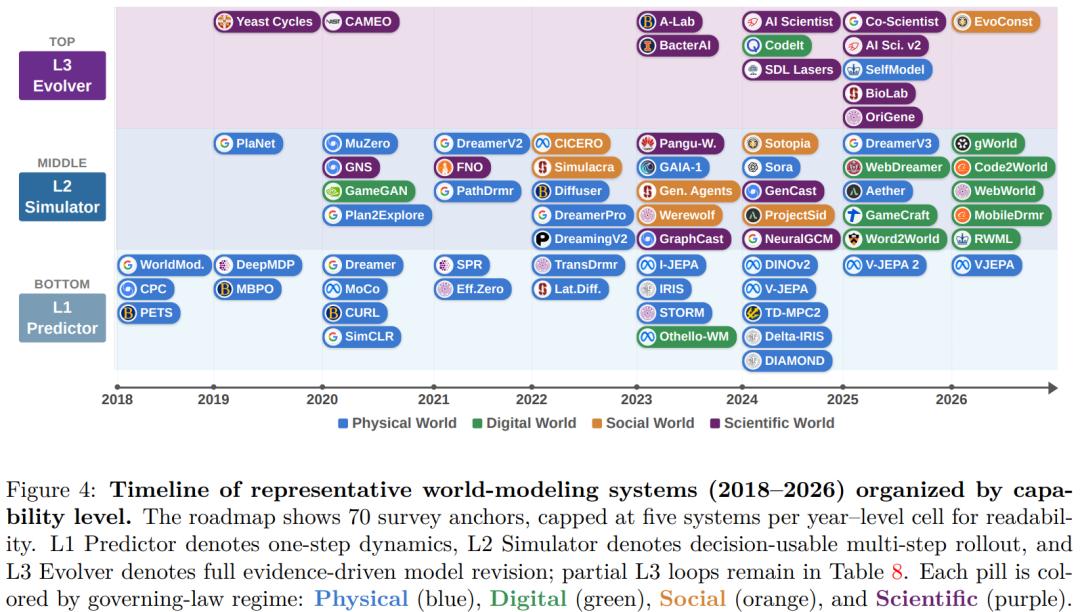
一篇汇聚了港科大、新加坡国立、牛津、港大等机构三十多位研究者的论文《Agentic World Modeling》,试图给出答案。它没有提出一个新的基准,也没有训练一个刷新记录的模型。它做的是一件更“底层”的事:提出一个名为“能力层级 × 治理定律”的框架,梳理了百篇相关研究,找出不同领域共享的认知结构。
这让我读的时候反复想起一句话:分类,是理解世界的开始。
三层能力金字塔:为什么L3是整个AI的终极圣杯
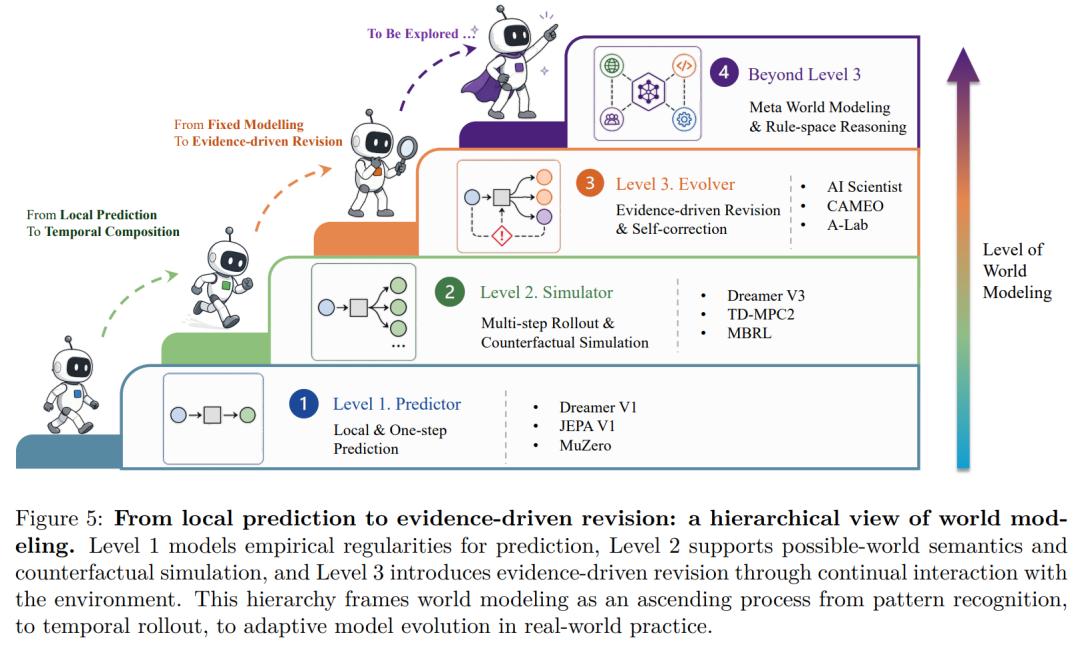
这篇论文最核心的贡献,不只是告诉你世界模型L1、L2、L3层级有什么区别。它构建了一个完整的能力演进框架,每一层都有硬性的检验标准。我把这三层的本质拆给你看。
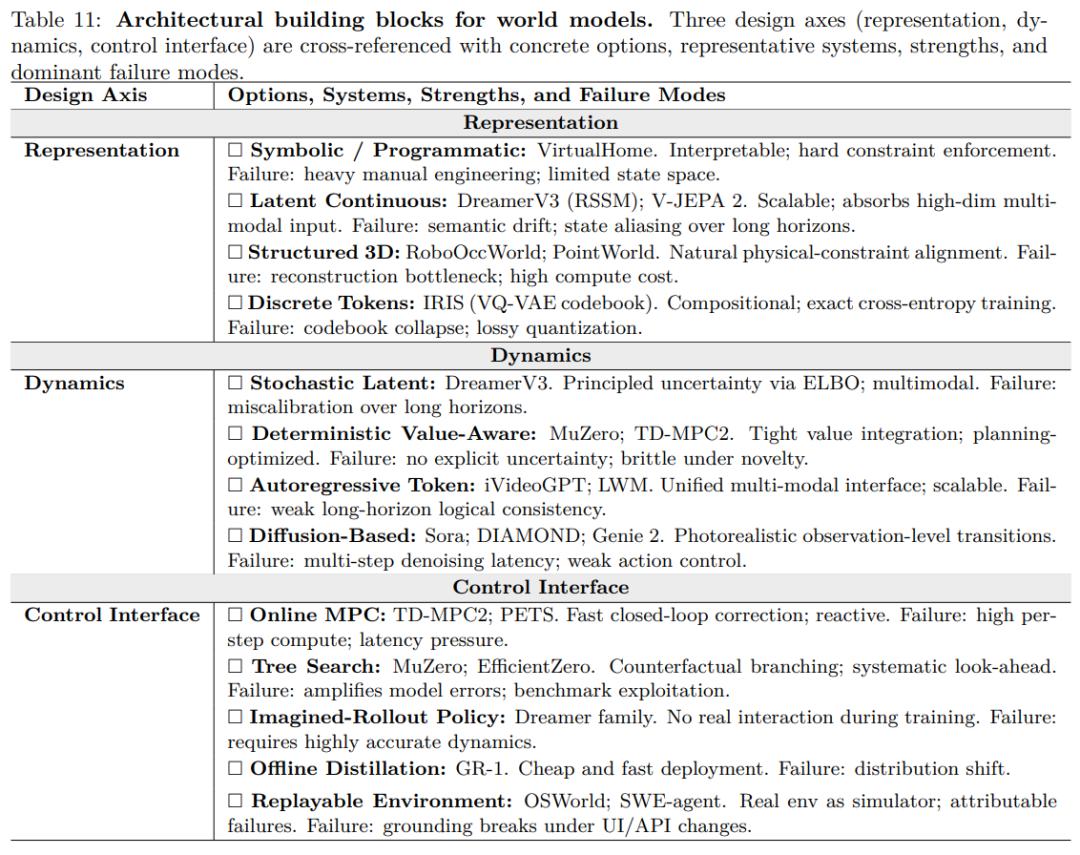
L1预测器:局部感知,见招拆招。
这个层级的世界模型,只做一件事——给定当前状态和动作,预测下一个状态。你可以理解为它有一个内在的马尔可夫链:只会走一步看一步。
它的四个核心组件,论文里讲得很清楚:状态推理(从观察到压缩状态)、前向动力学(状态+动作→下一个状态)、观测解码(状态→还原观测)、逆动力学(从两个状态推断中间发生了什么动作)。
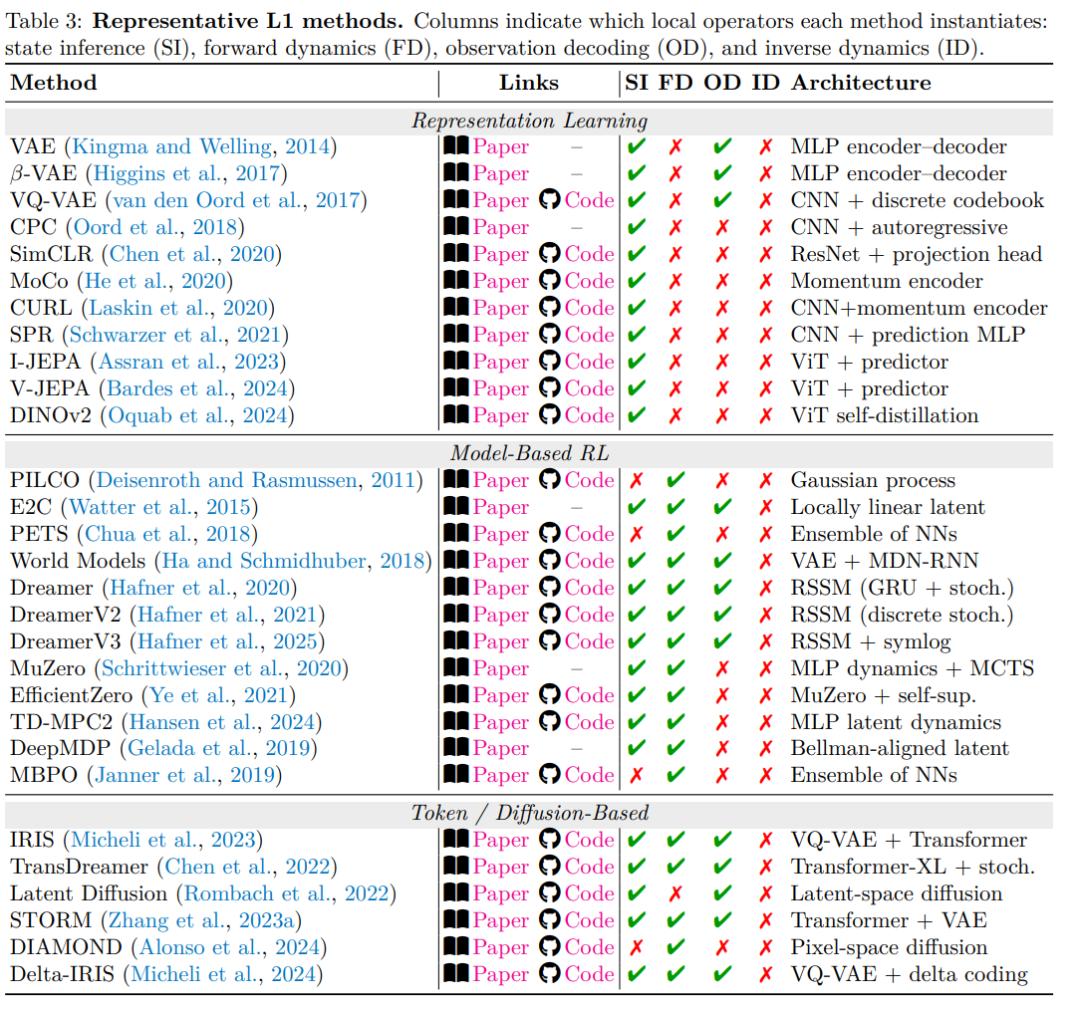
Dreamer系列就是L1的典型代表——它能把高维的像素压缩成低维的隐状态,然后在这个隐状态空间里预测下一步。但关键在于,它是"一步优化"的。每一步的预测都是局部最优,至于连续走了10步以后会滚到哪里去,它完全不保证。
这就是L1的死穴:一步预测的精度再高,也不等于长程模拟的可靠性。
L2模拟器:长程推演,约束下的反事实推理。
从L1升级到L2,不是把一步预测重复10次那么简单。论文给出了三个硬性门槛,缺一个都不叫L2:
第一,长程一致性。连续推演100步,你的预测还可用吗?还是误差指数爆炸,到第15步就已经和真实世界毫无关系了?
第二,干预敏感度。改变动作输入,输出有相应的有意义的改变吗?如果没有,你做的不是模拟,只是画面补全。
第三,约束一致性。生成的结果尊重这个世界的规则吗?物理世界的东西不会穿模,数字世界的API调用不会凭空出现,社会世界的承诺不会被遗忘,科学世界的分子键不会奇迹般断裂。
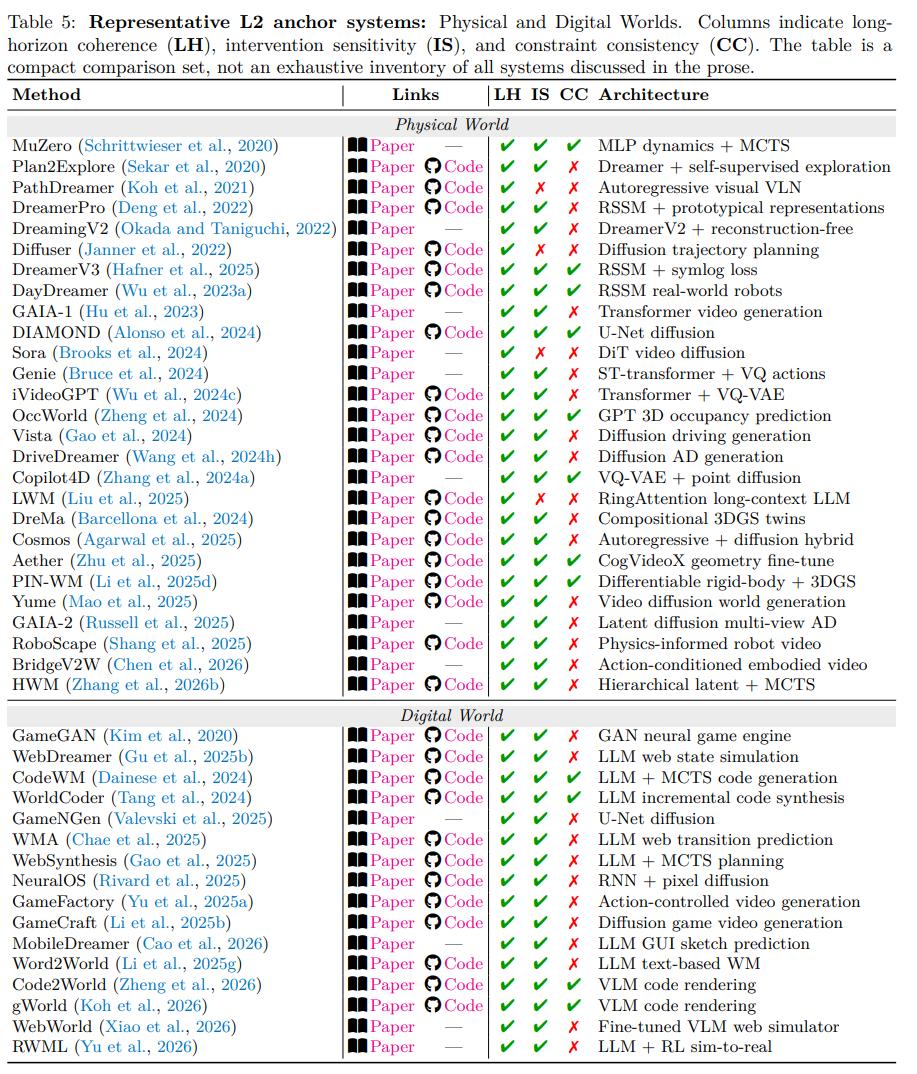
这三个门槛,卡掉了目前绝大多数的所谓"世界模型"。能过第一条的,可能是个还行的视频预测器。三条都过,才配叫L2。
论文把L2再按"规则宇宙"分了四类——物理世界、数字世界、社会世界、科学世界。这个分类太妙了。因为不同的规则宇宙里,"约束"的本质完全不同。
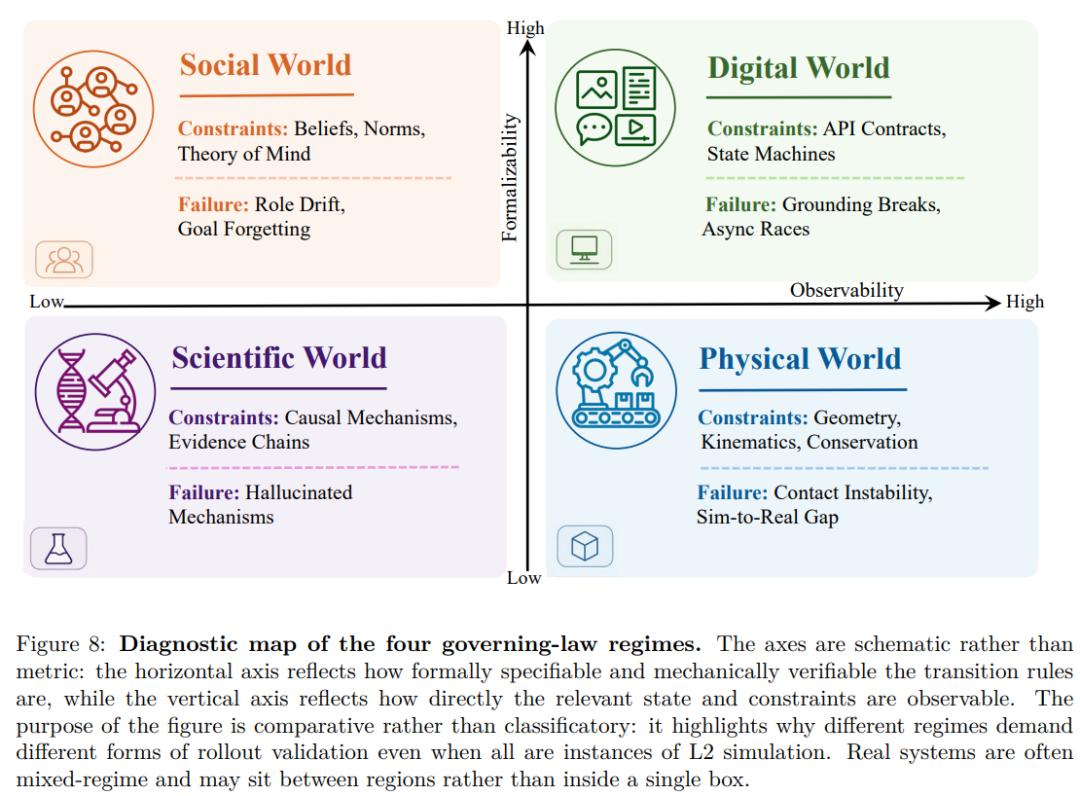
物理世界好办,牛顿力学在那摆着,穿模了、重力反向了,一看就知道。但社会世界呢?一个社交Agent承诺了三天后给你发文件,三天后它的对话里完全没有提这件事——这叫承诺失忆,在社会世界模型里就是一次约束崩塌。
这套框架最狠的地方在于,它让模糊的"好不好"变成了可测的"过没过"。一个系统能不能叫L2模拟器,不是看你论文里怎么写的,而是看它在这些测试门槛上能不能立住。
L3进化器:自我修正,让模型结构成为可修改的对象。
如果L2是"在这个规则宇宙里玩明白",L3就是"当规则宇宙的规则改了,或者我发现我对规则的理解是错的,我能自己修正"。
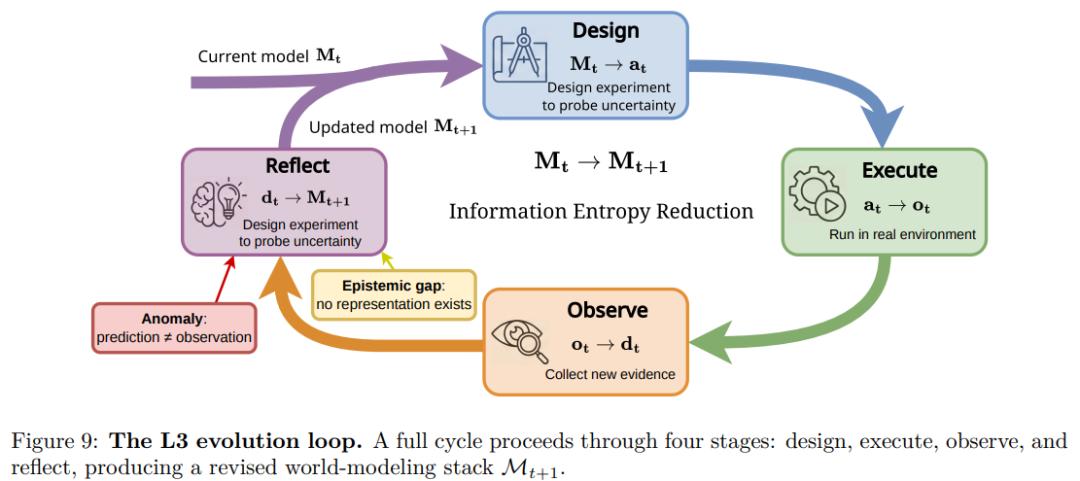
这个概念在AI圈里被提过很多次,但一直缺乏精确的界定。这篇论文给出了三个L3的特有能力:
第一,主动的信息扩张。不是等着数据来,而是主动设计实验去探测不确定的区域。
第二,自主执行和观测。不是模拟实验结果,而是真去做了实验,采集了真实的观测数据。
第三,基于挑战的信念修正。当实验数据打脸了模型的预测,不是甩锅说数据有噪音,而是真的修改模型本身——包括参数、结构,甚至假设空间。
读到这你就明白了,L3和L2的本质区别是什么:L2的模型是固定的,L3的模型是自己会变的。
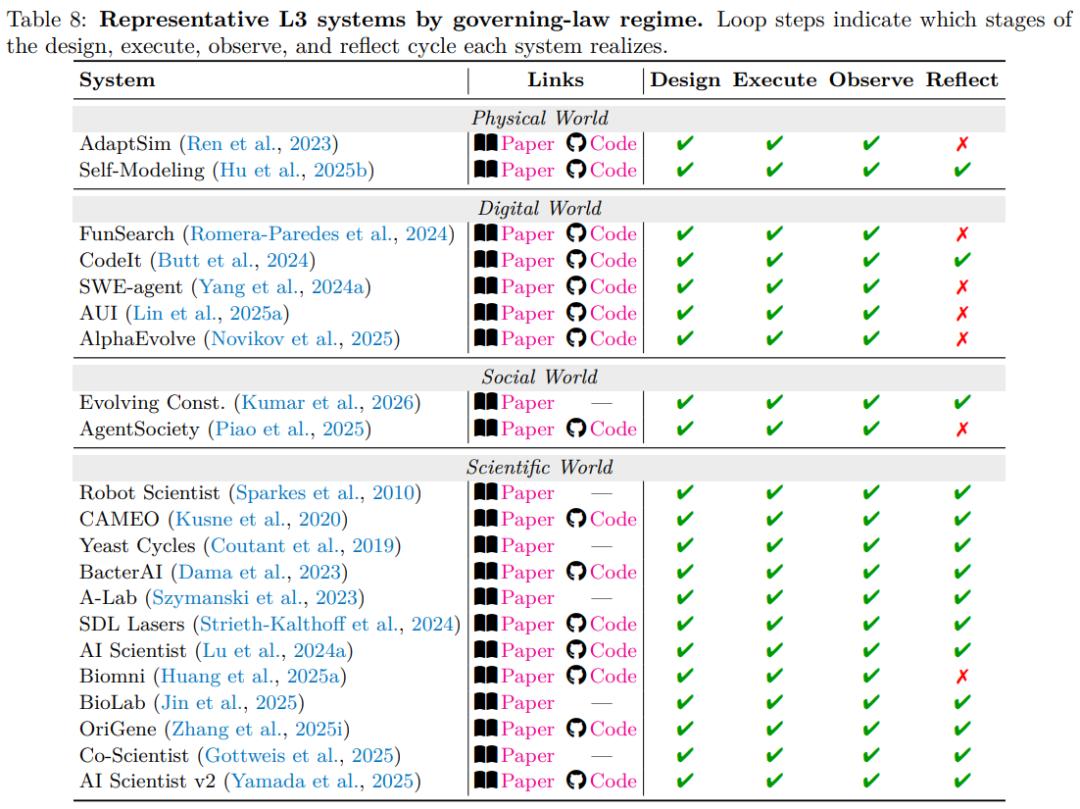
而且论文里讲清楚了三种"变"的层次:最浅的是参数更新——拿新数据微调一下权重;深一点的是结构调整——加个新模块、扩展个专家网络;最深的是假设空间扩展——发现当前模型完全没法解释这个现象,需要引入全新的变量或机制。
这第三种变化,对应的是科学史上的范式革命。当年牛顿力学解释不了水星轨道进动,不是参数调一调就能解决的——是整个模型的结构要从牛顿的绝对时空,改成爱因斯坦的弯曲时空。
这就是L3的真正含义:不是"我错了,我改",而是"我发现自己连理解这个问题的维度都不够,我得重新搭一个更完整的认知框架"。
最让我头皮发麻的发现:大部分"世界模型",连L1都做不扎实
读完论文里关于跨域对比的部分,我有一个很深的感受:我们行业对"世界模型"这个词的滥用,已经到了极其危险的地步。
举几个论文里点破的反直觉结论。
第一个反直觉结论:视觉越真,物理越假。
那些能生成超清视频的扩散模型,看起来真实到让人产生幻觉,但它们在"物体永不出现在不可能区域"这类基础物理约束上,表现反而比简单的结构化模型更差。
原因其实很好理解。高保真视频模型的目标函数是"像素看起来对不对",而不是"物理上对不对"。一个杯子缓缓穿过桌面的画面,如果像素过渡做得足够好,从视觉角度看是没有违和感的——人眼需要额外认知加工才能判断出"穿模了"。但对物理约束检测来说,穿模就是一刀切的对错。
所以你用Sora这种系统做具身智能的训练数据,等于用劣质的物理模拟教机器人认识世界——你的数据看起来再真,底层规则也是错的。
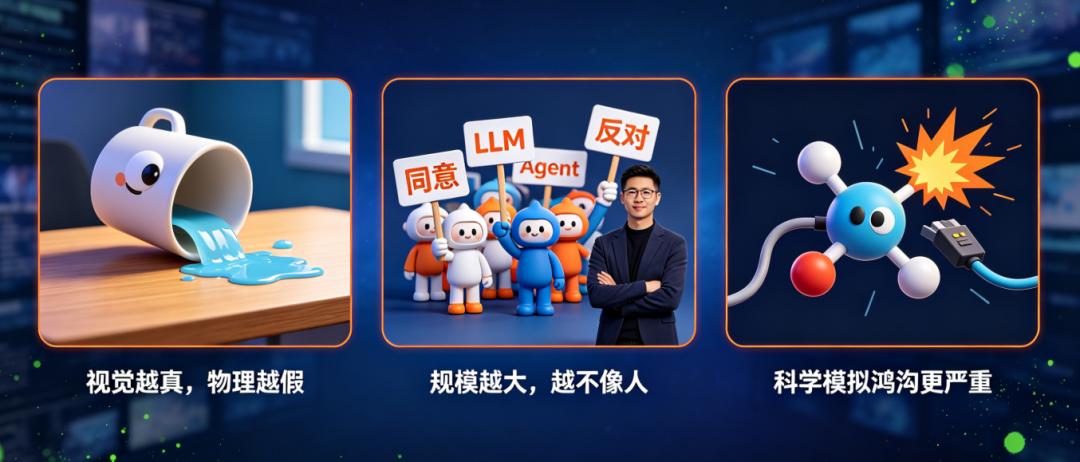
第二个反直觉结论:社会模拟的规模越大,人的行为反而越不像人。
现在的社会模拟可以跑上万个Agent同时交互,生成几百万条对话。但论文里引用的研究发现了一个细思极恐的现象——LLM Agent有系统性的共识偏差。它们天然趋于温和、妥协、达成一致,不像真人那样会固执、极端、撕裂。
一个社会模拟里的Agent,如果都按照同一套语言模型分布生成行为,模拟到最后会收敛到一个同质的"好市民"状态。但真实社会的结构,恰恰是由那些不按套路出牌的人推动的。
这就是社会世界建模的死结:你无法用今天这种训练方式得到的语言模型,模拟出真正的社会异质性。
第三个反直觉结论:科学世界模型的"模拟-现实鸿沟",比机器人还严重。
做过机器人的都知道Sim-to-Real有多头疼——仿真器里训练好的策略,到了真实世界因为摩擦、接触动力学、传感器噪音的变化,全崩了。
但论文指出,科学世界模型的这个问题更隐蔽。神经网络势能函数在分子动力学仿真里可以跑出极高的精度,可一旦遇到真实实验测量的结构数据,预测误差会呈现一个可怕的特征——计算数据越多,误差以幂律下降,但到一定程度就停滞了。没有真实实验数据校准,纯靠仿真训练的模型存在一个硬天花板。
这意味着,那些号称"用AI加速材料发现"的系统,如果没有闭环的实验验证能力(也就是L3的能力),本质上只是在沙滩上盖楼。
工程落地指南:你的系统该停在L1还是冲刺L3?
这篇论文不光告诉你"是什么",还告诉你"怎么做"。它给了一个从L1到L3的工程路线图,我把它拆成对从业者最实用的三条决策逻辑。
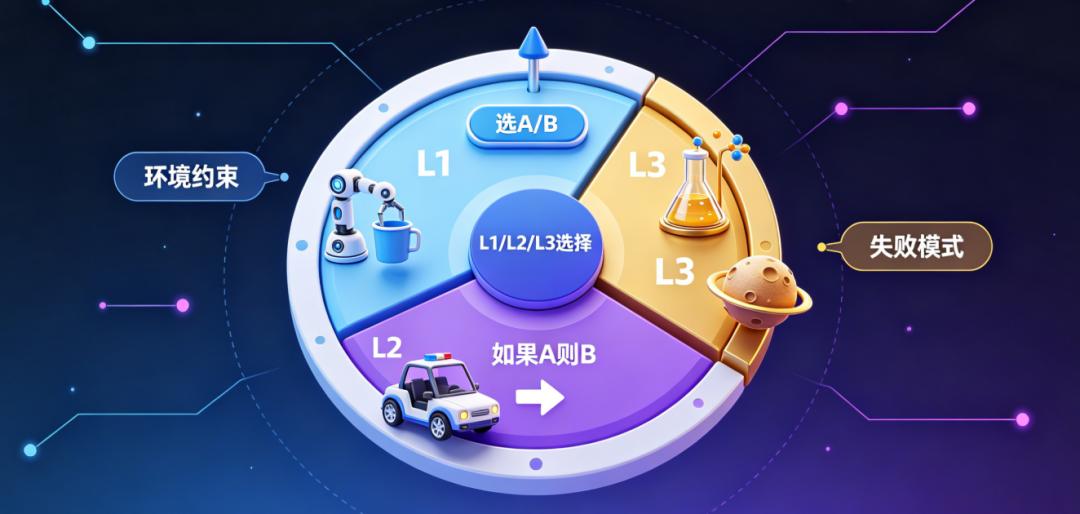
第一条逻辑:看你需要做的决策,是"选A还是选B",还是"要不要换个玩法"。
这是判断你需要L1还是L2的核心标准。
如果你的Agent只需要做一个确定的单步决策——比如说,看到一个杯子,判断它的位置,然后伸手去抓——L1加一个好的实时控制策略就够了。论文里提到的TD-MPC2,在104个技能任务上用一个固定模型就搞定了。
但如果你的Agent需要比较不同的行动序列,做"如果A则B,如果C则D"的反事实推理——那你就必须上L2。自动驾驶就是一个典型:你不能在"向左避让"和"急刹车"之间选一个,除非你的世界模型能推演出两种选择各自的结果。
论文用了一个很妙的说法:L2回答的是"如果我这样做了,会发生什么"这个问题。而L3回答的是"我为什么会对会发生什么判断出错"。
第二条逻辑:看你的环境约束,是"确定的"还是"未知的"。
这决定了你要不要从L2往L3冲。
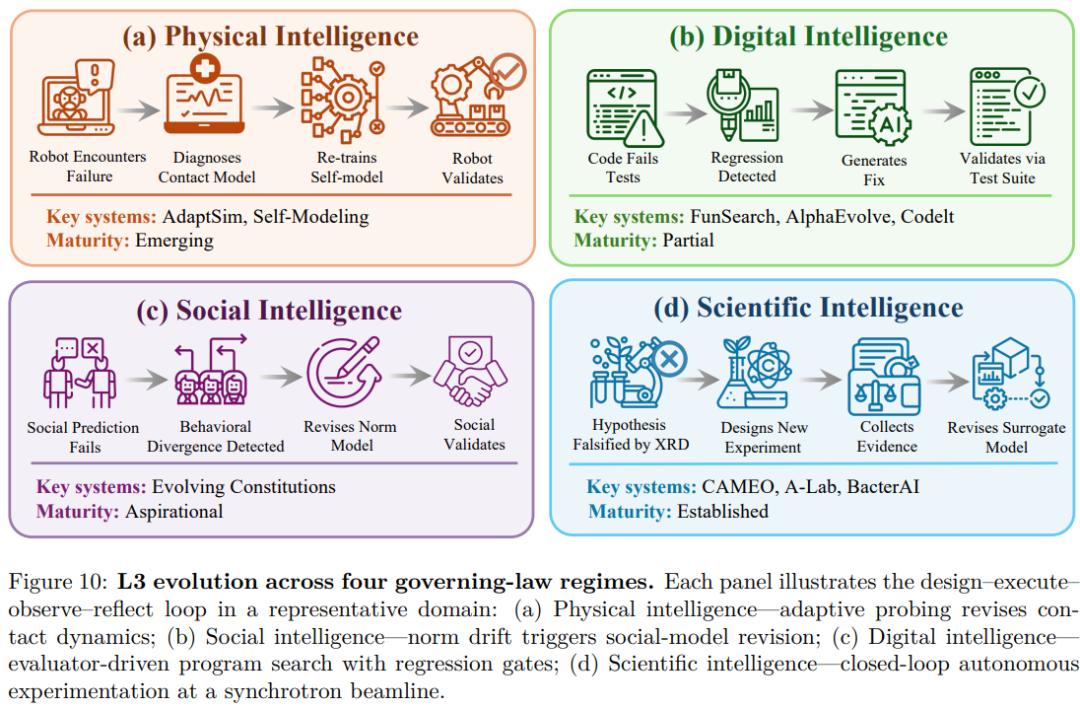
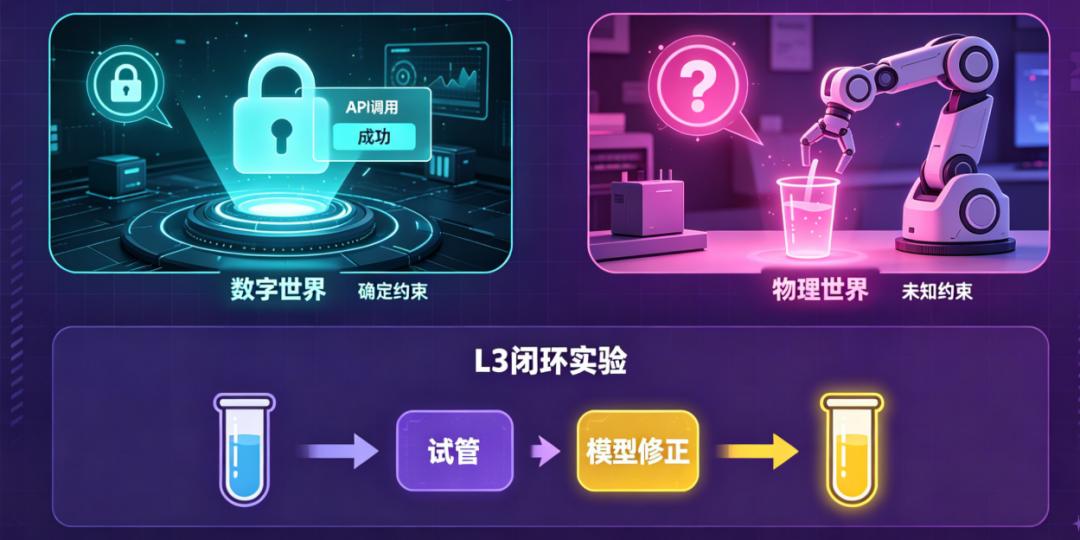
数字世界是L2的天堂,因为约束是确定的——API调用要么成功要么返回错误码,UI界面要么跳转要么不变。论文里提到的WebEvolver、CodeIt等系统,就是利用数字世界的这个特性,通过自动化测试评估来实现闭环改进。
但物理世界和科学世界不行。机器人的接触动力学没有闭合的解析解,材料合成的真实反应路径充满了未知中间产物。在这些领域,没有L3的自我修正能力,模型会在遇到第一次意外的时候就开始系统性犯错。
科学世界是L3最成熟的试验场,论文里列举的CAMEO和A-Lab已经能在材料合成领域跑通完整的闭环实验-->模型修正-->再实验的全自动流程。但这种成熟度是有代价的——它需要昂贵的仪器和结构化的实验设计空间。
第三条逻辑:看你的失败模式,是"参数不行"还是"架构不对"。
这是所有工程落地里最容易错判的问题。
论文引用了科学哲学里的拉卡托斯框架——一个模型的"硬核"(根本架构和归纳偏置)和"保护带"(可学习的参数)是两种不同层次的东西。
大量AI系统遇到问题时,工程团队的第一反应是加数据、调参、换训练策略——这是在修保护带。但有时候问题出在硬核上。
机器人抓杯子总是掉,不是因为抓取力度参数没调好——而是它的隐状态里根本就没编码"这个表面是光滑还是粗糙的"这个变量。在你的模型架构里,摩擦属性根本就不存在,加再多的数据也学不出来。
这就是L3最难的部分——得判断问题是出在已知未知(参数没学好),还是未知未知(需要引入一个新的维度)。
文章读完,我最大的感受是:我们错失了太多可以L2化的系统
这篇论文给我最大的启发,不是一个技术概念,而是一个认知框架。
它让我看清了一件事:AI系统之间的真正鸿沟,不是"神经网络vs符号系统",也不是"生成模型vs判别模型",而是"只能在训练分布里做模式匹配的L1"和"能在长程推演里保持规则完整的L2"之间的那条线。
过了这条线的是少数。机器人领域的Dreamer勉强算,科学计算的GraphCast和NeuralGCM算,数字世界的WebDreamer在往这个方向走。但大量的视频生成系统、语言模型Agent、社会模拟器,都还在这条线之下——做着看起来很炫的输出,底层却是不可靠的。
更关键的,L3的稀缺程度远超我的想象。除了一些高度仪表化的科学实验系统,在物理世界、数字世界、社会世界,真正能自己改自己模型的系统,几乎为零。
但换个角度看,这也意味着这三个领域里,谁先做出可用的L3,谁就拿走了最大的红利。
这篇文章帮你认清了自己的系统卡在哪一层。如果它还在L1,别急着叫它世界模型。如果它刚迈入L2,恭喜你已经跑赢了90%的同行。至于L3——那是下一个十年的故事,但它的种子,已经在今天的一些闭环科学发现系统里,悄悄发芽了。
参考资料
• Agentic World Modeling: Foundations, Capabilities, Laws, and Beyond
• https://arxiv.org/pdf/2604.22748