算网LLaMA-Factory镜像:零代码轻松微调百余种大模型
LLaMA-Factory 是一个为大语言模型(LLM)和视觉语言模型(VLM)设计的开源、低代码微调框架,旨在让模型定制变得更简单、更高效。
它由北京航空航天大学开发,目前是社区中最受欢迎的微调框架之一。
LLaMA-Factory 将复杂的模型微调过程集成在一个统一的框架内,其核心功能覆盖从数据到部署的全流程。
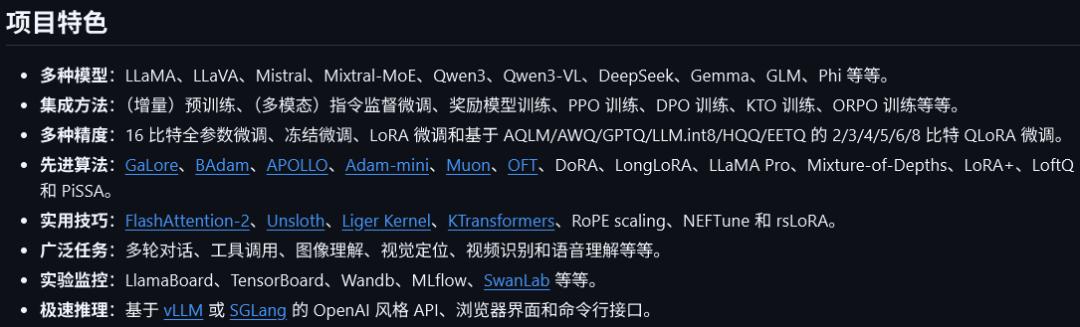
凭借其灵活高效的设计,LLaMA-Factory 在许多场景下都能发挥作用。
在医学、法律、金融、文化等专业领域,通过微调大幅提升模型在该特定领域的表现能力。例如微调 Llama-3.1-70B 模型,使其能进行医学诊断。
针对文本生成、分类、问答、翻译等特定任务,对模型进行定向优化。
在消费级 GPU 等受限硬件上,利用 QLoRA 等技术进行低成本、高效的模型微调。
快速打造 AI 聊天机器人、企业知识库问答系统、AI 客服等应用。例如使用政务数据微调 DeepSeek-R1 模型,打造专业的 AI 政务助手。
微调视觉语言模型(VLM),实现图像理解、音视频处理等多模态应用。例如微调 Qwen-VL 模型,构建自动图像标注流水线。
在学术机构或企业实验室中,研究新的微调算法、对齐技术等。
AI 初学者与爱好者,希望无需编写代码,通过简便的 Web UI 快速入门大模型微调。
机器学习工程师,希望通过高效的 CLI 和模块化设计,快速迭代模型,优化和部署模型。
研究人员,利用其丰富的算法和灵活性进行前沿实验。
初创公司在开发资源和工程师团队有限的情况下,高效构建原型和MVP产品。
企业技术团队为公司的特定业务场景定制模型,如金融、医疗、政务领域,无需从零造轮子。
LLaMA-Factory 既为专业开发者提供了全面的技术模块和高性能的训练能力,也为非技术背景的用户提供了一个非常友好的零代码平台。
凭借其开源开放、易于上手和功能丰富的特点,LLaMA-Factory 成功地降低了大型模型应用的门槛。
算网 GPU 平台上线了寒武纪显卡适配的源码镜像 llamafactory-mlu,简单操作即可开启大模型微调。
首先打开官网:https://sumw.com.cn/,立即体验。
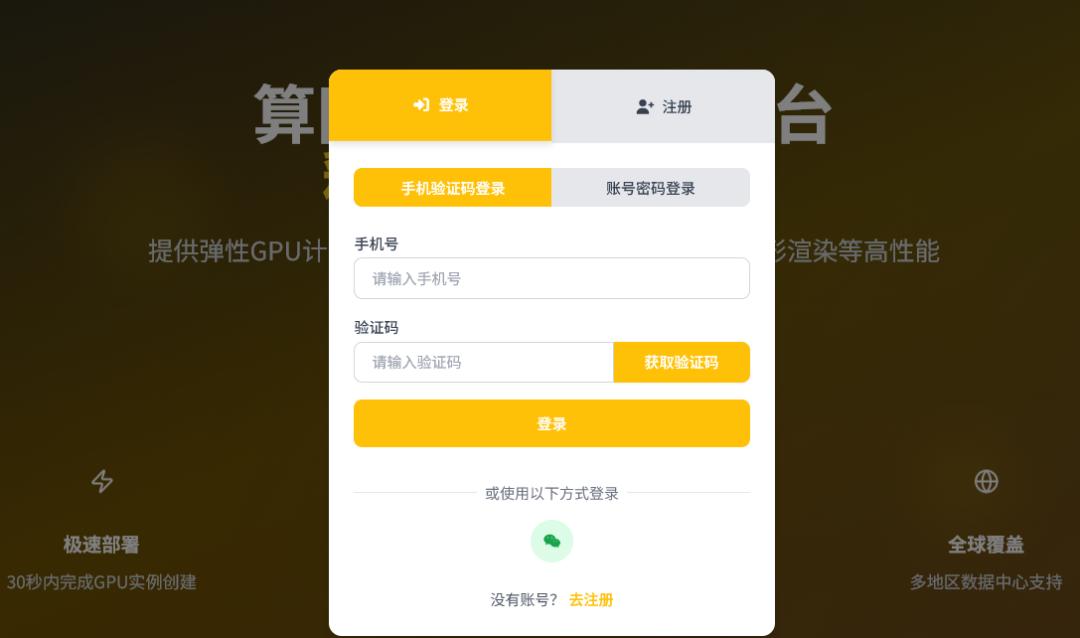
输入手机号,接收验证码登录。
进入算力市场选择GPU。
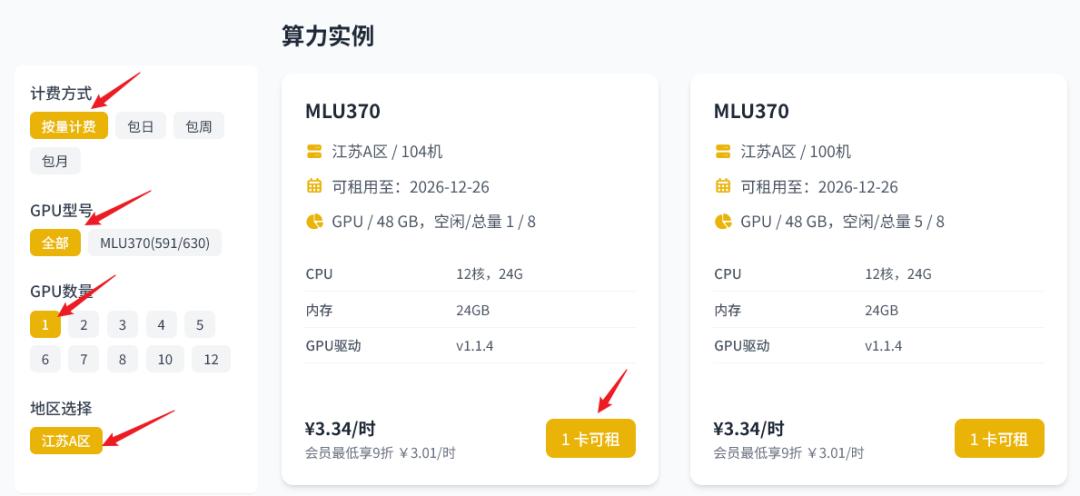
下拉找到镜像,社区镜像,点击选择 llamafactory-mlu 镜像,选择版本,确认租用。
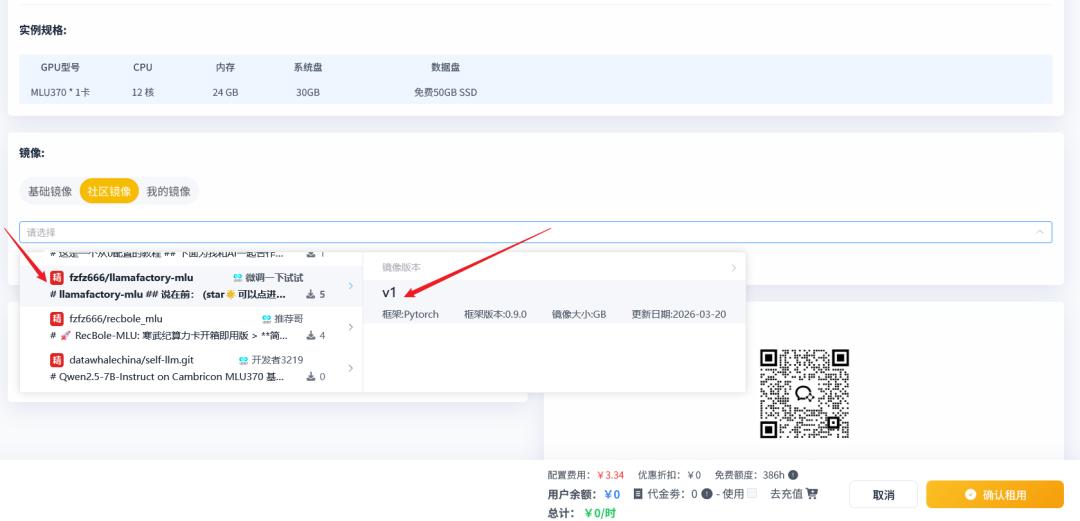
等待启动。
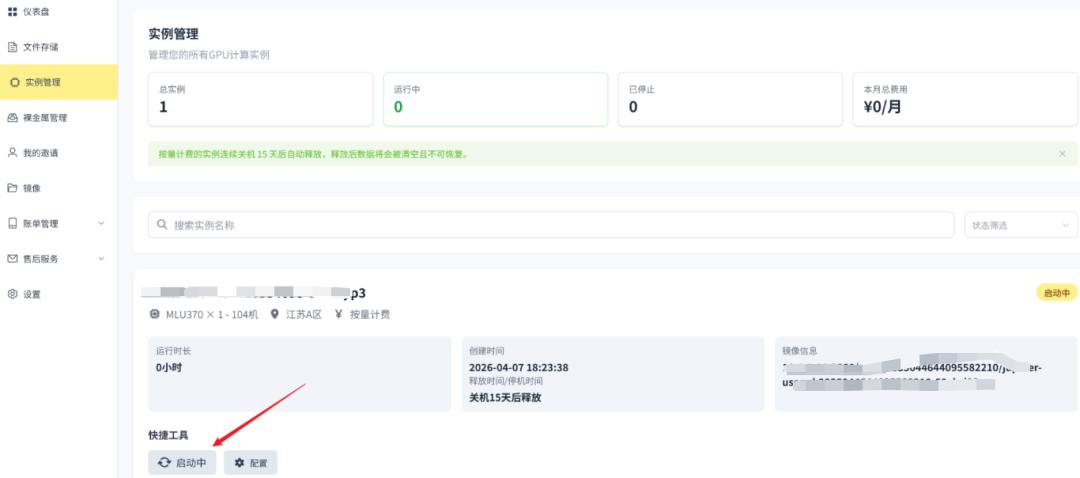
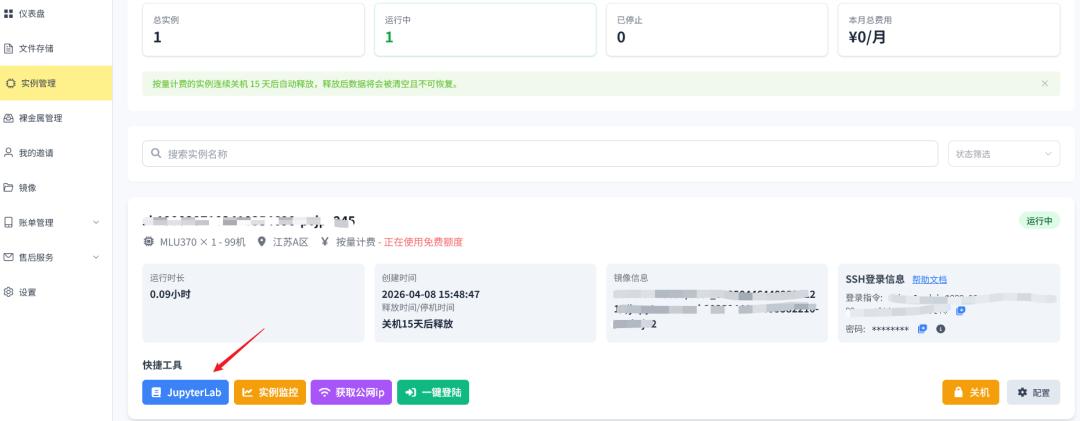
点击jupyterlab登录。
登录后界面是这样的。
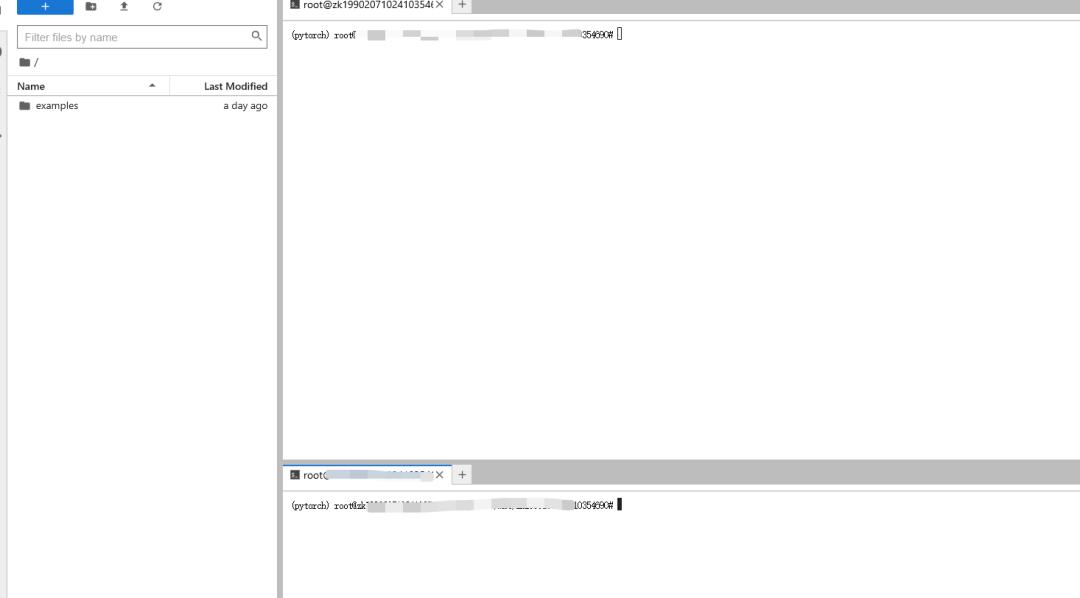
然后按下列步骤完成即可体验。该镜像已经装好了transformer、PEFT等需要适配MLU显卡的库,只需要下载github的内容,解压缩之后即可运行。
详细快速部署指南如下:
一、 环境基准检查 (Pre-check)
在部署前,请确保你的系统环境满足以下唯一要求:
硬件:寒武纪 MLU370 系列加速卡。
系统驱动:执行 cnmon 能够正常看到卡信息。
Python 版本:必须是 3.10(驱动强绑定)。
底层框架:已安装寒武纪官方版 PyTorch (torch_mlu),执行 python -c "import torch_mlu" 不报错。
二、 下载与解压魔改包
直接从 GitHub 下载你封装好的全套魔改源码:
三、 一键配置 Python 依赖环境
这一步是关键!我们要先安装基础依赖,然后将我们的“魔改版源码”强制挂载到 Python 环境中。
四、 运行微调 (以 Qwen2.5-0.5B 为例)
1. 启动 WebUI 界面
输入服务器 IP 即可用浏览器访问。
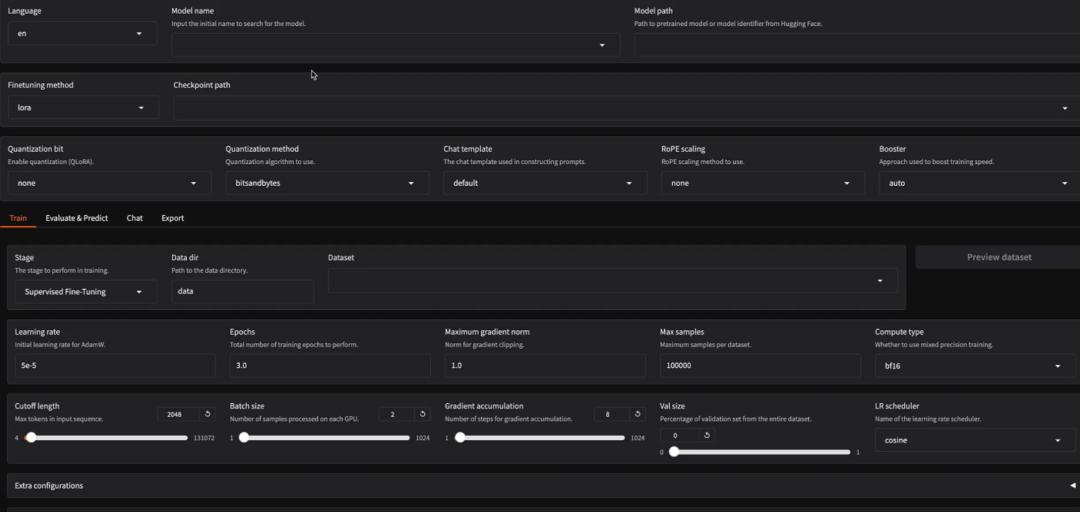
必选设置:
计算精度:必须选 fp16。
FlashAttention:必须关闭。
模型路径:填入你的 Qwen2.5 存放路径。
2. 纯命令行快速验证 (推荐)
如果你想直接看进度条,执行这个脚本:
赶快试试吧!