PaddleOCR镜像,来算网部署你的24小时文档识别、解析工具箱
PaddleOCR 是百度基于 PaddlePaddle 开源的一站式 OCR 与文档智能引擎,把 PDF/图像等非结构化内容转为结构化、对大模型友好的数据(JSON/Markdown),提供从“文字检测识别”到“文档版面解析、关键信息抽取”的全流程能力。
项目在 GitHub 上已获得 7.7万 Stars,并与 RAGFlow、MinerU 等知名项目深度集成,是构建 RAG、智能体等应用的常用基础组件。
PaddleOCR 能在弯曲、扫描、屏幕拍照、复杂光照、倾斜等真实场景下稳定解析文档,输出结构化的 Markdown/JSON。
PP-StructureV3 驱动的版面结构分析,支持表格(含嵌套)、公式、印章、图表等的定位与还原,提供细粒度坐标信息。
支持更多输出格式(Markdown、JSON,以及 DOCX 导出)和常见文档格式(Word/Excel/PPT 等)转 Markdown,便于接入后端或大模型处理。
支持 100+ 语种,并在多语言混排文档上表现优异。覆盖证件、街景、书籍、工业部件等场景;官方还提供浏览器推理 SDK PaddleOCR.js 在前端直接运行 OCR。
可以用 PaddleOCR 实现智能文档/RAG。把扫描件/PDF 批量转为 Markdown/JSON,用于企业知识库构建、RAG 检索增强生成与智能问答(与 RAGFlow、MinerU 等项目协同)。
或者票据/证照自动化。发票、银行单据、快递面单、身份证件等的自动识别与字段提取,用于财务报销、风控审核、开户/录入等。
亦或表单/表格数字化。财务报表、问卷调查、合同中的表格结构还原与数据抽取,导入 Excel/数据库或进行后续分析。
工业制造与质检也有用武之地。例如工业部件铭牌/标签文字识别、质检单据识别,用于产线信息化与追溯等。
在移动端/前端场景,还能通过 PaddleOCR.js 在浏览器端实现截图/拍照识别、屏幕实时翻译等轻应用(例如实时翻译工具、屏幕 OCR)。
算网 GPU 平台上线了 PaddleOCR 镜像,你可以为自己部署一个云端24小时在线文档或图片的识别、解析工具箱。
首先打开官网:https://sumw.com.cn/,立即体验。
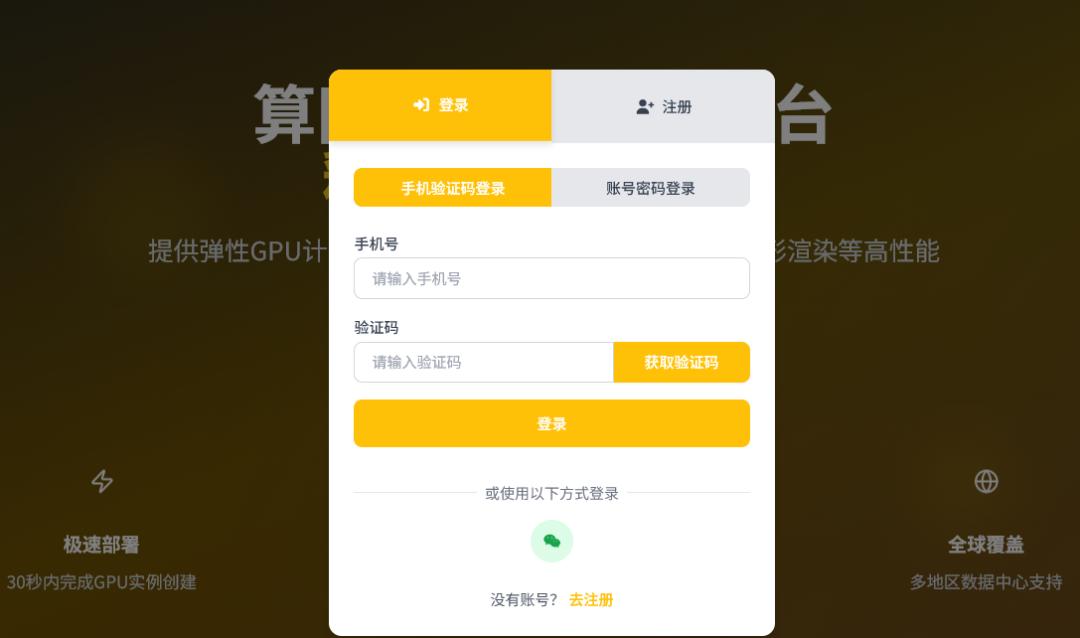
输入手机号,接收验证码登录。
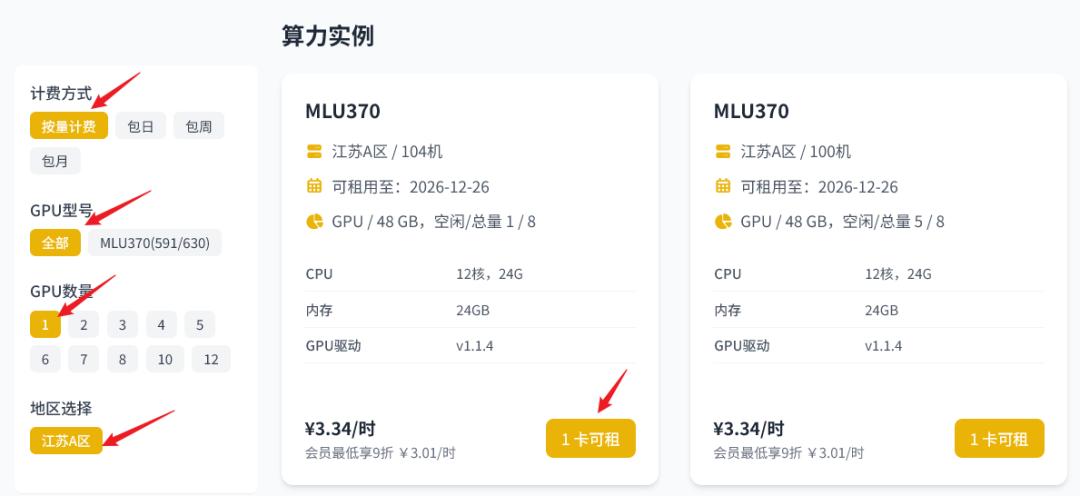
进入算力市场选择GPU。
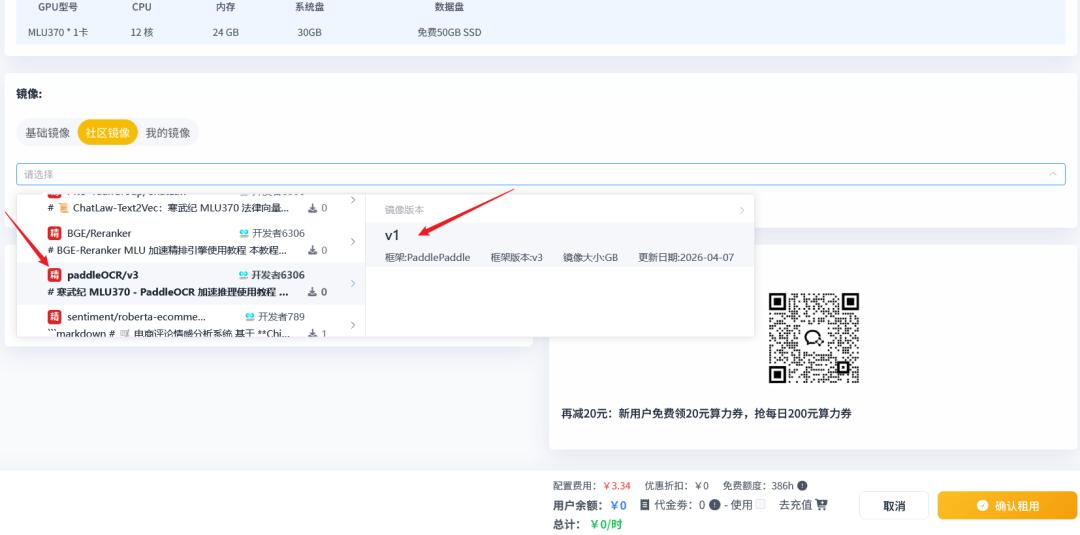
下拉找到镜像,社区镜像,点击选择 PaddleOCR 镜像,选择版本,确认租用。
等待启动。
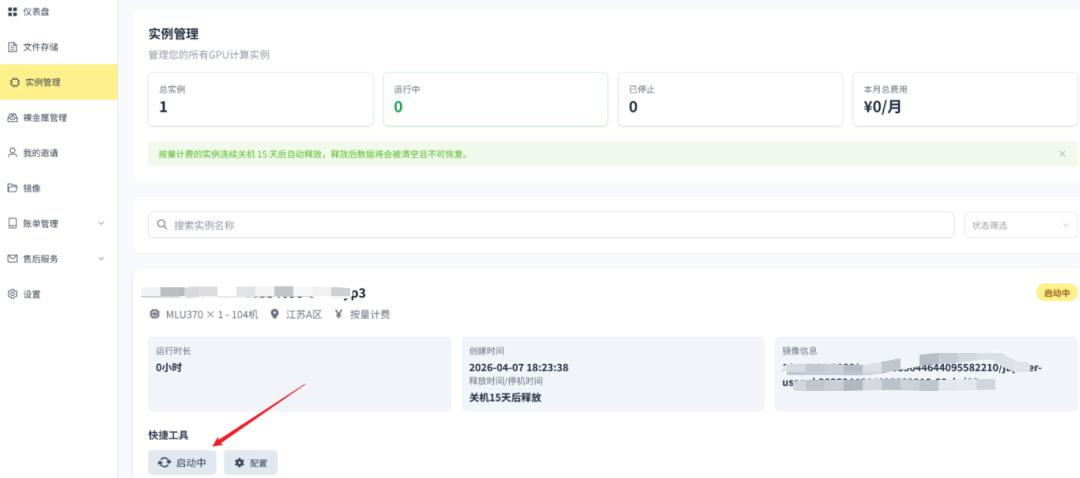
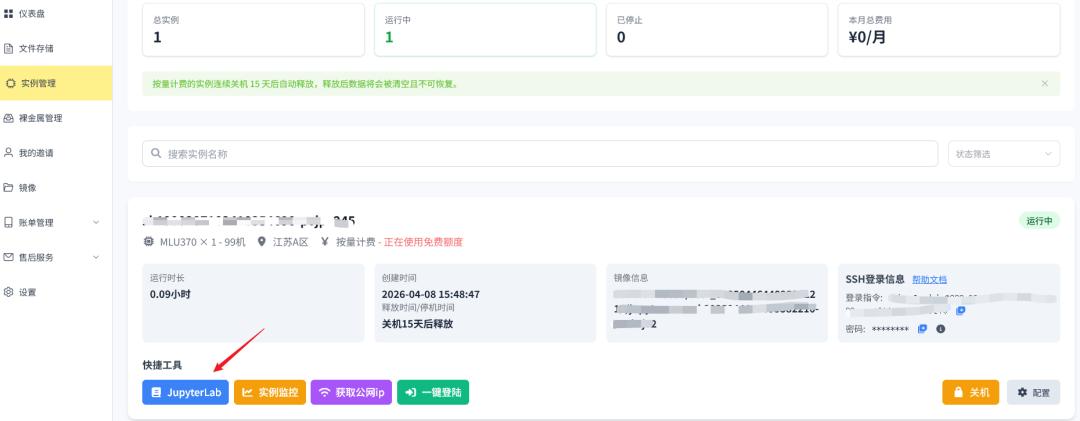
点击jupyterlab登录。
登录后界面是这样的。
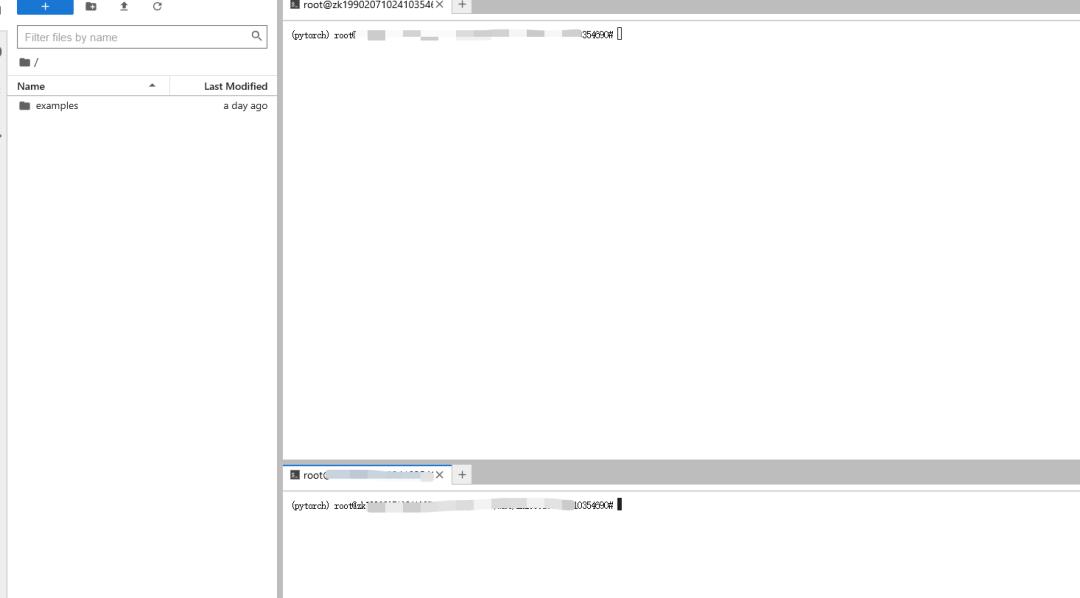
然后按下列步骤完成即可体验。
1,启动环境(必做)
每次新进入容器或断开重连 SSH 后,必须执行以下命令以激活寒武纪驱动和项目环境变量:
2,准备加速模型路径
推理程序需要加载之前优化好的 MagicMind 模型(.model 文件)。请确保模型文件存在于以下路径,并执行声明:
3,一键运行推理 Demo
系统会自动读取测试图片文件夹(默认./doc/imgs),并调用 MLU370 进行识别。
4,识别自己的图片
如果你需要识别特定的图片,可以使用以下两种方式:
方式一(批量): 将你的图片放入/mnt/zk2035044644095582210/my_images,然后修改命令参数:
方式二(单张): 直接指定--image_dir为图片文件的绝对路径。
5, 查看结果
控制台输出: 程序运行完毕后,会在终端打印出识别出的文字内容、坐标位置以及置信度。
可视化结果: 识别后的图片(带红色检测框)保存在infer_python/system_infer_results/目录下。类似:
快来试试吧~