DeepSeek-V4技术报告解读
还在为长文档分析烧显卡而头疼?当GPT-4处理10万字就要“爆内存”时,国产大模型已经悄悄进入了“百万token”时代。今天,我们彻底拆解刚刚发布的DeepSeek-V4,看它如何用一套颠覆性的架构,在1M token上下文下,将计算量砍到前代的27%,缓存仅需10%,同时性能全面超越Claude、GPT-4等顶级闭源模型。
读完本文,你将彻底掌握其三大核心创新:混合注意力机制、流形约束超连接、Muon优化器的设计精髓,理解这套架构为何能重新定义长上下文处理的效率边界。
❓ 为什么百万token上下文是“不可能三角”?
想象一个真实场景:你需要让AI分析一份500页的医疗报告、或是一整年的公司财报。传统大模型会立刻“卡住”——不是能力不行,而是计算成本呈平方级爆炸。
问题的根源在于Transformer的核心:注意力机制。每个新生成的token,都需要与之前所有token计算关联度。当序列长度L达到100万,这个计算量是 ,意味着单次前向传播就需要处理万亿次级别的运算。更致命的是,为了记住整个上下文,模型需要缓存每个中间位置的“键值对”(KV Cache)。100万token的KV Cache,对于千亿级模型来说,轻松吃掉几十甚至上百GB的显存。
这就是长上下文处理的“不可能三角”:性能、效率、成本难以兼得。要么牺牲精度做近似,要么承受天价的计算开销。但为什么DeepSeek-V4能同时打破这两个瓶颈?关键在于它对注意力机制的“外科手术式”重构。
🏗️ 整体架构:一次对Transformer的“深度改装”
在深入细节前,我们先俯瞰DeepSeek-V4的全貌。它并非推倒重来,而是在成熟的DeepSeekMoE框架上,进行了三项关键“心脏手术”。
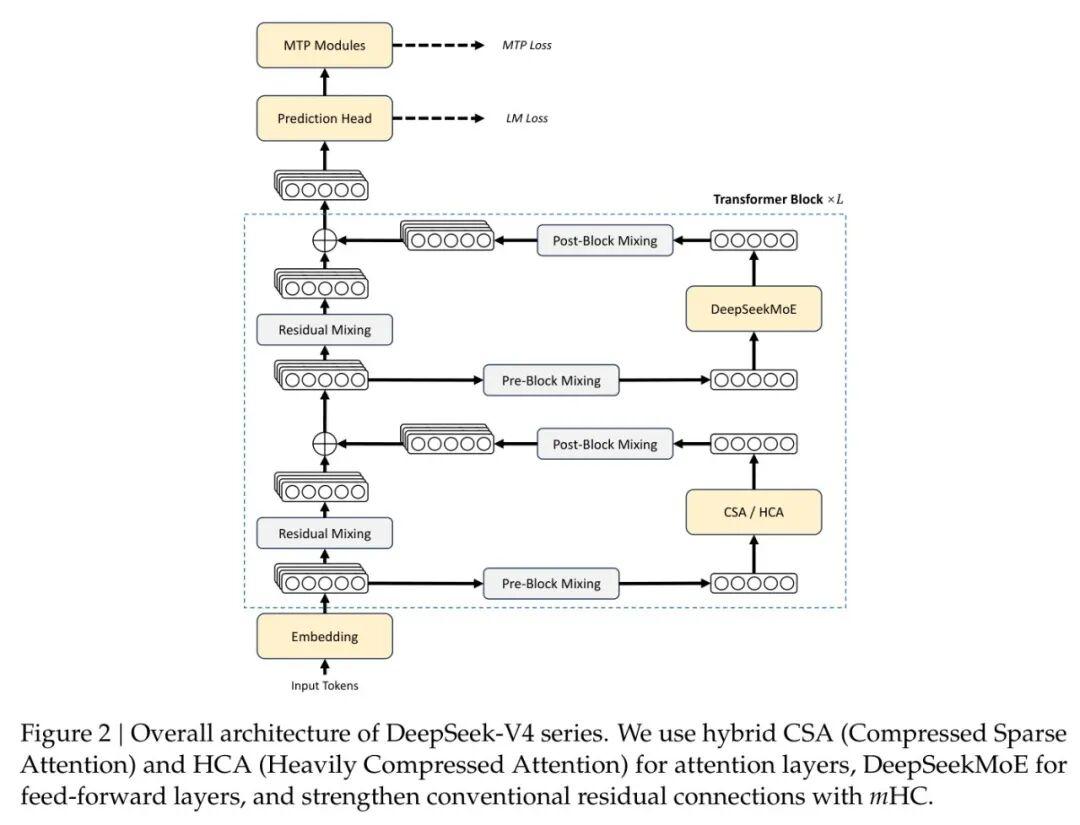
如图所示,输入Token经过Embedding层后,进入由L个Transformer Block堆叠的主干网络。每个Block内部包含两大核心升级:
- 注意力层:不再是单一的稠密注意力,而是**压缩稀疏注意力(CSA)与重度压缩注意力(HCA)**的混合体。
- 前馈层:沿用DeepSeekMoE的混合专家设计,但引入了**流形约束超连接(mHC)**来增强层间信息流动。
网络顶部则保留了多Token预测(MTP)模块,用于辅助训练。这个架构看似复杂,但每一项设计都直指效率瓶颈。下面,我们逐一拆解。
💡 核心创新一:混合注意力机制(CSA+HCA)
这是DeepSeek-V4效率飞跃的第一性原理。它的核心思想是:不是所有token都值得平等关注。对于长距离依赖,可以进行“有损压缩”和“选择性关注”;对于局部依赖,则保留“无损窗口”。
🎯 CSA:压缩 + 稀疏,双重降本
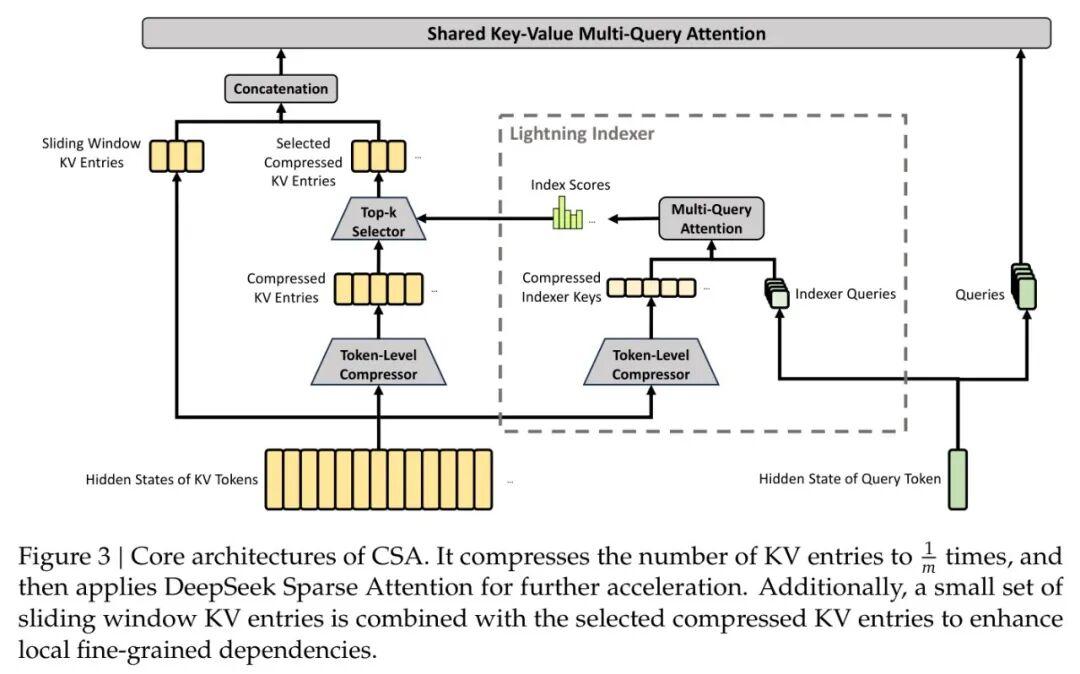
CSA的全称是Contextual Sparse Attention(上下文稀疏注意力)。它干了两件聪明事:先压缩,再稀疏选择。
第一步:分组压缩
将每m个连续token的KV状态,压缩成一个“代表条目”。这就像把一段冗长的会议记录,总结成几个关键要点。压缩不是简单平均,而是通过可学习的权重进行加权融合。
第二步:稀疏选择
压缩后,序列长度缩短为原来的1/m。但即使这样,对于100万token,压缩后仍有25万个条目(假设m=4)。CSA的第二个妙招是:每个查询token只关注全局压缩条目中的Top-k个。这个选择过程由一个轻量级的“闪电索引器”完成。
🎯 HCA:极致的全局压缩
如果说CSA是“精选摘要”,那么HCA就是“高度概括”。HCA采用更大的压缩率 (例如128),将每128个token压缩成1个条目,并且不进行稀疏选择,所有压缩条目都会被全局关注。
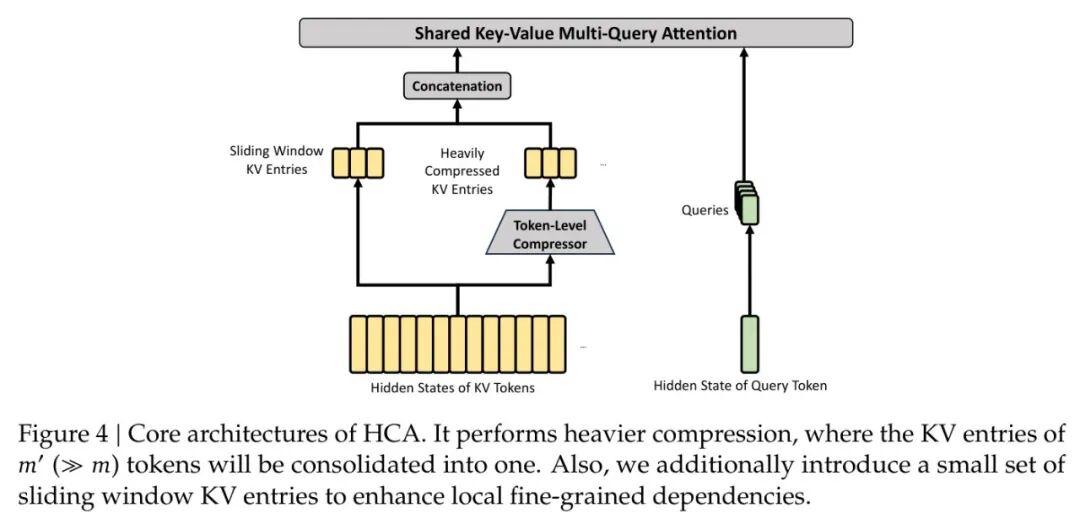
HCA虽然压缩激进,但保留了完整的全局视图,适合捕捉文档的整体结构或主题信息。CSA和HCA在模型中交替使用,分别负责捕捉“关键细节”和“整体脉络”,形成了高效的协作。
🎯 精妙的缓存布局设计
混合注意力带来了异构的KV条目,如何高效管理?DeepSeek-V4设计了一套创新的缓存布局。
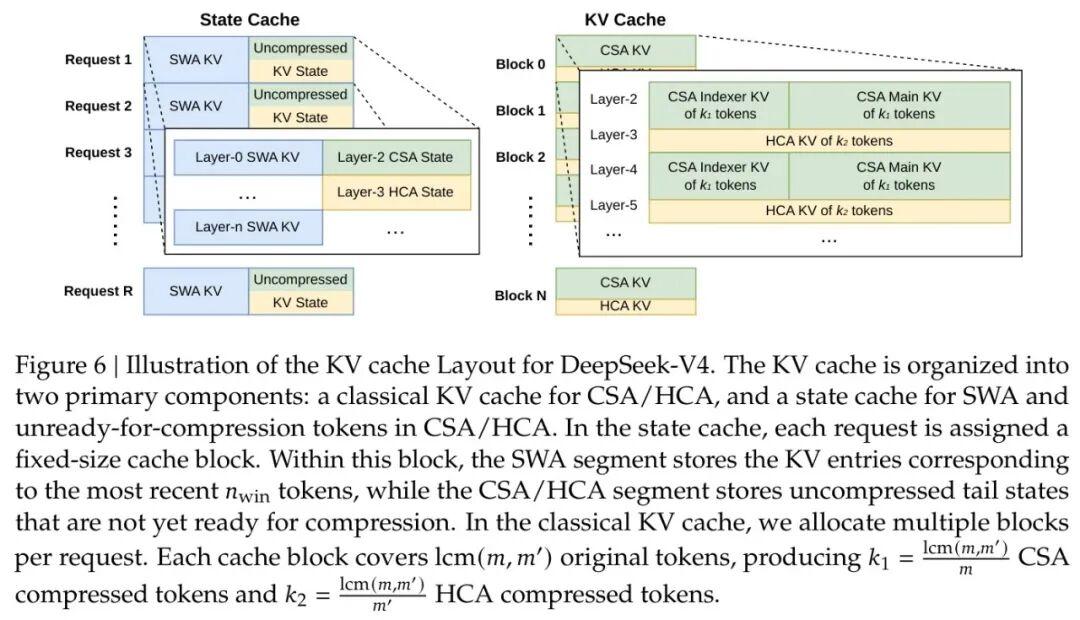
缓存被分为两部分:
- • State Cache:为每个请求固定分配,存储最近n_win个token的原始KV(用于局部滑动窗口注意力),以及尚未凑够一个压缩块的“尾部状态”。
- • KV Cache:按块分配,存储CSA和HCA压缩后的条目。
这种分离设计实现了动态内存管理:压缩块可以像传统PagedAttention一样灵活分配和释放,而状态缓存则固定大小,管理简单。正是这套组合拳,达成了惊人的效率提升。
💡 核心创新二:流形约束超连接(mHC)
如果说混合注意力解决了计算和存储的外部瓶颈,那么mHC则致力于提升模型内部的“信息高速公路”效率。
你可以把它想象成交通枢纽的智能调度系统: 负责将来自多条车道(宽残差)的车流汇聚到主干道(层计算), 确保部分车流能不受干扰地直接通往下一层(保留原始信息), 则将主干道处理后的车流重新分配回多条车道。mHC让信息在层间流动更稳定、更高效,是模型能力提升的隐性功臣。
💡 核心创新三:Muon优化器与工程壮举
训练一个万亿参数、混合注意力的模型,本身就是一项系统工程。DeepSeek-V4引入了Muon优化器来替代部分AdamW,它通过牛顿-舒尔茨迭代近似梯度矩阵的正交分解,实现了更快的收敛和更好的稳定性。
但真正的挑战在于如何让这套复杂架构跑起来。论文中透露的工程优化堪称教科书级别:
🚀 专家并行的“波次调度”
MoE层需要跨GPU通信,容易成为瓶颈。DeepSeek-V4的解决方案是将专家分组为多个“波次”,实现计算与通信的极致重叠。
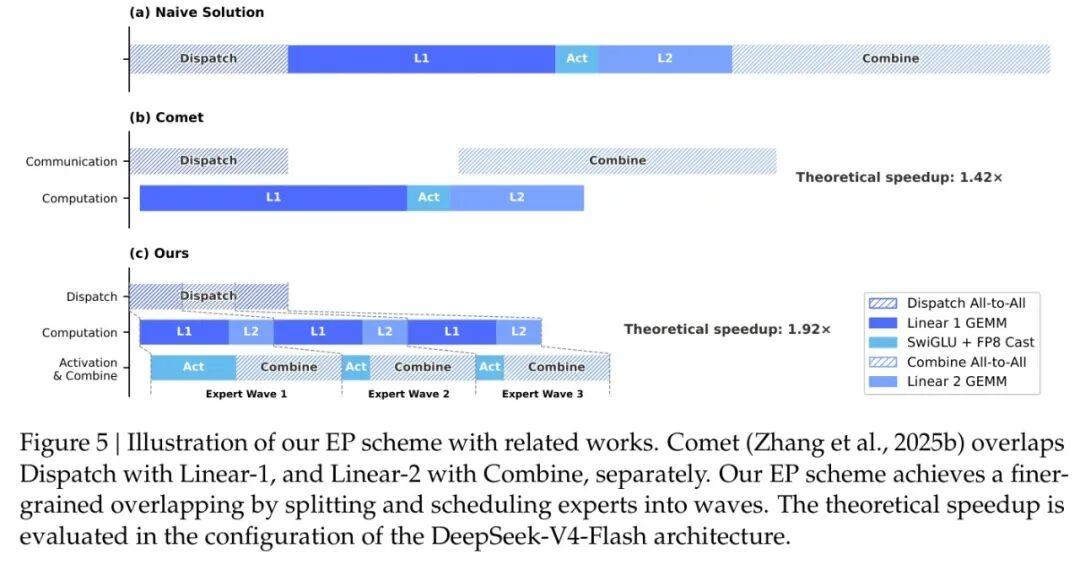
如图所示,通过将专家分成多个波次,每个波次内,当前波次的计算、下一个波次的通信、以及上一个波次结果的收集可以同时进行,形成了细粒度的流水线,将通信延迟几乎完全隐藏。
🛠️ 推理框架的异构缓存与磁盘KV
为了部署,团队设计了异构KV缓存管理,并创新性地支持将压缩后的KV缓存存储至磁盘。当多个用户查询共享很长的一段前缀时(例如分析同一份法规文档),可以直接从磁盘加载已计算的压缩缓存,彻底避免重复预填充,这对降低长上下文服务的延迟和成本至关重要。
🧠 思考管理:工具调用与长程推理
拥有了百万token的“内存”,模型如何使用它?DeepSeek-V4设计了精细的思考管理机制。
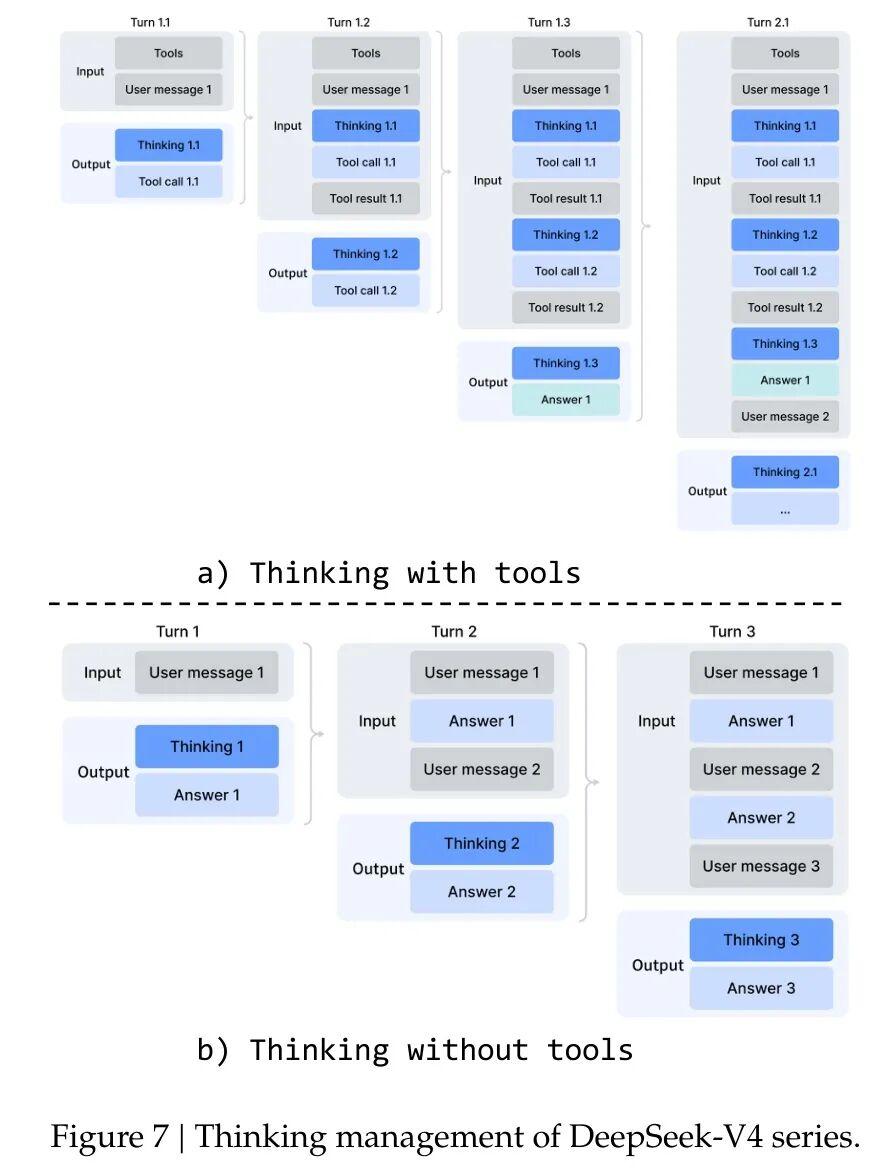
在工具调用等复杂Agent场景中,模型的整个思考链会被完整保留在上下文中,即使中间插入了用户的新消息。这使得模型能进行真正的“长程思考”,保持问题解决的连贯状态。而在普通对话中,则采用更简洁的模式,避免无用信息堆积。
此外,模型支持三种推理模式(Non-think, Think High, Think Max),用户可以根据任务复杂度在速度与深度之间灵活权衡。
📊 实验验证:数据不会说谎
说了这么多创新,实际效果到底如何?我们用数据说话。
🏆 SOTA性能对比:全面超越的开源新王
在涵盖知识、推理、代码、长上下文、智能体能力的全方位评测中,DeepSeek-V4-Pro-Max在知识与推理基准上,与顶级闭源模型展开全面较量。
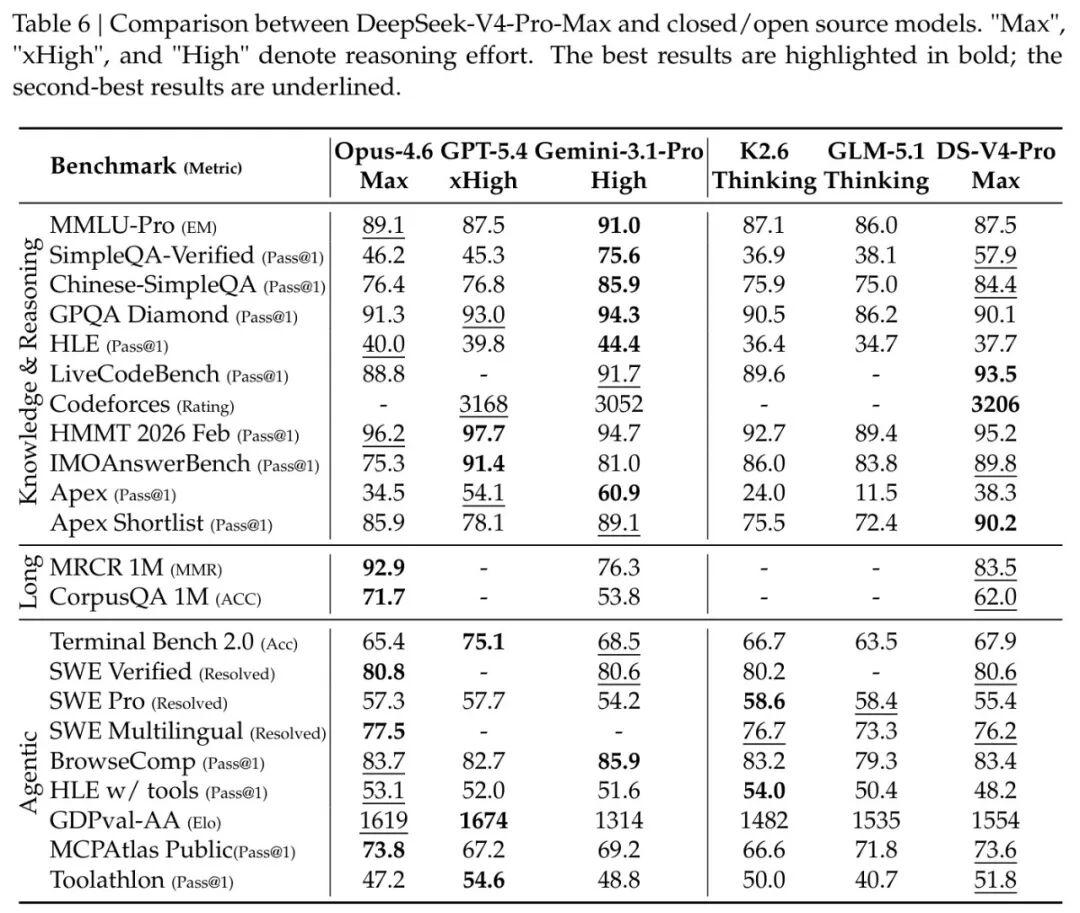
如表所示,在SimpleQA-Verified等知识基准上,V4-Pro-Max显著领先所有开源模型,虽仍稍逊于Gemini-3.1-Pro,但差距已大幅缩小。在LiveCodeBench、Codeforces等编程竞赛中,其表现已与GPT-5.4相当,这是开源模型首次在该领域达到闭源顶尖水平。
⚡ 效率碾压:FLOPs与KV缓存暴跌
性能强的同时,效率提升更为震撼。
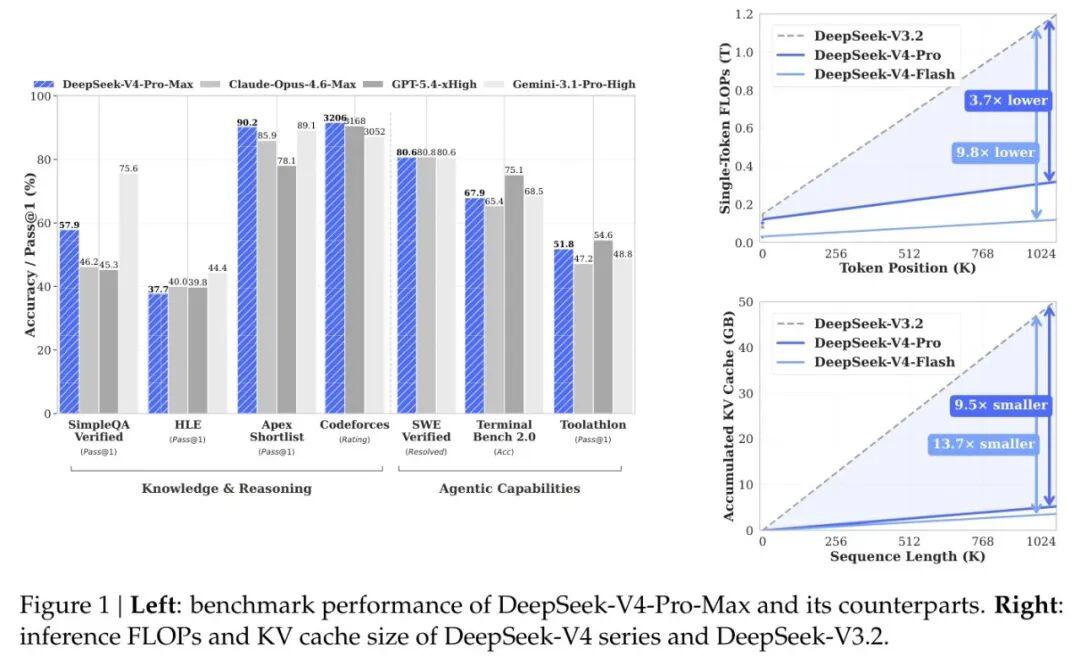
这个对比极具冲击力:更大的模型(V4-Pro激活参数490亿 vs V3.2的370亿),处理长上下文时,计算量和内存占用反而暴降。V4-Flash更是将效率推到极致:FLOPs仅需10%,缓存仅需7%。这意味着,以前跑不起的长文档应用,现在可以轻松部署。
📈 长上下文性能衰减控制
支持百万长度,不只是能“吃进去”,还要能“用得好”。在衡量长文档信息检索能力的MRCR任务上,V4系列表现出了优秀的稳定性。
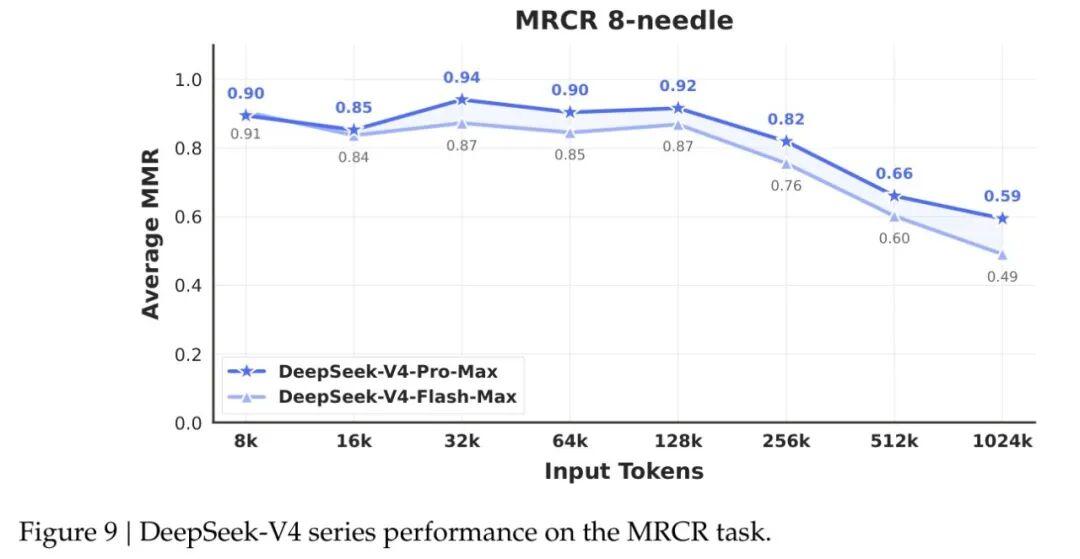
如图所示,在128K token内,模型检索性能(平均MMR)几乎无衰减。随着长度增至1M,性能虽有所下降,但仍显著优于Gemini-3.1-Pro,证明了其长上下文处理的有效性。
🔬 消融实验:搜索与写作能力大幅进化
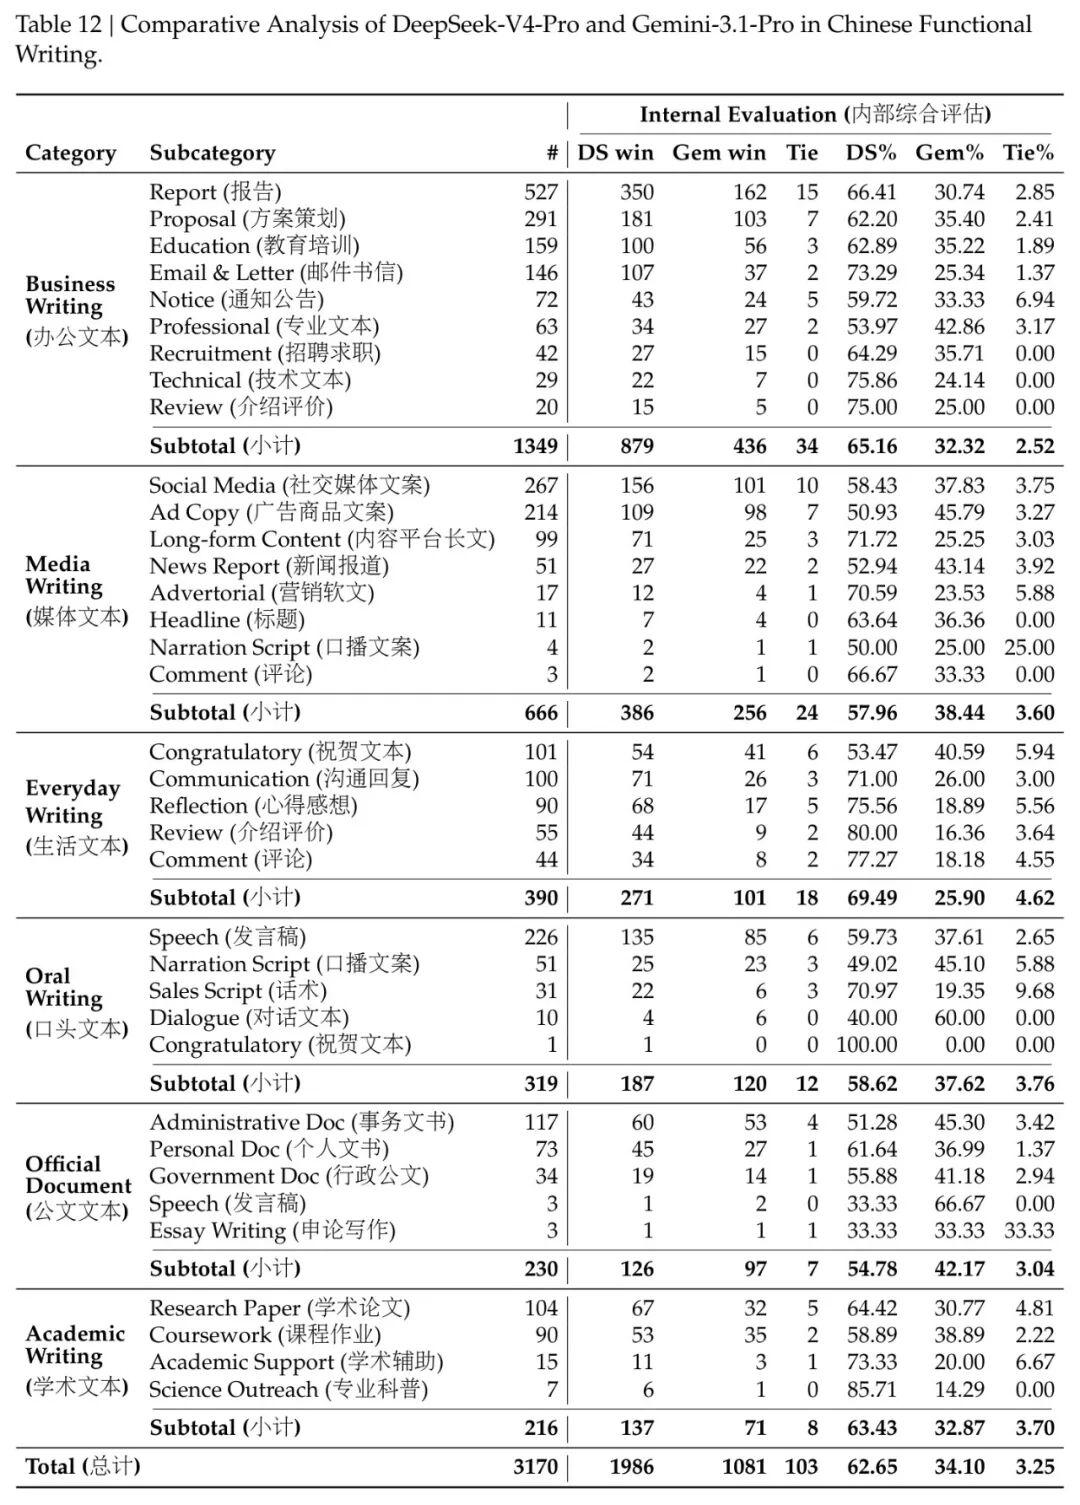
在内部真实场景评估中,V4相比前代和竞品的提升更为明显。
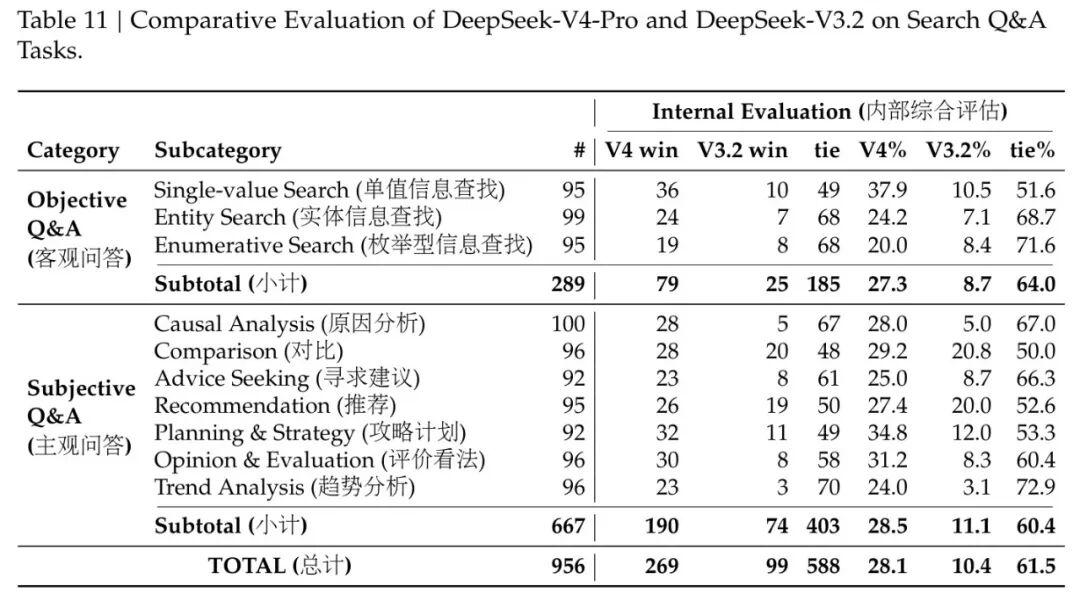
在搜索问答中,V4-Pro在所有子类别上碾压V3.2。在中文写作——国产模型的优势战场——V4-Pro同样展现出统治力。
🎯 复杂任务输出示例
理论数据之外,模型的真实输出能力更令人印象深刻。它能生成结构清晰、数据可视化的复杂商业提案和科研报告。
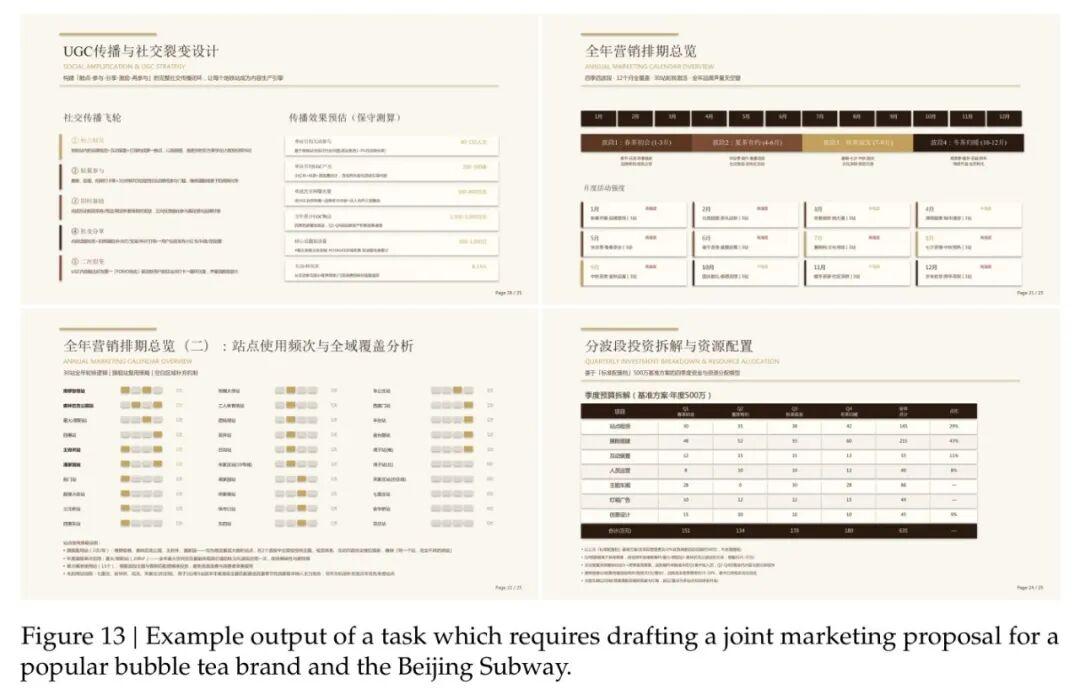
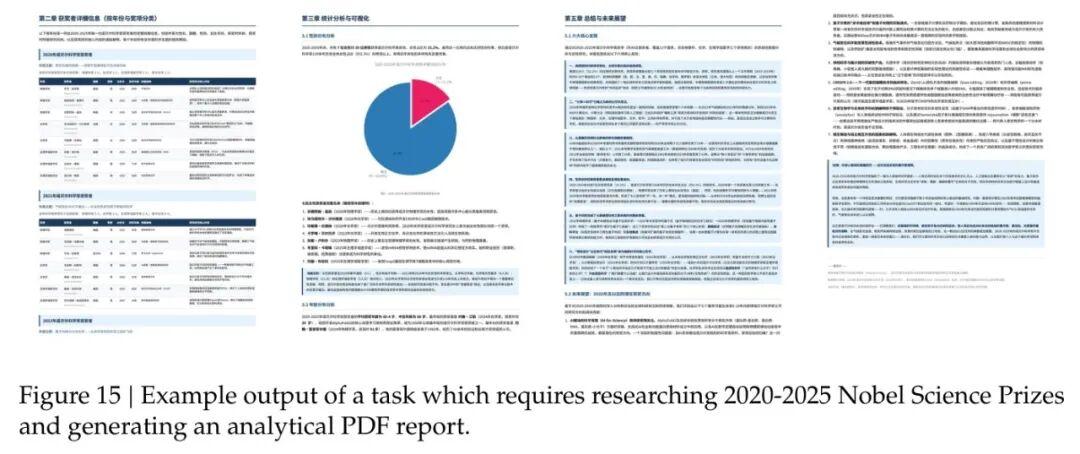
从架构图到商业提案,DeepSeek-V4展现的是一种系统级的工程与智能能力。
⚖️ 客观评价:开创性、复杂性与未来
毫无疑问,DeepSeek-V4是一次里程碑式的发布。它首次在开源世界将高效百万token上下文变为现实,并在多项能力上迫近甚至超越闭源前沿。
核心优势:
- 架构创新引领效率革命:CSA/HCA混合注意力是解决长上下文瓶颈的治本之策,为行业指明了方向。
- 工程实现堪称壮举:从训练稳定性(前瞻性路由、SwiGLU钳位)到推理优化(异构缓存、磁盘KV),整套系统工程深度令人叹服。
- 综合性能达到新高度:不仅在标准基准,更在真实写作、搜索、编程等场景展现出强大实用性。
局限与挑战:
- 架构复杂性:论文自己也承认,为了追求极致性能和稳健性,集成了大量技巧,导致架构略显复杂。未来的工作需进行“架构蒸馏”,提炼更优雅的核心设计。
- 训练稳定性原理未明:前瞻性路由等稳定训练的技巧虽有效,但理论机制尚未完全清晰,这给更大规模的扩展带来不确定性。
- 部分场景仍有差距:在极其复杂的指令跟随和多轮写作任务上,内部评估显示其仍略逊于Claude Opus-4.5。
💡 实战思考:对我们开发者而言,V4的混合注意力设计思路极具借鉴价值。在处理长文本、多文档检索等场景时,是否可以借鉴其“全局压缩概览+局部稀疏精读”的思想,设计更轻量化的解决方案?
🌟 总结与展望
DeepSeek-V4不仅是一个强大的模型,更是一份关于如何构建下一代大模型的工程蓝图。它告诉我们:
- • 长上下文不是“堆硬件”就能解决,必须从注意力机制这一根本架构上进行创新。
- • 效率与性能可以兼得,关键在于精细的设计与极致的工程优化。
- • 开源模型正在从“追随”走向“并跑”甚至“引领”,在核心架构创新上开始展现领导力。
展望未来,随着架构进一步精简、多模态能力融入、以及长程Agent任务的深入探索,基于DeepSeek-V4这类高效架构的模型,必将解锁更多前所未有的应用场景:全本法律分析、跨年度财报对比、超长代码库维护……一个真正的“超长上下文智能”时代,已经拉开序幕。
🤔 深度思考:你认为DeepSeek-V4这套混合注意力机制,最可能率先在哪个行业或应用场景产生颠覆性影响?是金融分析、医疗科研,还是代码开发?欢迎在评论区留下你的真知灼见!
💝 支持原创:如果这篇近5000字的深度拆解帮你拨云见日,点赞+在看就是对我最大的鼓励!分享给你身边同样关注AI技术前沿的朋友吧!
🔔 关注提醒:想第一时间获取更多硬核AI技术解读?别错过后续更新!
#AI技术 #深度学习 #大模型 #DeepSeek #论文解读 #长上下文 #模型压缩
参考
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence