基于LLM增强语义网络的跨股票可预测性框架
“Cross-Stock Predictability via LLM-Augmented Semantic Networks”
本文提出LLM增强的跨股票可预测性框架,采用“检索 - 推理”范式,先通过轻量级嵌入相似度生成候选图,再用大语言模型分类边并去除无交易价值的边,最后用精炼图构建股票信号。回测显示,基于大语言模型的边缘过滤使多空夏普比率从0.742提升到0.820,最大回撤从 - 10.47%降至 - 7.85%,表明大语言模型推理可提升文本金融网络经济保真度和跨股票可预测性。
【 扫描文末二维码加入星球获取论文 】
摘要
文本金融网络可用于研究跨股票回报,常见方法构建的网络含虚假边缘。本文提出两阶段框架,先从10 - K嵌入构建稀疏候选图,再用大语言模型按经济关系分类过滤候选边缘。用精炼图聚合配对均值回归信号成股票交易信号。2011 - 2019年对标普500成分股回测显示,基于大语言模型的边缘过滤使多空夏普比率从0.742提升到0.820,最大回撤从 - 10.47%降至 - 7.85%,表明大语言模型推理可提升文本金融网络经济保真度和跨股票可预测性。
简介
交叉股票可预测性指股票未来回报可由经济关联公司同期表现部分预测,源于信息在关联企业间缓慢扩散,利用此需可靠经济关联网络。自然语言处理虽能构建网络,但存在虚假相关性问题,会稀释预测内容、降低投资组合表现。
本文提出“检索 - 推理”框架,先用轻量级嵌入相似度搜索生成候选图,再用大语言模型(LLM)对候选边分类,去除竞争边、降低替代边权重,用改进图构建股票信号。对美国股票(2011 - 2019年标普500)评估,发现:添加LLM过滤提高长短仓夏普比率、降低最大回撤;语义网络表现优于随机图和基于SIC的行业网络;Fama - French因子回归显示有显著日阿尔法。
本文主要贡献:
提出利用LLM过滤虚假相关性的框架,生成高保真经济图;
设计关系感知、距离加权的信号聚合机制;
进行广泛实证评估,证明LLM推理模块能显著改善投资组合。
相关工作
跨股票可预测性和经济联系
金融文献表明经济关联企业回报可预测焦点企业未来回报,归因于投资者疏忽和信息扩散慢。已识别的关联包括供应链、行业分类、地理邻近和共享分析师覆盖等,还有基于回报相似性的跨股票预测。近期研究强调剖析关联性质,如将跨股票关联分为对称(共同因子动量驱动)和不对称(单向领先 - 滞后关系)成分,前者常导致长期回报反转,后者反映投资者反应不足;还提出“双重同行效应”。但现有研究多依赖静态或手动分类,滞后于市场动态。
数据驱动的对等网络及其局限性
近期研究利用高维文本和专利数据构建企业网络,如基于10 - K产品描述开发文本行业动量、从监管文件提取竞争网络、用专利衡量创新相似性预测回报、用图学习从定价数据推断动态动量溢出网络。
这些方法依赖相似性指标推断经济联系,但文本或技术相似性不能明确企业关系性质,将不同关系纳入单一基于相似性的网络会引入结构噪声、削弱回报可预测性。
本文提出基于大语言模型的关系框架,对10 - K披露进行上下文语义推理,将企业间引用明确分类为结构化经济类别,从无监督相似性估计转变为有监督语义分类,提高可解释性、减少虚假相关性。
LLMs用于金融推理
大语言模型(LLMs)在金融文本分析能力卓越,应用广泛,如股票回报预测、宏观经济预测等,但直接经济预测可能存在数据污染和记忆问题。
本文工作部署LLMs作为语义推理代理进行网络细化,采用“检索 - 推理”框架,构建高保真经济图,解决嵌入网络局限和前瞻偏差问题。
问题建模
符号
设 V={v1,…,vN} 为 N 只股票的集合,观察每只股票 vi 在 [1,T] 时间内的日回报率 r i,t,其归一化价格 Px 为从参考日期 t0 起的毛回报率累积乘积;每只股票还有从公司披露文件得到的 D 维文本嵌入 hi,用于表示公司业务概况。
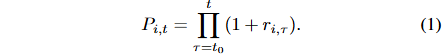
基于网络的跨股票可预测性
跨股票可预测性利用经济关联企业间信息逐渐扩散的特点,核心是目标股票未来回报可由其经济同行当前状态部分预测。用图 G = (V, E) 表示关联,股票 v_i 的跨股票预测信号 S_{i,t} 通过聚合其邻域信息构建。信号质量关键取决于边集(E)的准确性,理想边集仅捕捉真实经济互动,使关联股票间价格错位反映临时低效而非永久差异。
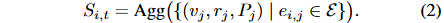
伪相关问题
构建E可利用文本相似度,计算股票对嵌入的余弦相似度,形成top - K邻居图。此方法高效可扩展,但存在局限,文本嵌入捕捉的是主题相似而非经济因果,会产生虚假关联的噪声边,聚合此类边信号会稀释预测内容、降低投资组合表现。
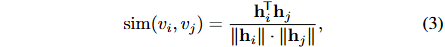
目标
工作核心是将候选图 G emb 精炼为高保真经济网络 G ref,保留代表实质经济关系的边并赋予语义标签。
核心问题是:大语言模型能否通过企业文本信息推理区分真实与虚假经济联系,提升跨股票预测能力?
方法
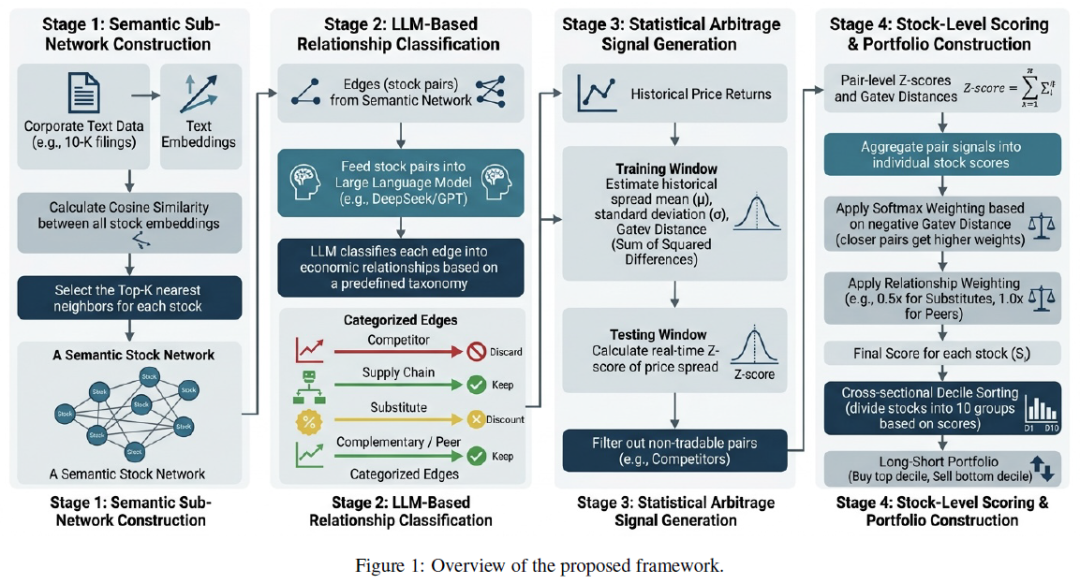
提出“检索后推理”两阶段框架,先通过嵌入相似度识别候选股票对,再用大语言模型验证和分类经济关系,用精炼网络构建跨股票预测信号,图 1 展示整体架构。
阶段1:候选图生成
根据嵌入矩阵 H 计算全成对余弦相似度矩阵,为每只股票保留与其最相似的前 K 个同行的边,通过对称化使候选图 G_emb 无向,此阶段轻量可扩展,将边数从 O(N²)减至 O(NK),使后续大语言模型推理计算可行。
阶段2:基于LLM的增强边缘分类
利用大语言模型(LLM)对候选边集 E_emb 中企业对的经济关系分类,基于企业披露进行结构化语义推理。
输入构建:从企业上一财年 10 - K 年报提取信息构建结构化提示,各部分截成固定长度,企业身份匿名。
提示设计:让 LLM 扮演行业分析师,从预定义分类 {竞争对手、供应链、互补、替代、同行、无关} 选一个标签,输出为结构化 JSON 格式。
关系分类:区分产生均值回归信号和反映结构竞争的关系,利于后续筛选边。
实现细节:用 DeepSeek - Chat,温度设为零保证输出确定性,批量查询、缓存结果,查询数为 O(NK)。
讨论:将网络构建从无监督相似度估计转为结构化语义分类,减少虚假边,提高网络经济保真度。
跨股票信号构造
训练阶段:对精炼图 G_{ref} 中每条边 (v_i, v_j),在训练窗口 [t_0, t_1] 计算归一化价格价差 s_{ij,t},估计其历史均值 u_{ij} 和标准差 sigma_{ij},记录距离 d_{ij}。
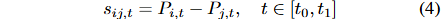
测试阶段:在测试窗口 [t_1 + 1, t_2] 计算每对的 z-score z_{ij,t},大的正 z_{ij,t} 预示未来均值回归。
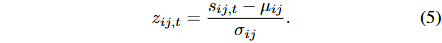
单股票信号聚合:将成对 z-score 聚合为单股票信号 S_{i,t},价差异常高时,v_i 获卖信号,v_j 获买信号。
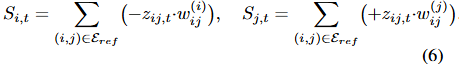
权重计算:权重 w_{ij} 通过对距离进行单股票 softmax 计算,并按关系权重缩放,同时用节点度 n_i 缩放以保持不同节点度股票的聚合信号幅度。
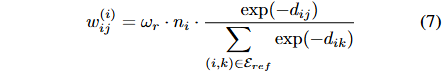
构建投资组合
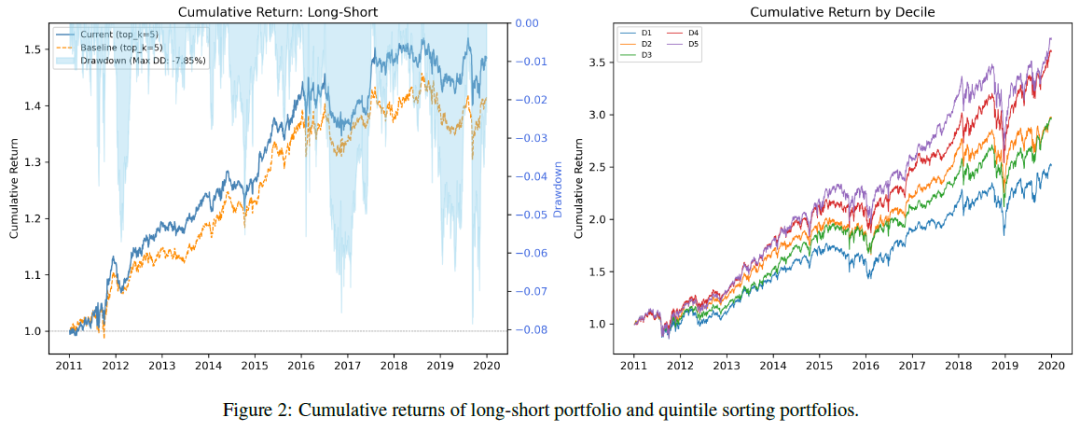
在每个再平衡日t,按信号Sᵢ,ₜ对所有股票横截面排序,分成G个等规模组,组1为低分股(预计下跌),组G为高分股(预计上涨)。构建多空组合,做多组G、做空组1,组合收益rₜᴸˢ = r̄ₜᴳ - r̄ₜ¹,作为股票横截面可预测性的主要衡量指标,报告年化收益、年化波动率、夏普比率和组合换手率。
实验
实验设置
股票范围:用CRSP数据库2007.7 - 2020.12美国普通股日收益率数据,投资范围限于标普500成分股,约605个唯一PERMNO。
文本嵌入:每年从公司10 - K文件获768维嵌入向量,匹配后约497只股票有有效嵌入。
滚动窗口回测:2011.1 - 2019.12用滚动窗口设计,180个交易日训练,2个月测试,用前一年嵌入。
投资组合构建:按信号排序分5个等分组,构建多空组合,组内等权,每日再平衡。
LLM配置:LLM增强边缘分类用DeepSeek - Chat,温度设0,结果缓存。
评估指标:报告多空组合年化收益、年化波动率、夏普比率、最大回撤、年化换手率和Newey - West t统计量。
结果
表1展示了五种配置下长短仓投资组合表现。
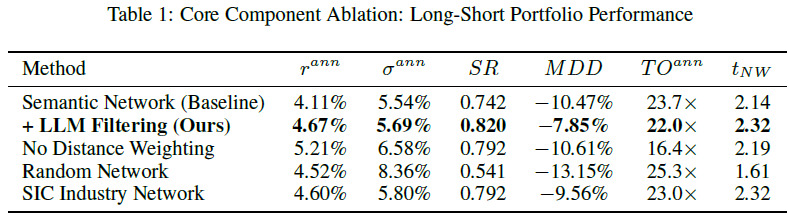
提出的LLM增强框架夏普比率最高(0.820),较基线提升10.5%,最大回撤从 - 10.47%降至 - 7.85%;用随机图替代语义网络,夏普比率降至0.541,说明嵌入网络捕捉到有意义的经济结构;SIC行业网络夏普比率有竞争力(0.792),但波动性高于LLM过滤网络,表明文本嵌入捕捉的企业间联系更丰富;去除距离加权使原始回报略增,但波动性大增,夏普比率低于完整模型。
五分位组合分析
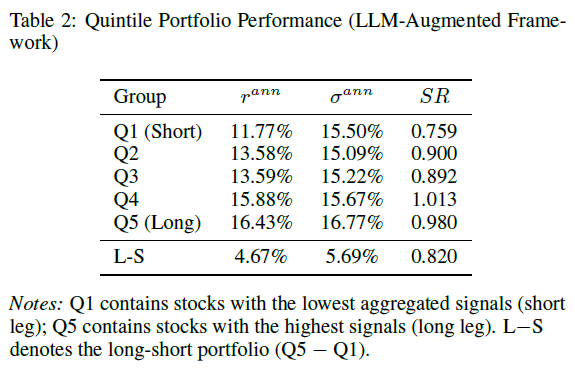
表2展示了所提LLM增强框架下各五分位组表现。五分位排序呈单调模式,平均回报从Q1到Q5递增,体现LLM增强信号的跨股票预测能力。收益差主要由跑赢市场的多头(Q5)驱动,空头(Q1)跑输市场。
消融分析
LLM边缘滤波的效果
表 1 对比“Baseline”与“+ LLM Filtering”,量化了 LLM 推理模块的附加值。LLM 过滤实现三项提升:年化回报提高 56 个基点、夏普比率提高 0.078、最大回撤降低 262 个基点,原因是 LLM 能识别并去除竞争对手优势。Newey - West t 统计量从 2.14 增至 2.32,超 5%显著性阈值,证明改进具统计可靠性。
语义网络vs.替代图
为验证基于嵌入的语义网络反映真实经济结构,将其与两种替代图构建方式对比:
随机网络(A3):随机选 K 个邻居连边,夏普比率降至 0.541(t 值无统计意义),表明信号预测内容源于语义网络拓扑,非聚合机制假象。
SIC 行业网络(A4):同 2 位 SIC 代码企业连边,夏普比率 0.792,说明行业网络有预测信息,但逊于 LLM 过滤的语义网络(0.820),显示文本嵌入能捕捉超越行业边界的细微经济联系。
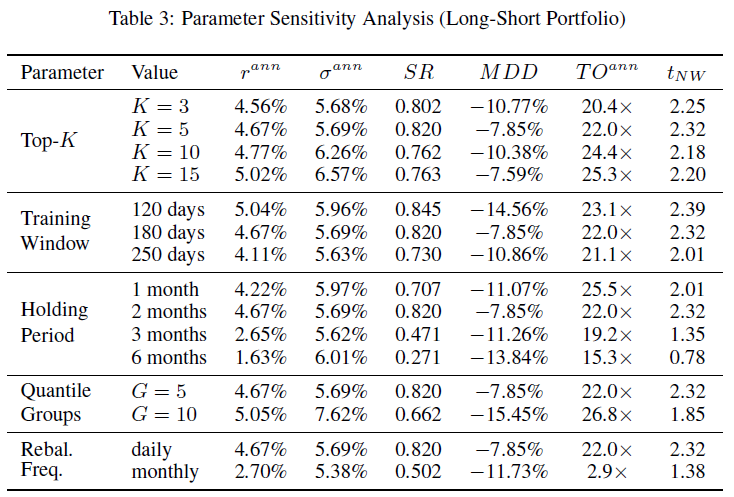
参数的敏感度
研究基线框架对关键超参数的稳健性,结果显示:
1)增加邻居数 K 可提升夏普比率,但会提高波动性和换手率,K = 5 能平衡信号强度与计算成本;
2)120 - 180 天的训练窗口表现最佳,延长至 250 天会降低夏普比率;
3)持仓期 2 个月为最佳,过短有高噪声,过长信号衰减严重。
总结
本文提出LLM增强的跨股票可预测性框架,采用“检索 - 推理”范式,先通过轻量级嵌入相似度生成候选图,再用大语言模型分类边并去除无交易价值的边,最后用精炼图构建股票信号。实证结果显示,对美国股票(2011 - 2019年标普500)实证显示,LLM过滤模块提升长短期夏普比率、降低最大回撤,语义网络远超随机图基线,Fama - French因子回归有显著正日阿尔法且因子载荷近零。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
