蚂蚁集团发布LLaDA2.0-Uni|扩散一统多模态,8步出图快到离谱
扫描下方二维码加入交流群
🔥 开源代码已放出:https://huggingface.co/inclusionAI/LLaDA2.0-Uni[1]
还在为“理解”和“生成”要训练两个模型而头疼吗?还在纠结扩散模型解码慢、语义编码器细节丢失吗?一个模型,既能看图说话、解析文档,又能根据文字生成高清大图、执行精妙编辑,甚至还能边推理边生成——这种“全能型选手”的梦想,现在被一个叫 LLaDA2.0-Uni 的模型实现了。
它不仅在多项基准测试中性能全面开花,甚至在特定任务上比肩甚至超越了那些“术业有专攻”的专家模型。这背后,是一个颠覆性的“语义离散扩散”架构。
❓ 核心痛点:为什么一个“万能”模型如此困难?
长期以来,多模态AI领域存在一个明显的“能力墙”:擅长理解的模型(如视觉语言模型VLMs)和擅长生成的模型(如文生图扩散模型)往往采用截然不同的架构和训练目标。
理解模型需要精准的语义提取,而生成模型追求的是高保真的像素重建。将它们强行塞进一个框架,就像让一个数学家和一个画家共用一套工具,结果往往是顾此失彼。之前的统一模型尝试,要么理解能力孱弱,要么生成质量堪忧,要么推理速度慢得让人无法接受。
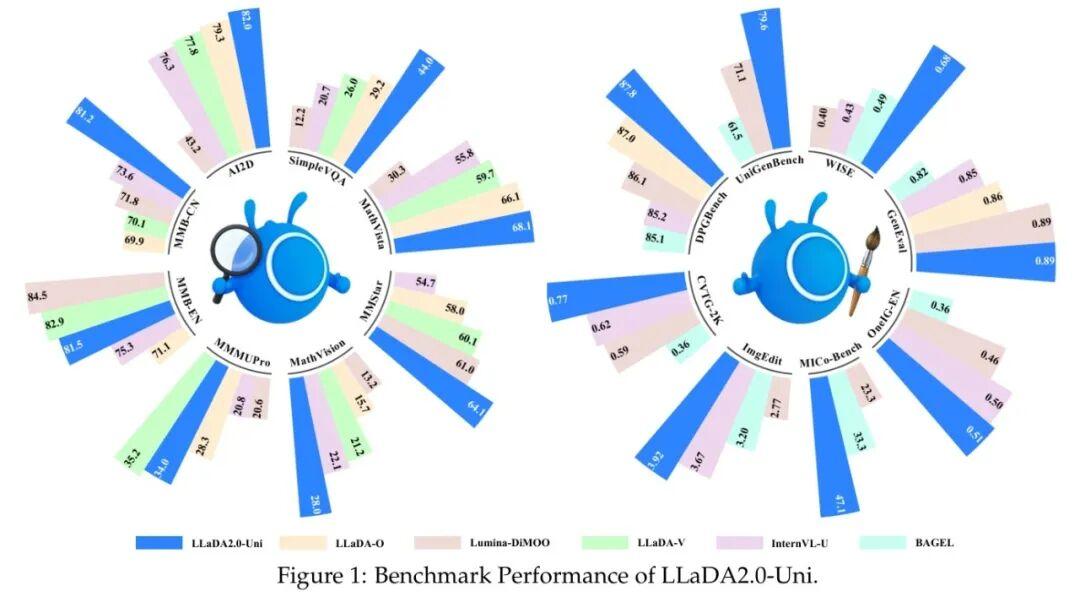
你看,LLaDA2.0-Uni的这把“大伞”几乎覆盖了所有任务,而且成绩拔尖。这不禁让人好奇:它到底是如何打破这堵“能力墙”的?秘密就藏在它的架构设计里。
🏗️ 架构拆解:三步实现“一统江湖”
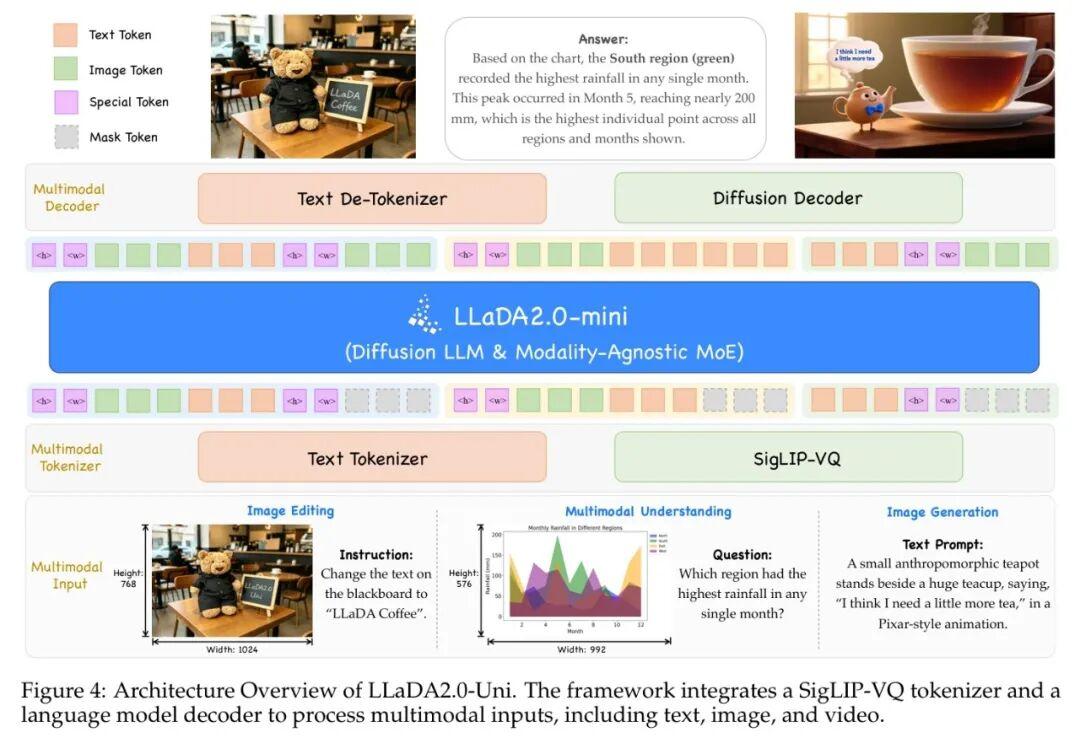
LLaDA2.0-Uni的架构设计清晰而巧妙,遵循着“统一表示 → 统一建模 → 高质量重建”的逻辑。我们通过下面这张总览图,可以一览其全貌。
💡 创新一:全语义视觉分词器(SigLIP-VQ)
这是打破“能力墙”的第一块基石。传统统一模型用的VQ-VAE分词器,目标是重建像素。这导致压缩后的视觉token丢失了大量语义信息,模型“看不懂”图里是什么,理解能力自然上不去。
LLaDA2.0-Uni则采用了SigLIP-VQ分词器。它的训练目标不是重建像素,而是直接学习视觉语义,并与强大的语言模型(如Qwen2.5)的语义空间对齐。简单来说,它把一张图转换成一串“视觉单词”,这些“单词”的含义和文本单词是在同一个“字典”里的。
- • 技术细节:它使用预训练的SigLIP视觉编码器提取特征,然后通过一个码本(16,384个词,维度2048)进行量化,得到离散的视觉token。这些token富含语义,使得后续的骨干模型能像理解文本一样理解图像。
- • 设计直觉:这就好比把图像翻译成了一种“视觉世界语”,让后续的模型处理起来毫无障碍。理解任务直接处理这些语义token,生成任务则以此为基础进行“造句”。
💡 创新二:统一的扩散大语言模型骨干
有了统一的“视觉世界语”,第二步就是用一个强大的“大脑”来处理它。LLaDA2.0-Uni的核心是一个拥有160亿参数的混合专家(MoE)扩散大语言模型(dLLM),基于LLaDA2.0-mini构建。
- • 统一目标:无论是文本还是图像token,模型都使用块级掩码扩散目标进行训练。即随机掩码掉序列中的一些块,让模型预测被掩码的内容。这个目标天然支持并行解码,效率远高于传统的自回归“下一个token预测”。
- • 模态无关的MoE:混合专家架构让模型能动态地为不同模态、不同任务分配计算资源,像一个灵活的“脑区”,无需为特定任务定制模块。
- • 分块注意力:为了避免纯双向注意力破坏语言模型固有的自回归偏差(这对生成连贯文本很重要),模型采用了分块注意力机制,在块内进行充分交互,块间连接则有所控制,在质量和效率间取得了平衡。
这个骨干模型就是通用智能的“发动机”,输入是统一的语义token序列,输出也是同样的序列。当任务是理解时,输出的是答案文本token;当任务是生成时,输出的是描述图像的视觉token。
💡 创新三:高效率的扩散解码器
SigLIP-VQ生成的视觉token是语义化的,但无法直接变回图像。因此,第三步需要一个专门的“画家”——扩散解码器,负责将语义token重建为高保真图像。
- • 基于Z-Image:解码器基于一个60亿参数的预训练文本到图像模型(Z-Image-Base)构建,但做了一个关键改动:它只以dLLM生成的视觉语义token为条件,不再冗余地输入文本提示。这强制解码器必须精确理解语义token的含义。
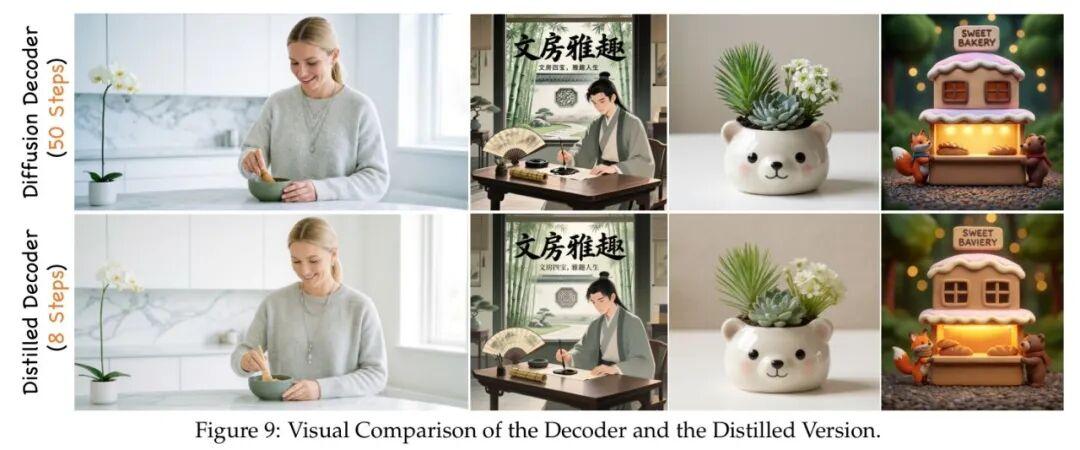
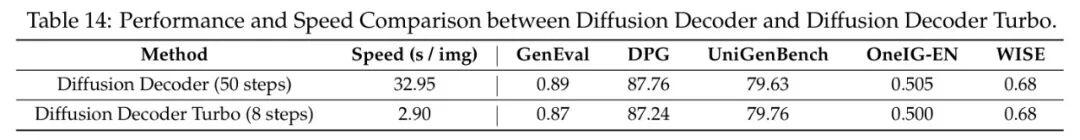
- • 少步蒸馏,速度飞跃:标准扩散模型需要50步采样,速度慢。团队对解码器进行了一致性蒸馏,在几乎不损失质量的情况下,将采样步数压缩到仅需8步。这带来了超过11倍的生成加速!
至此,一个“理解-生成-编辑-推理”的全能流水线就构建完成了。那么,它的实际表现到底有多“能打”?我们用数据说话。
📊 实验验证:数据证明“全能王”实力
LLaDA2.0-Uni在超过20个主流基准上接受了全方位考验,结果令人震撼。
🏆 SOTA对比:理解不输专家,生成领先同行
首先看多模态理解能力。下表是它与专业视觉语言模型(VLMs)及其他统一模型的对比。
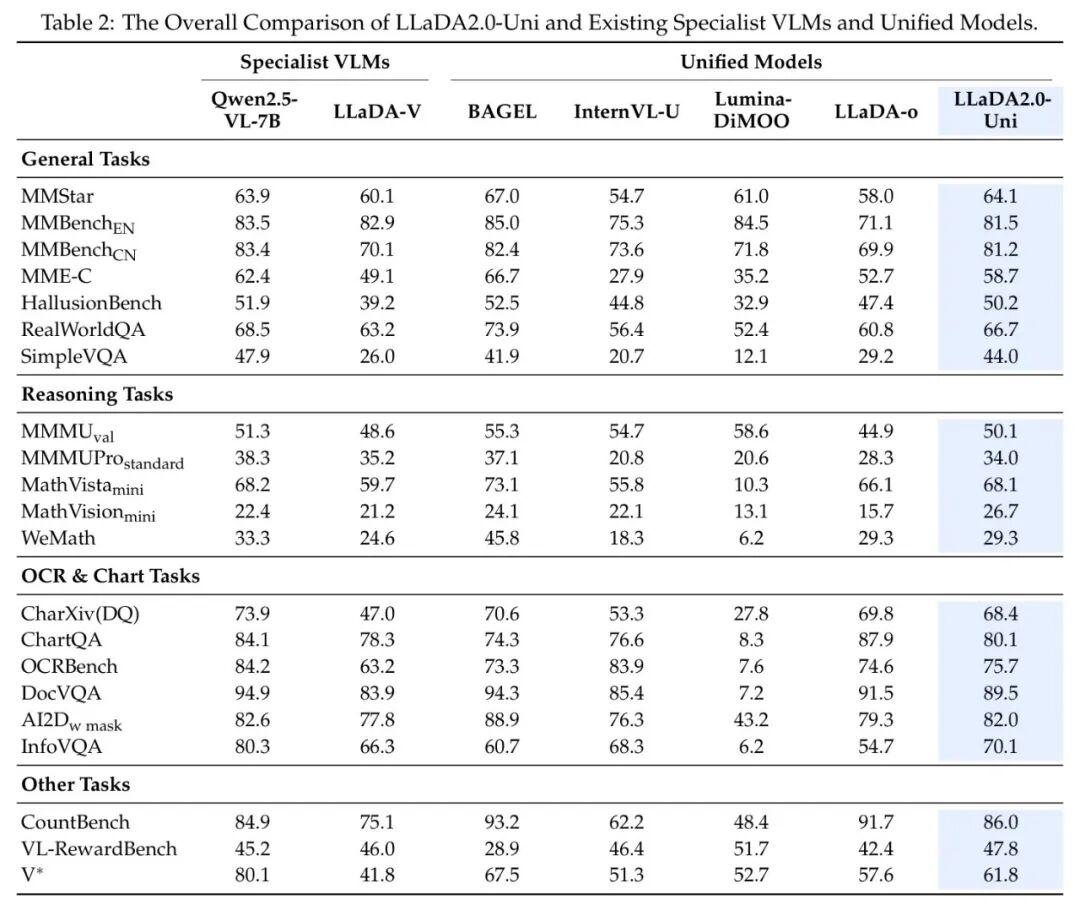
结论很明确:LLaDA2.0-Uni的理解能力,已经达到了专业VLM的水平。 这意味着,为了获得顶级理解能力而专门部署一个VLM的必要性正在降低。
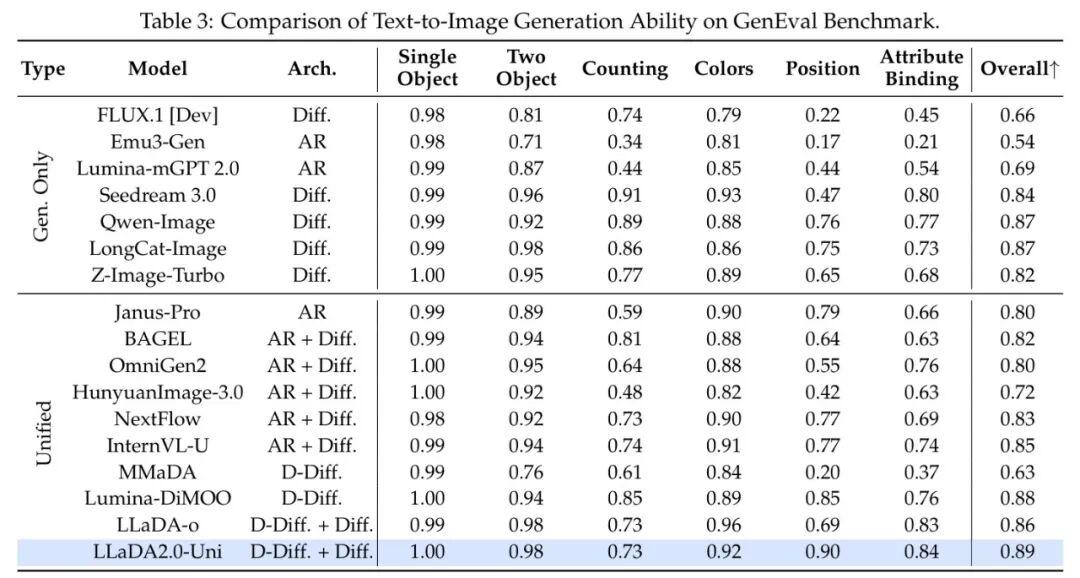
再看文本到图像生成能力。在评估组合生成能力的权威基准GenEval上,它的表现堪称惊艳。
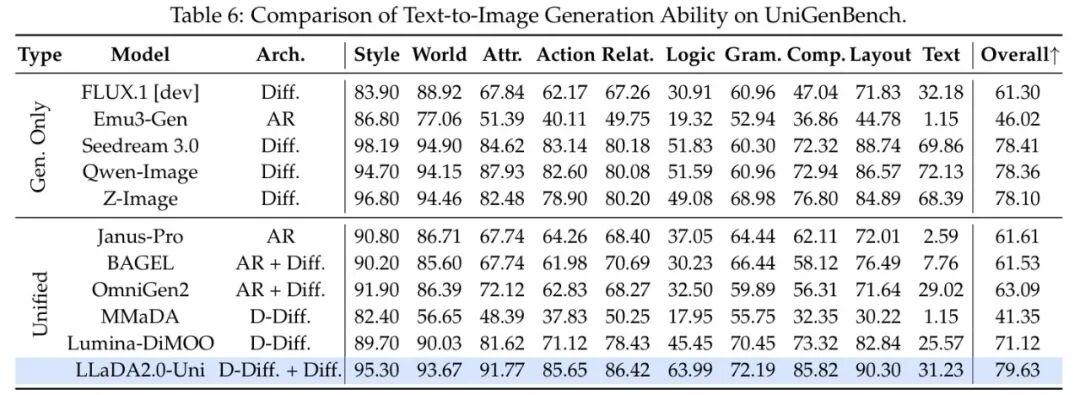
在更综合的DPG和UniGenBench基准上,LLaDA2.0-Uni同样取得了所有统一模型中的最高分,甚至在风格、逻辑、布局等维度上超越了部分专业生成模型。
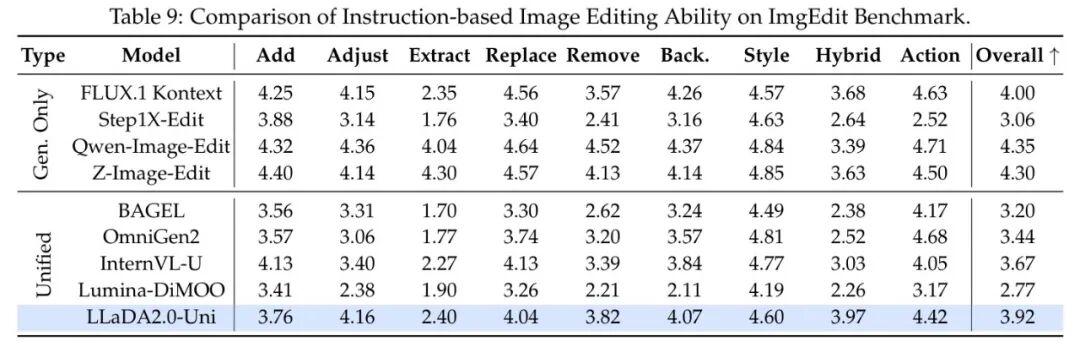
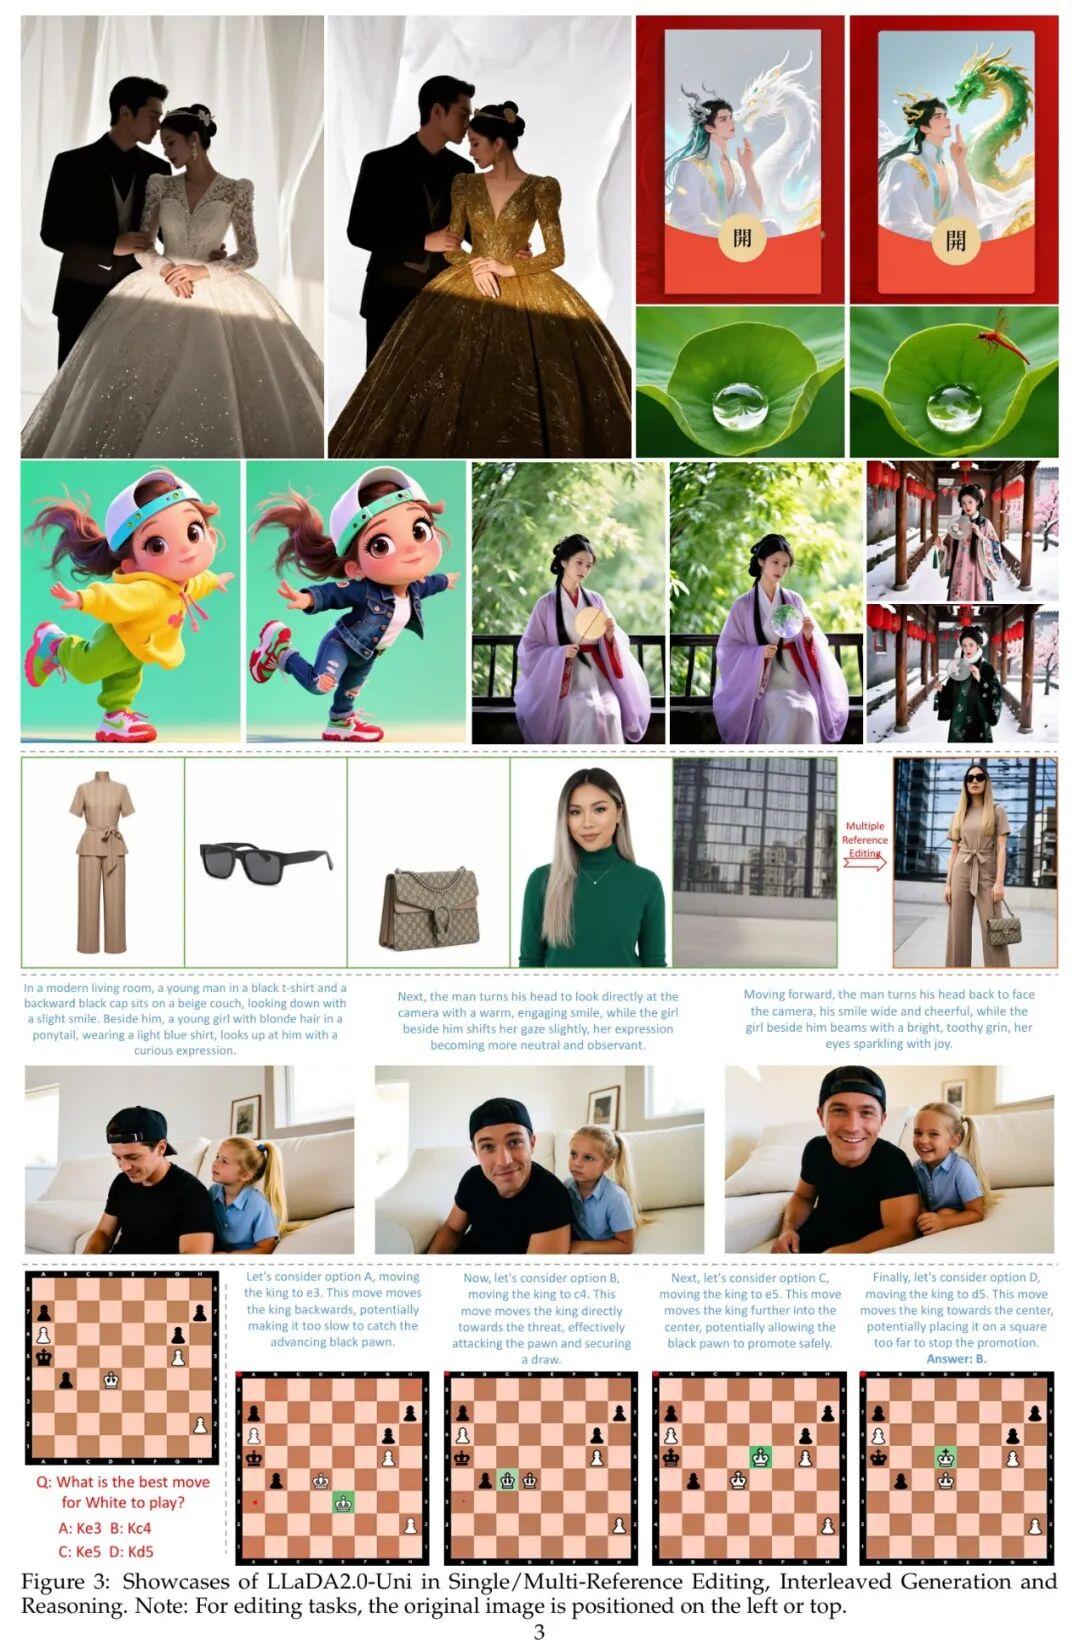
图像编辑方面,无论是通用编辑(ImgEdit)还是复杂的多参考编辑(融合多张参考图的特征),LLaDA2.0-Uni都展示出了强大的综合能力。
🔬 消融与效率:鱼与熊掌可以兼得
一个强大的模型也必须兼顾效率。LLaDA2.0-Uni在推理加速上做了两项扎实工作。
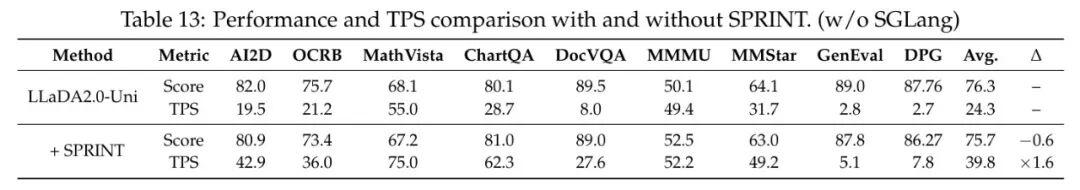
1. SPRINT:无损加速推理
为了加速dLLM骨干的推理,论文提出了SPRINT模块,它包含 “稀疏前缀保留” 和 “非均匀Token解掩码” 两个策略。前者根据重要性动态修剪注意力计算中的键值缓存,后者根据模型置信度自适应地决定每步预测多少Token,减少冗余计算。
2. 解码器蒸馏:11倍生成加速
如前所述,通过一致性蒸馏,扩散解码器在保持质量的同时,单图生成时间从约33秒缩短到约2.9秒。
这意味着LLaDA2.0-Uni不仅在能力上是“六边形战士”,在实用性上也做好了准备。
🚀 未来已来:交错生成与推理的雏形
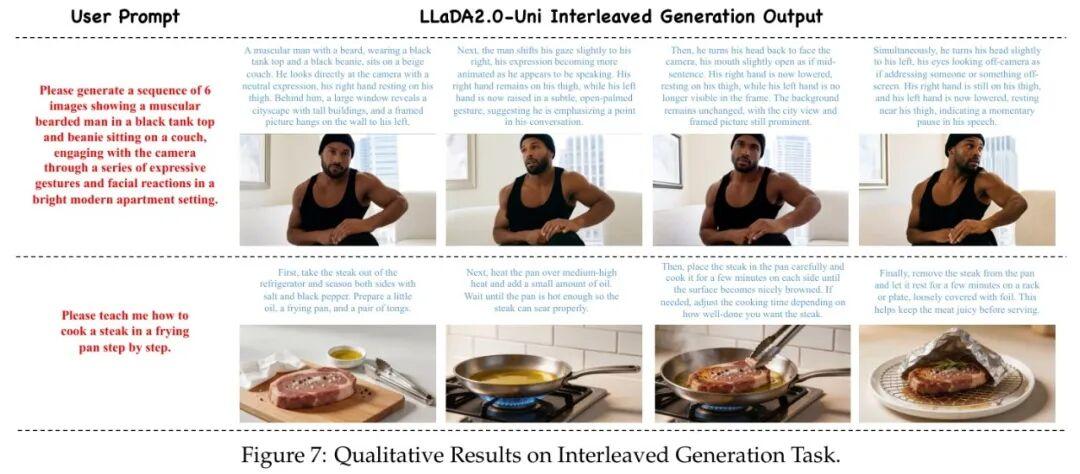
统一架构最令人兴奋的潜力,在于解锁了传统单一模型难以实现的高级能力——交错生成与推理。也就是说,模型可以像人类一样,在思考和输出的过程中,自由地混合文字和图片。
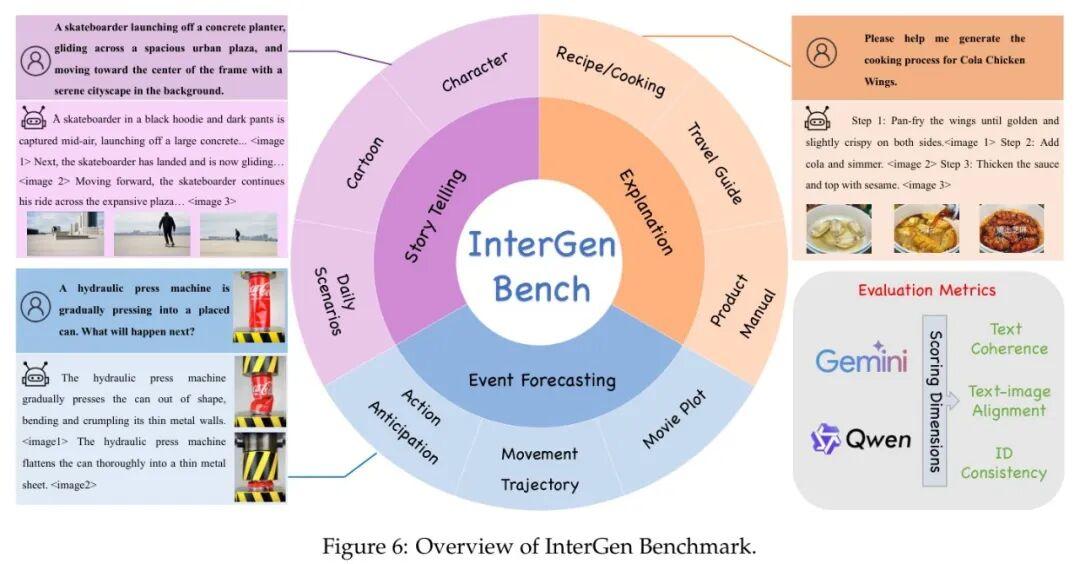
例如,让模型生成一个分步骤的烹饪指南,它不仅能输出每一步的图片,还能配上详细的文字说明。
更厉害的是,它还能进行交错推理。比如,面对一个物理力学问题或国际象棋棋局,它能像“草稿纸”一样,先输出一步步的推理文字,最终给出答案或生成对应的示意图。
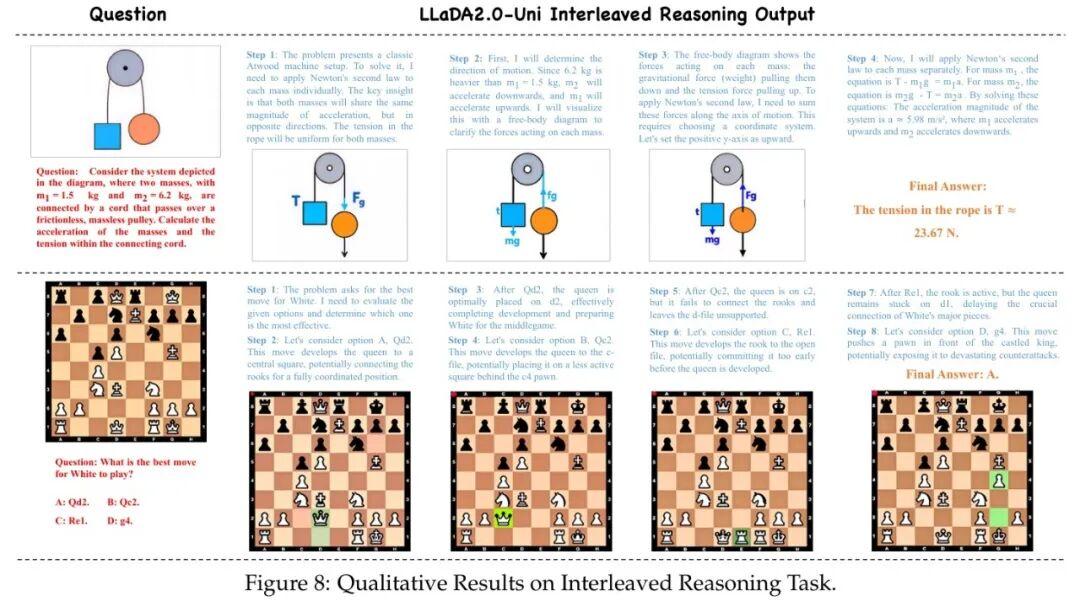
这种能力,让我们看到了未来AI助手更自然、更强大的交互形态。
⚖️ 客观评价与展望
当然,LLaDA2.0-Uni并非完美。论文也指出了其局限性:SigLIP-VQ分词器在保留极细粒度视觉细节(如毛发纹理、微小文字)上仍有提升空间;交错生成与推理的能力还有待更大规模数据和训练的进一步激发。
然而,瑕不掩瑜。LLaDA2.0-Uni的核心贡献在于,它成功地验证了 “语义离散扩散” 这条技术路线的巨大潜力。它用一个简洁统一的框架,同时攻克了理解、生成、编辑、推理、效率等多重难题,为多模态通用人工智能(AGI)的发展提供了一个极具前景且可扩展的范式。
它告诉我们,AI的“通才”时代,或许比我们想象的来得更早一些。
🤔 深度思考:你认为像LLaDA2.0-Uni这样的统一模型,最可能率先在哪个应用场景(如智能内容创作、教育、交互式娱乐)中产生颠覆性影响?欢迎在评论区留下你的观点!
💝 支持原创:如果这篇近5000字的深度解读让你对多模态AI的未来有了新的认识,点赞+在看就是最好的支持!分享给你的技术伙伴,一起探讨!
🔔 关注提醒:设为星标,第一时间获取最前沿的AI技术深度解读!
#AI技术 #多模态大模型 #LLaDA2 #AIGC #论文解读 #扩散模型
参考
LLaDA2.0-Uni: Unifying Multimodal Understanding and Generation with Diffusion Large Language Model
引用链接
[1]: https://huggingface.co/inclusionAI/LLaDA2.0-Uni