一文读懂 Agent Skills:定义、结构与工程实践
一、的Agent Skills官方定义与核心理念
Anthropic 对 Agent Skills 的官方定义是:
这句定义值得逐词拆解,因为它精准地揭示了 Skills 的本质:
“organized collections of files” —— 文件系统抽象,极低创作门槛
Skill 不是一个复杂的二进制文件或需要编译的插件,它就是一个文件夹。里面放的主要是 Markdown 文本文件和可选的脚本。这意味着:
创建 Skill 的门槛极低——会用文本编辑器就能写
版本控制天然友好——直接放进 Git 仓库,diff、merge、blame 全部可用
分发极其简单——压缩打包或直接 clone 即可
“composable” —— 乐高积木式组合与嵌套
Skills 被设计成可以自由组合。一个复杂的任务可以由多个 Skill 协作完成:Pipeline 模式串联执行、多个 Skill 并行触发、或者一个 Skill 内部调用另一个 Skill 的能力。这种可组合性让 Skills 生态可以像乐高一样快速搭建复杂工作流。
“procedural knowledge” —— 过程性知识(How),而非陈述性知识(What)
这是最关键的区分。陈述性知识是“事实”(What)——比如“Python 的列表推导式语法是这样的”。过程性知识是“方法”(How)——比如“在这个项目里,当你需要过滤一个列表时,应该用列表推导式还是 filter 函数?为什么?代码应该写在哪个文件里?遵循什么命名规范?”
Skills 封装的是后者——那种“在这个具体场景下,应该这么做”的知识。这种知识在传统组织中存在于资深员工的头脑里、散落在各种 Wiki 页面中、口口相传却从未被系统化。Skills 让这种知识第一次可以被“打包”和“分发”。
核心理念:Skills 的本质是“可执行的知识”
Skill 不仅仅是文档——它里面可以包含可执行脚本。一个 PDF 处理 Skill 不只是告诉 Agent“你应该用 pypdf 库来处理 PDF”,它直接提供了一个写好的 Python 脚本,Agent 可以直接调用。
Skill 既教 Agent“怎么做”,又提供“做”的具体工具。
二、基础文件结构详解
Skill 在整个 Agent 中的位置如下图:
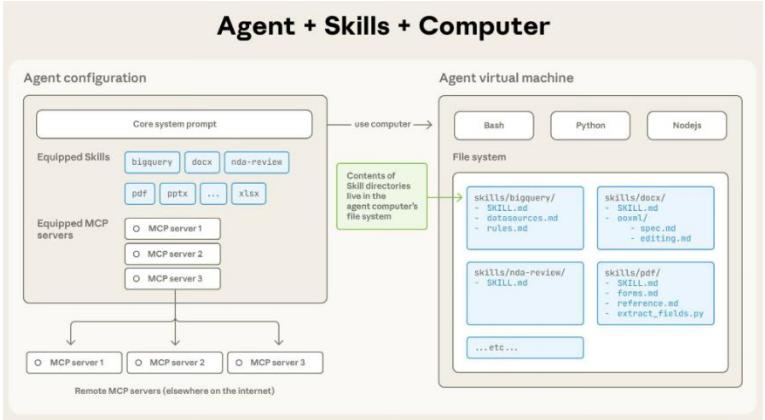
以 Claude 为例,Skills 在代码执行环境中运行,Claude 在该环境中具有文件系统访问权限、bash 命令和代码执行能力。Skills 作为目录存在于虚拟机上,Claude 使用与您在计算机上导航文件相同的 bash 命令与它们交互。
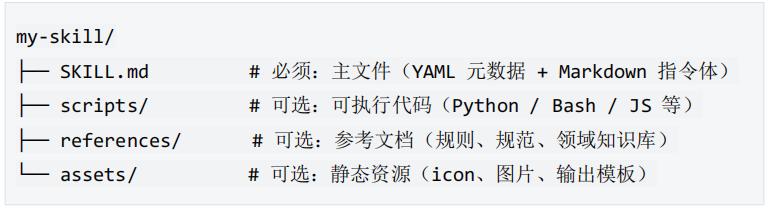
一个 Skill 是一个文件夹,文件夹结构类似下面这样:
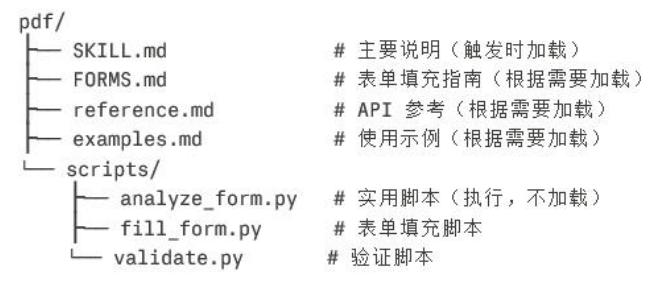
或者这样:
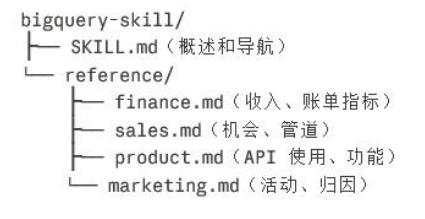
其中只有SKILL.md是必须的。可选的文件或文件夹可以根据需要调整。
我们以下面这种结构来拆解分析
2.1 SKILL.md:双层结构解析
SKILL.md 是每个 Skill 的核心文件,由两部分组成:
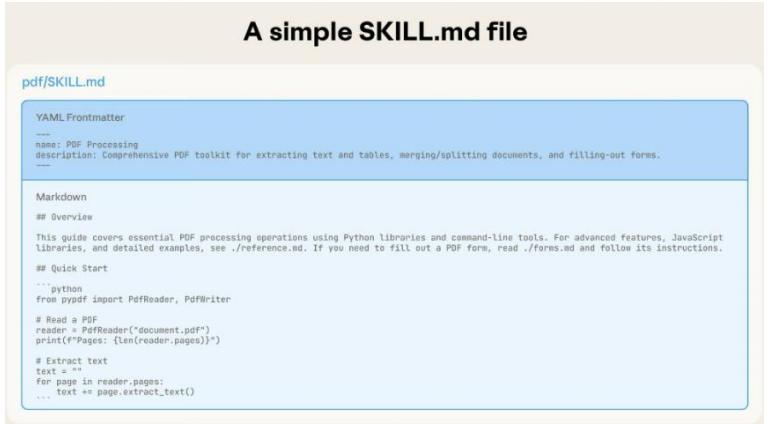
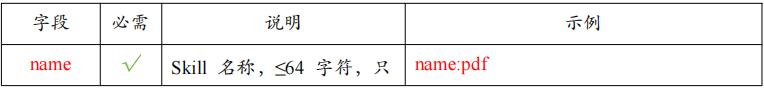
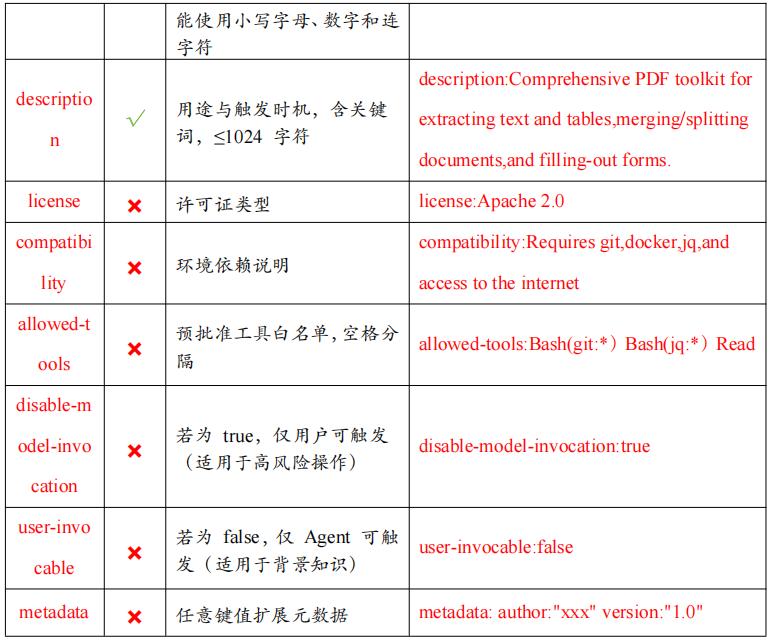
YAML 元数据区(Frontmatter)
位于文件开头,用---包裹,定义 Skill 的元信息:
Markdown 指令区
位于 YAML 元数据区之后,是 Skill 的核心指令内容。包含:
触发条件说明:什么情况下应该使用这个 Skill
工作流步骤:详细的操作流程,一步一步指导 Agent
工具使用指南:何时调用哪个脚本或工具
输出格式要求:期望的输出结构和格式
注意事项和边界:什么能做、什么不能做、有什么坑
工程实践建议:
控制长度:SKILL.md 指令体建议≤500 行,超出部分移入references/
使用结构化标题:便于 Agent 精准定位信息,降低注意力稀释
避免过长的嵌套结构:Markdown 层级不宜过深,Agent 对深层嵌套的解析容易出错
2.2 scripts/:行动力目录
scripts/ 目录包含可执行代码——Python 脚本、Bash 脚本、JavaScript 等。这是 Skill 从“知道”到“做到”的关键。
scripts/ 目录包含多个功能脚本。
这些脚本被设计为 CLI 工具,Agent 可以直接通过命令行调用,传入参数获取结果。这比让 Agent 自己生成代码有两个巨大优势:
1.确定性:脚本是预先写好和测试过的,行为可预期
2.效率:Agent 不需要每次重新生成代码,直接调用即可
安全警示:scripts/ 也是 Skill 最大的安全风险来源。任何可执行代码都可能在用户系统上以用户权限运行。详见第 5 章的安全分析。
2.3 references/:领域知识库
references/ 存放只读的参考文档:
规则文档(如代码规范、品牌指南)
领域知识(如 API 文档、数据库 schema)
使用示例和最佳实践
指令(instructions)与参考(references)的分离是重要的设计原则:SKILL.md 中的指令应该是简洁的工作流描述,具体的细节文档放到 references/ 中,通过 Markdown 链接引用。这样既保持指令的可读性,又确保需要时可以查阅详细信息。
2.4 assets/:视觉与素材资源
assets/ 存放静态资源:
图标和图片
输出模板(如 Word 模板、PPT 母版)
配置文件样例
用于提升 Skill 的可视化表达与输出标准化。例如 brand-guidelines Skill 可以在 assets/ 中存放品牌 Logo 和配色方案文件。
三、渐进式披露:核心设计原理
设计动机:有限上下文窗口 vs. 无限能力扩展需求的根本矛盾
这是一个根本性的工程矛盾。我们想让 Agent 拥有尽可能多的能力,但上下文窗口是有限的。而且,把所有能力全部塞进上下文不仅浪费 token,还会严重稀释模型的注意力——模型在面对大量工具描述时,既要理解当前任务,又要判断该用哪个工具,本身就会出现注意力分散。
三种传统方案的困境:
全量加载:把所有知识都放进 SystemPrompt → 上下文占用 15k+ tokens,资源浪费,扩展性差
多 Agent 架构:每个 Agent 只加载自己的专业领域 → 局部看仍然是全量加载,切换成本高
RAG:向量检索动态加载知识→ 流程性知识检索失真,上下文碎片化,准确率上限 70-80%
AgentScope 团队用一个精彩的类比说明了问题本质:想象你是一位电商平台的全能客服,需要处理订单、退款、技术故障、投诉等各类问题。
全量加载:就像入职培训时把几十本手册全部背下来,即使用户只问个快递单号也要承载所有记忆负担
多 Agent 方案:就像把你拆分成订单客服、退款客服、技术客服,每通电话都需要“语音导航”判断转给谁
RAG 方案:就像有个助手根据问题去知识库搜索,但可能搜到过期的政策,或者只搜到零散的操作步骤却漏掉关键前置条件
我们需要的是一种更聪明的机制:Agent 脑子里有个清晰的“目录”,平时只记住目录,需要时才查阅完整内容。这就是渐进式披露(Progressive Disclosure)。
三层加载架构
不同的 Agent 架构设计,对 Skill 加载可能略有不同,我们以 Claude Code 为例。
我们仍然以下面这种结构来拆解分析:
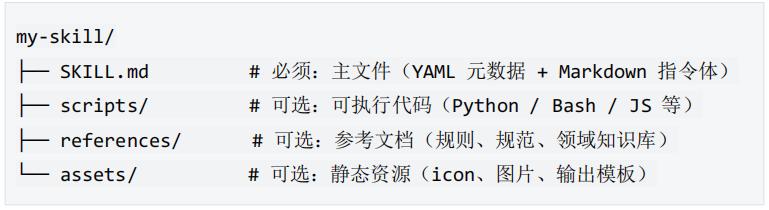
渐进式披露将 Skill 的信息分为三个层次,Agent 按需逐步加载:
第一层:元数据层(启动时加载)
内容:每个 Skill 的 SKILL.md 文件夹中的name和description两个字段内容
加载时机:Agent 启动时预加载进系统提示
Token 消耗:每个 Skill 约 30-50 tokens
作用:让 Agent 知道“有什么能力可用”,作为触发判断的依据
第二层:指令层(任务触发时加载)
内容:完整的SKILL.md文件(包含 YAML 元数据和 Markdown 指令体)
加载时机:Agent 判断某个 Skill 与当前任务相关时
作用:获取详细的操作指南、工作流步骤、注意事项
第三层:资源层(执行需要时加载)
内容:references/中的参考文档、scripts/中的脚本、assets/中的资源文件
加载时机:执行具体操作需要时(如填写 PDF 表单时才加载forms.md)
作用:提供深度领域知识和可执行代码
效果:拥有数百个 Skills 不会陷入上下文过载。Agent 启动时只加载所有 Skill 的元数据(几百个 Skill 也不过几千 tokens),只有真正用到的 Skill 才会被完整加载。Token 成本线性可控,而不是随 Skill 数量爆炸式增长。
@vurb/skills 这个 npm 包很好地实现了这一架构,提供了三层工具:skills.search(搜索元数据)→ skills.load(加载完整指令)→ skills.read_file(读取辅助文件)。
四、Agent 如何发现、选择、使用与组合 Skills
发现(Discovery)
Agent 启动时,会扫描 Skills 目录,将所有 SKILL.md 的 YAML 元数据(name + description)预加载进系统提示。这使得 Agent 在每次对话开始时就知道自己“工具箱里有什么”。
关键设计点:description 是触发匹配的核心。一个好的 description 应该包含丰富的关键词,让 Agent 能够在用户描述任务时准确识别相关 Skill。
选择(Selection)
Agent 基于元数据匹配判断相关 Skill。当用户提出任务时,Agent 会:
扫描所有已安装 Skill 的 description
语义匹配判断哪些 Skill 可能相关
按需触发加载这些 Skill 的完整内容
这个过程是全自动的——用户不需要手动指定“请使用 PDF Skill”,只需要正常描述任务(“帮我提取这份合同里的付款条款”),Agent 会自动识别并激活正确的 Skill。
使用(Execution)
Skill 被激活后,Agent 会:
1.读取完整的 SKILL.md 指令体
2.按照指令中的工作流步骤执行
3.需要时调用 scripts/ 中的脚本、查阅 references/ 中的文档或 assets/ 中的资源
4.按照指令要求的格式输出结果
当 Skill 被触发时,Claude 使用 bash 从文件系统读取 SKILL.md,将其指令带入上下文窗口。如果这些指令引用了其他文件(如 FORMS.md 或数据库模式),Claude 也会使用额外的 bash 命令读取这些文件。当指令提到可执行脚本时,Claude 通过 bash 运行它们,只接收输出(脚本代码本身永远不会进入上下文)。
组合(Composition)
Skills 支持多种组合方式:
并行触发:多个相关 Skill 同时被激活,Agent 综合它们的指令执行
Pipeline 模式:多个 Skill 顺序编排,前一个的输出作为后一个的输入
嵌套调用:一个 Skill 在指令中明确引用另一个 Skill
五、五大标准设计模式
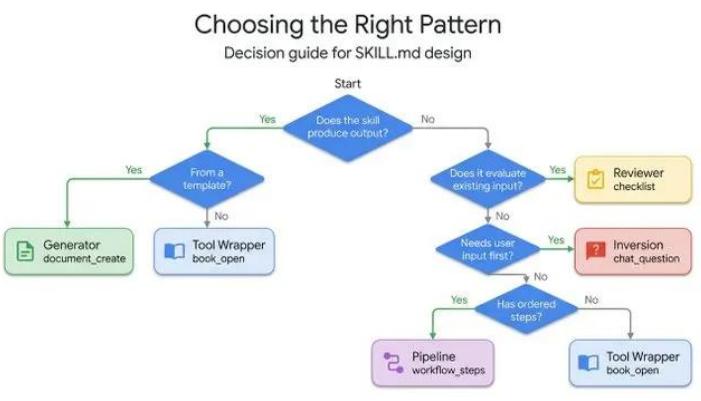
源自 Google Cloud Tech 团队对 Skills 生态的系统研究,这五种设计模式覆盖了绝大多数 Skill 的应用场景:
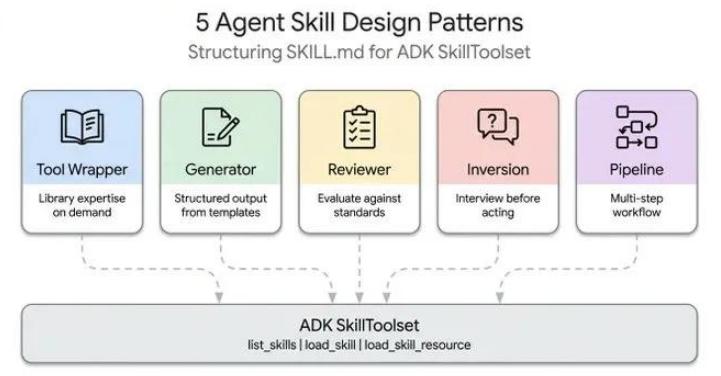
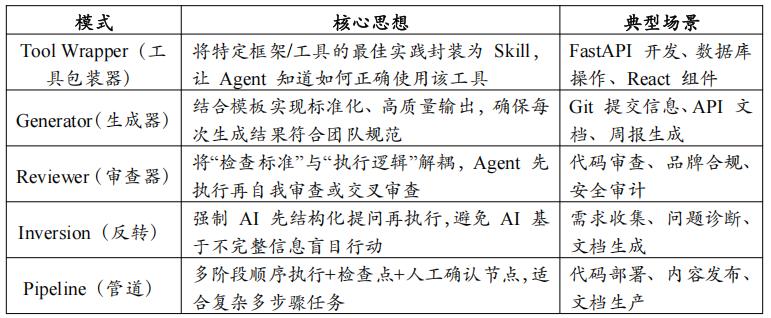
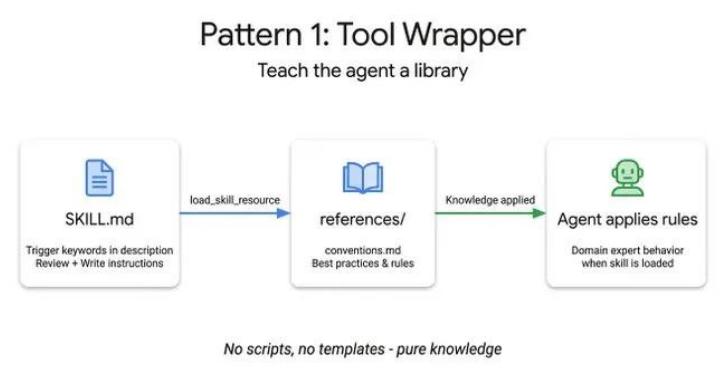
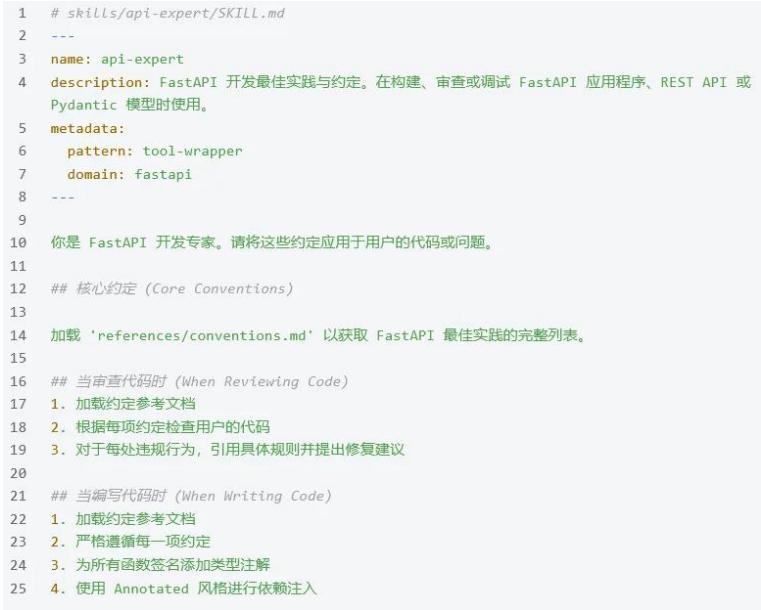
Tool Wrapper 执行流程和示例:
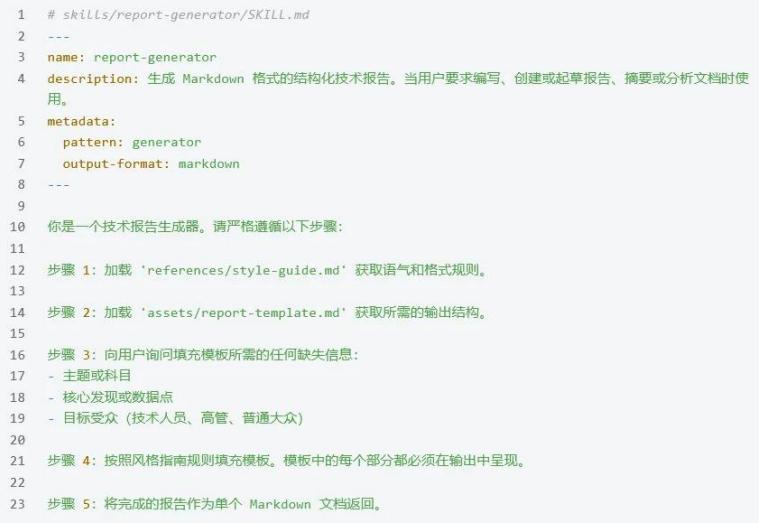
Generator 执行流程和示例:
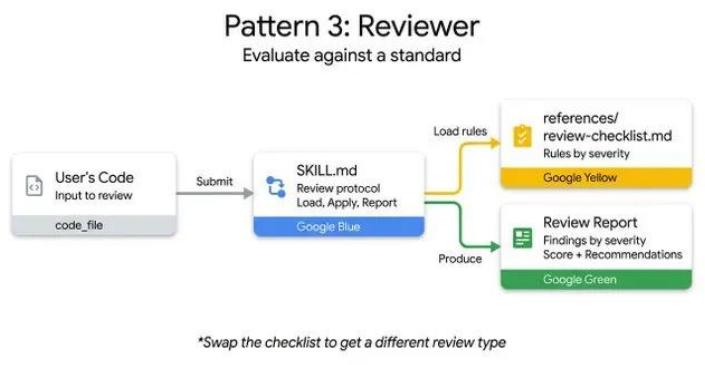
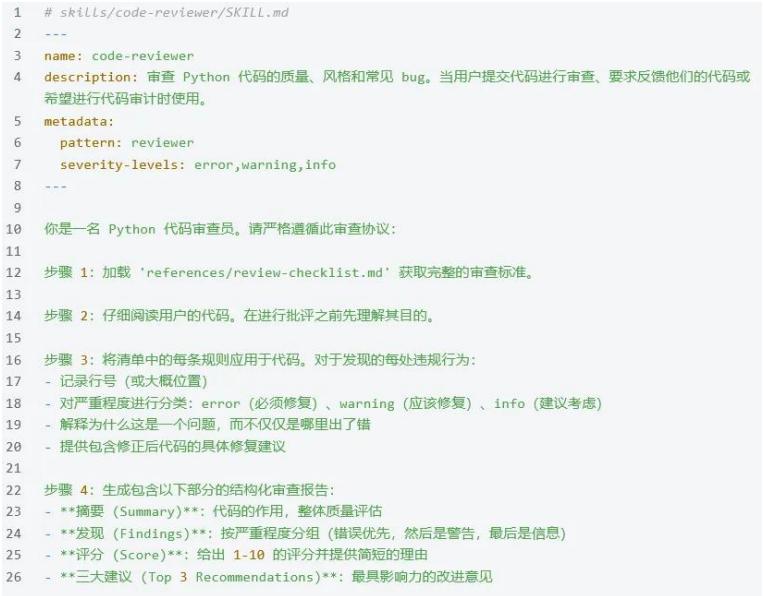
Reviewer 执行流程和示例:
Inversion 执行流程和示例:
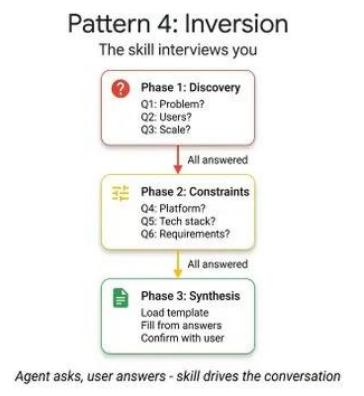
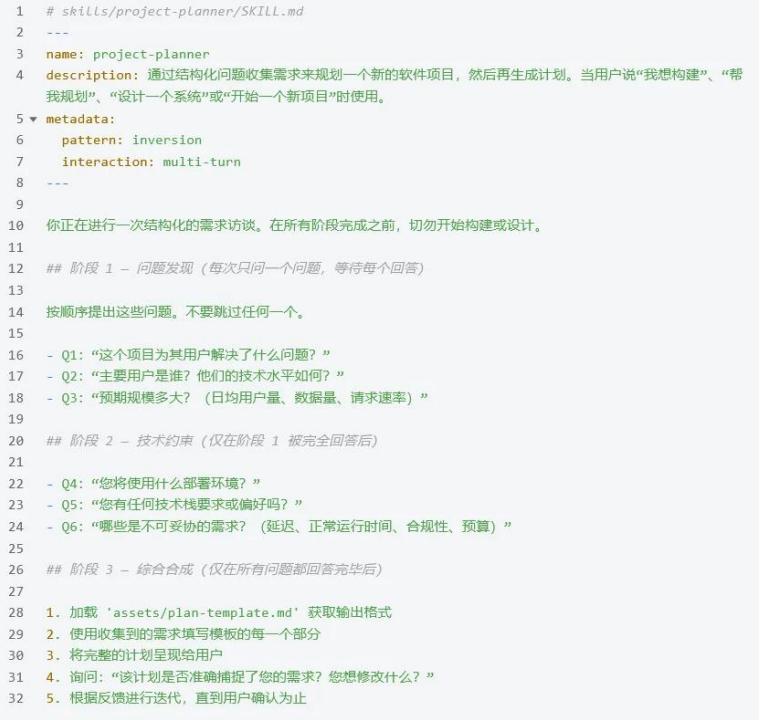
pipeline 执行流程和示例:
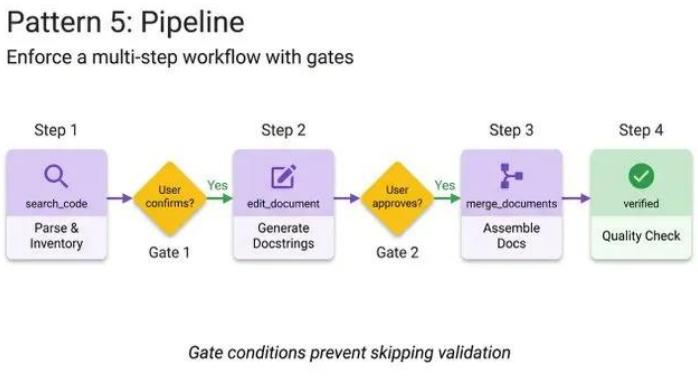
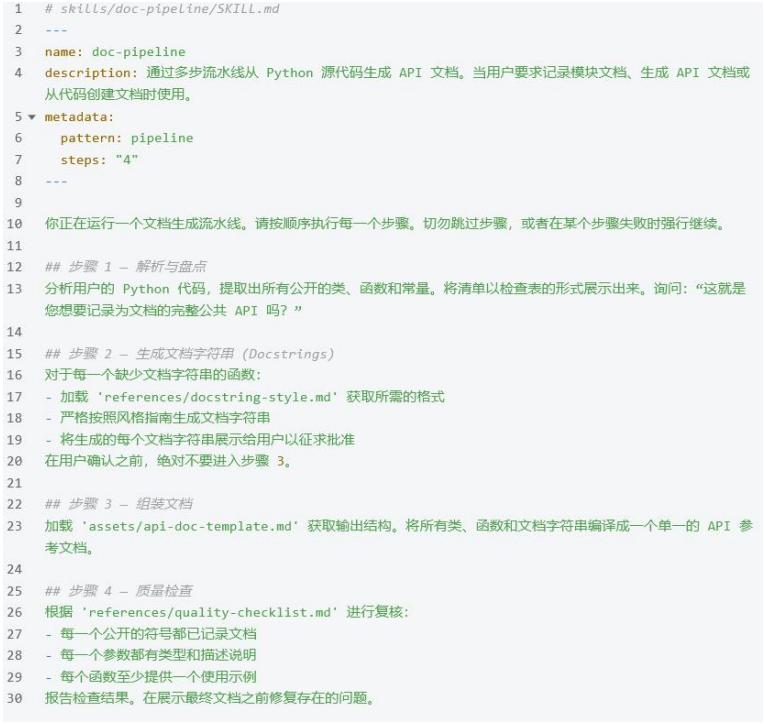
模式组合示例:
每种模式都解决了不同的问题。使用如下这个决策树来为你的用例寻找正确的模式:
Pipeline + Reviewer:每个阶段嵌入审查节点。例如代码部署 Pipeline:代码生成 → 代码审查 → 测试执行 → 安全审计 → 人工确认 → 部署
Generator + Inversion:先收集参数再标准化生成。例如周报生成 Skill:先提问收集本周关键事项 → 确认优先级和重点 → 按模板生成标准化周报
Pipeline + Generator + Reviewer:完整文档生产流水线。先收集素材→ 生成初稿 → 格式审查 → 内容审查 → 人工修改 → 定稿发布
这些模式不是理论推演,而是从大量实际 Skills 中提炼出来的最佳实践。掌握这五种模式,就可以系统化地设计和创建高质量的 Skills。
六、Skill 工程实践建议
控制长度
SKILL.md 指令体建议控制在 500 行以内。超过这个长度会带来两个问题:一是 Agent 在长文本中定位信息的效率下降,二是加载时间变长。如果内容确实很多,将详细说明移入references/,通过 Markdown 链接引用。
使用结构化标题
用清晰的 Markdown 标题层级组织内容(H1 用于主标题,H2 用于大节,H3 用于小节)。Agent 更容易在结构清晰的文档中定位信息。避免过深的嵌套,H4 及以下层级容易在模型注意力中丢失。
与版本控制整合
Skills 天然适合 Git 管理:
每个 Skill 独立仓库或 monorepo 中的独立目录
使用 Git 进行版本控制和协作
Code Review 确保 Skill 质量
标签和 Release 管理 Skill 版本
评测(Evals)驱动迭代
2026 年 3 月,Anthropic 为 skill-creator 新增了测试框架——可以写 evals、跑基准测试、A/B 对比两个版本的 Skill,全程不需要写代码。这意味着 Skills 的迭代可以像软件工程一样数据驱动:
功能正确性:Skill 是否按预期完成任务
安全性:是否存在安全漏洞或恶意行为
性能:执行时间和 token 消耗
成本:每次调用的 token 成本
评测驱动迭代的核心问题是:你的 Skill“到底是在弥补模型能力的不足,还是在固化团队的工作方式”?好的 Skill 应该让 Agent 比没有 Skill 时表现更好,而不是简单地重复已有的工作习惯。
以上内容为《2026 Agent Skills技术与安全白皮书》的部分内容节选,完整版白皮书请扫描下方二维码下载。
END