谷歌分布式训练开启另一轮扩展定律!百万芯片高压高故障仍然零全局停机
现今训练最先进大语言模型,有一个听起来很荒谬的常态。
想象一下,一支由上万名抄写员组成的团队,正在共同誊写一部巨著。所有人必须步调一致,每写一个字,就要互相核对一次,确保笔迹完全一样。只要有一个人打了个喷嚏,慢了半拍,整个誊写工作就得停下来等他。
而谷歌最新名为Decoupled DiLoCo的研究,直接把这种锁步模式扔进了历史博物馆。
它让一个庞大集群里的不同部分可以各干各的,再通过一种极其聪明的方式异步汇合。
最惊人的成果是,当模拟数百万芯片在频繁故障的高压环境下训练时,这套系统做到了零全局停机时间,而模型性能丝毫不打折扣。
解构锁步的困境
今天的大模型训练,普遍采用一种叫SPMD(单程序多数据流)的范式。
你可以把它理解成一个极其庞大且严苛的方阵,所有计算芯片步调完全一致。
这种对参数一致性的执念,让系统变得脆弱无比。
一个问题芯片、一次网络抖动,都能让整个价值数亿美元的集群陷入停滞。
团队用一种非常有趣的视角,类比计算机领域的CAP定理,重新审视了模型训练的瓶颈。
他们认为,传统SPMD训练是一个一致性原教旨主义者,为了确保每块芯片看到的模型参数都分毫不差,不惜牺牲掉可用性和分区容错性。
在成千上万块芯片协同工作数月的场景下,硬件故障就像家常便饭。
每次故障都意味着停机、等待、恢复和算力浪费,如同一个繁忙的机场,因为一盏信号灯故障,就要关闭所有跑道。
破局之道,叫做Decoupled DiLoCo。
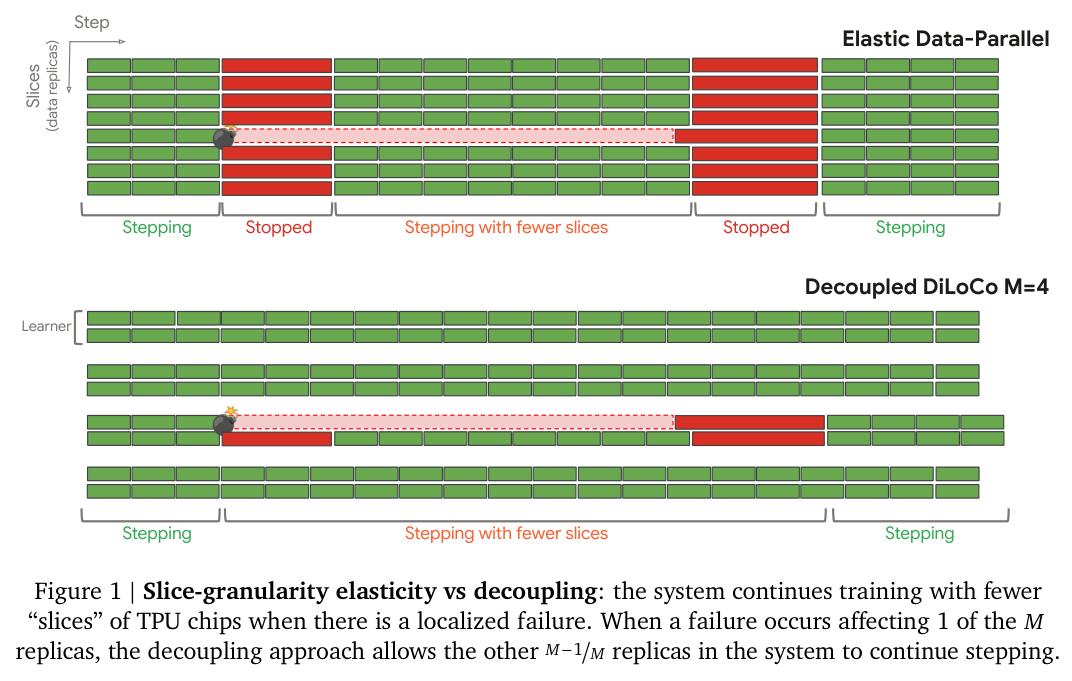
思路简单而优雅:将一个铁板一块的大集群,拆分成若干个独立的小团队,称为Learner(学习者)。
每个学习者拥有完整的模型副本,在自己的数据上埋头训练,互不干扰。就算其中一个学习者遭遇硬件崩溃,其他学习者的工作也完全不受影响。
协调这些学习者的重任,落在一个叫Syncer(同步器)的中央节点身上。
但这位调度员从不要求所有人立正站好。它会按照预设的时间节奏,随机地向所有正在工作的学习者发出邀约,收集它们训练好的模型参数碎片。
它只等待一个最低数量的学习者响应,就能完成一次全局参数的优化更新。那些因为故障或网络延迟而迟到的学习者,会被暂时跳过,等待下一次机会。整个过程,训练从未停歇。
这种设计带来了实实在在的收益。
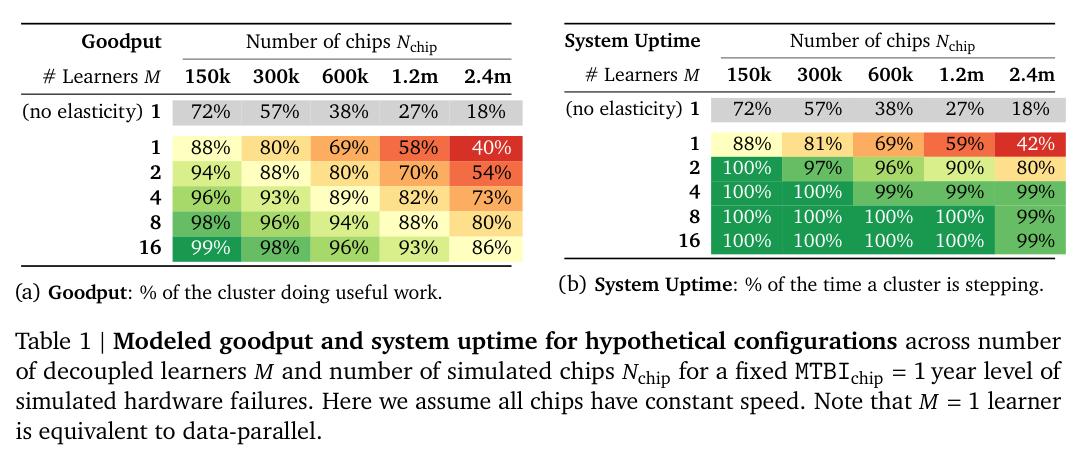
一项模拟数据显示了惊人的对比。假设单个芯片平均一年出一次故障,在一个由240万块芯片组成的庞大集群里,没有弹性功能的常规数据并行训练,系统有效工作时间仅为18%。即便加入了动态调整功能,有效工作时间也跌至40%。
而当切换到Decoupled DiLoCo,并将集群拆分为16个独立学习者时,系统有效工作时间飙升至86%,系统无故障运行的时间占比更是保持了近乎完美的99%。
优雅的混沌工程实验
为了验证这套框架的鲁棒性,团队做了一件很酷的事情。
他们在代码里模拟了一个修罗场,通过混沌工程的原则,人为地注入各种故障。他们设定故障发生的频率、恢复时间、甚至芯片处理速度的随机波动,来考验系统的极限。
结果令人振奋。
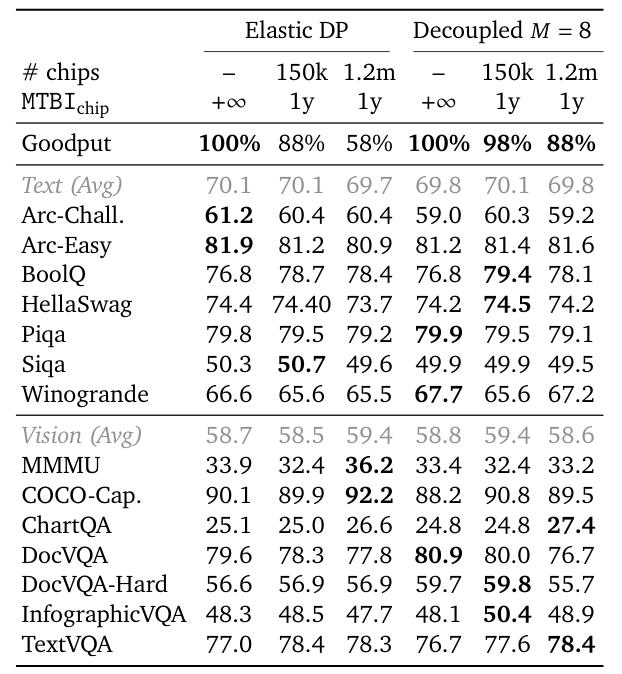
在一个包含8个学习者、模拟120万块芯片、故障环境恶劣的实验中,Decoupled DiLoCo的系统有效工作时间保持在88%,而同样条件下的传统模式只有58%。
更关键的是,在应对这些混乱的同时,模型在文本和视觉任务上的表现,和那些在完美无故障环境下训练出的模型,依然保持了同等水平。在一个5B参数的密集模型上,无论是平均文本得分还是视觉得分,都几乎没有变化。
这意味着,训练团队不再需要用牺牲模型质量来换稳定性,或者反过来。他们可以同时拥有两者。
捡拾算力与异构硬件大一统
这种解耦架构还释放了两个令人兴奋的额外红利。
一个是算力撷取。训练集群的利用率很少能一直保持100%。比如,可能会有一些即将被抢占的计算资源,或者不同地理位置分散的硬件,在某个时间段内闲置。
Decoupled DiLoCo可以像一个灵活的插线板,随时接入这些临时可用的算力作为新的学习者。
论文展示了一个实验,当可用算力在训练过程中动态增加300%时,模型不仅没有崩溃,训练时间反而压缩到了原来的62%,性能与基线持平。
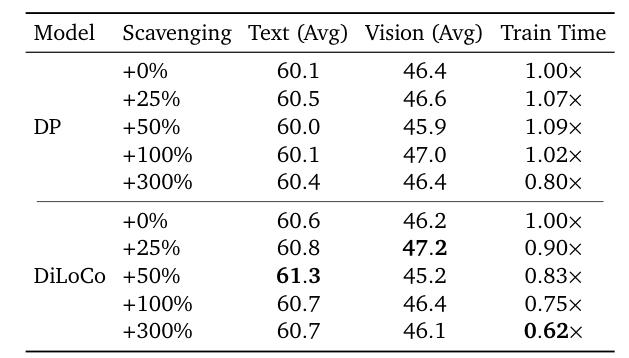
而传统数据并行模式,由于状态传输和同步开销,在这种动态扩缩容的场景下,时间收益要小得多。
另一个是异构计算。不同代际、不同型号的芯片可以无缝地加入同一个训练任务。
在一次实验中,研究者混合使用了两种不同型号的TPU,即使它们之间的处理速度有接近20%的天然差异,通过Decoupled DiLoCo和一个聪明的自适应等待机制,系统高效运转,模型最终效果与纯同步设置无异。
这为企业平滑过渡到新硬件、或者充分利用旧硬件库存,打开了充满想象力的新空间。
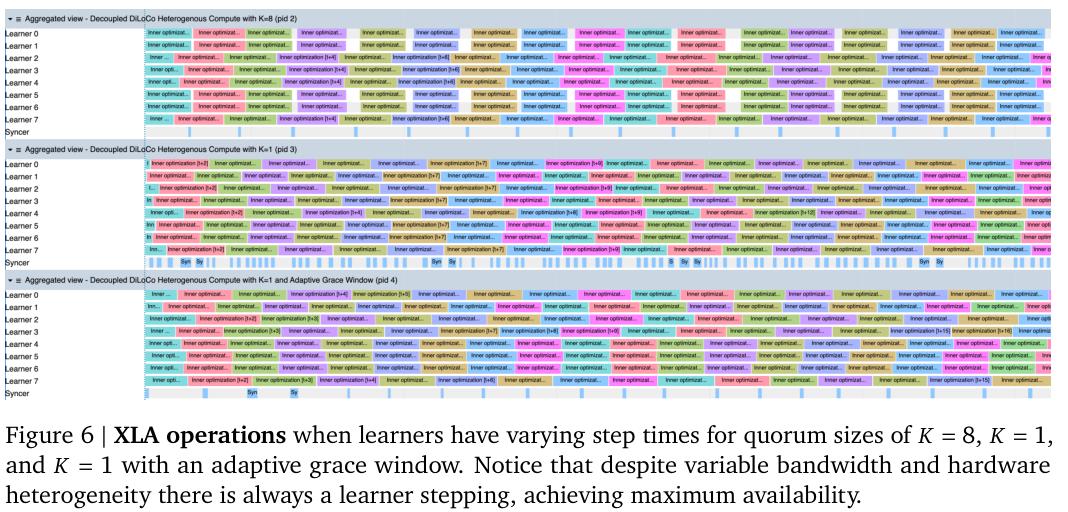
上图展示了在不同设置下,运行速度不一的学习者们的忙碌状态。第一行是保守的等待全部学习者到齐的模式,产生了大量空闲。第二行是激进的不等待模式,虽然忙碌,但同步过于零碎。第三行是论文采用的自适应策略,它在不造成等待的前提下,尽可能地汇集了更多学习者的贡献,达成了效率与质量的良好平衡。
规模定律依然有效
一个始终悬挂在分布式训练方案头上的疑问是:这种松耦合会损害模型的最终能力吗?尤其是在模型规模和训练数据量都急剧增大的时候。
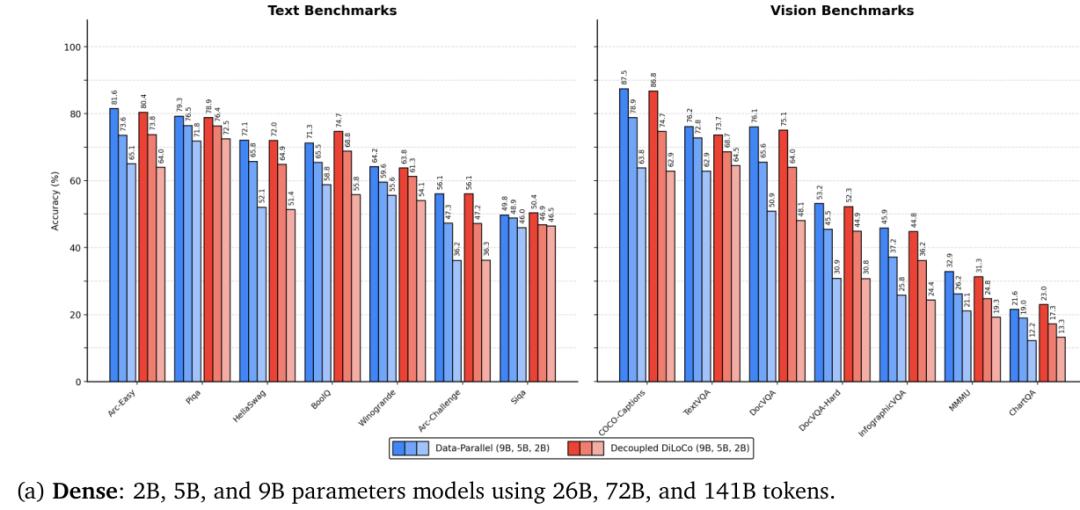
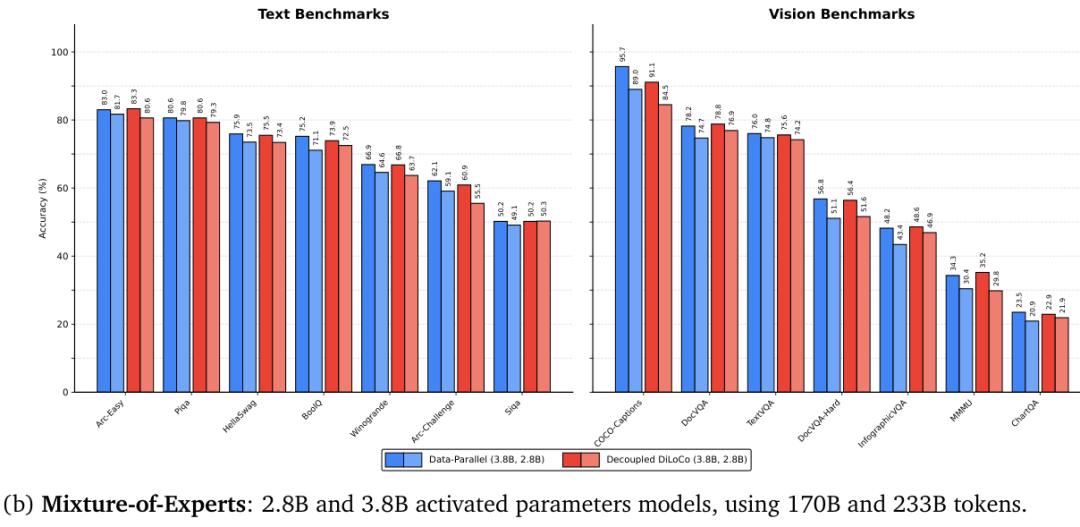
答案是否定的。论文系统地验证了从2B到9B参数的密集模型,以及2.8B和3.8B激活参数的混合专家模型。
在所有尺度上,Decoupled DiLoCo都取得了和传统同步数据并行训练相匹配的下游任务性能。无论是对文本理解的平均得分,还是对图表、文档的理解能力,差异都在可忽略的范围内。
该研究直接挑战了同步是必须的这个默认前提。它用一个极简的、异步的、对故障友好的系统设计,证明了在大规模训练中,我们可以通过牺牲一些无关紧要的一致性,来换取更宝贵的系统可用性和硬件容错性。
当AI训练规模持续向极限扩张,硬件集群的异构性和地理分布性日益普遍,这种从追求全局一致转向拥抱局部独立的理念,或将成为新一代基础设施设计的基石。
若将大规模AI训练比作一场马拉松,与其让万人方阵踢着正步艰难走向终点,不如让每个小队跑出自己的节奏,在终点前完成一次精彩的智慧汇合。
参考资料:
https://arxiv.org/pdf/2604.21428