QuantCode-Bench:LLMs量化代码生成质量评估基准
“QuantCode-Bench: A Benchmark for Evaluating the Ability of Large Language Models to Generate Executable Algorithmic Trading Strategies”
大语言模型在通用编程任务表现佳,但生成可执行算法交易策略能力待探索。本文提出 QuantCode - Bench 基准,围绕 Backtrader 框架,含 400 个任务,设单轮和多轮交互设置。采用四阶段评估流程,可区分模型四种能力。实验表明,单轮设置中前沿模型编译率高但后续表现差,多轮设置性能提升,但部分失败源于对自然语言规范的错误解读。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
大语言模型在通用编程任务表现佳,但生成可执行算法交易策略能力待探索。本文提出 QuantCode - Bench 基准,用于系统评估现代大语言模型根据英文文本描述为 Backtrader 框架生成策略的能力。该基准含 400 个不同难度任务,通过多阶段流程评估,对比单轮和智能多轮两种设置下的模型表现。单轮最佳模型“Judge Pass”约 70 - 76%,多轮可达 95 - 98%。分析表明当前模型主要局限在于交易逻辑操作、API 使用和任务语义遵循,交易策略生成是特殊代码生成任务,需兼顾技术正确与多方面的一致性。
简介
现有代码基准多关注通用编程等任务,未充分体现模型在特定领域应用场景的行为。算法交易策略生成任务特殊,需理解主题、遵循 API 并产生有意义行为,现有基准无法满足其评估需求。
本文提出 QuantCode - Bench 基准,围绕 Backtrader 框架,含 400 个任务,设单轮和多轮交互设置。采用四阶段评估流程,可区分模型四种能力。实验表明,单轮设置中前沿模型编译率高但后续表现差,多轮设置性能提升,但部分失败源于对自然语言规范的错误解读。
本文引入专为生成可执行算法交易策略设计的基准。提出区分技术可执行性、交易行为存在性及与任务规范语义对齐的多级评估框架。对比现代模型在单轮和智能体设置下的表现。进行详细错误分析,确定流程各阶段主要失败模式。发布基准供金融领域特定代码生成研究复用。
QuantCode-Bench
任务定义
QuantCode - Bench评估模型根据文本描述生成Backtrader交易策略的能力,有四项嵌套要求:策略语法正确、能在回测环境成功执行、在历史数据上至少完成一笔交易、符合交易思路。该基准比一般编码任务更严格,各验证阶段层层递进,主要指标Judge Pass为策略通过整个评估流程的任务比例。
数据集
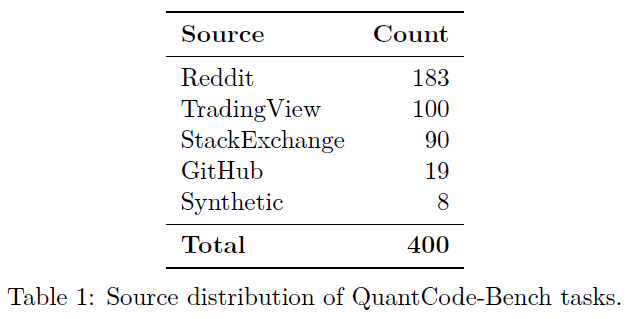
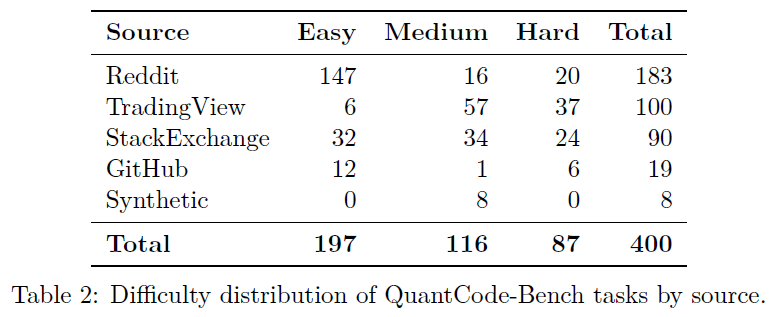
QuantCode - Bench数据集有400个交易策略生成任务,描述来自多源,形式、结构和详细程度各异。各任务经结构丰富,提取指标、进出条件和额外规则,并划分难度等级(易、中、难)。
Backtrader
选择Backtrader是因其作为开源框架在回测和交易策略原型开发中广泛使用,且API有一定复杂度。它要求模型正确处理指标、数据行、订单执行方法和索引约定,使基准测试更贴合实际代码生成,降低靠套用模板取得成功的可能性。
评估方法
验证过程
QuantCode - Bench评估采用四阶段过程:
1.)编译:代码语法正确可解释。
2.)回测:策略在基准历史数据上无运行时错误执行。
3)交易:策略至少完成一笔交易。
4.)评判:LLM法官确认策略与任务描述匹配。
该过程可定位失败点、分解不成功生成,对特定领域任务避免单一指标掩盖不同失败原因。
大模型裁判
流程最后阶段用于验证生成策略与原始任务描述的语义一致性,因策略可能技术可行但实质错误。为此使用大语言模型(LLM)评判代码,评判标准有:指标是否与原描述对应或等价。策略的关键进出及行为逻辑是否实现。代码是否为相关实现而非通用模板替换。此方法与“LLM 评判器”相关文献一致。
评估设置
考虑两种交互设置:
单轮设置:模型接收任务描述后首次尝试生成正确策略,测一次性生成质量,对模型领域、库及常见策略模板初始知识敏感。
智能多轮设置:每次失败后模型获含错误类型和系统消息的结构化反馈,最多可修改重试10次,测模型迭代纠错、局部搜索和利用诊断信息的能力,类似评估机制已在代码和软件工程基准测试中被证明有用。
结果
单轮
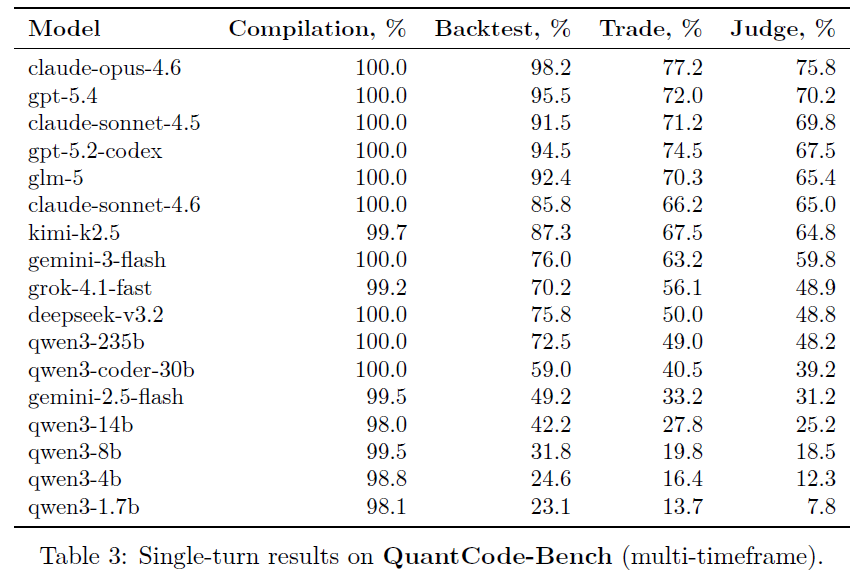
表3展示QuantCode - Bench单轮结果,呈现出基准测试的核心模式:前沿模型在编译阶段普遍表现强,但在评估流程后期差异大。单轮结果显示流程前后阶段差异明显,多数强模型编译不再是瓶颈,高编译率不意味着高评判通过率,表明现代前沿模型的主要质量损失在回测和交易阶段。
多轮
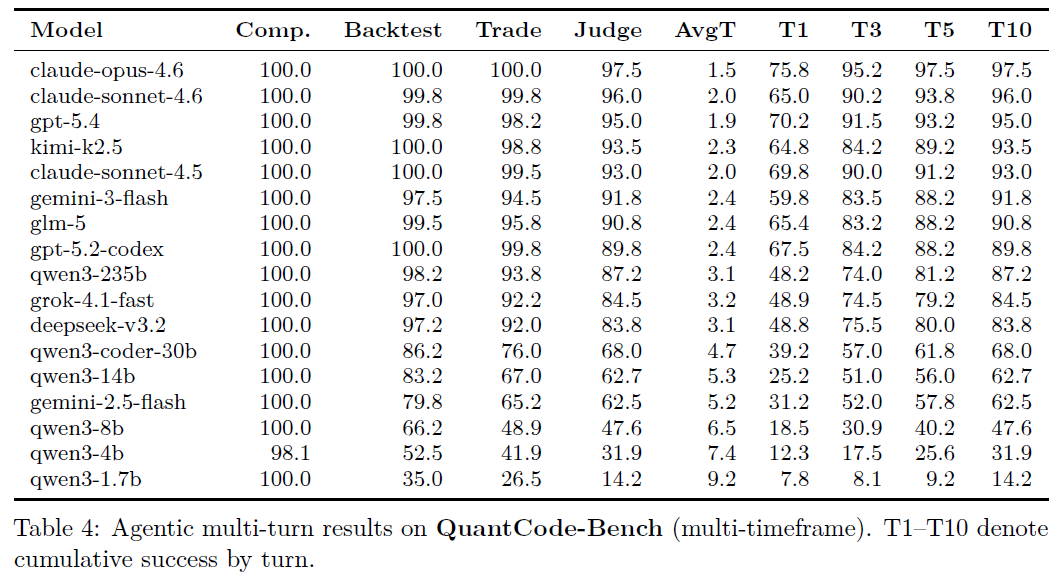
表4结果显示,模型主要差异不在句法正确性,而在执行、交易信号生成和语义合规层面。迭代反馈对强模型特别有效,其大量错误可在少量尝试内局部修复。
错误分析
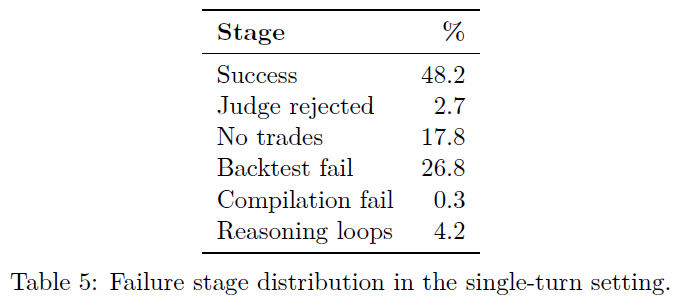
故障阶段分布(单轮)
表5按生成失败的第一阶段汇总单轮结果,显示了整体流程中难点集中处。现代模型编译不再是主要问题,主要失败点在回测和无交易等后期阶段,表明交易策略生成核心难点已从Python语法转为策略在特定执行环境中的正确实施。
回测错误和后期失败的分类
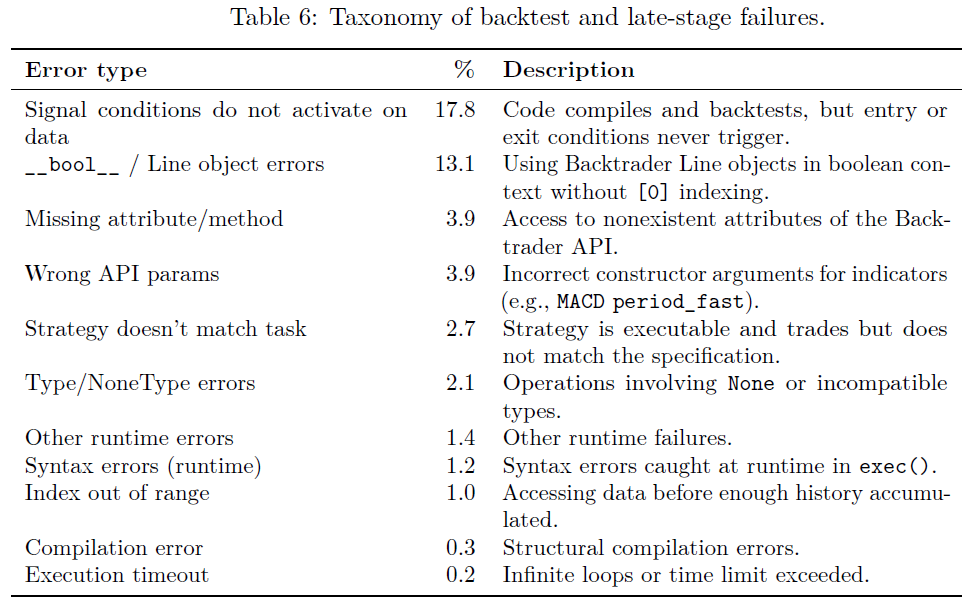
表6对运行时和后期失败进行细粒度分类,揭示Backtest、No trades和late - judge失败类别内的主导模式。最常见失败类型是策略编译和回测通过但无交易,原因多为入场条件过严、特征计算历史上下文不足或指标逻辑操作有误。次常见为__bool__ / Line对象错误,反映布尔条件下对Backtrader行对象处理不当。缺失属性/方法错误占比小,表明直接API幻觉不如逻辑激活和行对象处理失败普遍。
智能体设置错误
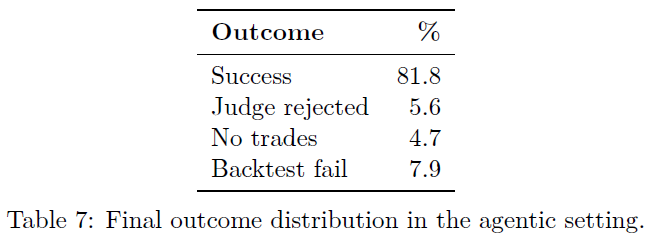
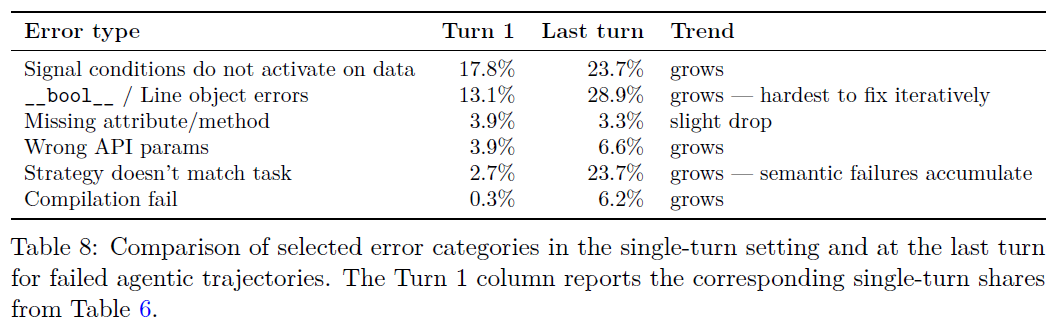
表格7和8总结了智能体设置中的最终结果分布,对比单轮错误类别与失败智能体轨迹最后一轮构成。与单轮情况相比,最后一轮未解决失败的构成向反映持续语义和逻辑问题的类别偏移,部分错误占比增大,“Missing attribute/method”仍较少。10次尝试后未解决的策略中,“Judge rejection”成主要失败原因。迭代调试主要对修复技术错误有效,对模型误解任务效果欠佳,智能体设置主要解决程序修复问题,未完全消除自然语言规范语义解释的局限。
讨论
算法交易策略生成涉及编程、金融逻辑和智能搜索,QuantCodeBench显示强大模型掌握部分问题但仍有局限。
现代大语言模型基本解决表层语法生成问题,主要挑战转向操作形式化,影响后续代码生成评估基准。
单轮与智能交互设置对比表明,大量错误属局部可修复类型,模型实用性取决于单轮准确性和迭代代码修复能力。
自然语言到代码或策略的基准测试中,难度不仅取决于概念深度,规范质量也很重要。
通用模型和代码专用模型对比,编程专业化不保证在特定领域策略生成上更优,通用模型语义和指令跟随能力强时表现更好。
裁判环节很重要,无语义验证会高估成功率,开放任务需语义验证作为主要评估程序。
限制
QuantCode - Bench虽覆盖重要实用任务,但当前版本有局限:
策略仅在Backtrader框架和环境评估,限制结果向其他算法交易库和环境的可迁移性,可扩展至QuantConnect/LEAN和Zipline,多框架评估可区分模型策略合成能力与API适配能力。
最终语义评估依赖LLM法官,虽强于纯技术验证,但无法保证语义绝对正确,法官可能忽略细微不匹配,且存在LLM评判的常见偏差。
未评估生成策略的盈利能力、风险稳健性和经济质量,工作重点是模型从描述生成可执行策略的能力,而非策略投资质量。
总结
本文提出 QuantCode - Bench,用于评估大语言模型生成可执行算法交易策略的能力,将任务形式化为嵌套要求,可评估代码质量和模型将自然语言交易想法转化为有效实现的能力。
结果显示,前沿模型在单次生成中远未完全解决任务,最大单次 Judge Pass 约为四分之三。而有迭代反馈的智能体设置能显著提升,最佳模型可达 95 - 98%,表明大量错误可修复,交互式调试循环中的模型行为至少和单次生成准确性同样重要。
交易策略生成需掌握专业 API、构建可执行代码、制定现实交易逻辑并遵循自然语言规范语义。现代模型在语法和基础层面表现良好,但在单次准确形式化交易意图和精确实现策略上有局限。
QuantCode - Bench 可用于特定领域代码生成、智能体软件修复及金融领域大语言模型评估的未来研究。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
