谷歌发布 Vision Banana|轻松击败SAM 3,同时视觉范式要变天了
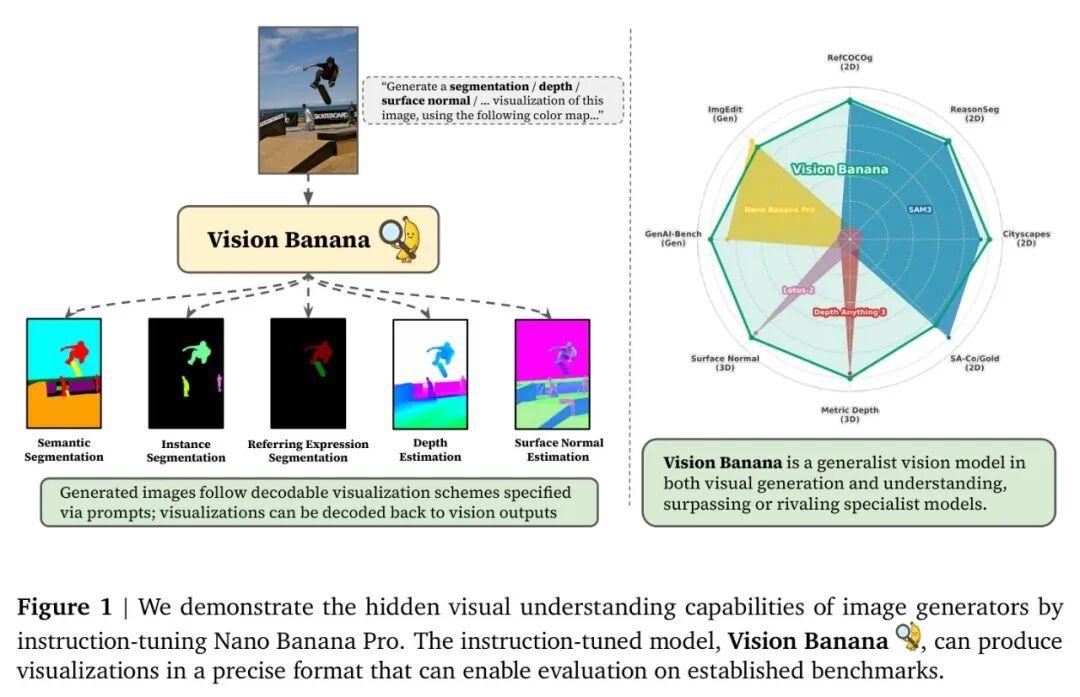
你是不是还在为视觉AI项目里,十几个专用模型来回切换而头疼?SAM负责分割,Depth Anything负责深度,Lotus-2负责法线…部署复杂,数据流混乱。告诉你一个颠覆性的发现:一个训练用来“画图”的图像生成模型,通过简单的指令微调,竟然能在所有这些专业视觉理解任务上,达到甚至超越SOTA(最先进)水平!
一个模型,既能生成图像,又能分割目标、估算深度和法线,还能理解自然语言指令。这不是科幻,而是刚刚提出的Vision Banana模型带来的现实。它向我们揭示了一个可能改变计算机视觉研究范式的核心事实:图像生成模型,本身就是强大的通才型视觉学习者。
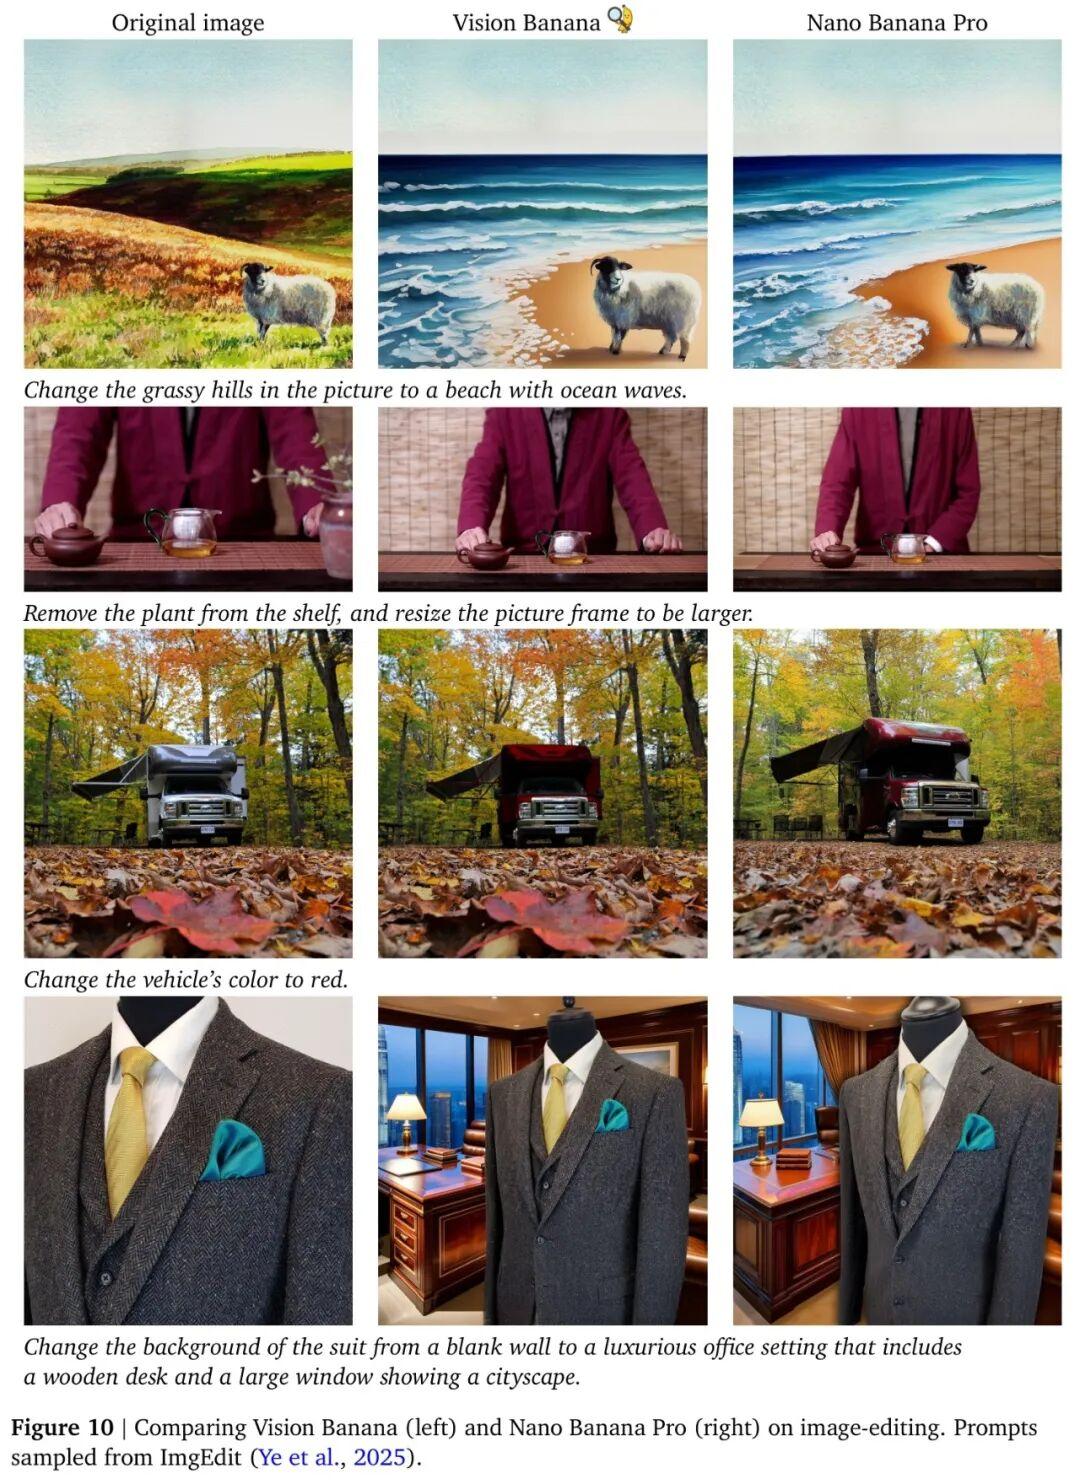
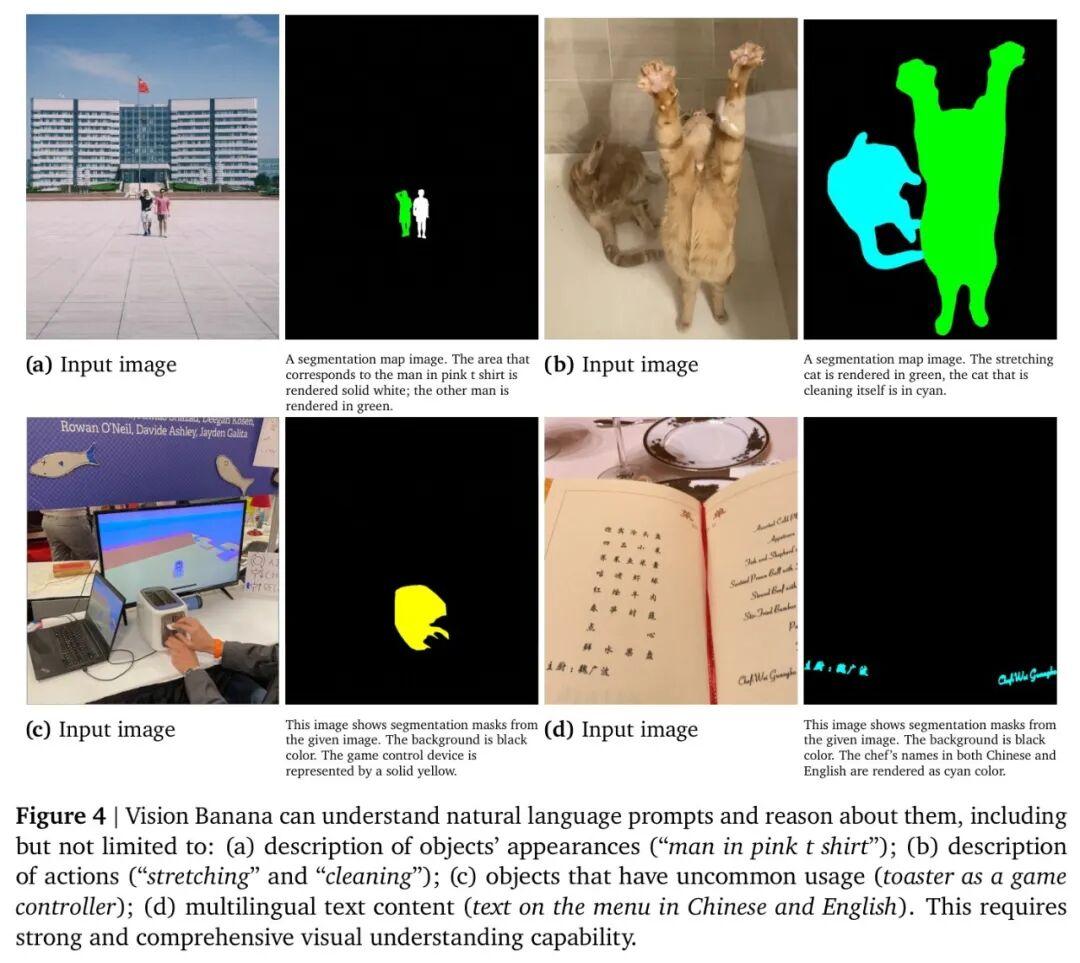
让我们先通过一张图,直观感受一下Vision Banana的通用能力。它接受一张图像和一条自然语言指令,就能输出多种格式化的视觉理解结果。
❓ 核心痛点:为什么我们需要“通才”模型?
在视觉AI的黄金时代,我们却陷入了一种“模型爆炸”的困境。
自动驾驶系统需要语义分割模型识别道路,深度估计模型判断距离,实例分割模型区分车辆,可能还需要一个单独的模型来理解“左前方那辆蓝色卡车”这样的自然语言指令。每个任务都需要一个精心设计和训练的专业模型,导致:
- 部署成本高昂:维护多个模型框架、推理引擎和优化策略。
- 数据流割裂:不同模型的输出格式不一,难以进行统一的后处理和决策融合。
- 泛化能力有限:专用模型通常在特定数据集上表现优异,但面对新场景、新概念时,零样本迁移能力往往不足。
这背后是一个根本性的问题:我们训练模型的方式,是否割裂了视觉世界的内在统一性?人类理解一张图片,是同时感知其语义、几何和空间关系的。有没有一种方法,能让AI模型也以这种统一、连贯的方式学习视觉?
大语言模型(LLM)的成功给了我们启示:通过海量无监督的“生成下一个词”训练,模型不仅学会了流畅写作,更“涌现”出了强大的语言理解、逻辑推理和代码生成能力。那么,在视觉领域,通过“生成下一帧像素”的训练,模型是否也能“涌现”出对视觉世界的深刻理解?
Vision Banana的研究团队给出了肯定的答案。他们发现,图像生成训练本身就是一种强大的“通才视觉预训练”。一个足够强大的图像生成器(如Nano Banana Pro),其内部已经学习了关于物体形状、纹理、三维结构、空间关系的丰富先验知识。我们所缺的,只是一把“钥匙”,来解锁这些知识,并将其引导到具体的视觉任务输出上。
这把钥匙,就是 “指令微调”。
💡 核心方法:将视觉理解“翻译”成图像生成
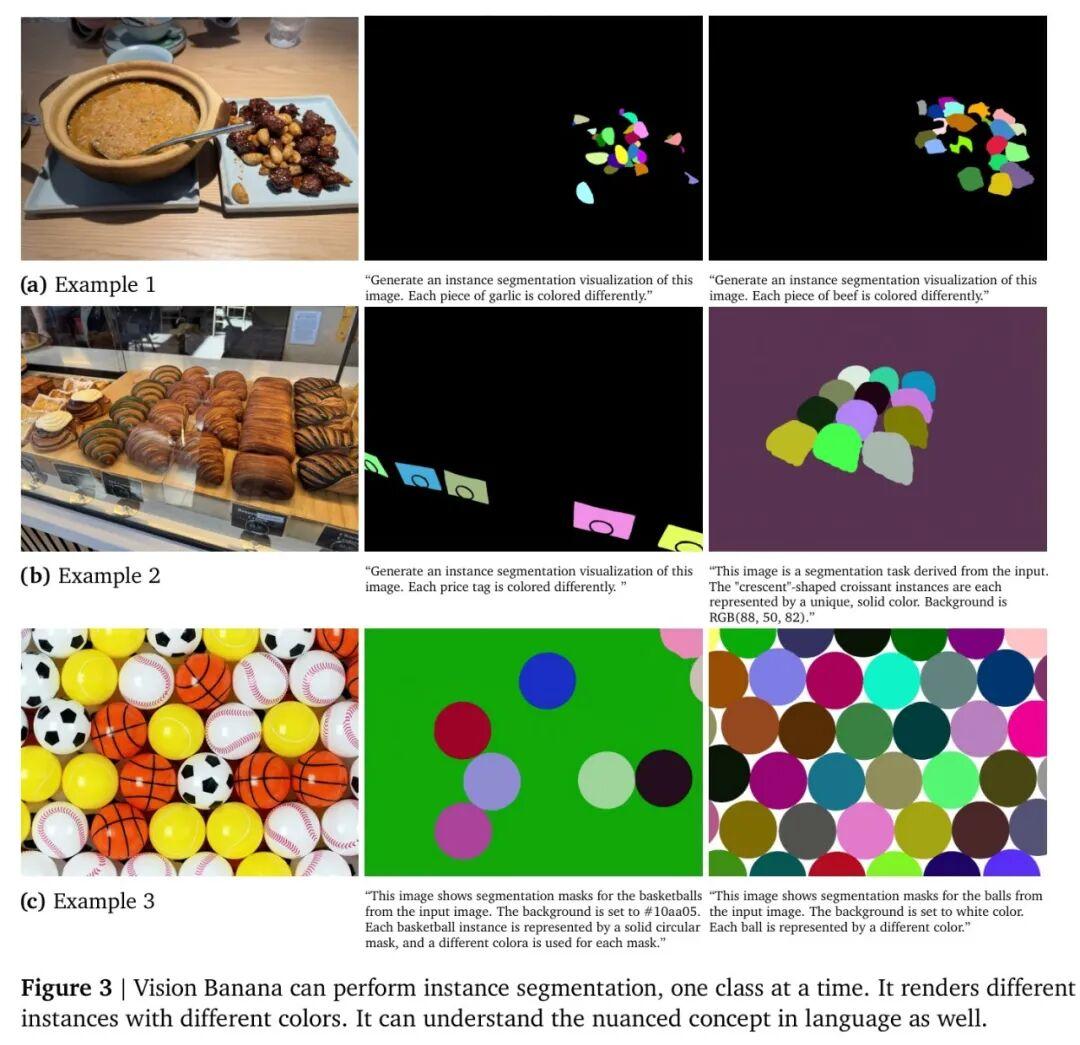
Vision Banana的核心思想极其优雅,也极具颠覆性:将所有视觉理解任务的输出,都重新表述为一张RGB图像。
想想看,语义分割图是一张彩色掩码图,深度估计图是一张伪彩色热力图,表面法线图也可以映射到RGB空间。既然基础模型(Nano Banana Pro)最擅长生成RGB图像,那么我们就用自然语言指令,告诉它生成一张“符合特定格式”的图片。
这个过程就像让一个画家根据详细描述作画:
- • 任务:“请画一张分割图,用红色表示猫,用粉色表示锁,用浅紫色表示出口标志,背景是黄色。”
- • 模型:生成一张RGB图片,其中特定像素的颜色严格对应指令中的描述。
- • 解码:我们收到图片后,只需根据颜色映射关系,将像素归类,就得到了分割结果。
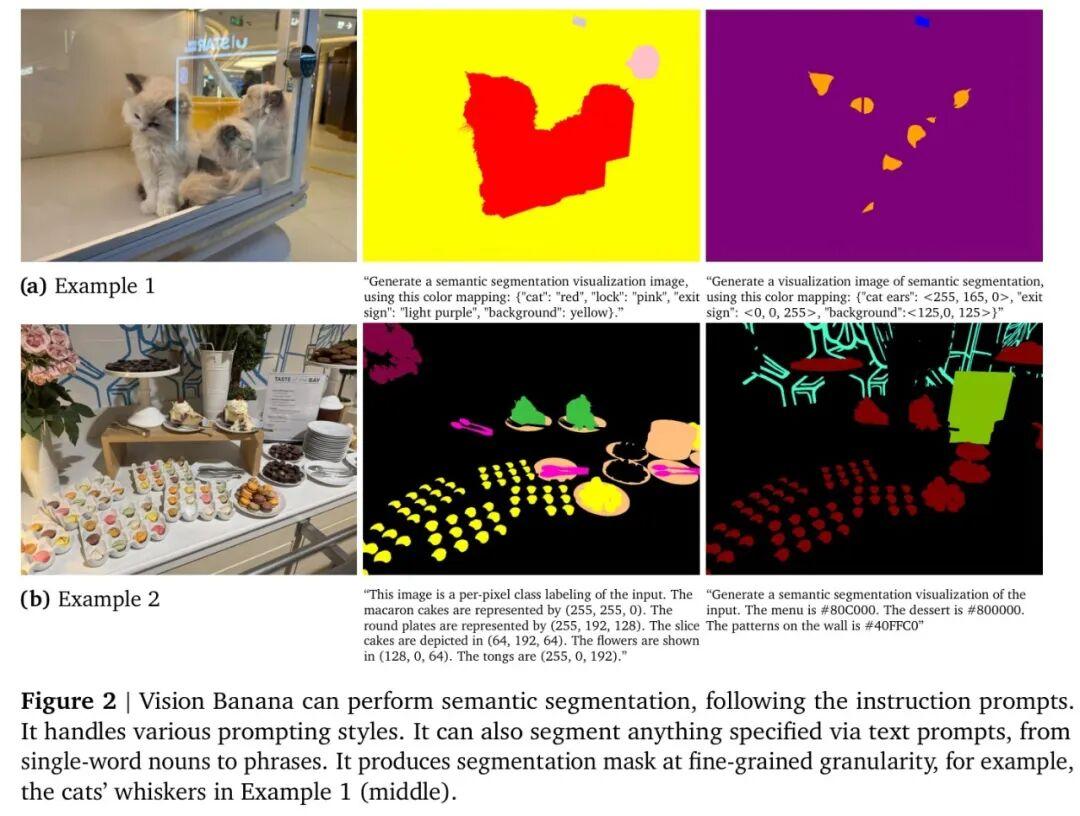
这种方法有三大优势:
- 统一接口:所有任务,无论2D还是3D,都通过“生成RGB图”这一种方式解决,模型架构和权重完全共享。
- 数据高效:指令微调只需要很少量的任务数据,核心是教模型“如何格式化输出”,而不是“如何理解任务”。真正的理解能力,已经在海量图像生成预训练中具备了。
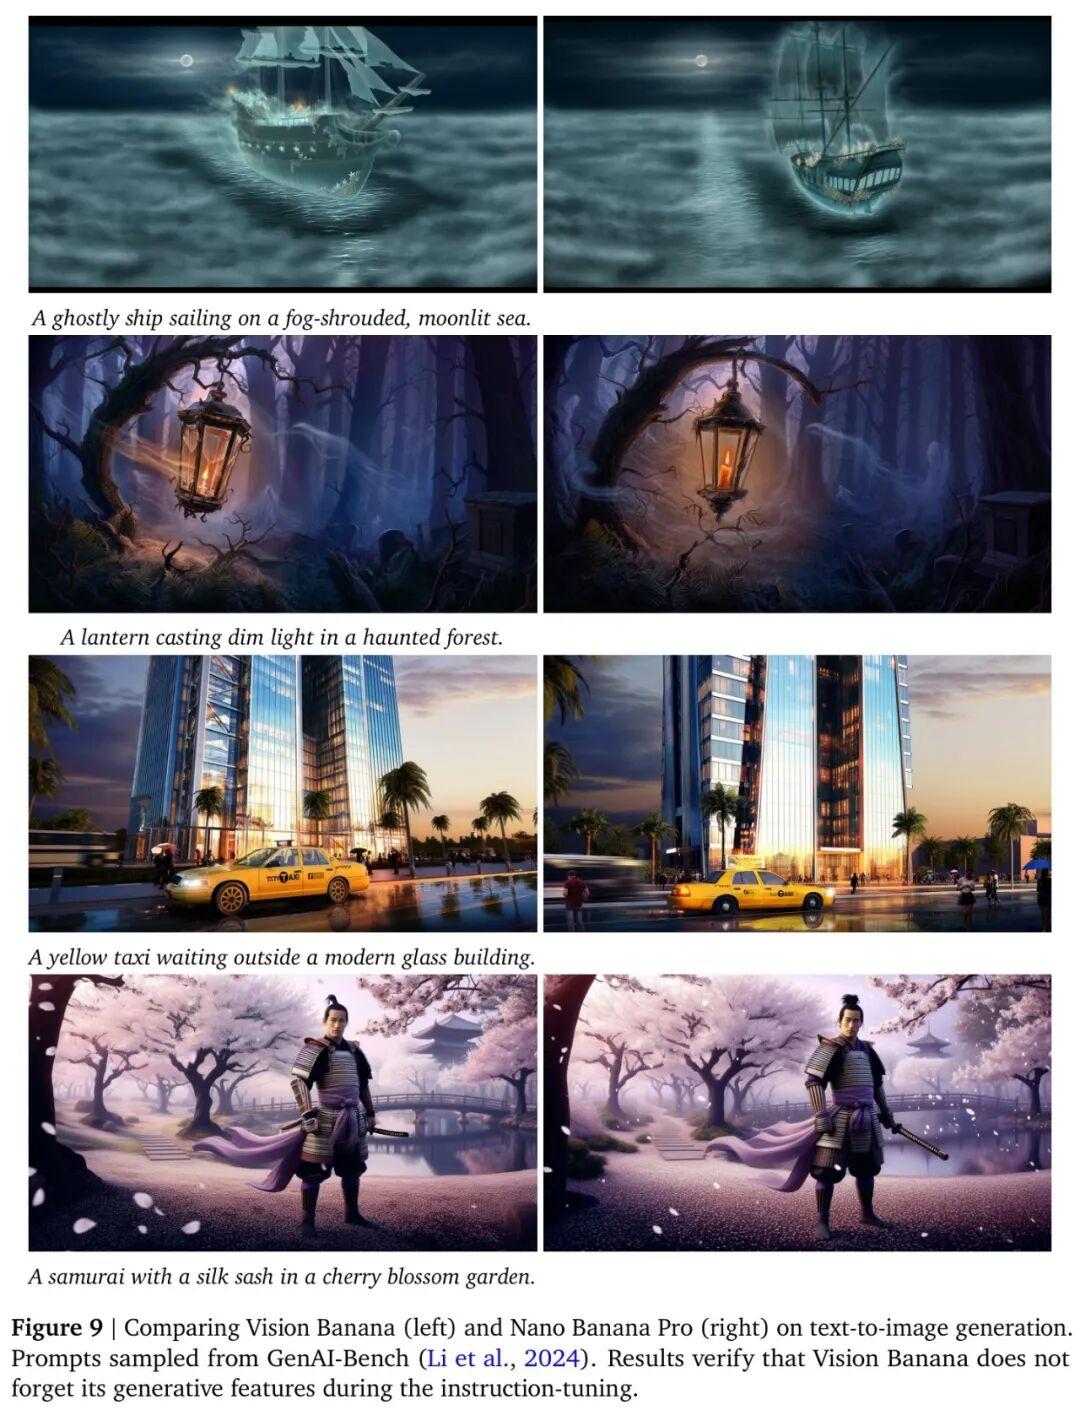
- 能力保持:轻量级的指令微调不会破坏模型原有的图像生成能力,使其真正成为一个“生成与理解”的统一体。
🏗️ 技术显微镜:如何让深度和法线“可视化”?
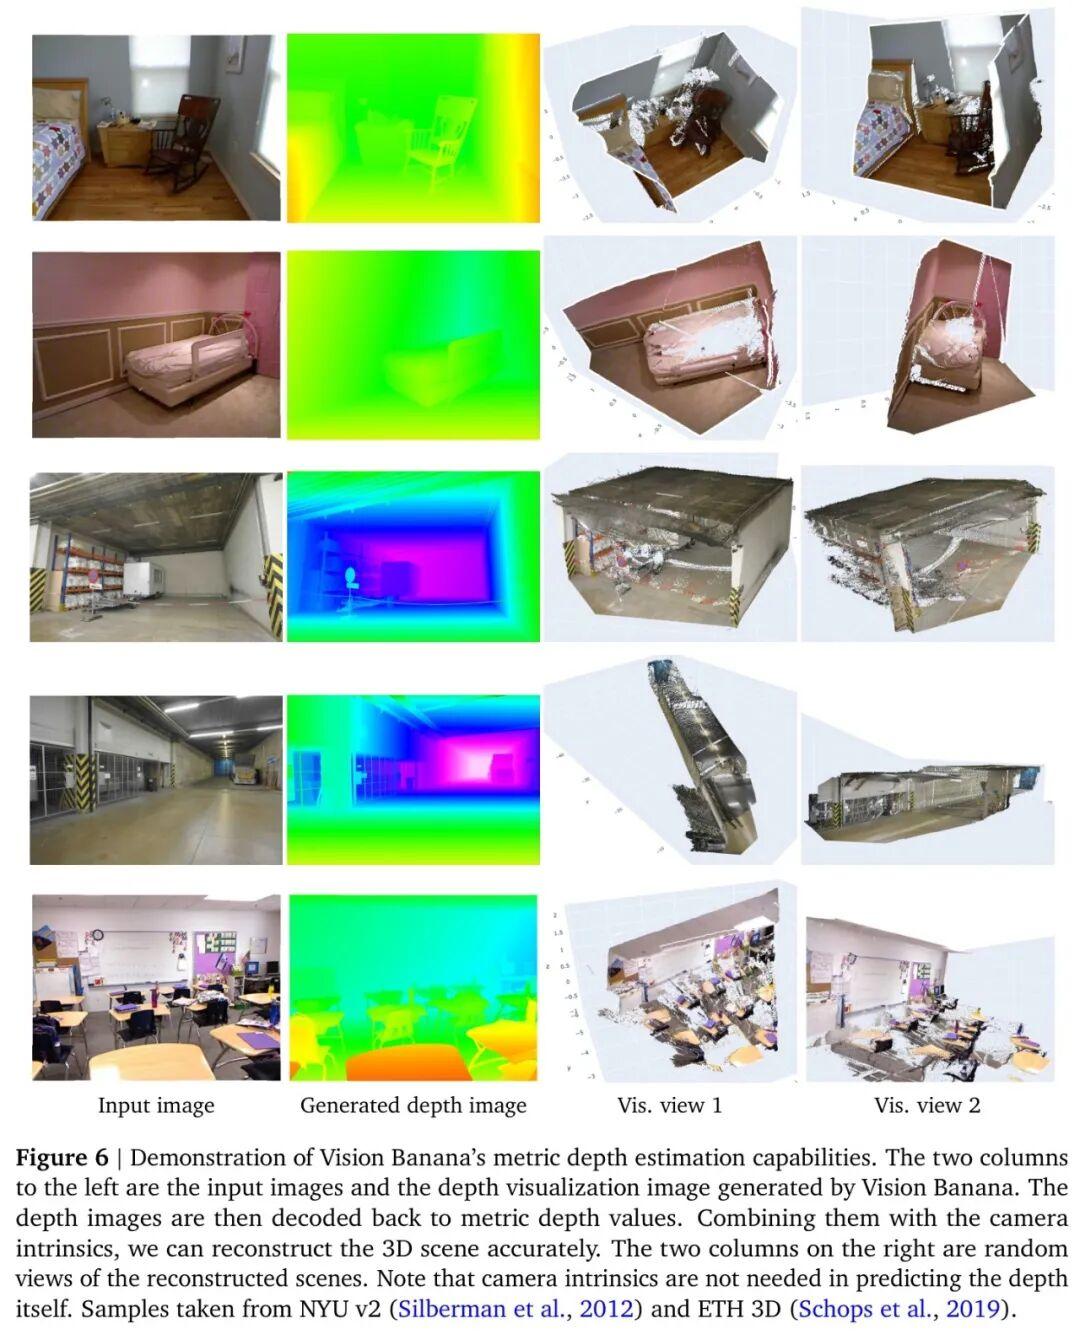
将分割输出可视化为彩色图相对直观,但如何将连续的、物理意义的深度值,或者三维的法线向量,“塞进”一张8位RGB图像里,并且还能无损地解码回来用于定量评估?这是工程上的精妙之处。
💡 度量深度编码:从无限到有限的优雅映射
深度估计的目标是给每个像素预测一个物理距离值 。直接线性映射到 [0, 255] 会丢失远处细节的精度,而机器人、AR等应用更关注近处物体的精确距离。
研究团队采用了一种可逆的幂变换,将无界的深度值“弯曲”到一个有界范围内,同时保留近处的精度。具体公式如下:
这里, 是形状参数(设为 -3), 是尺度参数。这个函数 将深度 映射到 [0, 1) 区间。之后,再将这个归一化的值,通过一个分段线性的色彩映射函数(类似3D Hilbert曲线的一次迭代)转换为RGB值。
关键在于“可逆”:从生成的RGB图像中,我们可以精确地反向这个过程,解码出原始的度量深度值。这使得我们可以在NYU Depth V2、KITTI等标准深度估计数据集上进行定量评估。
💡 表面法线编码:与RGB空间的天然契合
表面法线是单位向量 ,每个分量在 [-1, 1] 之间。一个非常自然的想法是直接映射到RGB:
- • (左右方向) → R通道
- • (上下方向) → G通道
- • (前后方向) → B通道
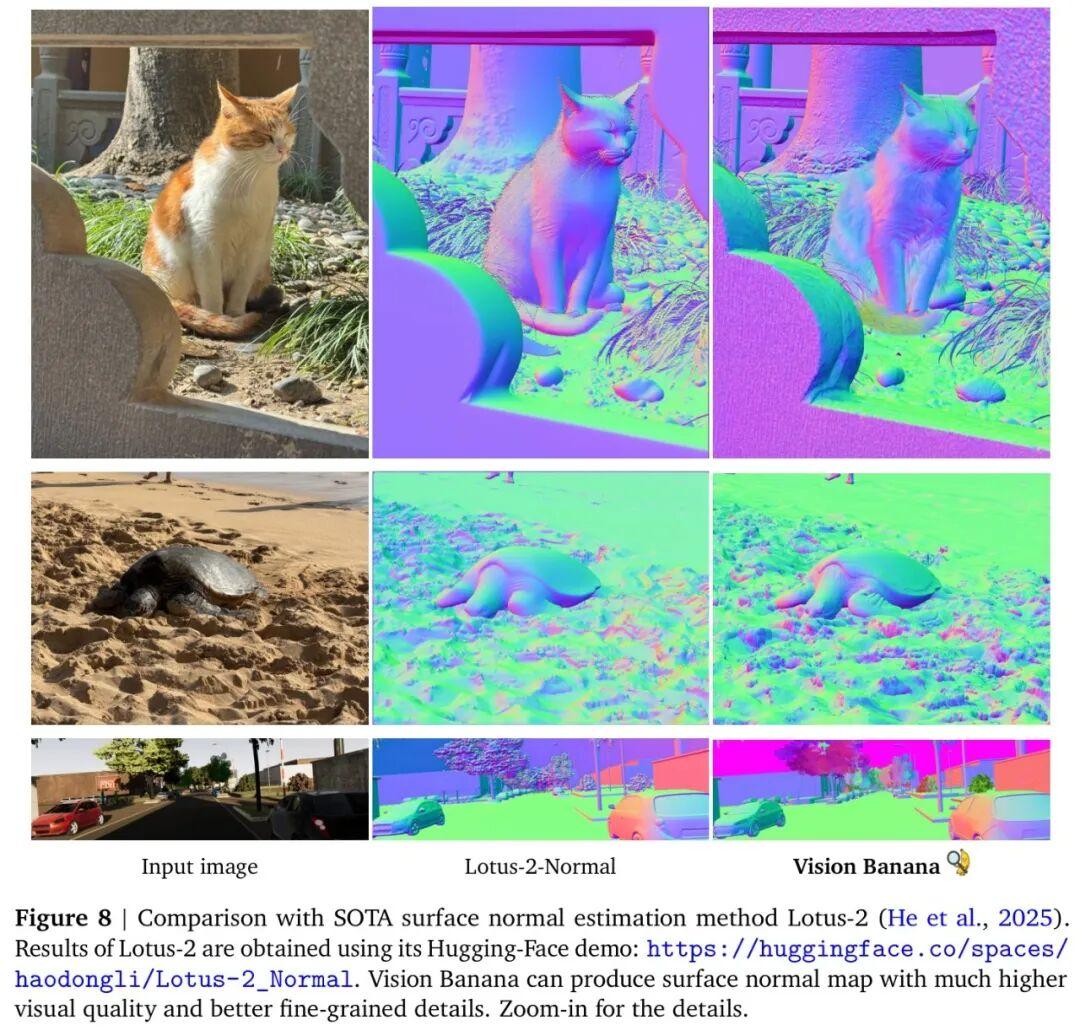
这样,面向相机的平面(法线≈(0,0,1))会呈现蓝色/紫色,朝上的平面(法线≈(0,1,0))呈现绿色,朝左的平面呈现红色。这种表示直观且无需复杂变换,模型可以直接学习并生成高质量的法线图。
🏆 实验验证:数据不说谎,通才模型真能打!
理论再优美,也需要数据支撑。Vision Banana在多个权威基准测试上,与当前各领域最强的专用模型进行了正面较量。
📊 2D理解:分割任务全面开花
团队在多个分割数据集上测试,包括语义分割(Cityscapes)、实例分割(SA-Co/Gold)、指代表达分割(RefCOCOg, ReasonSeg)。关键是,Vision Banana采用零样本迁移评估,即从未在这些数据集的训练集上训练过。
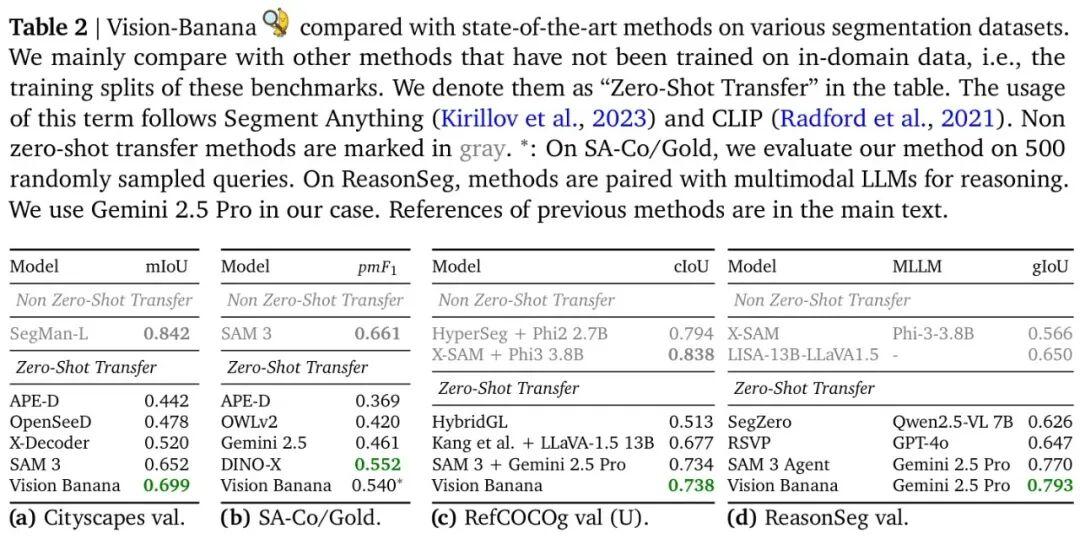
结果令人震惊:
- • 语义分割:在Cityscapes上,mIoU达到 80.1%,超越了专业分割模型SAM 3的75.4%。
- • 指代表达分割:在需要复杂语言理解的ReasonSeg数据集上,gIoU达到 0.793,创造了新的零样本SOTA。
📊 3D理解:几何估计超越专家
在更具挑战性的3D几何理解任务上,Vision Banana同样表现强悍。
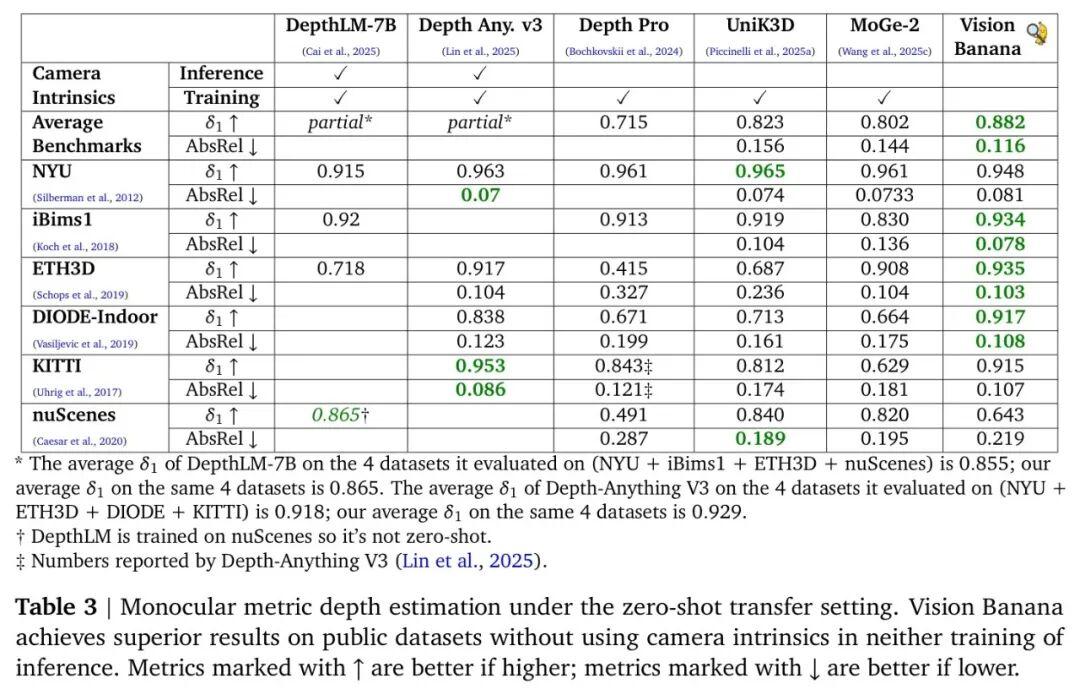
- • 度量深度估计:在NYU、KITTI等6个数据集上,其综合性能(平均δ₁指标)全面超越了当前的深度估计专家模型 Depth Anything V3。
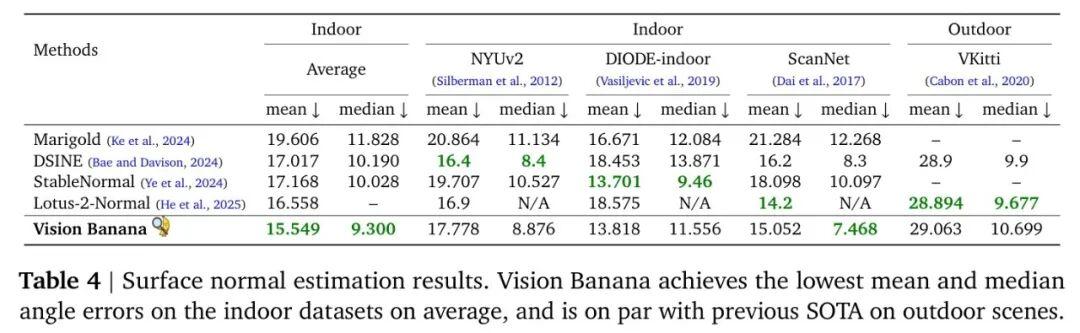
- • 表面法线估计:在室内数据集(NYUv2, ScanNet)上,其角度误差显著低于 Lotus-2 等SOTA方法。
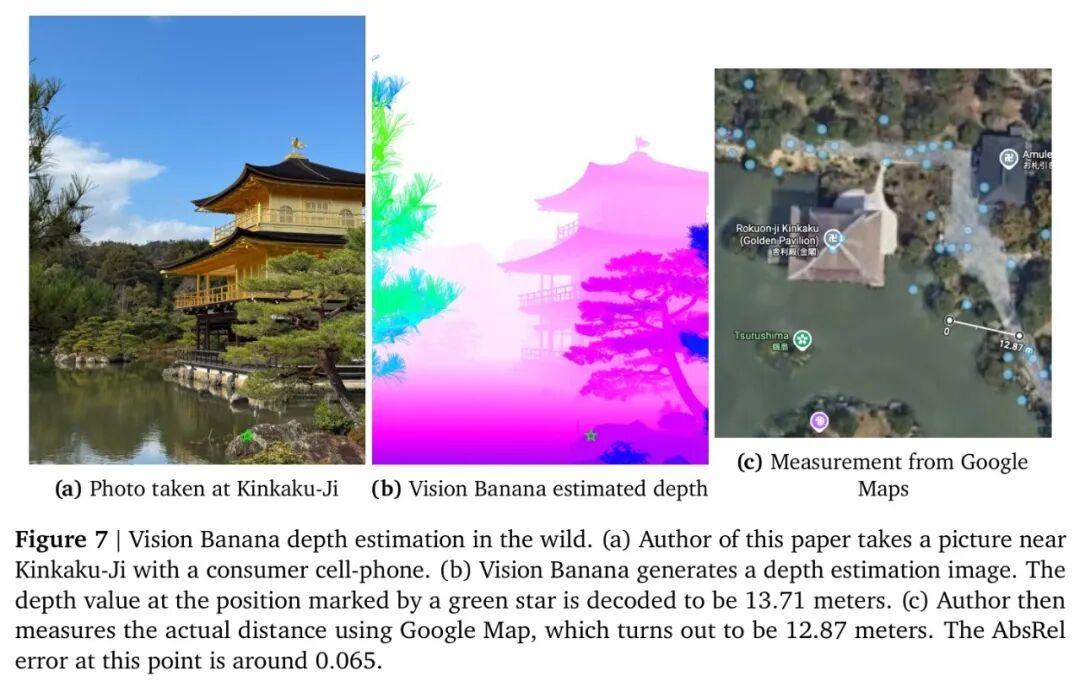
更有说服力的是野外真实场景测试。研究团队用手机拍摄了一张日本金阁寺的照片,用Vision Banana估计深度,并用Google Maps测量实际距离进行对比。
⚖️ 客观评价与未来展望
当然,任何新技术都有其局限性。Vision Banana目前的主要挑战在于计算开销。运行一个大型图像生成模型进行推理,其成本远高于运行一个轻量级的专用判别模型。这对于实时性要求高的应用(如自动驾驶)是一个需要攻克的问题。
然而,其代表的方向无疑是激动人心的:
- 范式验证:它强有力地证明了“生成式视觉预训练”是一条通往通用视觉AI的有效路径,类似于LLM的成功。
- 统一接口:“图像生成”有望成为视觉任务的通用接口,极大简化多模态模型的设计和训练流程。
- 涌现潜力:随着模型规模和数据量的进一步扩大,很可能像LLM一样,激发出更多未知的涌现能力。
未来的工作充满想象:扩展到视频理解、结合LLM进行复杂推理、开发高效的推理加速方案……我们可能正站在“视觉基础模型”爆发的前夜。
🌟 价值升华
读完本文,你应该记住三个核心收获:
- 图像生成器是隐秘的通才:为“画图”而训练的大模型,其内部已经学习了丰富的视觉表征,是未被充分挖掘的视觉理解宝库。
- 指令微调是万能钥匙:通过轻量的指令微调,将任务输出格式化为图像,就能解锁模型的多种理解能力,且不损害其生成能力。
- 统一接口是未来趋势:“生成一张符合要求的图”可能成为解决各类视觉任务的统一范式,简化AI系统架构。
这项研究不仅仅是一个新模型,更是一次对计算机视觉研究范式的深刻叩问。它告诉我们,有时候,通往“理解”的最佳路径,恰恰是学会“创造”。
🤔 深度思考:你认为“生成式视觉预训练”会成为未来视觉AI的主导范式吗?它最可能率先在哪个应用场景(如内容创作、机器人、AR/VR)产生颠覆性影响?欢迎在评论区留下你的观点!
💝 支持原创:如果这篇硬核解读让你对AI视觉的未来有了新认识,点赞+在看就是最好的支持!分享给你身边的技术伙伴,一起探讨!
🔔 关注提醒:设为星标,第一时间获取最前沿、最深度的AI技术解读!
#AI技术 #深度学习 #计算机视觉 #生成式AI #多模态 #论文解读 #模型架构
参考
Image Generators are Generalist Vision Learners