DeepSeek-V4深度解析:百万Token上下文的高效推理架构
- [1. 概述]
- [1.1 DeepSeek-V4 系列模型]
- [1.2 核心创新点]
- [1.3 性能概览]
- [2. 核心架构]
- [2.1 继承自 V3 的设计]
- [2.2 流形约束超连接(mHC)]
- [2.3 混合注意力机制:CSA 与 HCA]
- [2.4 Muon 优化器]
- [3. 通用基础设施]
- [3.1 专家并行与通信计算重叠]
- [3.2 FP4 量化感知训练]
- [3.3 推理框架与 KV 缓存]
- [4. 预训练]
- [4.1 数据构建]
- [4.2 预训练配置与基座模型表现]
- [5. 后训练]
- [5.1 专家训练与推理模式]
- [5.2 在线策略蒸馏(OPD)]
- [5.3 思考模式与工具调用]
- [6. 评估结果]
- [6.1 知识与推理]
- [6.2 代码与智能体]
- [6.3 长上下文]
- [6.4 实际任务表现]
- [7. 效率分析]
- [7.1 推理 FLOPs 与 KV 缓存对比]
- [7.2 效率提升的技术归因]
- [8. API 使用指南]
- [8.1 思考模式 API 调用]
- [8.2 工具调用集成]
- [9. 总结与展望]
- [参考文献]
DeepSeek-V4 是 DeepSeek 于 2026 年 4 月发布的预览版本大语言模型系列,包含两个基于 Mixture-of-Experts(MoE)架构的模型:DeepSeek-V4-Pro(1.6T 总参数,49B 激活参数)和 DeepSeek-V4-Flash(284B 总参数,13B 激活参数)。两者均原生支持 100 万 Token 上下文长度,标志着大语言模型正式迈入百万级上下文时代。
1.1 DeepSeek-V4 系列模型
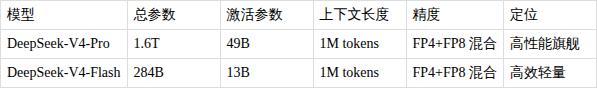
两个模型均采用 MIT 开源许可证,在 HuggingFace 和 ModelScope 平台同步发布。
1.2 核心创新点
- 混合注意力架构:结合压缩稀疏注意力(CSA)和重度压缩注意力(HCA),在 1M Token 场景下,V4-Pro 仅需 V3.2 的 27% 推理 FLOPs 和 10% KV 缓存
- 流形约束超连接(mHC):将残差映射矩阵约束在双随机矩阵流形上,增强深层信号传播的数值稳定性
- Muon 优化器:采用混合 Newton-Schulz 迭代的正交化优化器,实现更快收敛和更高训练稳定性
- 在线策略蒸馏(OPD):两阶段后训练范式,先独立培养领域专家,再通过多教师蒸馏统一合并
- FP4 量化感知训练:路由专家参数使用 FP4 精度,进一步降低存储和计算开销
1.3 性能概览
DeepSeek-V4-Pro-Max(最大推理模式)在多项基准测试中表现突出:
- 在 SimpleQA-Verified 上达到 57.9% Pass@1,超越 Opus-4.6(46.2%)和 GPT-5.4(45.3%)
- 在 Apex Shortlist 基准上达到 90.2%,超越 Opus-4.6(85.9%)和 GLM-5.1(72.4%)
- 在 Codeforces Rating 上达到 3206,接近 GPT-5.4 的 3168 水平
- 在 Putnam-2025 形式推理中达到 120/120 满分
- 在内部研发编码基准中,Pass Rate 达到 67%,超越 Claude Sonnet 4.5(47%),接近 Opus 4.5(70%)
DeepSeek-V4 保留了 Transformer 架构和多 Token 预测(MTP)模块,同时引入了三项关键升级:mHC 增强、混合注意力架构、Muon 优化器。整体架构如下图所示:
Input Tokens → Embedding → [CSA/HCA Attention] → DeepSeekMoE → Prediction Head + MTP Modules↑ ↑残差连接(mHC增强)共享专家+ 路由专家
2.1 继承自 V3 的设计
MoE 架构:V4 延续 DeepSeekMoE 范式,采用细粒度路由专家和共享专家。相比 V3 的变化:
- 激活函数从
Sigmoid(·)改为Sqrt(Softplus(·))计算亲和度分数 - 移除路由目标节点数量限制,重新设计并行策略以保持训练效率
- 前几层 dense FFN 替换为 Hash 路由 MoE,根据输入 Token ID 的预定义哈希函数确定目标专家
- 采用无辅助损失的负载均衡策略,辅以轻度序列级平衡损失
多 Token 预测(MTP):MTP 模块配置与 V3 保持一致,通过同时预测多个未来 Token 提升训练效率和推理质量。
2.2 流形约束超连接(mHC)
传统残差连接在深层网络中容易出现信号退化。Hyper-Connections(HC)通过可学习的残差映射矩阵解耦残差宽度与隐藏层维度,但多层堆叠时频繁出现数值不稳定。
mHC 的核心创新是将残差映射矩阵 B_l 约束到双随机矩阵流形(Birkhoff 多面体):
M = {M ∈ R^{n×n} | M·1_n = 1_n, 1_n^T·M = 1_n^T, M ≥ 0}这一约束确保:
- 映射矩阵的谱范数
||B_l||_2 ≤ 1,残差变换是非扩张的 - 流形 M 在矩阵乘法下封闭,深层堆叠 mHC 时稳定性有数学保证
- 输入/输出变换通过 Sigmoid 约束为非负有界,避免信号相消
动态参数化:mHC 的三个线性映射参数被分解为动态(依赖输入)和静态(不依赖输入)两部分:
# Simplified mHC dynamic parameterizationdef mhc_params(X_l, W_pre, W_res, W_post, S_pre, S_res, S_post, alpha_pre, alpha_res, alpha_post):X_hat = RMSNorm(flatten(X_l))A_l=alpha_pre*(X_hat@W_pre)+S_pre # Input transformB_l = alpha_res * reshape(X_hat @ W_res) + S_res # Residual mapping (doubly stochastic)C_l = alpha_post * (X_hat @ W_post).T + S_post # Output transformreturn A_l, B_l, C_l
2.3 混合注意力机制:CSA 与 HCA
当上下文长度达到百万级时,标准注意力机制的计算复杂度(O(n²))成为主要瓶颈。V4 设计了两种高效注意力机制并混合使用:
压缩稀疏注意力(CSA)
CSA 的工作流程:
Token 级压缩:将每
m个 KV 条目压缩为一个条目,序列长度缩短至1/m
- 对每个压缩块,计算两个分支的压缩权重(前向和后向重叠窗口)
- 使用加权 Hadamard 积聚合信息
Lightning Indexer 稀疏选择:对压缩后的 KV 条目执行 DeepSeek Sparse Attention(DSA),每个 Query Token 仅关注 top-k 个压缩块
- 采用低秩方式生成 indexer queries
- 使用 ReLU 加权点积计算索引分数
Shared KV Multi-Query Attention:压缩 KV 条目同时作为 key 和 value,使用 MQA 方式执行核心注意力
滑动窗口补充:保留最近 n_win 个未压缩 KV 条目,与压缩 KV 条目拼接,增强局部依赖建模
Attention Sink:引入可学习 sink logits 防止注意力分数过度集中
重度压缩注意力(HCA)
HCA 比 CSA 执行更激进的压缩(m' >> m),将每 m' 个 KV 条目合并为一个。HCA 的结构更简单:
- 仅使用单分支压缩权重
- 同样采用 Shared KV MQA + Grouped Output Projection
- 搭配滑动窗口保留局部信息
混合架构与效率
CSA 和 HCA 交替排列在 Transformer 层中。部分层使用 CSA(保留更多细节),部分层使用 HCA(极致压缩),实现精度与效率的平衡。两者的共同特征包括:
- 部分 RoPE:对注意力的最后 64 维应用旋转位置编码
- 分组输出投影:将大量注意力头输出分组投影,降低计算量
- Token 级压缩器:所有压缩操作在 Token 粒度进行,无需文档级边界信息
2.4 Muon 优化器
V4 采用 Muon 作为主要优化器(Embedding、Prediction Head、RMSNorm 等模块仍使用 AdamW)。Muon 的核心步骤如下:
Algorithm: Muon for DeepSeek-V4Input: Learning rate η, momentum μ, weight decay λ, rescaling factor γFor each training step t:1.G_t=∇_WL_t(W_{t-1}) # Compute gradients2.M_t=μ·M_{t-1}+G_t # Momentum accumulation3. O'_t = HybridNewtonSchulz(μ·M_t + G_t) # Nesterov + orthogonalization4.O_t=O'_t·√(max(n,m)·γ) # Rescale update RMS5.W_t=W_{t-1}·(1-ηλ)-η·O_t # Weight decay + update
V4 使用混合 Newton-Schulz 迭代进行正交化:对矩阵 M 的 SVD 分解 M = UΣV^T,迭代逼近 UV^T,近似正交化梯度更新矩阵。这比标准 Newton-Schulz 迭代在保持正交性的同时更高效。
3.1 专家并行与通信计算重叠
MoE 模型通过 Expert Parallelism(EP)加速,但 EP 的跨节点通信(Dispatch/Combine All-to-All)是主要瓶颈。V4 提出细粒度 EP 方案,将通信和计算融合为统一的流水线内核:
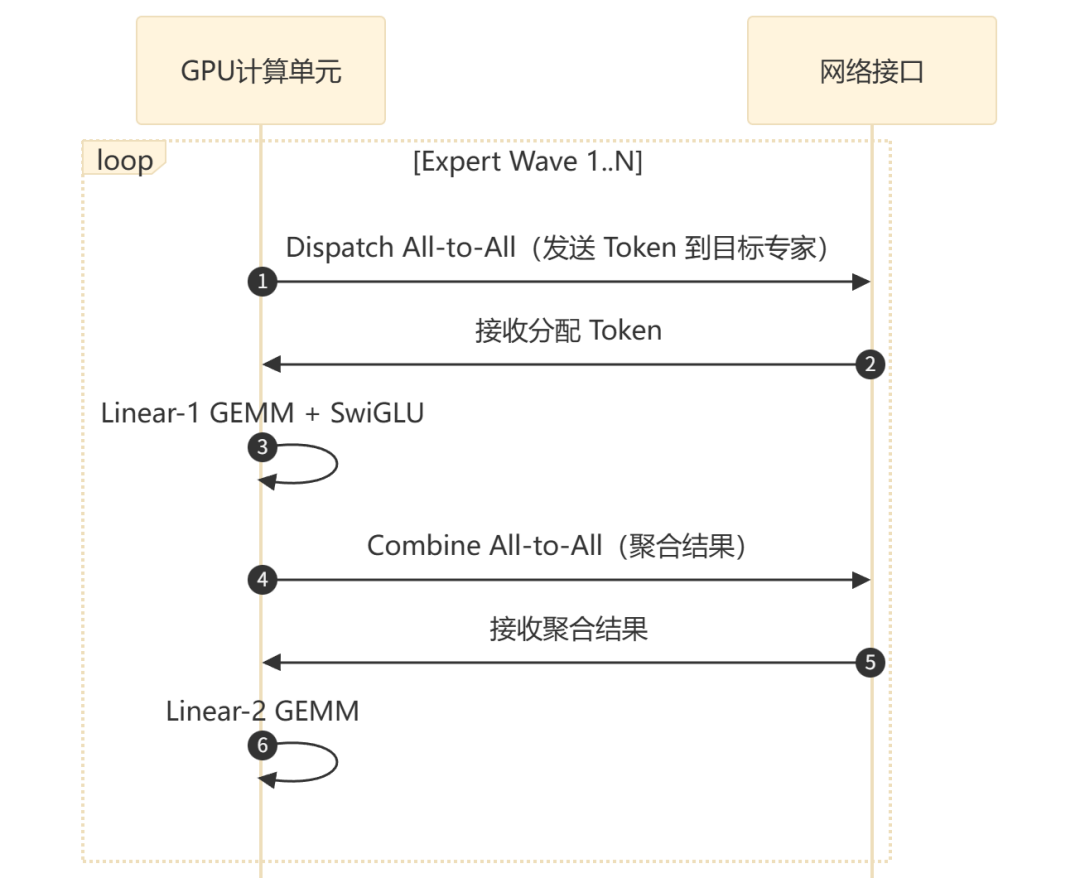
关键洞察:在单个 MoE 层中,通信总时间低于计算时间,因此将通信隐藏在计算之下。该方案在 NVIDIA GPU 和华为 Ascend NPU 上均验证有效,通用推理负载加速 1.50-1.73 倍,RL rollout 场景最高加速 1.96 倍。
此外,V4 还开源了 CUDA 内核实现 MegaMoE(DeepGEMM 组件),并开源了基于 TileLang 的灵活高效内核开发框架。
3.2 FP4 量化感知训练
V4 的路由专家参数使用 FP4(MXFP4)精度,其余参数使用 FP8。这一设计的关键点:
- 训练阶段:FP4 权重在反向传播时通过无损 FP4→FP8 反量化步骤模拟,复用现有 FP8 混合精度框架,无需修改反向管线
- 推理阶段:直接使用原生 FP4 权重,减少内存带宽和采样延迟
- 未来优化:当前硬件上 FP4×FP8 操作峰值算力与 FP8×FP8 相同,但理论上可提升 1/3 效率,未来硬件将进一步提升
模型总参数精度分布:BF16(2.8B)、F8_E8M0(49.2B)、F8_E4M3(23.2B)、I8(786.4B),总计约 862B 参数。
3.3 推理框架与 KV 缓存
V4 的推理框架针对百万级上下文进行了深度优化:
- 分层 KV 缓存结构:根据 Token 距离和压缩级别,将 KV 缓存分为热/温/冷层级
- 磁盘 KV 缓存存储:超出 GPU 显存容量的 KV 缓存自动卸载到 SSD,通过 3FS 文件系统实现高效读写
- 上下文并行:将超长序列的注意力计算分布到多个设备,支持百万 Token 的 RL rollout
4.1 数据构建
V4 在预训练阶段使用了超过 32 万亿(32T) 多样化高质量 Token:
- DeepSeek-V4-Flash 训练 32T tokens
- DeepSeek-V4-Pro 训练 33T tokens
4.2 预训练配置与基座模型表现
两个模型在预训练后即可原生高效支持 1M 上下文长度。基座模型评估中:
- V4-Flash-Base 在大多数基准上已超越 V3.2-Base
- V4-Pro-Base 在推理、编码、长上下文和世界知识任务上全面超越前代,成为 DeepSeek 系列最强基座模型
训练框架方面,V4 实现了 Muon 的高效实现、mHC 的成本优化内存方案、长上下文注意力的上下文并行,以及灵活激活检查点的扩展自动微分。
5.1 专家训练与推理模式
V4 的后训练采用两阶段范式,第一阶段为领域专家独立训练:
每个领域专家通过 SFT + RL(GRPO 算法)顺序优化。V4 引入了三种推理模式:
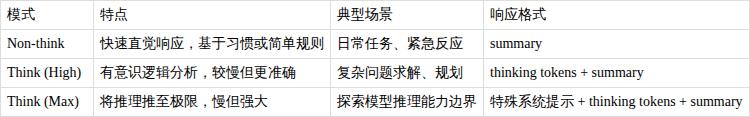
Think Max 模式通过注入特殊系统提示激发深度推理:
Reasoning Effort: Absolute maximum with no shortcuts permitted.You MUST be very thorough in your thinking and comprehensively decomposethe problem to resolve the root cause, rigorously stress-testing your logicagainst all potential paths, edge cases, and adversarial scenarios.
5.2 在线策略蒸馏(OPD)
第二阶段使用**多教师在线策略蒸馏(OPD)**将所有领域专家的能力合并到最终模型中。OPD 的目标函数:
L_OPD(θ) = Σ_i w_i · D_KL(π_θ || π_{E_i})其中 π_{E_i} 是第 i 个领域专家,w_i 是权重。关键设计:
- 从学生模型
π_θ采样训练轨迹(on-policy) - 学生根据当前任务上下文选择性地从对应专家学习
- 支持 10+ 个万亿参数级教师模型
- 使用集中式磁盘调度器按需加载教师权重
5.3 思考模式与工具调用
V4 引入了新的工具调用 Schema,使用 <|DSML|tool_calls> 标签和结构化参数格式。思考模式与工具调用的交互流程:
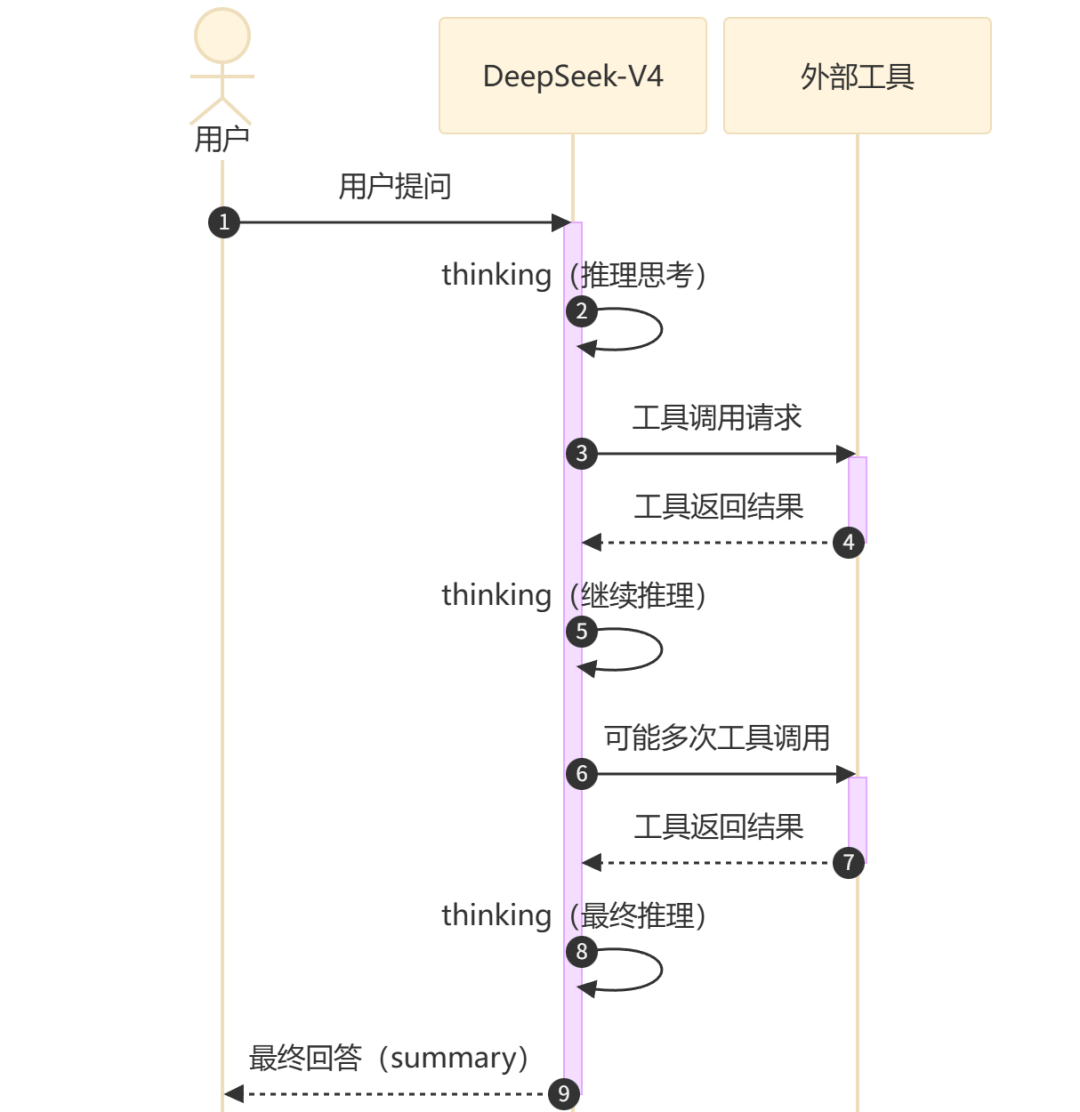
与 V3.2 的关键区别:V4 在工具调用场景下完整保留所有轮次的推理内容(reasoning_content),而非每轮丢弃。此外,V4 还引入了 Quick Instruction 机制,通过在输入序列末尾添加专用特殊 Token(如 <|action|>、<|query|>、<|domain|>),复用已有 KV 缓存并行执行辅助任务(搜索判断、意图识别等),显著降低 TTFT。
6.1 知识与推理
V4-Pro-Max 在知识密集型任务上取得重大突破:
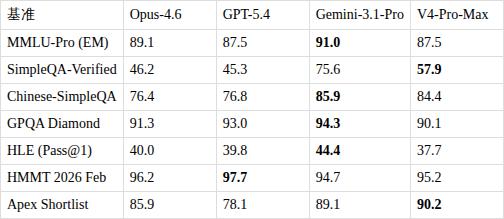
在形式推理方面,V4 在 Putnam-2025 混合形式-非形式推理中达到 120/120 满分,与 Axiom 并列第一。在数学竞赛 Codeforces 上,V4-Pro-Max 达到 3206 Rating。
6.2 代码与智能体
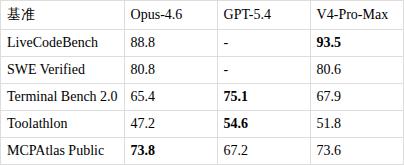
在内部研发编码基准中,V4-Pro-Max 的 Pass Rate 为 67%,超越 Sonnet 4.5(47%),接近 Opus 4.5(70%)。85 名 DeepSeek 开发者调查显示,52% 认为 V4-Pro 可作为主力编码模型,39% 倾向肯定。
6.3 长上下文
在百万 Token 上下文的 MRCR 基准上:
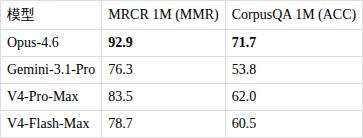
V4-Pro 在 MRCR 任务上超越 Gemini-3.1-Pro,但仍落后于 Claude Opus 4.6。
6.4 实际任务表现
DeepSeek 在实际任务中进行了内部评估:
- 中文写作:V4-Pro 在功能写作上与 Gemini-3.1-Pro 持平,在创意写作上略有优势
- 搜索增强:Agentic Search 相比 RAG 在复杂任务上显著提升,且成本高效
- 白领任务:与 Opus-4.6-Max 对比,V4-Pro-Max 在内容质量上更优(主动提供补充见解和自验证),但在指令遵循和格式美观上有改进空间
- 编码智能体:在真实 R&D 任务中表现接近 Opus 4.5
7.1 推理 FLOPs 与 KV 缓存对比
在 1M Token 上下文场景下,V4 相比 V3.2 的效率提升:
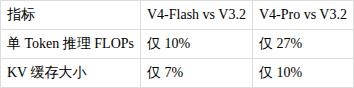
这意味着 V4-Flash 在百万上下文中仅需 V3.2 十分之一的计算量和不到十分之一的 KV 缓存,使百万 Token 上下文的日常服务成为现实。
7.2 效率提升的技术归因
效率提升来自多方面协同优化:
- KV 压缩:CSA 将 KV 序列压缩
1/m倍,HCA 压缩1/m'倍(m' >> m),大幅减少 KV 缓存和注意力计算量 - 稀疏选择:每个 Query 仅关注 top-k 个压缩 KV 块,将注意力复杂度从 O(n²) 降至近似 O(n)
- FP4 精度:路由专家参数使用 FP4,减少内存占用和带宽需求
- Shared KV MQA:压缩 KV 条目同时作为 key 和 value,降低参数量和计算量
- 分组输出投影:将大量注意力头分组投影,控制输出投影的计算开销
8.1 思考模式 API 调用
DeepSeek V4 支持通过 OpenAI SDK 调用思考模式:
from openai import OpenAIclient = OpenAI(api_key="<DeepSeek API Key>",base_url="https://api.deepseek.com")response = client.chat.completions.create(model="deepseek-v4-pro",messages=[{"role": "user", "content": "9.11 and 9.8, which is greater?"}],reasoning_effort="high", # "high" or "max"extra_body={"thinking": {"type": "enabled"}},)# Access reasoning and final answerreasoning = response.choices[0].message.reasoning_contentanswer = response.choices[0].message.content
流式调用方式:
response = client.chat.completions.create(model="deepseek-v4-pro",messages=[{"role": "user", "content": "Solve this problem"}],stream=True,reasoning_effort="max",extra_body={"thinking": {"type": "enabled"}},)reasoning_content = ""content = ""for chunk in response:if chunk.choices[0].delta.reasoning_content:reasoning_content += chunk.choices[0].delta.reasoning_contentelse:content += chunk.choices[0].delta.content
注意事项:
- 思考模式不支持
temperature、top_p、presence_penalty、frequency_penalty参数 - 默认
reasoning_effort为high,复杂 Agent 类请求自动设为max low/medium映射为high,xhigh映射为max
8.2 工具调用集成
思考模式支持工具调用,需注意 reasoning_content 的正确处理:
import jsonfrom openai import OpenAIclient = OpenAI()tools = [{"type": "function","function": {"name": "get_weather","description": "Get weather for a location","parameters": {"type":"object","properties": {"location":{"type":"string"},"date":{"type":"string"},},"required":["location","date"]},}},]messages = [{"role": "user", "content": "Weather in Shanghai tomorrow?"}]while True:response = client.chat.completions.create(model="deepseek-v4-pro",messages=messages,tools=tools,reasoning_effort="high",extra_body={"thinking": {"type": "enabled"}},)# CRITICAL: append full message including reasoning_contentmessages.append(response.choices[0].message)tool_calls = response.choices[0].message.tool_callsif tool_calls is None:break # Final answer receivedfor tool in tool_calls:result = call_tool(tool.function.name, json.loads(tool.function.arguments))messages.append({"role": "tool","tool_call_id": tool.id,"content": str(result),})print(response.choices[0].message.content)
关键规则:
- 有工具调用的轮次,必须在后续请求中回传完整
reasoning_content,否则 API 返回 400 错误 - 无工具调用的轮次,
reasoning_content会被忽略,无需回传 - 可直接使用
messages.append(response.choices[0].message)简化操作
DeepSeek-V4 通过架构层面的系统性创新,在保持模型能力的同时实现了百万级上下文的工程可行性:
- 混合注意力架构(CSA+HCA) 是实现百万上下文的核心,将推理 FLOPs 降至 V3.2 的 27%(Pro)/10%(Flash),KV 缓存降至 10%/7%
- mHC 解决了深层 Transformer 的信号退化问题,使深层堆叠在数学上有稳定性保证
- Muon 优化器 加速训练收敛,OPD 实现多领域专家能力的高效合并
- V4-Pro-Max 在多项基准上达到开源最佳,部分任务超越闭源模型
- V4-Flash 以更小的参数规模在推理任务上接近 Pro 水平,是极具性价比的选择
DeepSeek 表示未来将探索更稀疏的 Embedding 模块、低延迟架构、长周期多轮智能体任务、多模态能力扩展,以及更好的数据策划和合成策略。
[1] DeepSeek-V4 Technical Report: https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro/blob/main/DeepSeek_V4.pdf
[2] DeepSeek-V4 HuggingFace Collection: https://huggingface.co/collections/deepseek-ai/deepseek-v4
[3] DeepSeek-V4 ModelScope Collection: https://modelscope.cn/collections/deepseek-ai/DeepSeek-V4
[4] DeepSeek API Docs - Thinking Mode: https://api-docs.deepseek.com/zh-cn/guides/thinking_mode