全网首发|DeepSeek V4 硬核实测:代码、Agent、推理全通关,开源模型天花板
4 月 24 日上午,DeepSeek V4 发布后,官方给出的信号其实已经非常明确。DeepSeek 官网首页对 V4 的定义是:“世界顶级推理性能,Agent 能力大幅提高”,而且已经同时上线网页端、App 和 API。DeepSeek-V4-Pro 是一个 1.6T 总参数、49B 激活参数 的 MoE 模型,DeepSeek-V4-Flash 是 284B 总参数、13B 激活参数,二者都支持 1M context。官方还披露了几项核心技术路径:Hybrid Attention、mHC 注意力压缩、Muon 优化器,以及 超过 32T token 的训练规模。
这些技术让Pro和Flash模型能在原生支持百万级Token上下文时,推理计算量和KV缓存占用相比前代降低一个数量级,同时凭借包含领域专家培育与策略蒸馏的后训练流程,在推理、知识和智能体任务上追平甚至部分超越顶尖闭源模型,从而为高效、实用的下一代长上下文智能奠定了关键基础。
据官方介绍,相比前代模型,DeepSeek-V4-Pro 的 Agent 能力显著增强。在 Agentic Coding 评测中,V4-Pro 已达到当前开源模型最佳水平,并在其他 Agent 相关评测中同样表现优异。目前 DeepSeek-V4 已成为公司内部员工使用的 Agentic Coding 模型,据评测反馈使用体验优于 Sonnet 4.5,交付质量接近 Opus 4.6 非思考模式,但仍与 Opus 4.6 思考模式存在一定差距。DeepSeek-V4-Pro 在世界知识测评中,大幅领先其他开源模型,仅稍逊于顶尖闭源模型 Gemini-Pro-3.1。在数学、STEM、竞赛型代码的测评中,DeepSeek-V4-Pro 超越当前所有已公开评测的开源模型,取得了比肩世界顶级闭源模型的优异成绩。
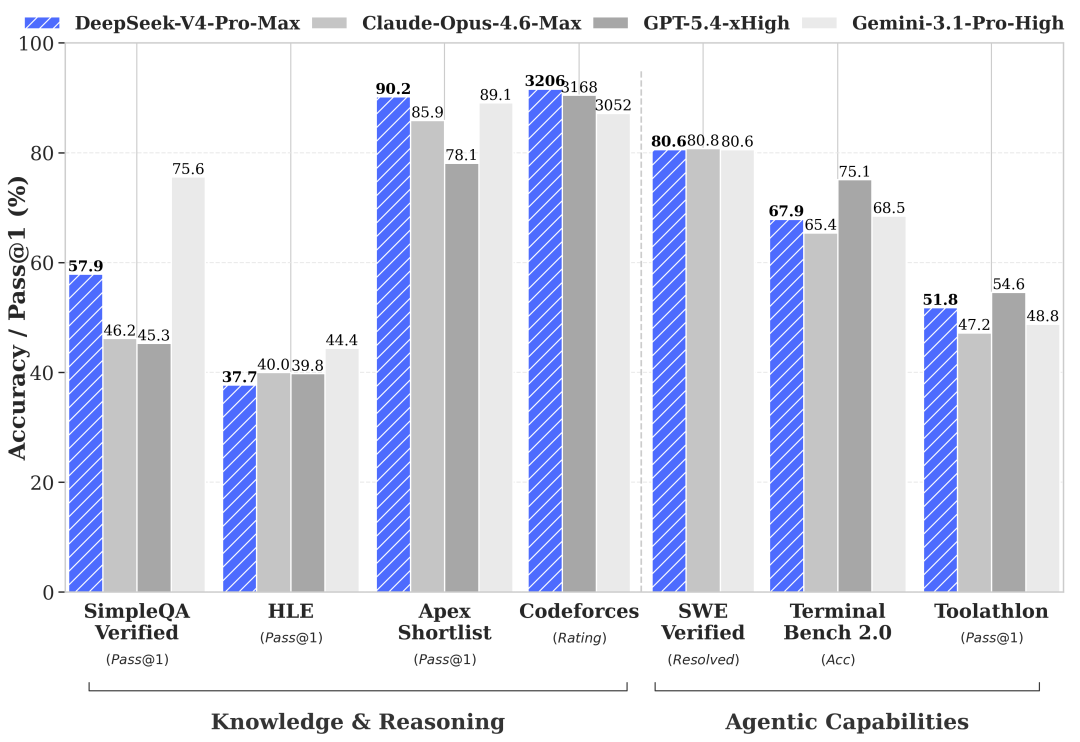
如果只看纸面材料,这一代想打的方向其实已经写在脸上了。它不是冲着“聊天更像人”去的,而是冲着 reasoning、coding 和 agent 三件事去的。
但真正重要的问题不在榜单上,而在落地上。因此我选了几个最现实的场景进行测试,包括:
- 能不能直接生成可运行代码
- 能不能修已有项目里的 bug
- 能不能接进 Claude Code 这种 agent 工作流
- 写长文时是“有内容”还是“有腔调没信息”
- 逻辑推理到底是真强,还是只会拉长思维链
基于这些问题,我在API模式下(没有记忆和联网功能)做了一轮完整实测。先说结论:
DeepSeek V4 Pro 已经到了生产可用的程度。它不是一个只会在榜单上好看的模型,而是已经可以在代码、bugfix、推理、中文写作上打出稳定结果。
一、先看官方给了什么:技术路线和榜单位置
如果把这次 V4 的官方信息压缩成一句话,我会写成:
DeepSeek 这次不是在继续做一个更强的聊天模型,而是在把模型往“推理器 + 编码器 + Agent 底座”三个方向同时推。
为什么这么说?
因为从官方模型卡和首页文案看,V4 这次最值得注意的,不是“参数更大”这件事本身,而是它在结构和任务目标上都更明确了。
先看结构。
V4-Pro 的 1.6T / 49B 这个组合,本质上还是 DeepSeek 一贯偏爱的 MoE 路线,但这次更值得注意的是它引入的几项技术细节:Hybrid Attention、mHC 注意力压缩,以及 Muon 优化器。它们共同指向的是同一件事:在更长上下文、更复杂推理和更强 agent 任务下,把计算效率和稳定性继续往前推。再叠加 1M context 和超过 32T token 的训练规模,这一代模型显然不是为了“顺着上一代小改一下”而来的。
再看榜单。官方给出的 V4-Pro-Max 成绩里,这几项测试得分都不低:LiveCodeBench、Codeforces、Terminal-Bench、SWE-Bench Verified、GPQA Diamond。代表了模型在代码,终端以及推理问题上能力的优势。
二、代码能力:我先没聊感觉,先直接上题
第一道题是一个从零生成的小模块。我给它的 prompt 很直接:
编写一个名为 `async_ttl_cache.py` 的 Python 模块。

要求:
- 导出一个名为 `async_ttl_cache` 的装饰器,参数为 `ttl_seconds: float`。
- 该装饰器只需支持异步函数。
- 在给定的 TTL 时间内缓存成功的结果。
- 对相同位置参数/关键字参数的并发进行中调用去重。
- 异常一律不得缓存。
- 被装饰的函数必须暴露一个 `cache_clear()` 方法。
- 只使用 Python 标准库。
测试的难点在于同时卡了几件事:异步函数、TTL 失效、并发去重、异常路径,还有接口设计。
DeepSeek V4 Pro 回来的结果,核心长这样:
cache: Dict[Hashable, Tuple[Any, float]] = {}
pending: Dict[Hashable, asyncio.Future[Any]] = {}

if key in cache:
    result, expiry = cache[key]
    if now < expiry:
        return result

if key in pending:
    return await pending[key]
也就是说,它没有向其他模型偷懒那样(g*说的就是你)只写一个“能缓存就行”的简化版,而是真的把缓存和 in-flight request dedup 都做进去了。
最后跑测试的结果也很直接:
4 passed in 0.36s
接口返回延迟是 12.299s,总 token 是 524。
整体来看:它不是在“会写 demo”的水平,而是在“能把工具函数一次交出来”的水平。
三、再看 bugfix:这比从零写代码更接近真实开发
第二道题测试的内容是bugfix,最消耗程序员发量的事情。
我给它的不是一张白纸,而是一个已经写坏了的 markdown_table.py,再加一组现成测试。目标很简单:别改 API,只把 bug 修掉。
测试题里最关键的 case 是这两个:
| alpha | `a|b` | 10 |
| beta | x \| y | 12 |
也就是说,这个解析器原来会在两种地方翻车:
- code span 里的
| - 转义过的
\|
原始实现的问题也很典型,基本就是一句:
return [cell.strip() for cell in stripped.split("|")]
这种代码平时看着没问题,一上边界条件就露馅。很像真实项目里那种“平时都能跑,线上某个怪输入突然炸了”的 bug。
DeepSeek V4 Pro 给回来的修复版,关键逻辑是这样:
elif ch == "\\" and i + 1 < len(stripped) and stripped[i + 1] == "|":
    current.append("|")
    i += 1
elif ch == "|" and not in_backtick:
    cells.append("".join(current).strip())
它没有去大改接口,也没有耍花活,而是很老实地把 bug 根因抓住了:不能见到竖线就切,至少得识别 escaped pipe 和 backtick 区间。
最后测试结果:
2 passed in 0.00s
接口延迟 12.06s,总 token 1092。
这轮我反而比前面那道更看好它。因为从零写东西,很多模型都会;但能在已有文件、已有测试、已有约束下把补丁补对,这才更像真实研发。
之前ds一直存在tool call的问题,导致agent 能力受限。这次 DeepSeek 官方提供了 claude code等code agent的配置方式(https://api-docs.deepseek.com/guides/coding_agents)
所以我把ds配置进claude code, 把同一个 bugfix 任务在claude code中进行修复。
结果同样很顺利:
2 passed in 0.00s
换句话说,DeepSeek V4 Pro 不只是能裸调 API 写代码,它已经能作为 Claude Code 的底层模型,把一个真实 patch 干出来。
四、写作能力:我也给了题,不是让它随便发挥
写作这块,我也没让它自由发挥。我给的是一个很具体的约束题:
写一篇 1000-1200 字中文评论,标题是《AI coding agents 正在把软件工程切成哪三层》。

要求:
- 面向有经验的开发者,但不要堆砌黑话
- 必须提出一个反直觉观点
- 必须包含一个具体反例
- 必须给出创业团队可执行的建议
- 禁止空泛口号和模板化表达
来看看他写的结果,你觉得如何?
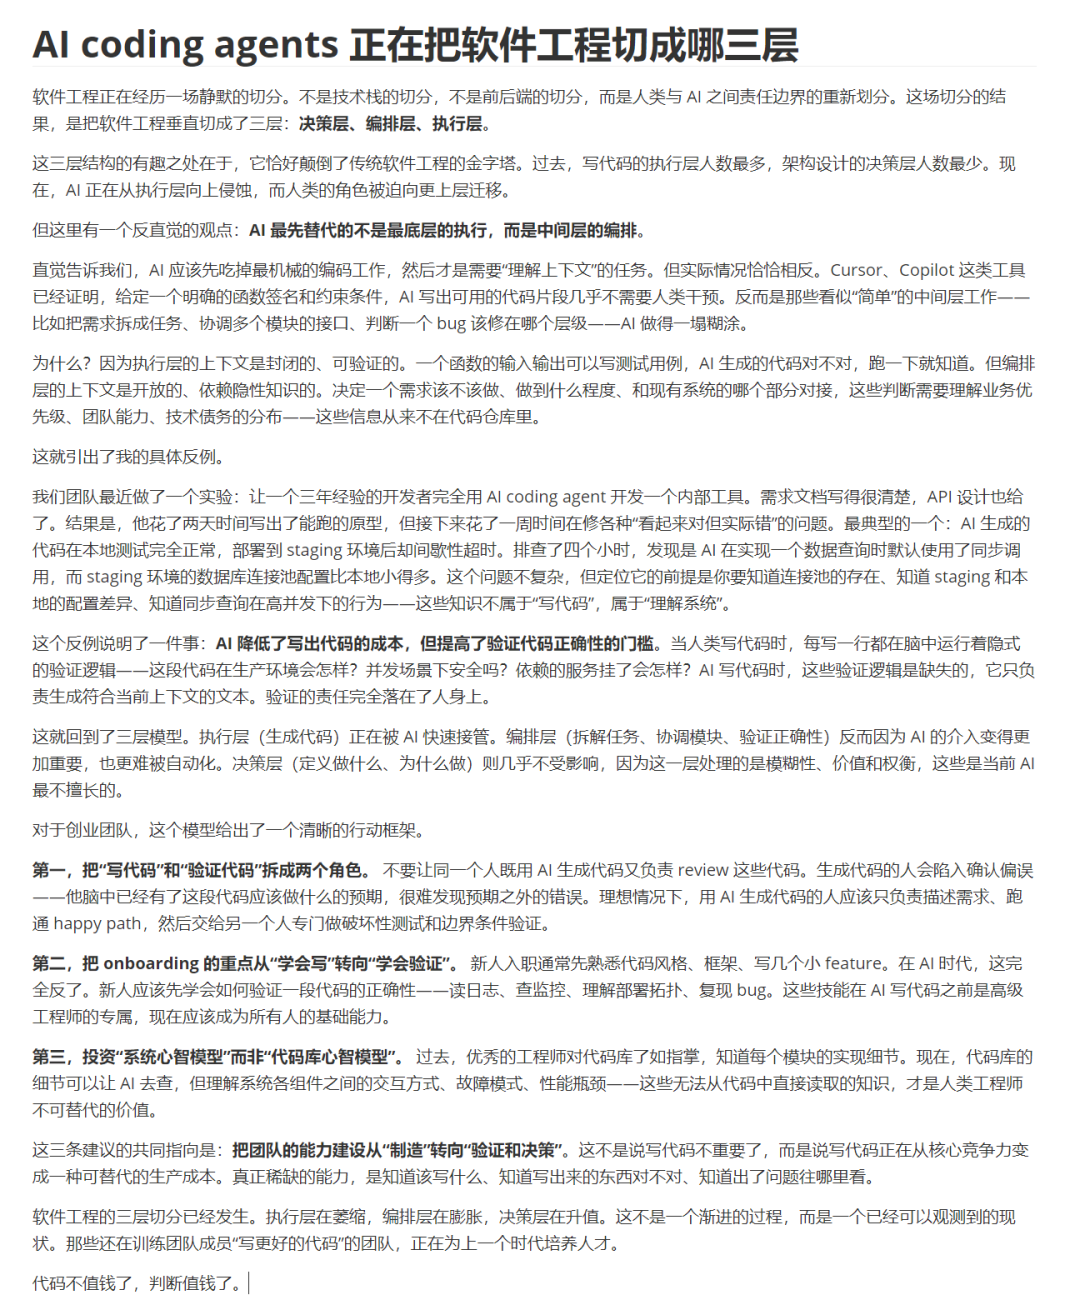
就成文质量来说,我觉得它是在线的。有观点,有结构,也有具体反例,最关键的是,他的AI味很淡。文章的核心观点“AI 降低了写代码成本,但提高了验证门槛”这条主线,基本是成立的。
但有一个小问题也非常具体:它写超了。
我的要求是 1000-1200 字,它实际写了大约 1619 个字符,部分超出了我要求的限制。所以这轮我的结论不是“它会不会写”,而是:
它会写,而且写得不差,没有明显的AI味;但你要是对篇幅有严格要求,还是得有人收一下。
五、逻辑推理:题做对了,但成本也真不低
推理题我也没偷懒,直接上了两道可验证的题。
第一道是排程题:
五位研究员 A、B、C、D、E 从周一到周五依次做报告。
- D 恰好在 E 之前两天做报告。
- A 在 C 之后做报告。
- C 在 B 之前做报告。
- B 不在周一。
- A 不在周五。
- B 在 D 之前做报告。
它给回来的答案是:
周一: C
周二: B
周三: D
周四: A
周五: E
结果没问题。为了避免拉踩,大家可以自行试试其他模型的表现。
第二道是概率题:
一个罐子里装有 4 颗红色、5 颗蓝色和 6 颗绿色的弹珠。
从中不放回地随机抽取三颗弹珠。
求恰好出现两种颜色且至少有一颗绿色弹珠的概率。
它给回来的答案是:
33/65
结果也对。
如果只看正确率,结论很简单:DeepSeek V4 Pro 的推理是靠谱的。
需要注意的是我是开了thinking模式测试的,所以token的时间和消耗量会偏高,这两道题分别用了:
- 排程题:
26.828s,838 reasoning tokens - 概率题:
32.956s,1025 reasoning tokens
我做过一轮对照:同样一道代码生成题,如果不显式关闭 thinking,deepseek-v4-pro 会把大量预算耗在 reasoning 上,最夸张的一次,56.35s 过去了,1800 completion tokens 几乎全是 reasoning,结果代码正文没出来。
而当我把 thinking 设成 disabled 之后,它反而更像一个正常的 coding 模型:延迟下来,代码也出来了。
所以这里给大伙一个很实用的建议:
- 写代码、写文案、抽结构化结果时,优先关 thinking
- 做可验证的复杂推理题时,再把 thinking 打开
六、Flash 我也顺手测了:快是快,但别急着让它扛主力
为了不只盯着 Pro,我也顺手测了几轮 deepseek-v4-flash。
先说它好的地方:是真的快。
比如同样的 direct code 题,它的接口延迟只有 5.548s,明显比 Pro 轻快。
但问题也来得很直接。
第一道代码题,我已经明确写了“只返回文件内容,不要 Markdown fences”,它给回来的结果开头还是:
```python
import asyncio
import functools
结果不用猜,测试直接因为 SyntaxError 挂掉。
而把 thinking 打开之后,另一个问题又来了:它会把预算几乎全吃进 reasoning,最后不出答案。
所以 Flash 的定位,我觉得挺清楚:
它适合做快响应、低成本草稿,不适合今天就拿去扛关键任务。
七、结论
如果你还在纠结“要不要试试 DeepSeek”,那我的建议只有一个:别试了,直接用。 在 V4 面前,犹豫本身就是对生产力最大的浪费。DeepSeek的 API 和开源模型直接开放给每一个开发者,Claude Code 可用,这意味着世界上最强的编码、推理和 Agent 底座之一,现在就在你手边,触手可及。
关于QuantML
QuantML 是链接全球顶尖量化人才的高端社群,我们聚焦于机器学习在量化投资中的最前沿应用。
核心价值:
- 顶级圈层: 社区涵盖头部机构从业者、知名私募创始人、机构量化负责人,基金经理,券商金工分析师、GitHub千星作者及顶会学者构成。
- 每日高价值内容: 持续分享前沿论文、论文研报复现、模型代码、核心Alpha因子以及QuantML-Qlib框架等。
加入我们,与最强大脑同行,洞见量化未来。